


python递归函数怎么定义及退出条件
深入讲解Python递归函数的定义方法与退出条件设计法则。通过调用栈图解、代码实战示例与边界排查四步法,系统掌握基线条件设置、栈溢出防范与实际项目应用。
RecursionError。
一、递归函数的本质与基本定义格式
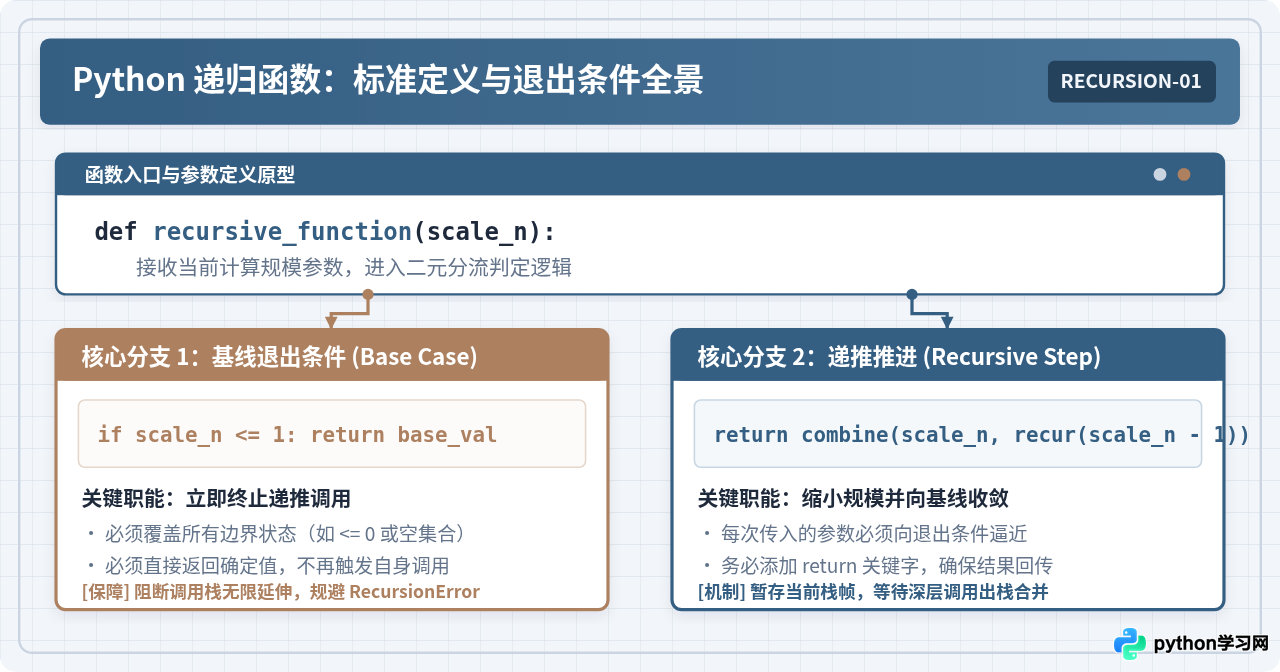
递归并不是某种专门的语法关键字,而是一种将复杂问题自顶向下拆解为同类型子问题的编程范式。在 Python 中,递归函数同样使用标准的 def 语句声明,但在函数体内部,它必须包含两项不可或缺的逻辑要素:
- 退出条件(Base Case):负责为最小规模的问题提供确定解,直接返回计算结果并终止继续下潜,避免无限循环。
- 递推调用(Recursive Step):把当前大问题分解为一个或多个参数规模更小的子问题,并在自身调用的基础上进行结果组合。
一个标准的 Python 递归函数通用结构模板如下:
def standard_recursive(scale_n):
    # 1. 退出条件(必须置于最前,阻断进一步下潜)
    if scale_n <= 1:
        return 1  # 交付基线值,直接出栈

    # 2. 递推逻辑(规模缩减,向退出条件逼近,并向上回传结果)
    return scale_n * standard_recursive(scale_n - 1)
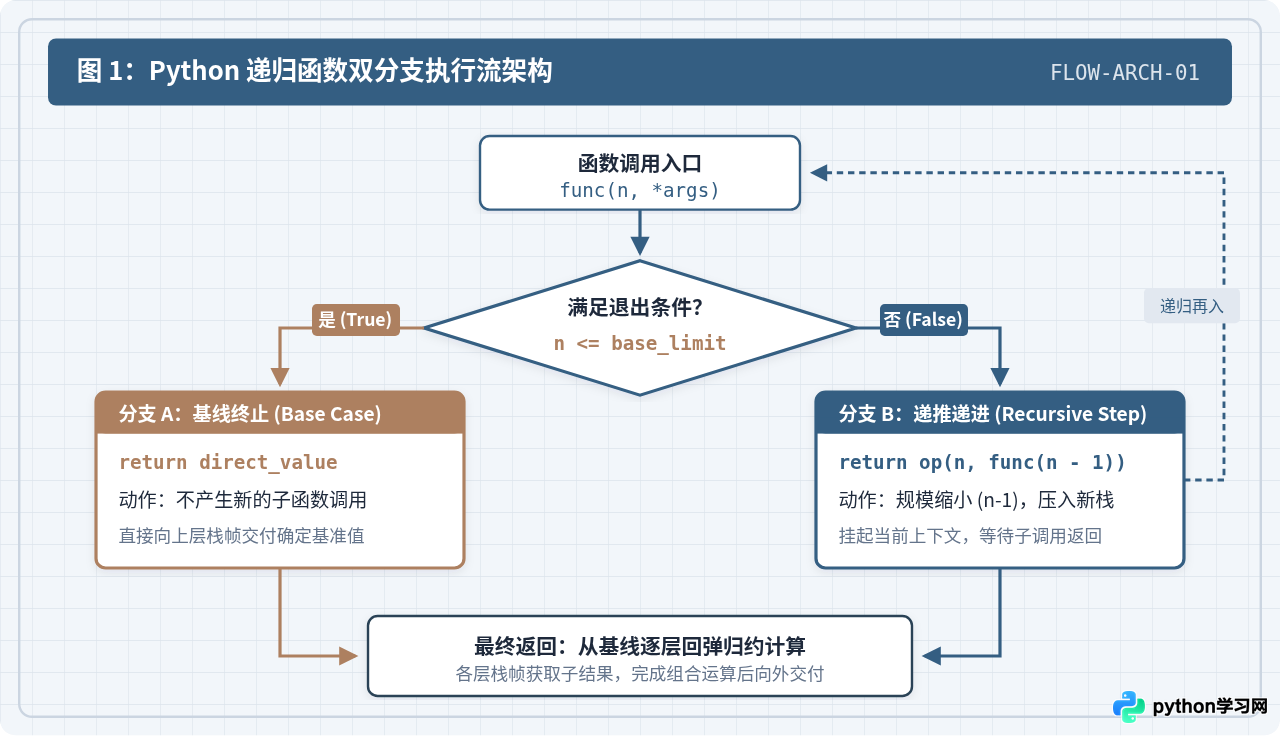
从控制流上看,每一次递归调用都会在内存的调用栈上创建一个新的栈帧(Stack Frame),用来保存当前调用的局部变量和程序计数器状态。只有当深层调用触碰到退出条件并返回数值后,调用栈才会自底向上依次销毁栈帧并完成归约计算。
二、退出条件(基线条件)的设计法则
退出条件是递归程序的刹车装置。设计一个严谨的退出条件,需要遵循以下四条核心准则:
1. 优先置顶,绝不后置
退出条件的判定逻辑必须位于函数体的最开始部分。如果在执行退出判断之前包含了任何递归调用或耗时计算,递归将直接失控穿透,导致基线条件形同虚设。
2. 使用范围区间而非单一等值
初学者常将基线条件写为 if n == 0:。这种写法在输入负数、浮点数或步长不为 1 时极其脆弱,极易导致参数跳过该固定点而陷入死循环。更为稳妥的做法是采用闭区间或范围比较,例如 if n <= 0: 或容器为空判断 if not collection:。
3. 严格透传 return 关键字
在递归分支中,调用自身的前方必须显式添加 return。若遗漏了 return,虽然内层递归正常运行完毕,但外层函数将无法捕获内层的返回值,导致最外层调用最终意外得到 None。
错误示例:
def f(n): if n == 1: return 1; f(n-1)(不仅条件易跳过,且漏掉了递归调用的 return)。
正确写法:
def f(n): if n <= 1: return 1; return f(n-1)。
三、执行机制解析:调用栈入栈与出栈全过程
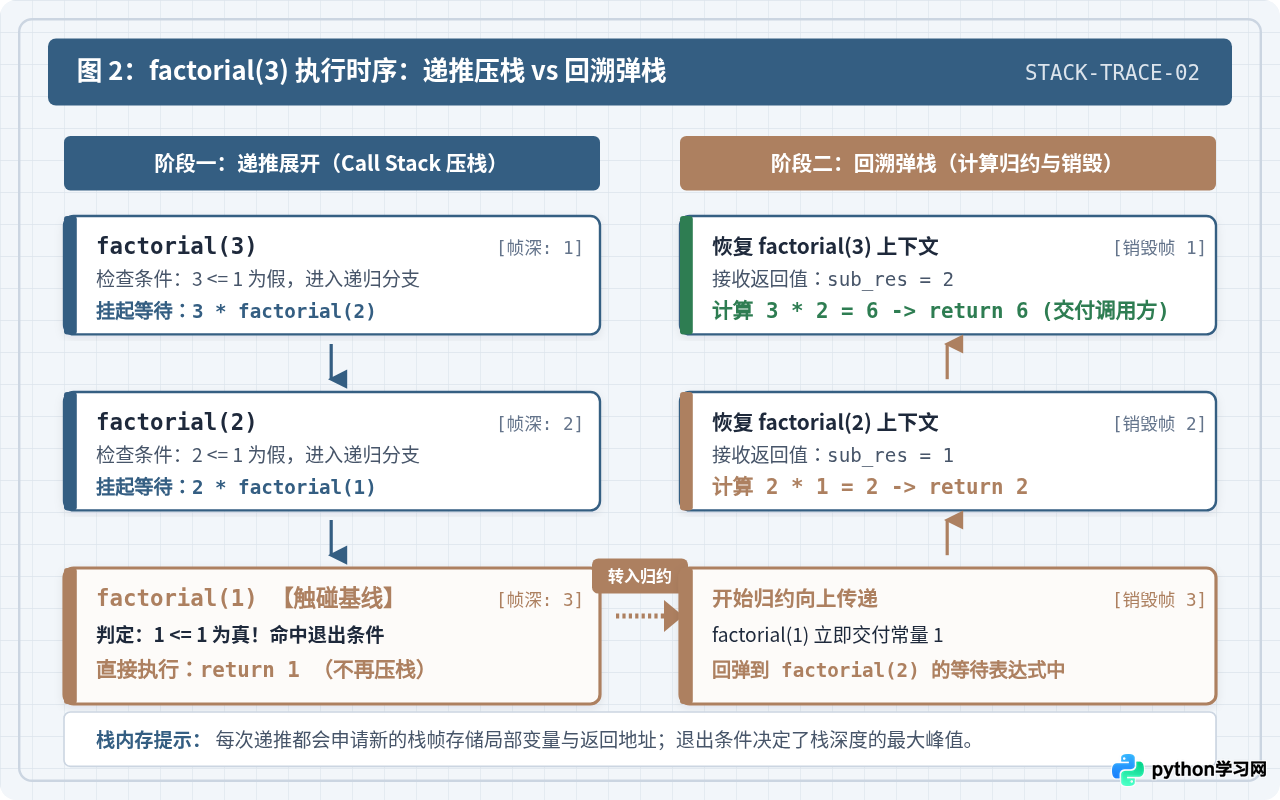
理解递归的关键在于洞察 Python 解释器内部的“调用栈(Call Stack)”。以经典的阶乘函数 factorial(3) 为例,其运算过程并非瞬间完成,而是清晰地分为“递推展开”与“回溯归约”两个阶段:
阶段一:递推展开(Push 压栈)
- 调用
factorial(3):条件3 <= 1为假,计算挂起为3 * factorial(2),当前栈帧被推入调用栈; - 调用
factorial(2):条件2 <= 1为假,计算挂起为2 * factorial(1),第二层栈帧压入栈顶; - 调用
factorial(1):条件1 <= 1为真,命中退出条件,执行return 1,递推阶段结束。
阶段二:回溯归约(Pop 弹栈)
factorial(1)返回常数1,其栈帧立即销毁弹栈;factorial(2)恢复上下文,获取子结果1,计算2 * 1 = 2,执行return 2并弹栈;factorial(3)恢复上下文,获取子结果2,计算3 * 2 = 6,执行return 6并交付最初的调用方。
四、典型实战范例:从数值计算到多层嵌套遍历
案例 1:带健壮性校验的阶乘计算
在实际编码中,除了基础退出条件外,还应当对非法入参(例如负整数或非整型)进行前置防御性拦截:
def safe_factorial(n):
    # 防御性参数校验(处理异常输入)
    if not isinstance(n, int) or n < 0:
        raise ValueError("输入必须为非负整数")

    # 核心退出条件:0! 和 1! 均为 1
    if n <= 1:
        return 1

    # 递推推进:规模单调递减 (n - 1)
    return n * safe_factorial(n - 1)

# 运行验证
print(safe_factorial(5))  # 示例输出: 120
案例 2:多层嵌套列表扁平化处理
递归在树形结构和非固定层级嵌套结构的遍历中具有极大优势。以下代码演示如何将任意深度的嵌套列表展平为单一平铺列表:
def flatten_nested_list(items):
    flat_result = []
    for item in items:
        # 判断元素是否仍为列表容器(退出条件分支划分)
        if isinstance(item, list):
            # 仍是列表:递归深入,并将子列表扁平化的结果合并进当前结果
            flat_result.extend(flatten_nested_list(item))
        else:
            # 基础标量:触碰基本元素边界,直接收集
            flat_result.append(item)
    return flat_result

# 运行验证
nested_data = [1, [2, [3, 4], 5], [6], 7]
print(flatten_nested_list(nested_data))  # 示例输出: [1, 2, 3, 4, 5, 6, 7]
在此案例中,退出条件是“当前元素不是列表”,此时算法不再产生新的递归分支,而是直接归入结果集中。
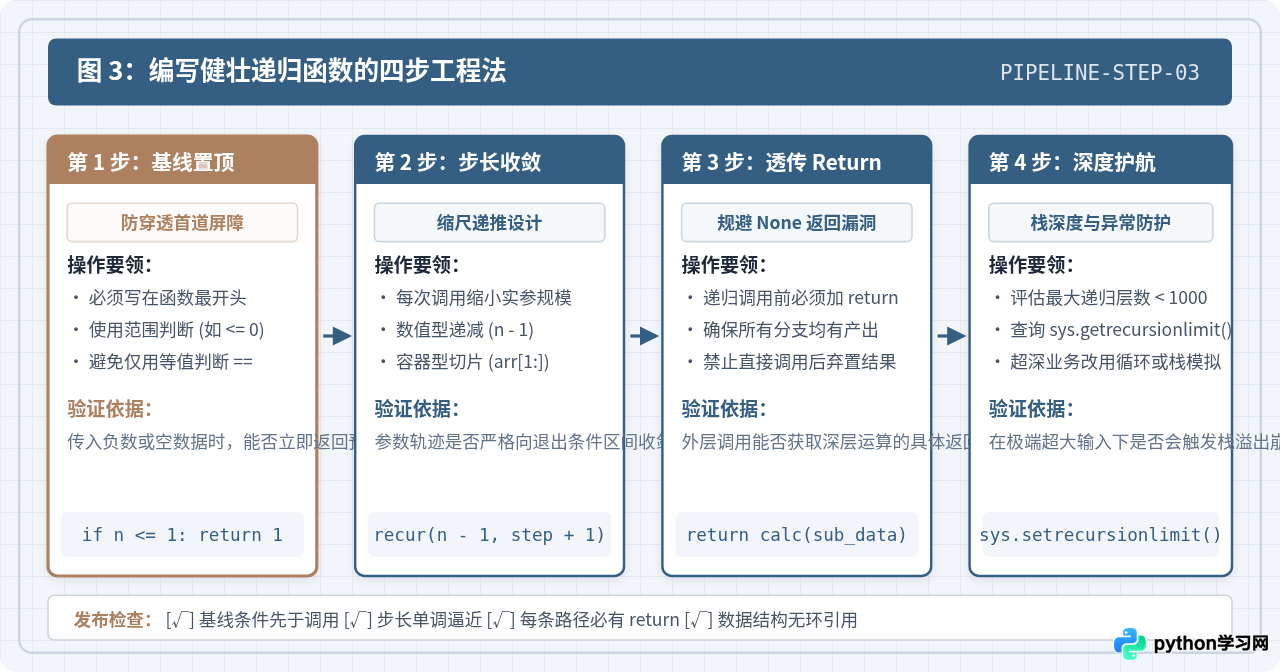
五、递归函数标准编写与边界排查四步法
为了在工程开发中彻底避免逻辑死循环和未定义行为,可以按照以下四个步骤来设计与自查递归代码:
- 第一步:基线置顶 —— 率先明确并写下最小不可分单元的判断逻辑(例如元素为 0、节点为 None、容器为空等),确保其先于任何递推逻辑执行。
- 第二步:步长收敛 —— 审视递归调用时的传入参数,验证实参在经过每一次运算后,其状态轨迹是否在严格地向退出条件收敛(如数字逐渐缩小、序列切片变短)。
- 第三步:透传 Return —— 逐行核对代码各执行路径,确保每个能够退出函数的条件分支均有合法的
return返回值,避免结果在回溯过程中丢失。 - 第四步:深度护航 —— 预估数据规模带来的栈开销,检查系统默认递归深度限制,对可能引发超限的大规模任务制定兜底策略。
六、常见报错排障与递归/迭代选型决策
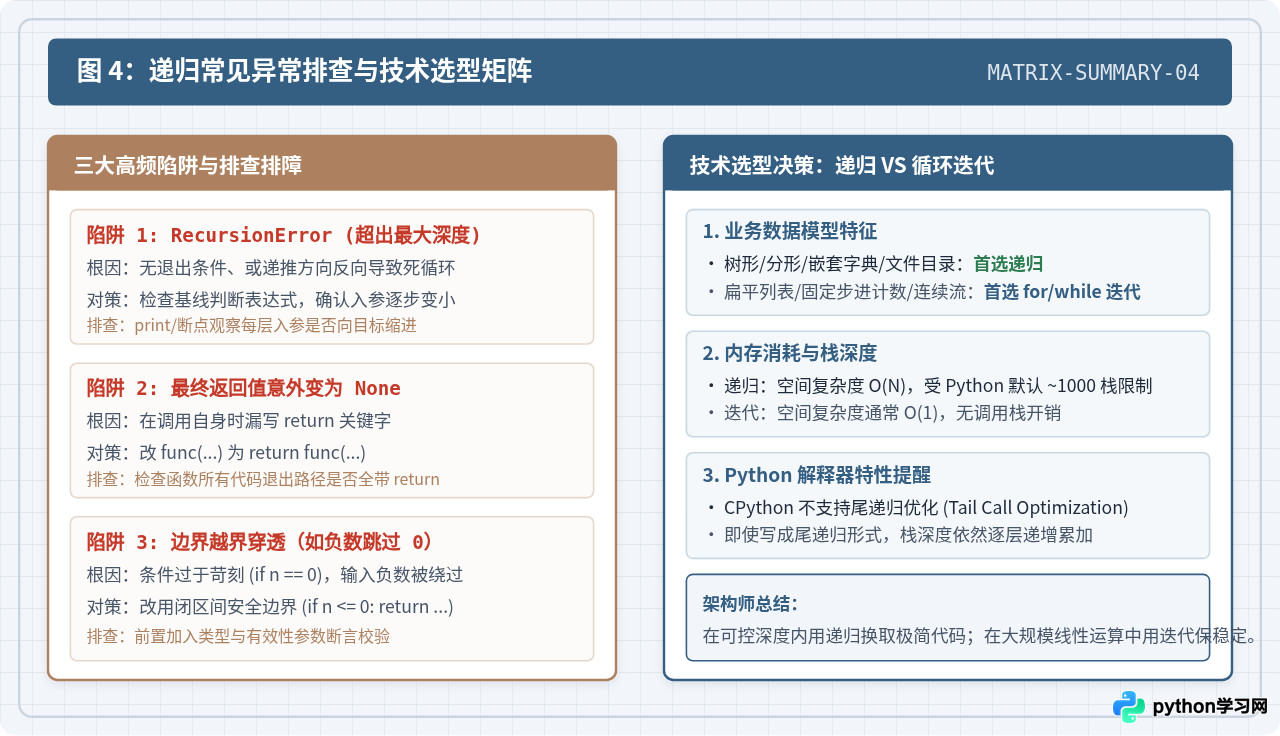
1. RecursionError 异常与最大栈深度机制
当递归未能在合理深度内触碰退出条件时,Python 解释器会主动截断执行并抛出异常:
RecursionError: maximum recursion depth exceeded in comparison
这是 CPython 解释器为了防止 C 语言级别栈溢出(Stack Overflow)导致整个 Python 进程崩溃而设立的安全机制。开发者可以通过标准库 sys 查看或临时调整该阈值:
import sys

# 获取当前解释器的最大调用深度(默认为 1000)
current_limit = sys.getrecursionlimit()
print(f"默认递归限制: {current_limit}")

# 调大栈深度限制(仅用于受控且确有必要的深层递归场景)
sys.setrecursionlimit(3000)
sys.setrecursionlimit 存在导致底层操作系统调用栈耗尽而直接崩溃的风险。
2. 递归与循环迭代的选型矩阵
在面对具体业务需求时,应根据数据特性与性能要求理性评估是否使用递归:
| 对比维度 | 递归函数 (Recursion) | 循环迭代 (Iteration / Loop) |
|---|---|---|
| 适合场景 | 分形结构、树/图遍历、分治算法(如快速排序、归并排序)、嵌套 JSON 解析 | 连续数值累加、线性列表过滤、无限长数据流消费、批量状态更新 |
| 代码表现力 | 符合数学定义,逻辑简洁优雅,无须手工维护复杂中间状态 | 需要较多辅助变量与计数器,但执行流程对硬件极为直观 |
| 空间复杂度 | O(N) 栈内存开销,受调用栈深度硬性限制 | 通常仅需 O(1) 辅助变量空间,无调用栈溢出风险 |
| 运行性能 | 频繁创建和销毁栈帧,开销略高于普通循环 | 纯 CPU 循环跳转,执行效率更高 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















