


python必背源代码最长公共前缀代码
深入解析Python实现最长公共前缀的经典必背源代码。包含纵向扫描法、字典序极值法与横向扫描法的完整实现、逐行推导、图解流程与复杂度对比。
一、问题定义与核心逻辑
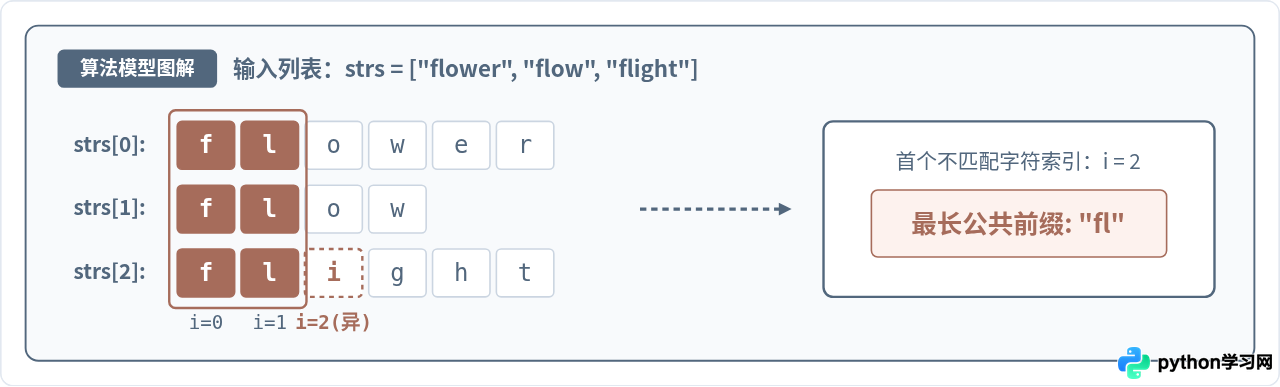
在字符串处理任务中,最长公共前缀的判定规则可以严格表述为:给定一个字符串数组 strs,寻找一个尽可能长的字符串 P,使得数组中的每一个字符串 s 均满足 s.startswith(P)。若列表为空或任意两个字符串的第一个字符便不相同,则公共前缀为空字符串 ""。
该问题的两个极端边界情况尤为值得注意:
- 空输入或单元素:若输入列表为空列表
[],直接返回"";若列表仅含一个字符串(如["single"]),其最长公共前缀必然是自身。 - 提前分歧:只要列表中存在某一个字符串已遍历结束,或者任意两个字符串在同一列出现不同字符,搜索就必须立刻终止。
二、必背源码一:标准纵向扫描法
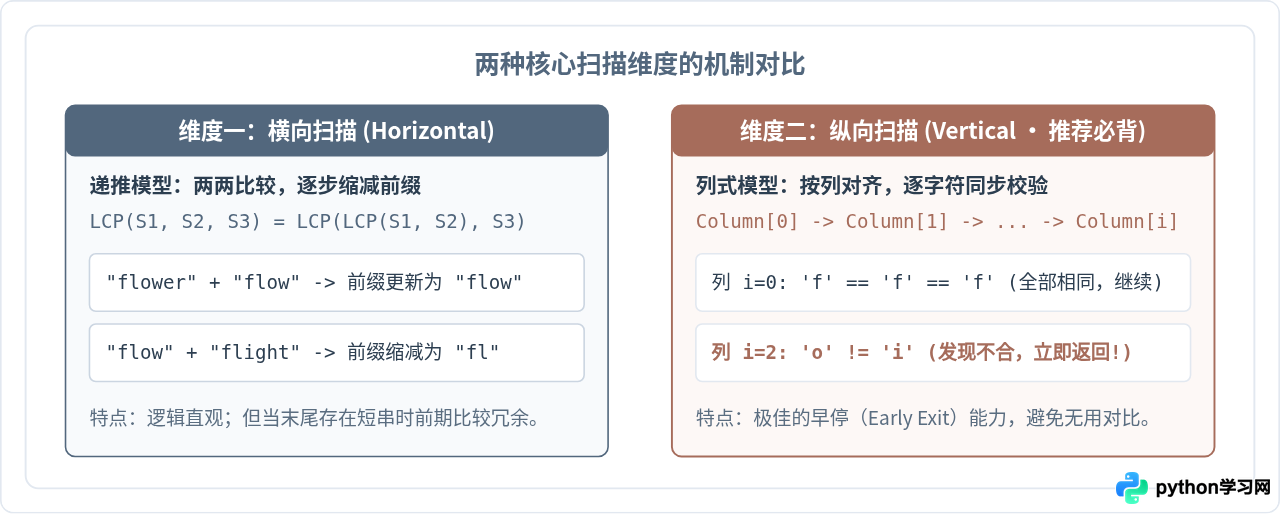
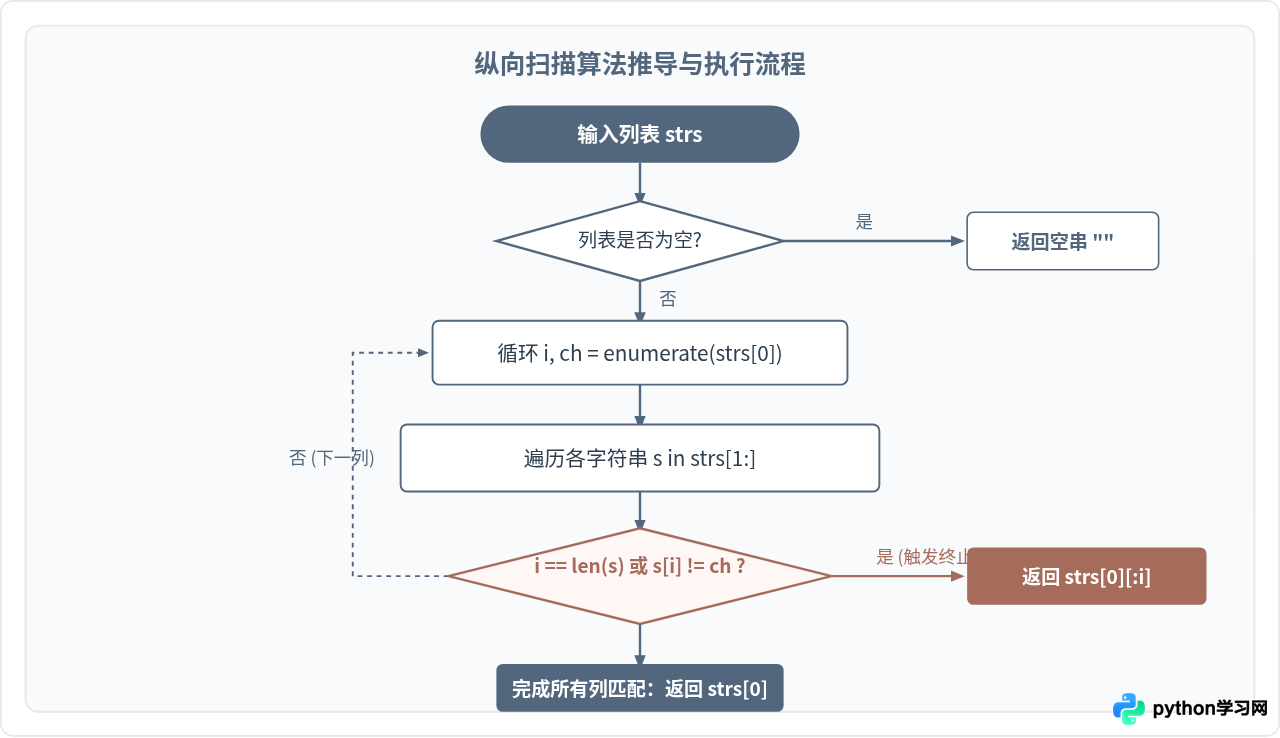
纵向扫描法是面试与生产中最推荐的标准代码。它的核心思想是:以第一个字符串 strs[0] 作为基准标尺,逐列检查所有其他字符串对应下标的字符是否一致。
1. 完整实现源码
def longest_common_prefix_vertical(strs: list[str]) -> str:
    # 1. 边界检查:若列表为空,直接返回空字符串
    if not strs:
        return ""

    # 2. 以首个字符串为基准,遍历其每个字符与索引
    for i in range(len(strs[0])):
        ch = strs[0][i]

        # 3. 纵向检查后续每一个字符串在当前列 i 的字符
        for s in strs[1:]:
            # 条件一:当前字符串长度不足 i(已到结尾)
            # 条件二:当前字符串在 i 处的字符与基准字符不匹配
            if i == len(s) or s[i] != ch:
                return strs[0][:i]

    # 4. 若首个字符串全部字符均通过校验,则其本身就是最长公共前缀
    return strs[0]
2. 运行示例
# 示例调用
data_1 = ["flower", "flow", "flight"]
data_2 = ["dog", "racecar", "car"]

print(longest_common_prefix_vertical(data_1))  # 示例输出: fl
print(longest_common_prefix_vertical(data_2))  # 示例输出: ""
3. 逐行执行细节与注意事项
在这段代码中,最关键的是内层判断 if i == len(s) or s[i] != ch: 的书写顺序。
i == len(s),后判断 s[i] != ch。因为当某个字符串 s 比基准串更短时,如果颠倒顺序直接执行 s[i],将立即引发 Python 的 IndexError: string index out of range 异常。利用 Python 的 or 短路特性,可以在下标越界前安全截断并返回。
三、必背源码二:字典序极值法
在 Python 面试中,若想要展现对语言内建函数与字符串排序特性的深度理解,字典序极值法(min/max 法)是最具技巧性与美感的高效解法。
1. 完整实现源码
def longest_common_prefix_minmax(strs: list[str]) -> str:
    # 1. 边界检查
    if not strs:
        return ""

    # 2. 获取整个列表中字典序最小和最大的两个字符串
    s_min = min(strs)
    s_max = max(strs)

    # 3. 仅比对极小串与极大串的公共字符
    for i, ch in enumerate(s_min):
        if ch != s_max[i]:
            return s_min[:i]

    # 4. 若全部匹配,s_min 即为公共前缀
    return s_min
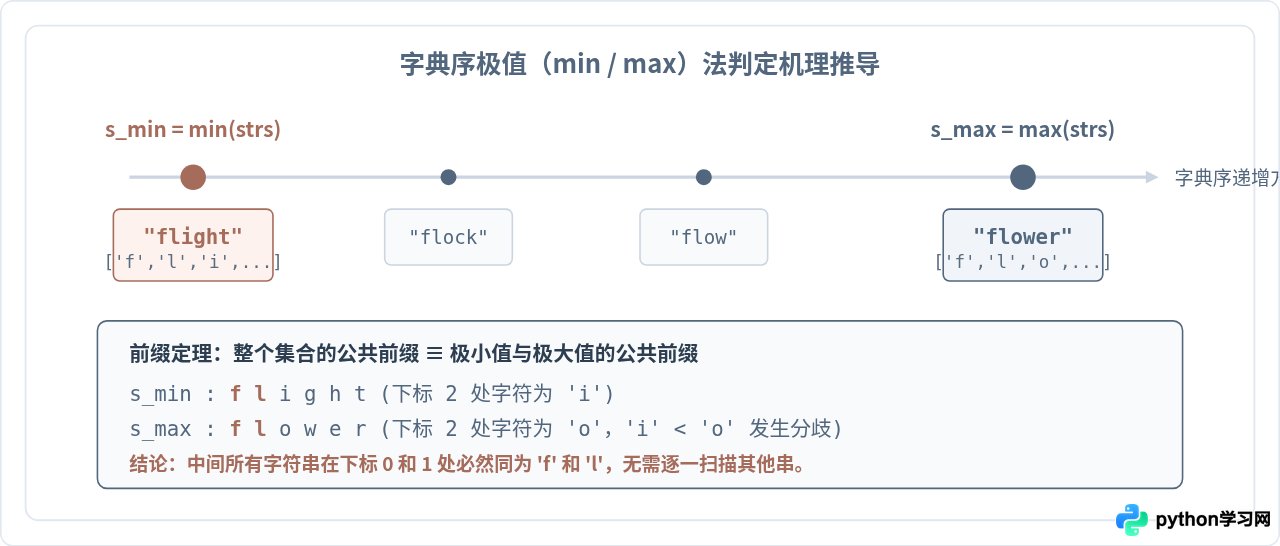
2. 为什么只需比对 min 和 max?
初学者往往会对这套解法产生疑问:为什么跳过了列表内部的所有其他字符串,仅比对两个极值就能代表整个数组?
其数学与逻辑依据在于字符串在 ASCII / Unicode 编码下的全序性(字典顺序)。设想我们将整个列表的所有字符串按字典序从小到大排列:如果某个前缀存在分歧,那么最先产生分歧的一定位于字典序两端(最左端的 s_min 与最右端的 s_max)。换言之,排在中间的所有字符串,其对应位置的字符编码值必然被夹在 s_min 与 s_max 之间。如果 s_min[i] == s_max[i],中间所有字符串在下标 i 处的字符必然也是同一个字符。
四、进阶与拓展写法:横向扫描与 zip 压缩
1. 横向扫描法(两两规约)
横向扫描法采用迭代更新公共前缀的方式,先将 prefix = strs[0],然后用它依次与 strs[1]、strs[2] 进行比对并不断缩短 prefix:
def longest_common_prefix_horizontal(strs: list[str]) -> str:
    if not strs:
        return ""

    prefix = strs[0]
    for s in strs[1:]:
        # 当 s 不是以当前 prefix 开头时,不断切掉末位字符
        while not s.startswith(prefix):
            prefix = prefix[:-1]
            if not prefix:
                return ""
    return prefix
2. Pythonic 的 zip 与 set 语法糖解法
利用 Python 内置的 zip(*strs) 可以极其优雅地将多个字符串“解压并按列打包”,结合 set 去重,可以写出极富 Python 风格的纵向扫描:
def longest_common_prefix_zip(strs: list[str]) -> str:
    if not strs:
        return ""

    res = []
    # zip(*strs) 会按列同步打包,以最短字符串长度自动终止
    for col in zip(*strs):
        if len(set(col)) == 1:
            res.append(col[0])
        else:
            break
    return "".join(res)
注意:zip(*strs) 会自动在最短字符串结束时停止迭代,因此完全规避了下标越界问题。但在空间上,set(col) 会产生微小的集合开销。
五、算法复杂度与选型总结
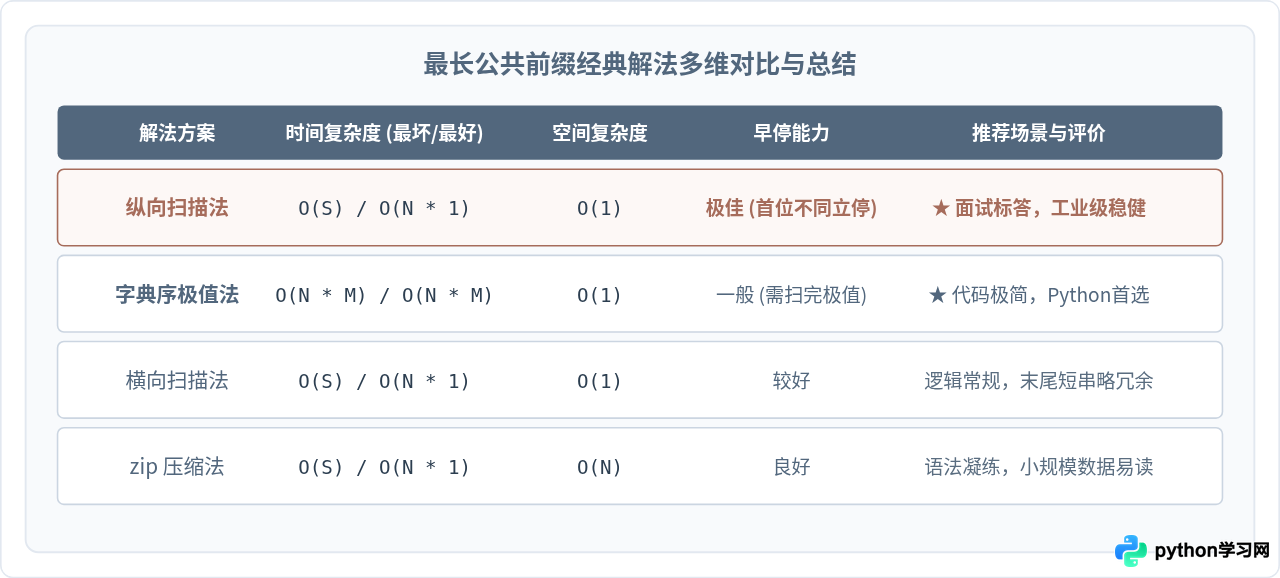
下表系统梳理了四种常见最长公共前缀实现的复杂度及适用场景(设 $N$ 为字符串总数量,$M$ 为最短字符串长度,$S$ 为全部字符串字符总数):
选型建议与总结
在实际编程与面试中,可以依据具体侧重点进行选择:
- 面试现场手撕:首选标准纵向扫描法。该解法不依赖特定语言的高级黑盒,严格展示了双重循环控制、越界防范与短路判断,是算法面试中最稳妥、得分率最高的实现。
- 工程极简或 Python 特色展现:选择字典序极值法(
min/max)。仅需提取首尾两个极值并进行单次比对,代码仅有寥寥数行,既展现了算法深度,又体现了对 Python 语言内部机制的娴熟驾驭。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















