


python必背源代码插入排序代码
发布时间:2026-11-20 |
11人浏览过
深入解析Python必背源代码之插入排序算法,提供完整规范的Python实现代码、逐行逻辑剖析、单步执行跟踪图解及复杂度与适用场景总结。
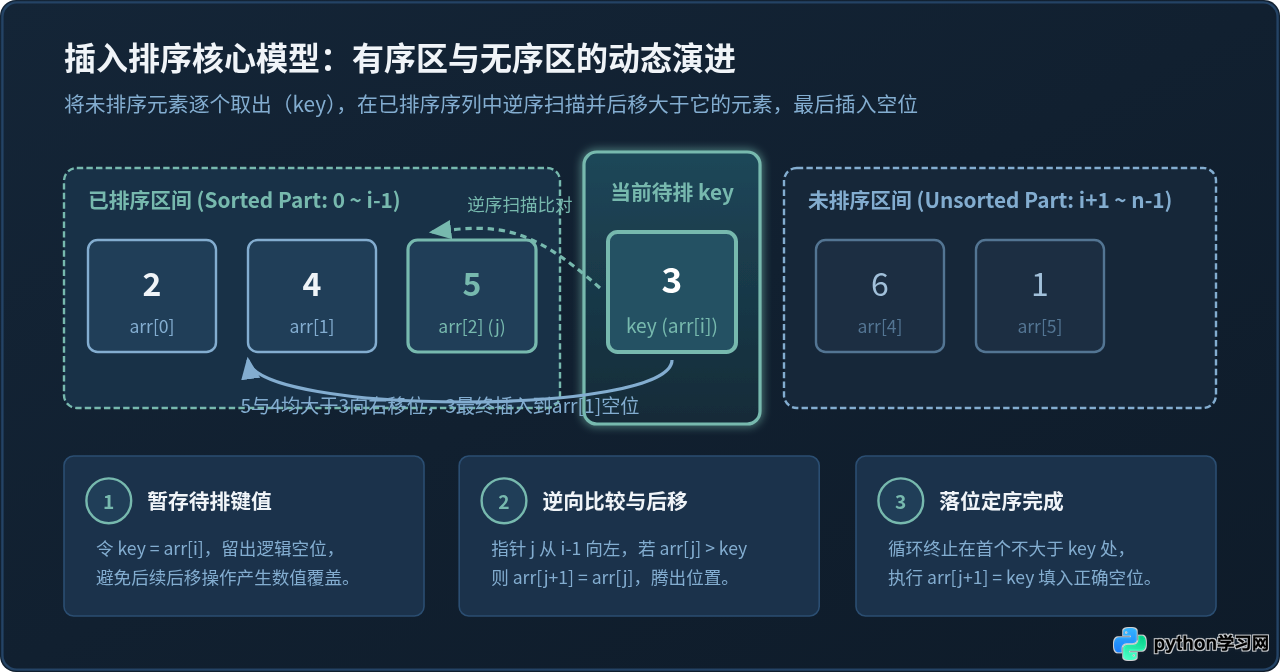
核心摘要:插入排序(Insertion Sort)是算法学习与编程考核中必须熟练写出的基础算法之一。其核心思想类似于整理手中的扑克牌:把序列划分为“已排序”与“未排序”两部分,逐个将未排序区间的元素提取出来,在已排序区间中从右向左扫描,找到合适位置后直接插入。本文给出标准的 Python 插入排序实现源码,剖析单步执行过程与内部移位机制,并阐明其在工业级排序(如 Python 内置 Timsort)中的关键应用。
一、标准的 Python 插入排序核心源码
在面试或算法手写代码时,最标准、简洁且兼顾执行效率的插入排序实现如下所示。该代码在标准 Python 3 环境下可直接执行,无需引入任何外部库:
def insertion_sort(arr):
    # 从第 2 个元素(索引 1)开始遍历,因为单元素 arr[0] 天然有序
    for i in range(1, len(arr)):
        key = arr[i]          # 暂存当前需要插入的目标值
        j = i - 1             # 指向已排序区间的最后一个元素

        # 将已排序区间中大于 key 的元素依次向后挪动一位
        while j >= 0 and arr[j] > key:
            arr[j + 1] = arr[j]
            j -= 1

        # 找到插入位置,将 key 填入腾出的空位中
        arr[j + 1] = key

    return arr
测试调用与示例输出
编写简短测试代码验证排序逻辑:
# 示例调用
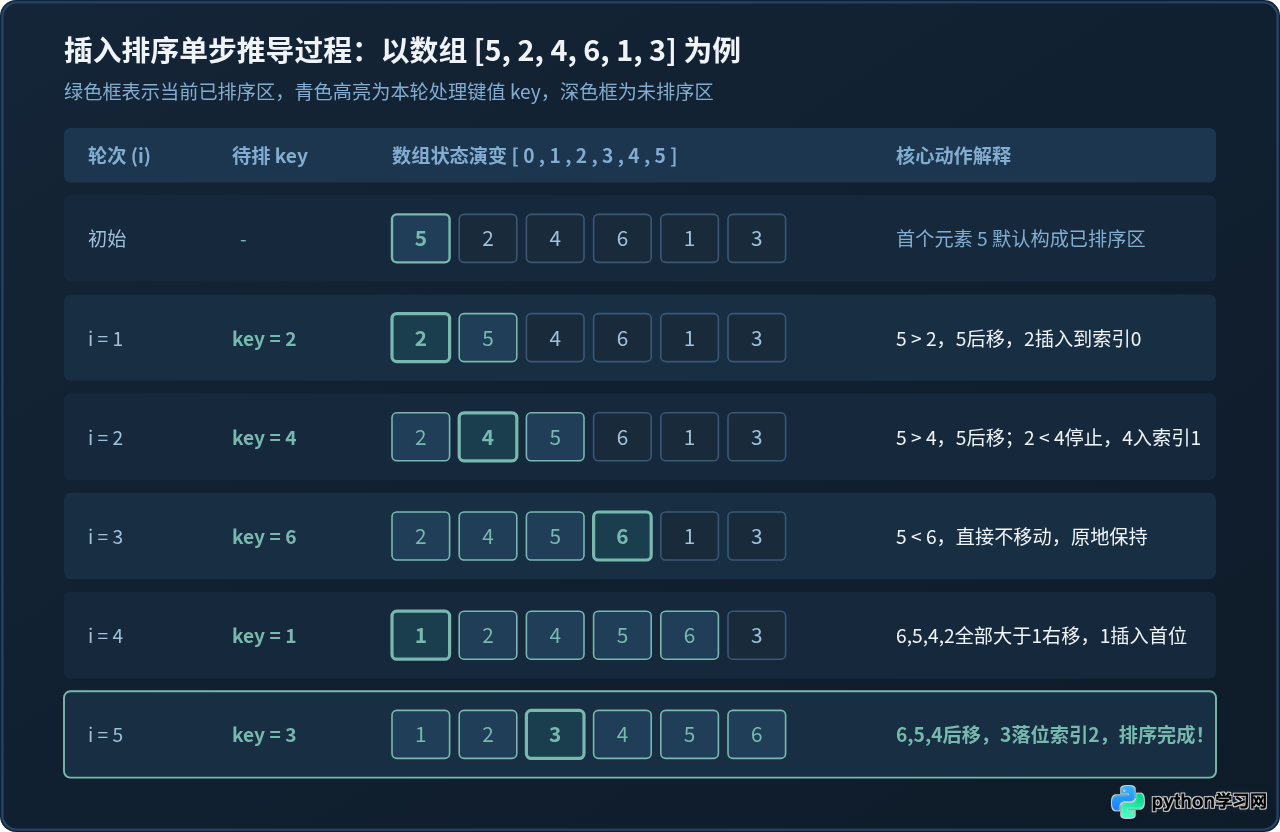
test_list = [5, 2, 4, 6, 1, 3]
sorted_list = insertion_sort(test_list)
print("排序结果:", sorted_list)
示例输出:
排序结果: [1, 2, 3, 4, 5, 6]
二、核心逻辑逐行拆解
整段代码仅有 8 行核心语句,结构极其紧凑,其执行逻辑可以清晰地划分为四个阶段:
- 外层循环区间
range(1, len(arr)):序列首个元素arr[0]天然构成一个长度为 1 的已排序序列。因此外层循环的游标i直接从索引 1 开始,直至数组末尾。 - 键值暂存
key = arr[i]:必须先将当前待插入的数值保存在变量key中。由于后续在寻找插入空位时会执行覆盖写操作,若不暂存,原数值就会被前面挪过来的元素直接冲刷丢失。 - 内层逆序比较与移位
while j >= 0 and arr[j] > key:指针j初始设为i - 1,从已排序区间的尾部向前推进。只要arr[j]比key大,就执行arr[j + 1] = arr[j]将该元素后移一位,然后j -= 1继续向前检查。 - 空位填入
arr[j + 1] = key:当while循环因为arr[j] <= key或者j < 0而退出时,说明j + 1正好是大于等于原位置且小于后方元素的合法插入槽位,直接将key赋值到arr[j + 1]即可。
三、关键机制:“单次后移”相比“频繁交换”的优势
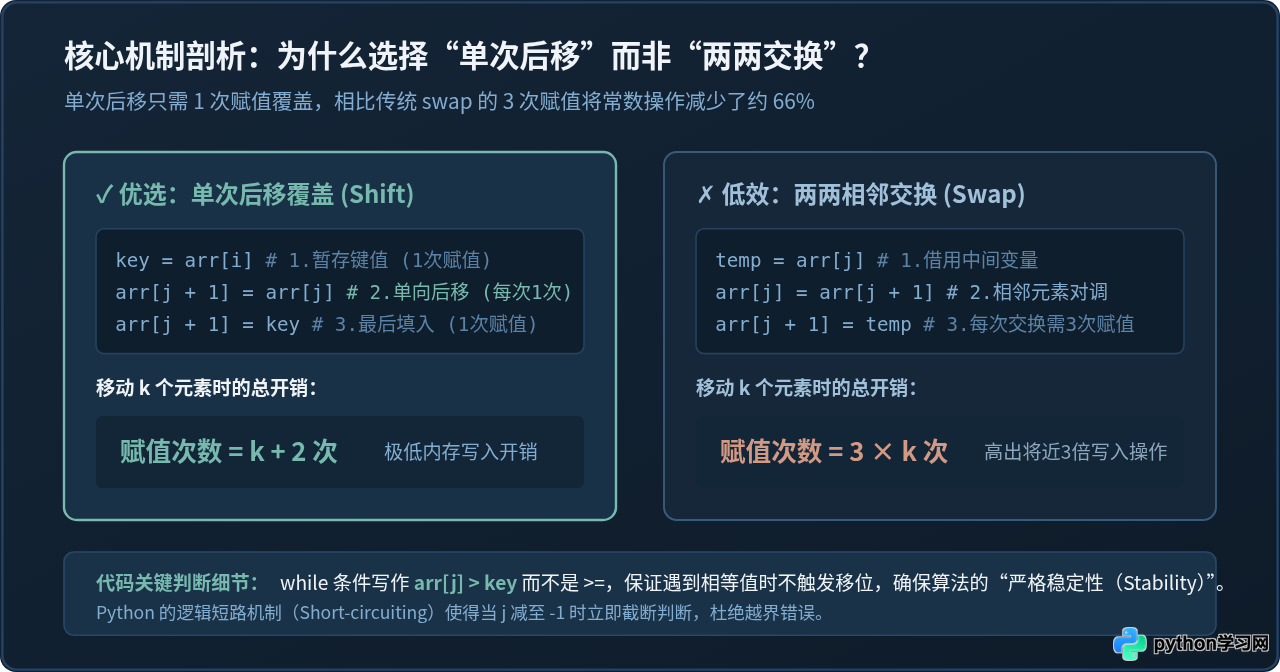
很多初学者在初写插入排序时,容易把内层循环写成类似冒泡排序的“相邻两两交换(swap)”。虽然最终也能实现排序,但在执行效率上存在本质差别:
如果使用两两交换,每次发现逆序都需要借助第三个变量完成一次 swap 操作(在底层执行 3 次变量赋值)。假如有 $k$ 个元素需要后移,两两交换需要执行 $3k$ 次赋值;而在标准实现中,我们先暂存 key,每次比较成立只执行单次覆盖写 arr[j + 1] = arr[j](仅 1 次赋值),最后再执行一次 arr[j + 1] = key,总共只需要 $k + 2$ 次赋值。操作量直接下降为原来的三分之一左右,这也是插入排序在实际小规模数据排序中速度明显优于冒泡排序的核心技术原因。
四、容易忽略的边界细节与稳定性
在编写和审查插入排序代码时,有两个细节决定了算法的鲁棒性与排序性质:
- 短路逻辑防越界:
while j >= 0 and arr[j] > key中的两个条件次序绝不能颠倒。Python 对布尔表达式使用短路求值(Short-circuit Evaluation),当j递减到-1时,j >= 0判定为False,解释器不会再去评估arr[j],从而避免触发意外的负数索引取值或越界错误。 - 算法严格稳定性保证:比较条件使用的是严格大于
arr[j] > key而不是大于等于>=。当已排序区间内存在与key数值相等的元素时,内层循环会立刻停止后移,新元素被放置在原相等元素的紧后方。这保证了值相同的两个元素在排序前后的相对次序绝对不会发生翻转,因此插入排序是一种稳定排序算法(Stable Sort)。
五、算法复杂度与工业级应用场景
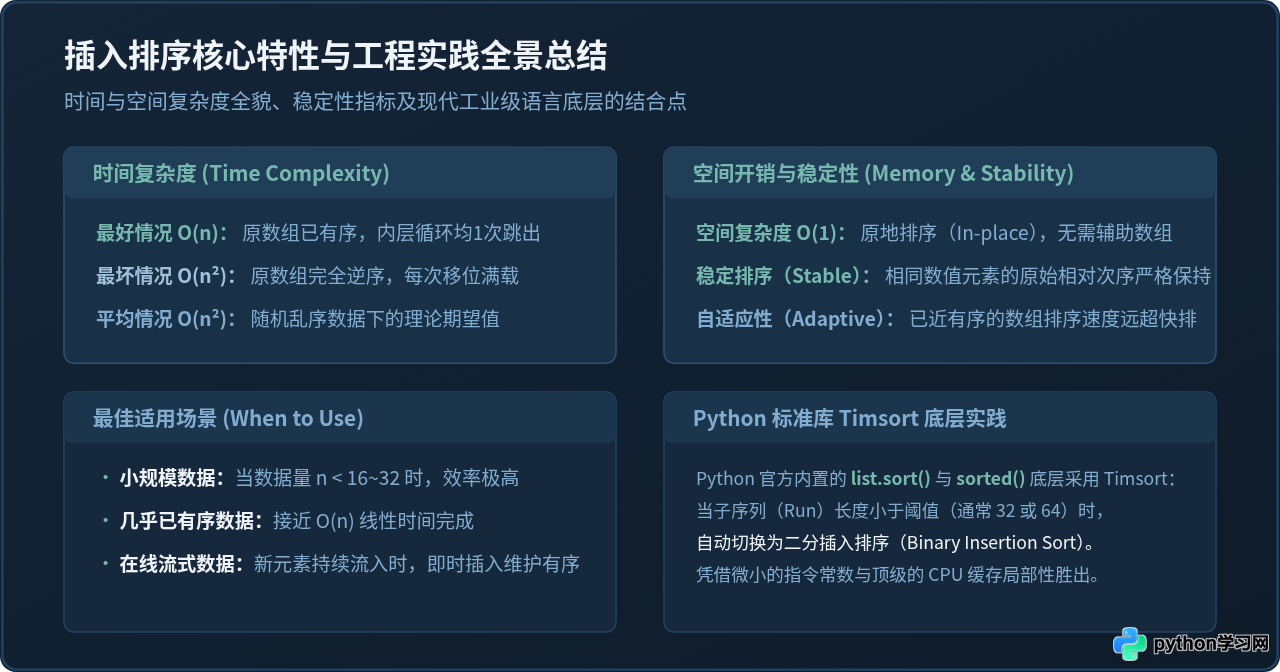
插入排序的理论指标与工程实际场景表现如下表所示:
| 评估维度 | 指标表现 | 具体触发条件与原因分析 |
|---|---|---|
| 最好时间复杂度 | O(n) | 原数组已经基本有序或完全升序时,内层 while 循环每次仅需一次比较即跳出,无元素后移。 |
| 最坏时间复杂度 | O(n²) | 原数组处于完全降序(逆序)状态,每个元素都要完整遍历已排序区间并全量后移。 |
| 平均时间复杂度 | O(n²) | 随机乱序数据集,内层循环平均比较并移动已排序区间的一半长度元素。 |
| 额外空间复杂度 | O(1) | 原地排序(In-place),除了若干临时标量变量(i, j, key)外不占用任何附加数组空间。 |
| 算法稳定性 | 稳定(Stable) | 严格大于判定确保了相等值元素保持原有的相对排列次序。 |
虽然从渐进复杂度上看,快速排序、归并排序的 $O(n \log n)$ 远好于插入排序的 $O(n^2)$,但在现代工程实践中,插入排序依然占据着不可替代的重要地位:
- 极小的数据规模(Small Array):当数据规模较小(例如 $n \le 32$ 或 $64$)时,快速排序和归并排序的递归函数栈调用与分支预测失败开销显著增大,而插入排序由于逻辑简单、具有极其紧凑的机器指令和优秀的数据局部性(连续内存访问命中 CPU L1/L2 缓存),其实际运行速度反而明显快于复杂算法。
- Python 内置 Timsort 算法的基石:Python 官方内置的
list.sort()与sorted()使用由 Tim Peters 发明的混合排序算法 Timsort。Timsort 的底层实现中,当切分出的自然升序/降序片段(Run)长度不足 64 时,就会自动使用二分插入排序(Binary Insertion Sort)将片段补齐至规定长度。正是插入排序的极速小常数特性,支撑了 Python 在真实业务数据排序中的优异性能。 - 流式数据动态维护:如果需要持续接收外部流式数据并动态维持序列有序,新到来的单个数据直接执行一次插入排序的内层逻辑即可在 $O(n)$ 时间内完成增量整理,无需对整体数据重新全量排序。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















