


Python自动化办公有哪些常见应用场景?
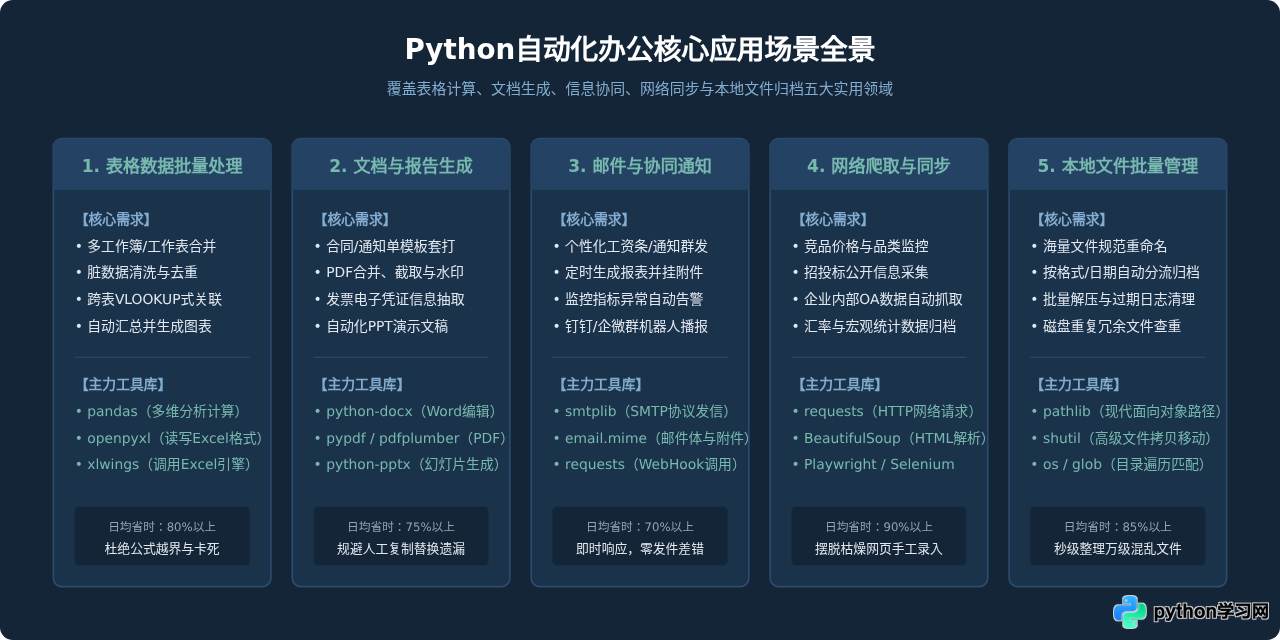
本文系统梳理Python在办公自动化领域的五大核心应用场景,涵盖Excel数据批量清洗合并、Word/PDF文档生成、邮件与即时通讯通知、网络数据采集及本地文件系统整理,提供完整的实战逻辑与代码示例。
假设每个月末,财务或业务运营人员都需要手动打开三十多个来自不同分支机构的Excel表格,逐个复制销售记录、核对格式、计算合计数,再生成结构固定的汇总报表并通过邮件分发给部门主管。这一整套操作不仅枯燥耗时,还极易因人为疲劳产生遗漏或单元格引用错误。Python自动化办公的核心目的,正是通过编写具有确定执行逻辑的代码,将这类规律固定、步骤机械、跨越多种软件格式的日常办公流程转变为一键运行的程序任务。
一、电子表格数据批量处理与自动化报表(Excel / CSV)
在企业办公中,数据最普遍的载体就是电子表格。当面临数十个结构相同但数据分散的工作簿时,传统手工复制不仅极容易漏行漏列,还经常遭遇Excel因计算量过大而卡死的情况。使用Python处理表格数据,不仅运算速度快,而且逻辑可追溯。
1. 典型应用场景
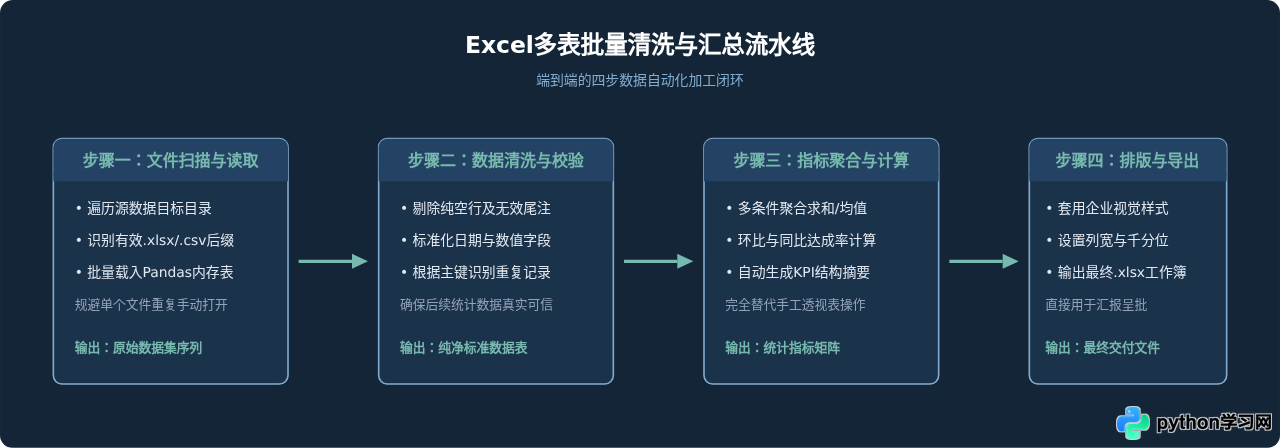
- 跨文件多表合并: 将各个分支网点、销售人员分别提交的日报、月报表格批量读取,自动剔除空行后合并为单一底表。
- 格式规范与脏数据清洗: 批量去除文本中的异常前后空格、统一“2026/10/17”与“2026-10-17”等混杂日期格式、修补缺失值并剔除重复记录。
- 动态计算与指标聚合: 按照部门、地区、月份进行分组多维统计(Groupby),自动计算总销售额、客单价及毛利率。
- 自动化套用样式并输出: 计算完成后,由程序自动给表格表头填充主题色、添加内外边框、设置千分位金额格式,并生成标准汇报工作簿。
2. 核心操作示例:批量合并目录下的销售月报
运行以下示例脚本前,需通过 pip install pandas openpyxl 安装对应依赖库。该脚本会自动扫描指定目录下的全部Excel文件,提取有效数据行并合并保存为一个总表:
import pathlib
import pandas as pd

def batch_merge_sales_reports(source_dir: str, output_file: str) -> None:
    folder = pathlib.Path(source_dir)
    excel_files = list(folder.glob("*.xlsx"))

    if not excel_files:
        print(f"未在目录 {source_dir} 下找到任何待合并的 .xlsx 文件。")
        return

    data_frames = []
    for file_path in excel_files:
        # 排除包含在生成结果中的文件,避免自身被重复累加
        if file_path.name == pathlib.Path(output_file).name:
            continue
        try:
            df = pd.read_excel(file_path, sheet_name=0)
            # 记录来源文件名,便于后续数据审计与溯源
            df["来源文件"] = file_path.name
            data_frames.append(df)
            print(f"成功读取:{file_path.name},行数:{len(df)}")
        except Exception as err:
            print(f"读取文件 {file_path.name} 失败,错误原因:{err}")

    if data_frames:
        merged_df = pd.concat(data_frames, ignore_index=True)
        # 去除全空行与完全重复记录
        cleaned_df = merged_df.dropna(how="all").drop_duplicates()
        cleaned_df.to_excel(output_file, index=False)
        print(f"合并完成!总计有效记录:{len(cleaned_df)} 行,已保存至:{output_file}")
    else:
        print("未提取到任何有效数据。")

# 示例调用
# batch_merge_sales_reports("./sales_data", "./汇总销售年报.xlsx")
二、文档批量生成与排版处理(Word / PDF)
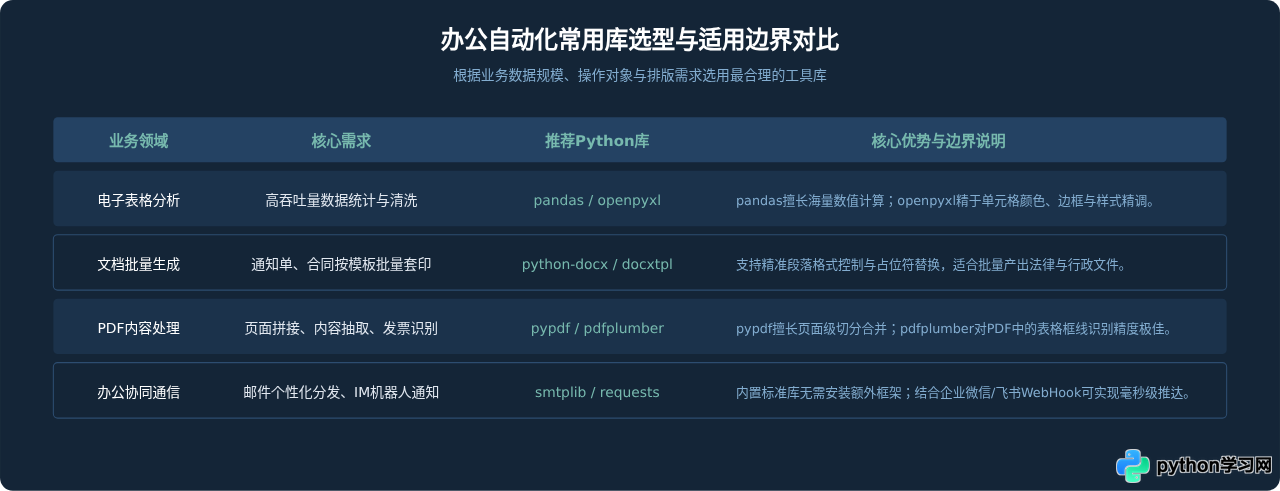
在人力资源、法务及行政岗位中,经常需要依据既有模板向不同对象出具定制文件,例如发放《录用通知书》、更新《劳动合同补充协议》或对海量发票PDF进行归档。
1. 典型应用场景
- Word模板变量套打: 在Word模板中预先设定如
{{姓名}}、{{身份证号}}、{{薪资}}等占位符,读取Excel名单后,一键生成数百份定制Word文件并转换为PDF。 - PDF文件智能合并与分割: 将扫描件中的各页按固定篇幅拆分成独立凭据,或将多个合同附件按顺序拼接为完整档案。
- 发票与电子凭据文本提取: 从大批量增值税电子发票PDF中,自动提取发票代码、号码、开票日期、金额及购买方名称,整理输出为结构化表格。
2. 核心操作示例:批量填充Word模板
以下代码演示如何利用 python-docx 库读取待替换的员工数据字典,自动遍历模板段落并输出个性化文档:
from docx import Document
import pathlib

def generate_custom_letters(template_path: str, employees: list, output_dir: str) -> None:
    pathlib.Path(output_dir).mkdir(parents=True, exist_ok=True)

    for emp in employees:
        doc = Document(template_path)
        # 遍历Word中的每个段落进行文本替换
        for paragraph in doc.paragraphs:
            if "{{姓名}}" in paragraph.text:
                paragraph.text = paragraph.text.replace("{{姓名}}", emp.get("name", ""))
            if "{{岗位}}" in paragraph.text:
                paragraph.text = paragraph.text.replace("{{岗位}}", emp.get("title", ""))
            if "{{入职日期}}" in paragraph.text:
                paragraph.text = paragraph.text.replace("{{入职日期}}", emp.get("date", ""))

        target_file = pathlib.Path(output_dir) / f"录用通知_{emp.get('name')}.docx"
        doc.save(str(target_file))
        print(f"已生成文件:{target_file.name}")

# 示例数据
employee_records = [
    {"name": "张伟", "title": "数据分析师", "date": "2026-11-01"},
    {"name": "李娜", "title": "运营专员", "date": "2026-11-03"},
]
# generate_custom_letters("template.docx", employee_records, "./output_letters")
三、邮件批量分发与协同即时通知
完成报表汇总或文档制作后,下一步通常是交付给具体责任人。人工发信时,经常面临收件人邮箱输错、附件挂错(例如将A员工的薪资表错发给B员工)等严重风险。Python可以通过内置模块建立标准化的自动化发信流程。
1. 典型应用场景
- 工资条/对账单定向分发: 读取后台员工或客户数据,为每个人动态匹配对应的专属PDF账单,并以正文加附件形式单独发送,保障信息私密性。
- 周期性例行报表发送: 结合操作系统定时调度,在每周一上午8点自动提取数据库周报,并向管理层邮箱发送图文并茂的HTML格式邮件。
- 业务系统指标监控告警: 当脚本检测到接口异常、关键指标下滑或服务器空间不足时,自动向企业微信、钉钉或飞书运维群发送WebHook卡片通知。
2. 核心操作示例:发送带附件的HTML格式邮件
import smtplib
from email.mime.text import MIMEText
from email.mime.multipart import MIMEMultipart
from email.mime.application import MIMEApplication
import pathlib

def send_automated_report(smtp_server: str, port: int, sender: str, password: str,
                          receiver: str, subject: str, html_body: str, attachment_path: str = None) -> None:
    message = MIMEMultipart()
    message["From"] = sender
    message["To"] = receiver
    message["Subject"] = subject

    # 添加HTML正文
    message.attach(MIMEText(html_body, "html", "utf-8"))

    # 如果有附件则读取并挂载
    if attachment_path and pathlib.Path(attachment_path).exists():
        file_path = pathlib.Path(attachment_path)
        with open(file_path, "rb") as f:
            part = MIMEApplication(f.read())
            part.add_header("Content-Disposition", "attachment", filename=file_path.name)
            message.attach(part)

    try:
        with smtplib.SMTP_SSL(smtp_server, port) as server:
            server.login(sender, password)
            server.sendmail(sender, [receiver], message.as_string())
        print(f"邮件成功送达至:{receiver}")
    except Exception as err:
        print(f"邮件发送失败:{err}")

# 示例调用
# send_automated_report("smtp.exmail.qq.com", 465, "bot@company.com", "AUTH_CODE",
#                       "manager@company.com", "本周销售简报", "<h3>详情见附件</h3>", "./周报.xlsx")
四、网络数据采集与业务系统数据同步
很多基础业务数据并非直接存储在本地,而是分散在各类政务网站、行业资讯门户或缺乏开放API的老旧内部OA系统中。每日人工登录、查询、复制粘贴往往消耗大量工时。
1. 典型应用场景
- 公开市场行情监控: 定时抓取主流电商平台指定商品的价格变动、销量趋势或用户评价,辅助制定动态定价策略。
- 招投标与政策通知监测: 每日定时扫描行业主管单位的公告页面,抓取最新采购公告,一旦出现预设关键词即自动告警。
- 无API遗留系统的数据导出: 利用
Playwright或Selenium驱动浏览器模拟人工登录内部系统,批量下载指定日期范围的运营原始报表。
合规与礼貌爬取提示: 实施网络数据抓取时,应严格遵守目标网站的Robots协议与法律法规。请求应设置合理的延时间隔(如 1~3 秒),避免高并发对目标服务器带来负荷,并且不得非法获取未经授权的受保护数据。
五、本地文件与文件目录批量管理
在日常电脑使用中,下载目录、扫描归档目录往往堆积了成百上千个命名杂乱、格式混杂的历史文件。Python的标准库提供了非常强大的文件系统操作能力。
1. 典型应用场景
- 按规则批量重命名: 将相机导出的海量照片(如
IMG_001.jpg)根据EXIF拍摄时间批量重命名为20261017_项目现场_001.jpg。 - 自动化目录分拣归档: 扫描指定下载文件夹,自动识别文件扩展名,将
.pdf移动至“文档归档”、.xlsx移动至“数据表格”、.zip移动至“压缩安装包”。 - 磁盘空间冗余清理: 根据文件的MD5哈希值快速查出磁盘上完全重复的内容,或者清理超过90天未访问的临时缓存日志。
2. 核心操作示例:按文件类型自动分拣整理
import pathlib
import shutil

def organize_messy_directory(target_folder: str) -> None:
    folder = pathlib.Path(target_folder)
    if not folder.exists() or not folder.is_dir():
        print("指定目录不存在!")
        return

    # 定义分类映射关系
    category_map = {
        "表格文件": [".xlsx", ".xls", ".csv"],
        "文档资料": [".docx", ".doc", ".pdf", ".txt"],
        "图片素材": [".jpg", ".png", ".svg", ".jpeg"],
        "压缩包": [".zip", ".rar", ".7z", ".tar.gz"]
    }

    for file_path in folder.iterdir():
        # 跳过子文件夹
        if file_path.is_dir():
            continue

        file_ext = file_path.suffix.lower()
        matched = False

        for category, extensions in category_map.items():
            if file_ext in extensions:
                dest_dir = folder / category
                dest_dir.mkdir(exist_ok=True)
                shutil.move(str(file_path), str(dest_dir / file_path.name))
                print(f"已归档:{file_path.name} -> {category}/")
                matched = True
                break

        if not matched and file_ext:
            other_dir = folder / "其它杂项"
            other_dir.mkdir(exist_ok=True)
            shutil.move(str(file_path), str(other_dir / file_path.name))
            print(f"已归档至杂项:{file_path.name}")

# organize_messy_directory("./Downloads")
六、自动化办公落地实施与避坑建议
虽然Python能解决大量重复劳动,但在实际企业落地过程中,如果不加规划盲目编写脚本,往往容易陷入“写脚本两小时,维护修Bug一整天”的困境。建议遵循标准化的实施路径:
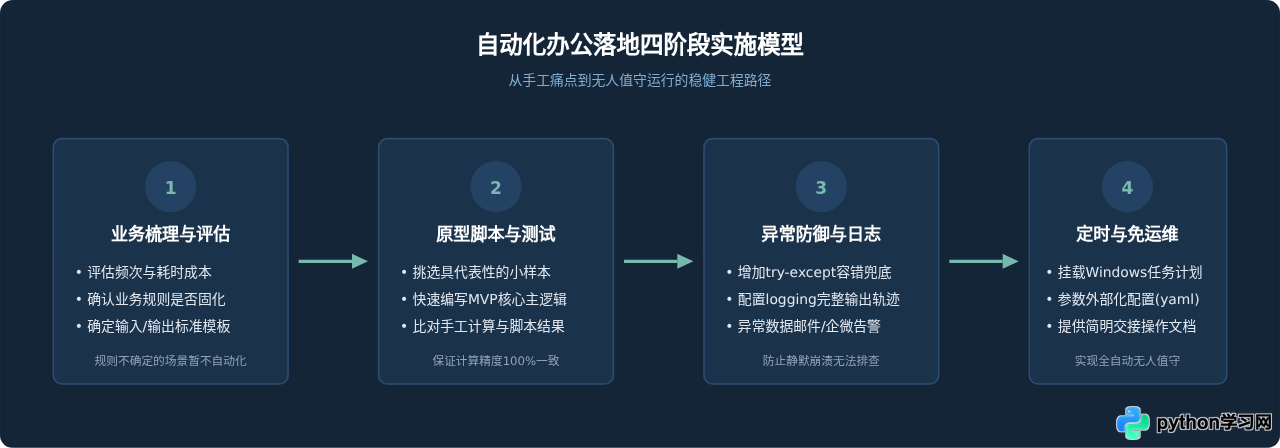
核心避坑原则
- 不可过度依赖完美数据: 办公场景下的原始表单经常存在列名多一个空格、日期写成中文字符等情况。在代码中必须加入针对列名与数据类型的清洗逻辑,例如
df.columns = df.columns.str.strip()。 - 警惕文件被占用异常: 若Excel文件已在桌面软件中打开,Python直接写入会报
PermissionError。编写脚本时应优先考虑导出为新时间戳命名的新文件,或者加入文件写入重试机制。 - 敏感密码与密钥不得硬编码: 邮箱授权码、数据库连接串及WebHook地址应保存在环境变量或外部配置文件中,避免脚本在同事间传递时泄露安全凭据。
总结
Python自动化办公的核心并不是追求复杂的算法模型,而是精准识别日常工作中高频发生、规则清晰的重复机械环节。无论是多源Excel数据的清洗聚合、成百上千份Word合同的快速套打、定时定点的报表邮件推送,还是海量本地文件的秩序化归纳,只要将各环节的基础库工具按标准流水线串联,就能显著降低差错率,将精力释放给真正具备创造力的业务思考之中。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















