


Python schedule库教程:怎么实现轻量级周期定时任务
本教程详细讲解如何使用Python轻量级定时任务库schedule实现周期性任务调度。涵盖核心运行机制、语法速查、参数传递、多线程防阻塞方案及选型边界。
在日常的 Python 脚本编写中,我们经常需要周期性地执行某些任务,比如每隔 10 秒抓取一次监控状态、每隔半小时同步一次文件、或者每天固定时刻发送一份汇总报表。Python 的标准库虽然提供了 time.sleep(),但在处理复杂的时间周期判断时代码容易变得晦涩冗长;而操作系统级的 Crontab 或重量级分布式框架 Celery,对于单脚本或单进程的小应用来说又显得过于笨重。schedule 库正是为此而生的轻量级周期定时任务解决方案,它没有任何第三方重型依赖,使用接近自然语言的声明式语法,能让我们用极低的代码成本在 Python 进程内完成任务调度。
一、理解 schedule 库的工作原理与执行模型
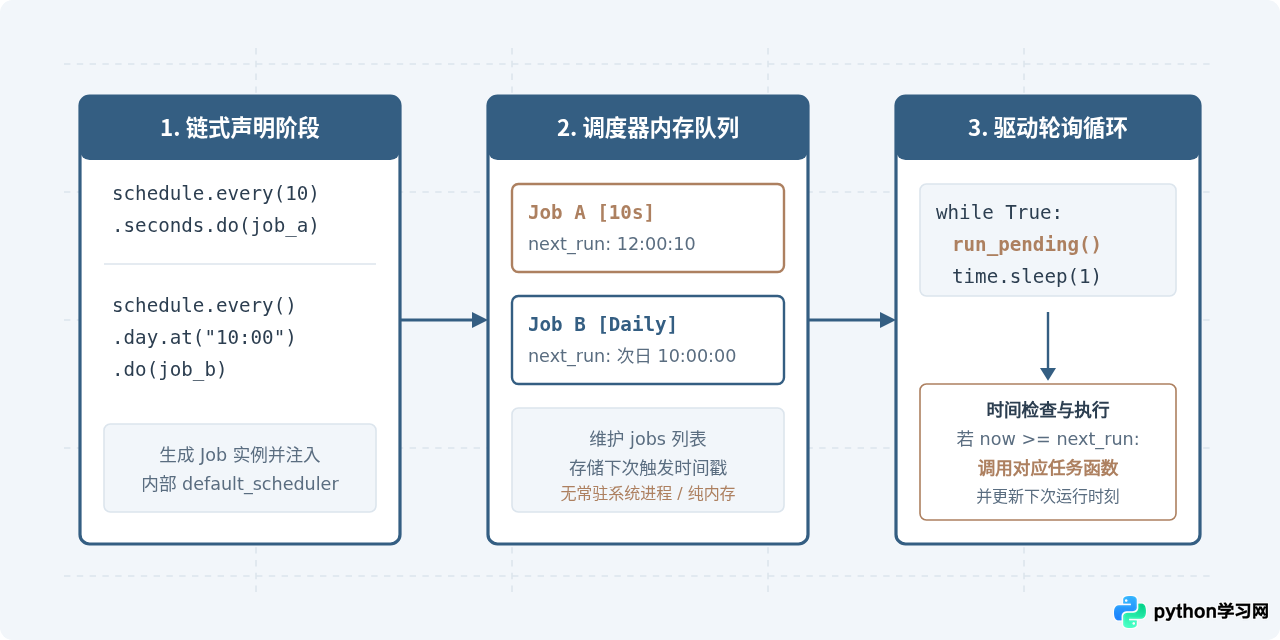
schedule 并不是操作系统的底层守护进程,也不是基于多线程预启动的时钟调度器。它的本质是一个运行在当前 Python 进程内的“内存作业管理器(Job Scheduler)”。在调用 schedule.every()...do(func) 时,库会在内存列表中登记一个包含下次执行时间(next_run)和执行周期的 Job 对象。
驱动这些作业执行的核心是 schedule.run_pending() 方法。我们需要在一个主循环中周期性地调用它(通常搭配 time.sleep(1))。每次调用时,调度器会遍历所有已登记的 Job,对比当前时间戳与任务的 next_run;只要当前时间已经到达或超过预定时间,调度器就会立刻同步执行该任务,并重新计算该任务下一次触发的时间点。
二、标准实施流程:从安装到运行任务
要在一个 Python 脚本中使用 schedule,只需要经过“环境安装、定义目标函数、配置调度规则、启动轮询引擎”四个确定步骤:
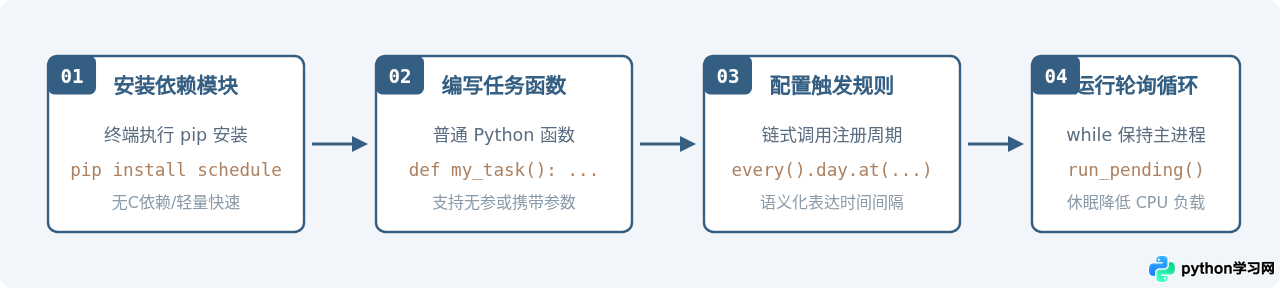
1. 依赖安装
在你的终端或虚拟环境中执行以下命令进行安装:
pip install schedule2. 编写最小可运行示例
下面的脚本定义了两个简单的打印任务,分别演示每隔 5 秒执行一次,以及在每天特定时刻执行:
import time
import schedule

def job_heartbeat():
    print(f"[{time.strftime('%Y-%m-%d %H:%M:%S')}] 心跳检测:服务运行正常")

def job_daily_report():
    print(f"[{time.strftime('%Y-%m-%d %H:%M:%S')}] 每日任务:生成汇总报表")

# 1. 注册每 5 秒执行一次的任务
schedule.every(5).seconds.do(job_heartbeat)

# 2. 注册每天固定 18:30 执行的任务
schedule.every().day.at("18:30").do(job_daily_report)

print("调度器启动成功,正在监听任务...")

# 3. 必须通过主循环主动触发 run_pending
while True:
    schedule.run_pending()
    time.sleep(1)
执行该脚本后,终端会每隔 5 秒输出一次心跳日志。只要主进程不退出,调度循环就会持续按预设的计划判断并触发任务。
三、核心语法与常用调度场景速查
schedule 拥有极其丰富的语义化链式调用接口,几乎覆盖了单机轻量级调度的所有常规周期诉求:
| 调度需求 | 代码示例 | 说明 |
|---|---|---|
| 秒级周期 | schedule.every(10).seconds.do(task) |
每 10 秒运行一次 |
| 分钟级周期 | schedule.every(15).minutes.do(task) |
每 15 分钟运行一次 |
| 小时级固定点 | schedule.every().hour.at(":15").do(task) |
每小时的第 15 分钟触发 |
| 每日固定时刻 | schedule.every().day.at("09:30").do(task) |
每天 09:30 触发(支持 "09:30:15" 秒级格式) |
| 每周特定星期 | schedule.every().monday.at("08:00").do(task) |
每周一上午 08:00 触发 |
| 随机波动范围 | schedule.every(5).to(10).minutes.do(task) |
在 5 到 10 分钟之间的随机间隔执行 |
任务参数传递与单次执行取消
如果目标函数需要接收外部参数,可以在 .do() 方法中顺次传入位置参数或关键字参数:
def greet(user_name, action="打卡"):
    print(f"提醒 {user_name} 进行 {action}")

# 传递位置参数与关键字参数
schedule.every(1).hours.do(greet, "张三", action="填写工时")
如果希望某个任务只在达到条件后执行一次就自动销毁,只需要让任务函数返回 schedule.CancelJob:
def one_time_init():
    print("环境准备就绪,执行初次数据拉取...")
    # 返回 CancelJob 后,调度器会自动将该 Job 从内存队列中移除
    return schedule.CancelJob

schedule.every(10).seconds.do(one_time_init)
四、关键细节与避坑:处理耗时任务的单线程阻塞
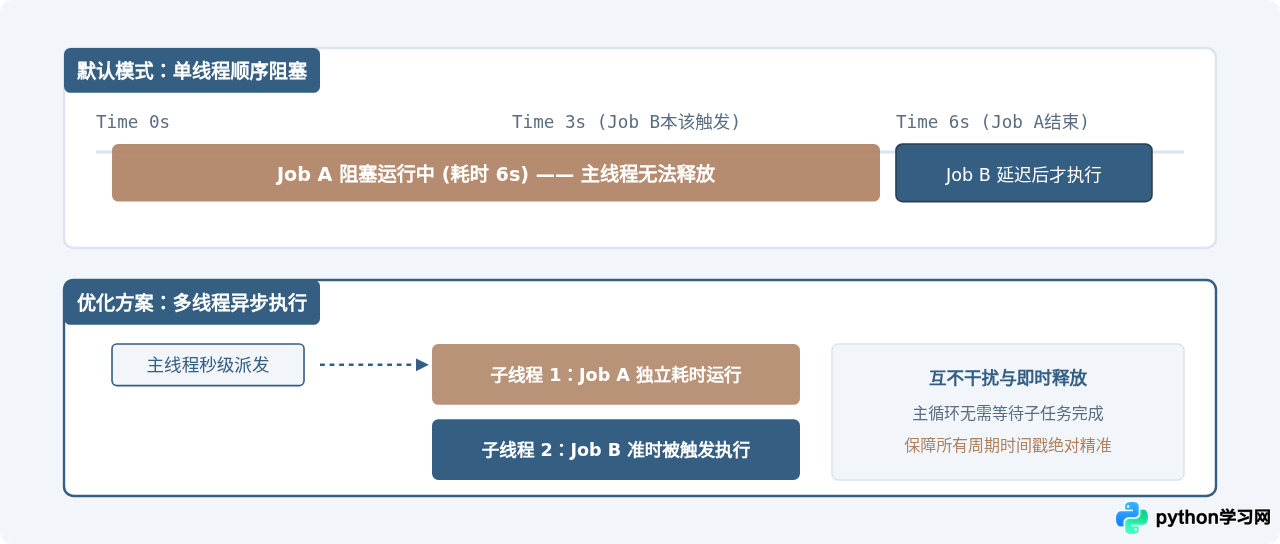
使用 schedule 时最容易踩到的“大坑”,就是任务阻塞导致后续定时全部延误。因为 schedule 默认是在调用 schedule.run_pending() 的当前单线程中同步顺序执行任务的。
假设 Job A 设定为每隔 2 秒执行一次,但某次 Job A 内部执行了复杂的网络请求,耗时花费了 10 秒;在此期间,主循环被完全阻塞在 run_pending() 内部,即使原定每隔 5 秒执行的 Job B 到了触发时刻,也只能排队等待 Job A 彻底返回后才有机会执行,导致所有后续时间戳发生错位。
正确做法:使用 threading 包装执行函数
解决任务耗时阻塞的推荐手段是定义一个辅助函数,将具体作业交给单独的线程去运行:
import threading
import time
import schedule

def run_threaded(job_func, *args, **kwargs):
    """把具体任务派发给独立子线程执行,主循环立即释放"""
    job_thread = threading.Thread(target=job_func, args=args, kwargs=kwargs)
    job_thread.daemon = True
    job_thread.start()

def long_time_task():
    print("开始耗时任务...")
    time.sleep(5)
    print("耗时任务执行完毕!")

def quick_task():
    print("快捷心跳检测触发!")

# 使用 run_threaded 间接执行耗时任务
schedule.every(2).seconds.do(run_threaded, long_time_task)
schedule.every(1).seconds.do(quick_task)

while True:
    schedule.run_pending()
time.sleep(1)在此模式下,run_pending() 调用 run_threaded 后立即返回,主循环不会被 5 秒的 time.sleep 卡死,每秒一次的 quick_task 也能准时触发。
try...except)。如果一个任务在单线程模式下直接抛出未捕获异常,会导致主进程循环崩溃终止,所有后续任务都将彻底停止调度。
五、选型对比:什么时候适合使用 schedule 库
在 Python 生态中,定时任务的实现手段非常多样。为了避免在不恰当的场景下误用 schedule,我们需要清晰理解它与其他工具的适用边界:
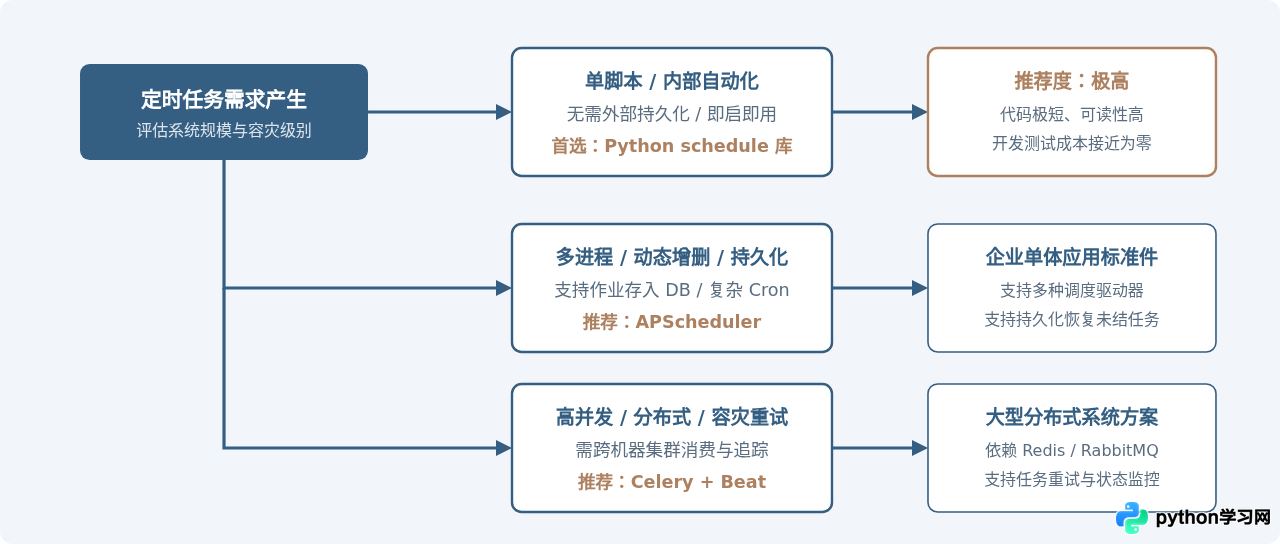
六、总结与落地建议
对于大部分不需要数据库做状态持久化、不需要跨服务器集群协调的本地运维脚本、爬虫任务或测试自动化工具来说,schedule 提供了最为优雅且易读的实现方式。它摆脱了底层时间戳与 sleep 间隔的繁琐数学换算,让开发者能像写英语句子一样定义周期任务。
在工程化落地时,牢记以下三条最佳实践原则:
- 主循环保留轻微休眠:在
while True中务必加入time.sleep(1),避免空转耗尽单核 CPU 100% 算力。 - 异步化耗时逻辑:但凡涉及文件 I/O、网络请求、批量数据处理等耗时超过 0.5 秒的操作,一律配合
threading.Thread异步执行。 - 做好全局异常隔离:在被调度的函数内部使用完整的异常捕获块,防止个别非预期报错打崩整个常驻进程。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















