


Python报错SyntaxError:误用&&代替and的解决方法
针对Python中误用&&导致SyntaxError: invalid syntax的问题,提供直接修复方案、词法解析原理解释、and与位运算&的区别以及规范写作实践。
在编写条件判断语句时,从C、Java、JavaScript或PHP等语言转向Python的开发者常习惯使用 && 连接多个布尔条件。在Python中运行此类代码会立即抛出 SyntaxError: invalid syntax。本文说明导致该错误的机制、直接修复方式以及相关语法的正确选型。
直接解决方案与代码对比
在Python中,逻辑“与”运算对应的官方保留关键字是英文单词 and,而不是双与符号 &&。Python语法分析器中不存在 && 这一运算符定义,因此代码在编译成字节码前就会直接报语法错误。
修复此问题的唯一且直接的方法:将条件表达式中的所有 && 替换为标准的 and。
错误示范代码:
# 错误示例:使用 && 连接条件
score = 85
if score >= 60 && score <= 100:
    print("成绩合格")
执行后控制台输出:
  File "check_score.py", line 3
    if score >= 60 && score <= 100:
                    ^
SyntaxError: invalid syntax
正确修复代码:
# 正确写法:使用关键字 and
score = 85
if score >= 60 and score <= 100:
    print("成绩合格")
解析机制:为什么会触发 SyntaxError
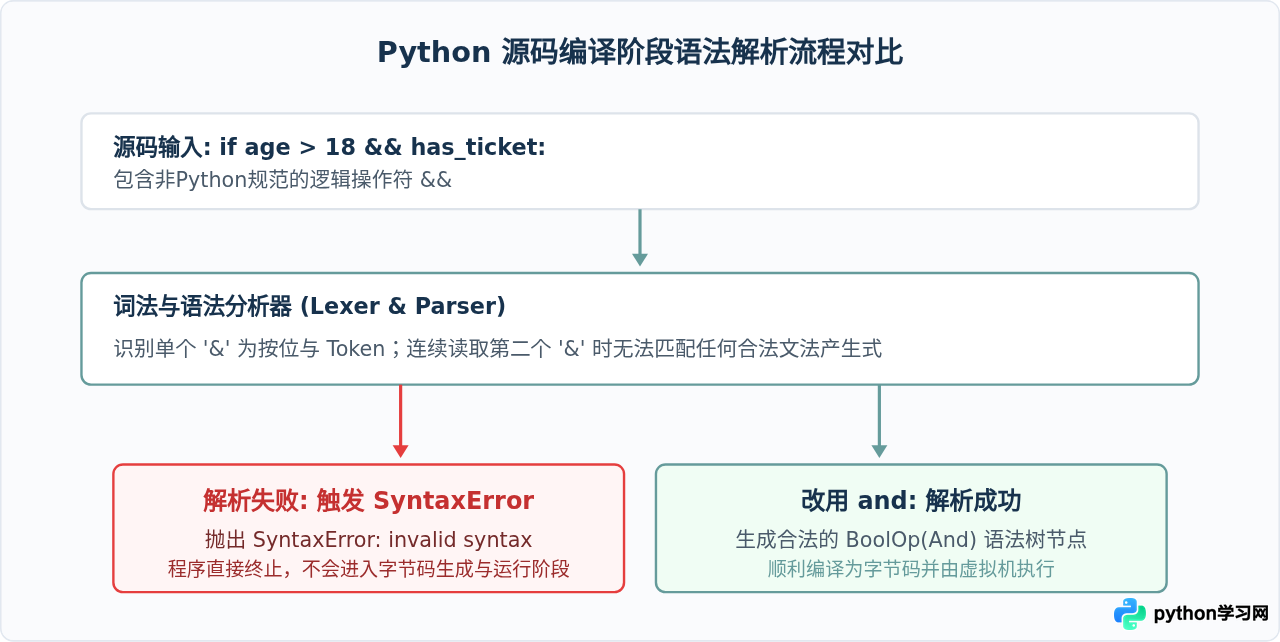
Python代码在被虚拟机执行前,必须先经过词法分析(Lexical Analysis)和语法解析(Parsing)阶段。Python的词法解析器仅将单个 & 识别为按位与(Bitwise AND)运算符 Token,符号表和文法定义中完全没有 && 的词法条目。
当解析器扫描到第一个 & 时,它将其视为二元位运算符;但紧接着遇到第二个 & 时,无法构成合法的语法树节点,因而无法继续构建抽象语法树(AST),立即中断并抛出 SyntaxError。这意味着代码根本没有进入实际运行阶段,程序在解析文件时就已经终止。
定位、排查与修复的标准步骤
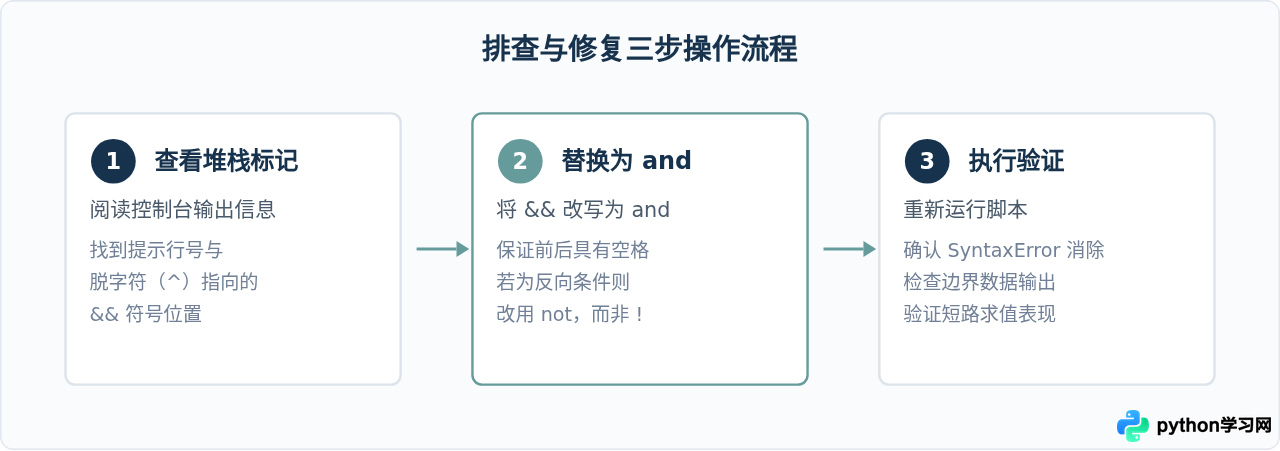
在较大项目中排查该错误时,请遵循以下三个确定性步骤:
- 定位终端报错行号与错误标记:观察Traceback信息,Python会精准打印出问题代码所在的行号,并在报错符号下方用脱字符(
^)指出语法违规的具体起点。 - 审视逻辑意图并执行字符替换:核实该处原本的布尔判断逻辑,将多条件之间的
&&改为and;如果是多行长条件,注意关键字的前后空格。 - 运行测试套件与执行验证:重新执行该模块或对应的单元测试,确认语法错误消除,并验证在短路求值场景下的逻辑输出符合预期。
语法差异对比:and、&& 与单符号 &
许多初学者在意识到 && 报错后,容易产生另一个误区:直接将 && 改为单符号 &。在Python中,& 是完全合法的运算符,代码不会报语法错误,但这会导致更加隐蔽的逻辑缺陷或类型错误(TypeError)。
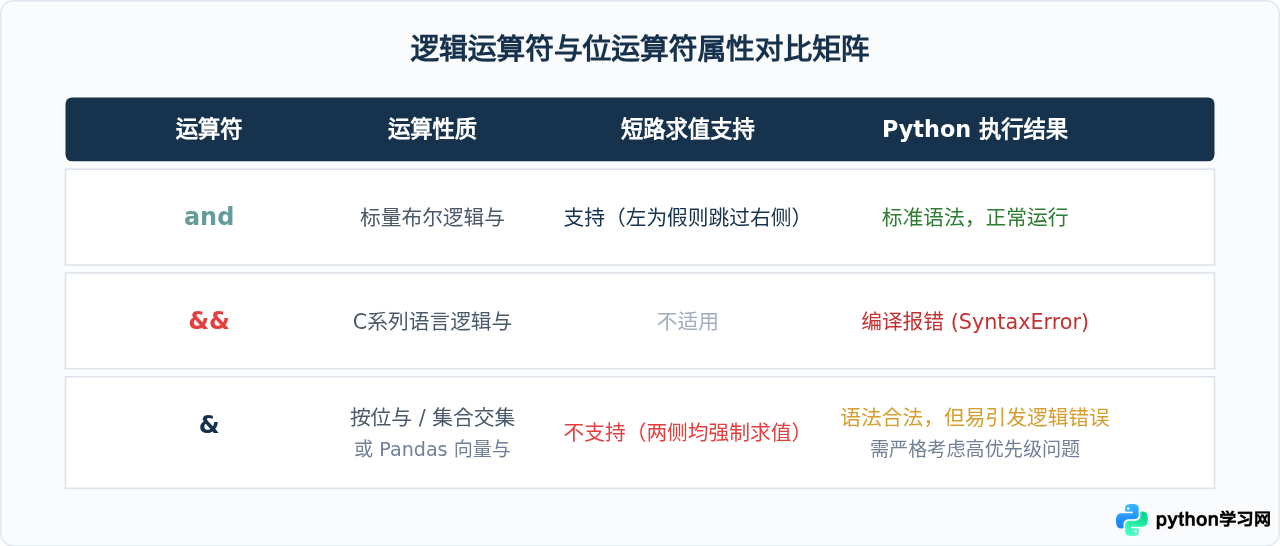
三者在底层行为、运算类型与优先级上存在本质区别:
and(逻辑与):用于布尔逻辑判断。支持短路计算(Short-circuit evaluation)。如果左侧表达式为假,右侧表达式不会被执行;返回决定表达式结果的操作数本身。&&:常见于C/C++、Java、C#、JavaScript等语言。在Python中为非法字符序列,直接触发SyntaxError。&(按位与):用于整数二进制位运算或集合交集运算。在处理标量布尔判断时不支持短路计算,且优先级极高(高于比较运算符>、<、==)。
避坑警示:不要用 & 充当标量条件判断
如果在判断式中书写 if a > 0 & b > 0:,由于 & 的优先级高于 >,Python会优先计算 0 & b,原式实际等价于 if a > (0 & b) > 0:,这将导致完全偏离预期的计算结果。
进阶场景与语法选型指南
在实际开发中,除了基础的 and 逻辑连接,Python还提供了更优雅的习语表达,同时在特定科学计算库中对符号有特殊要求:
1. 数值区间判断:使用链式比较(Chained Comparison)
如果使用 and 是为了判断一个数值是否处于某个闭区间,Python支持类似数学公式的链式比较写法。这比显式书写 and 更紧凑,且语义清晰:
# 传统 and 写法
if score >= 60 and score <= 100:
    pass

# Python 推荐的链式比较写法
if 60 <= score <= 100:
    print("成绩在60到100之间")
2. 数据分析场景:Pandas / NumPy 中的特殊规则
当处理 Pandas Series 或 NumPy 数组时,不能使用 and 关键字,因为 and 要求对整个容器对象的真值进行评估,会抛出 ValueError: The truth value of a Series is ambiguous。此时必须使用重载后的按位运算符 &,且各个子条件必须使用小括号显式包裹以确保优先级正确:
import pandas as pd

df = pd.DataFrame({'age': [15, 25, 40], 'score': [80, 90, 60]})

# 正确:在 DataFrame 过滤时使用 & 并加括号
qualified = df[(df['age'] >= 18) & (df['score'] >= 80)]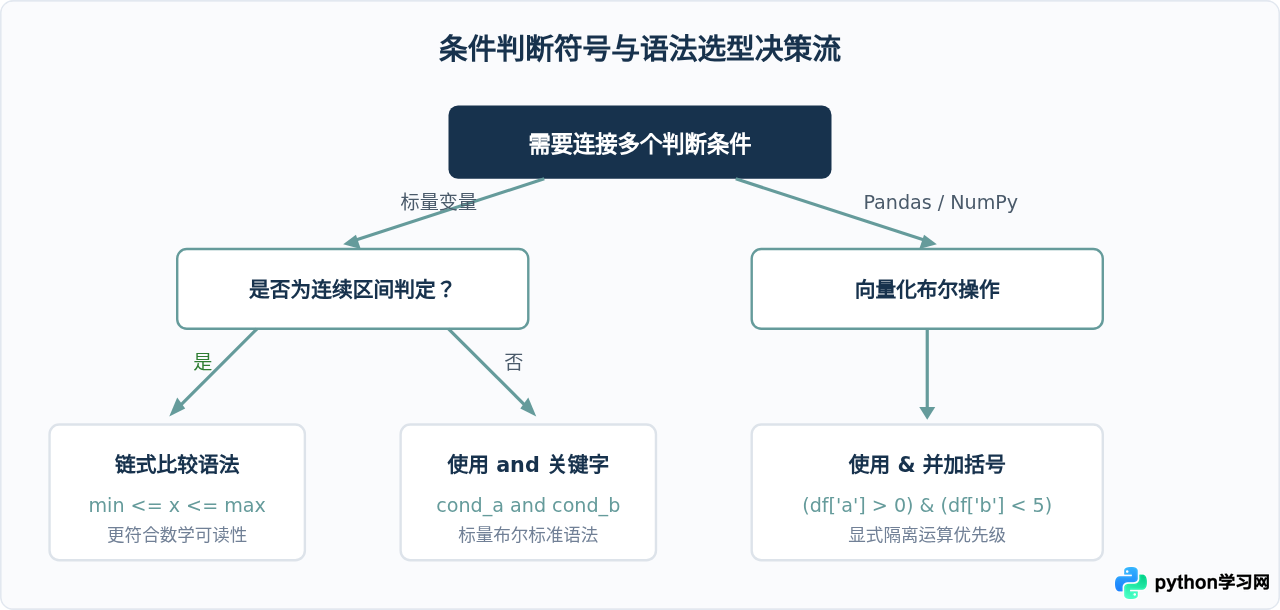
总结与速查清单
处理此类语法报错的核心原则可以归结为以下三点:
- 符号替代:在普通标量条件中,彻底放弃其他编程语言中的
&&、||、!符号惯性,全面转换为 Python 关键字and、or、not。 - 避免误用
&:普通if条件分支严禁使用单个&代替and,以规避运算优先级颠倒和缺乏短路机制带来的潜在Bug。 - 区间与向量适配:区间判定优先使用链式比较表达式;仅在涉及 Pandas 或 NumPy 数组过滤时采用带有括号隔离的按位与
&运算。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















