


中文译本还是英文原版?自学Python高阶技术书籍的阅读选择建议
针对自学Python高阶技术书籍时的版本选择难题,系统分析中文译本与英文原版的核心优劣、适用场景与决策路径,提供双本协同精读方法与避坑建议。
一、中文译本与英文原版的核心差异与代价权衡
进入 Python 进阶阶段后,开发者所面对的书籍(如《Fluent Python》《Python Cookbook》《CPython Internals》等)不再只是罗列基础语法,而是大量探讨元类编程(Metaprogramming)、描述符协议(Descriptor Protocol)、异步事件循环(Asyncio Event Loop)以及 CPython 内存布局。在这一层面上,阅读语言的选择直接决定了知识吸收的准确率与自学完成率。
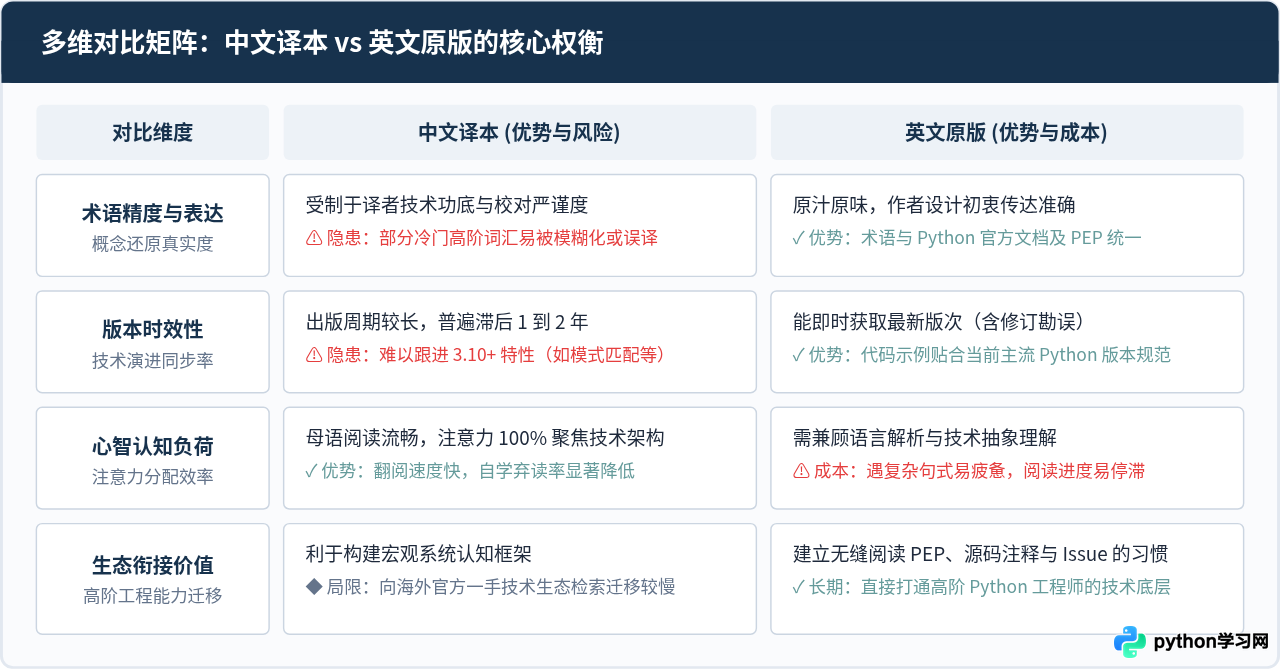
中文译本与英文原版在自学场景中的权衡主要体现在四个维度:
- 术语准确度与行文顺畅度:高阶 Python 涉及大量惯用法与系统术语。高质量译本能消除长难句阻碍,但平庸译本常出现直译、硬译甚至倒错(例如将“duck typing”生硬直译、把“generator expression”与“list comprehension”混为一谈),导致读者误入歧途。
- 版本更新与技术时效:技术图书从外文定稿到中文版出版通常需要 12 至 24 个月。在这期间,Python 语言本身可能已历经一次大版本更新(如结构化模式匹配、类型提示系统增强、异常组等),中译本往往停留在旧版本规范。
- 心智认知负荷:阅读本身需要理解复杂的抽象逻辑。若读者的英文技术阅读速度低于每分钟 100 词,英语语法分析将占据大量工作记忆,导致无力深究代码与架构本质,引发中途放弃。
- 长远技术生态适应:Python 官方文档、PEP 增强提案、最新开源库源码注释均为英文。适度接触原版有助于建立地道的技术语感与检索习惯。
二、自学读者的四步决策路径与选择模型
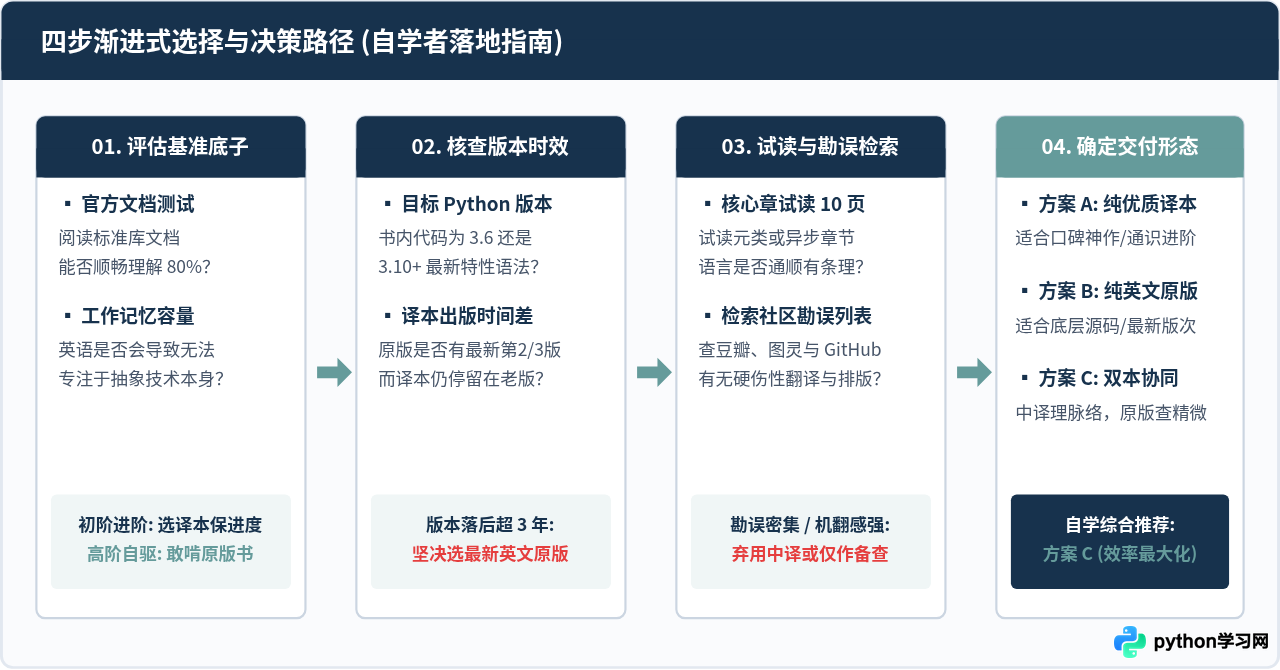
面对一本厚度动辄六七百页的 Python 进阶书籍,切忌单凭一时兴致盲目直接购买英文版,也不要未经考察直接下单老旧译本。建议自学者按照以下四个步骤进行理性评估:
- 步骤一:评估个人技术储备与语言负荷阈值
自测技术英语阅读能力:若打开 Python 官方文档中的标准库说明(如collections.abc或inspect模块),能在不借助翻译插件的情况下顺畅理解 80% 以上的描述,则具备通读英文原版的基础;若每读两句话就要查词典,请务必先选中文译本。 - 步骤二:核查目标图书的技术版本生命周期
检查图书所对应的 Python 版本。例如《Fluent Python》第一版对应 Python 3.4,第二版对应 Python 3.10。若目标中译本是第一版而英文原版已有第二版,必须毫不犹豫选择第二版英文原版,因为两版之间关于类型注解、类型提示(Generics)和异步编程有本质变迁。 - 步骤三:执行“10页试读与公开勘误检索”
翻开中文译本前言、目录及核心章节(如元编程或生成器章)前 10 页。重点观察:句子是否通顺、是否存在明显的机器直译腔调、技术专有名词是否有英文对照。同时前往 GitHub、豆瓣读书或图灵社区搜索“书名 + 勘误”,若勘误表很长且涉及大量代码打印错误,应果断以原版为主。 - 步骤四:确定最终阅读实施形态
根据前三步的判断,在“纯中文快速消化”、“纯原版深度啃读”与“双本对照精读”三种方案中锁定行动策略。
三、“双本协同”精读高阶 Python 书籍的具体操作方法
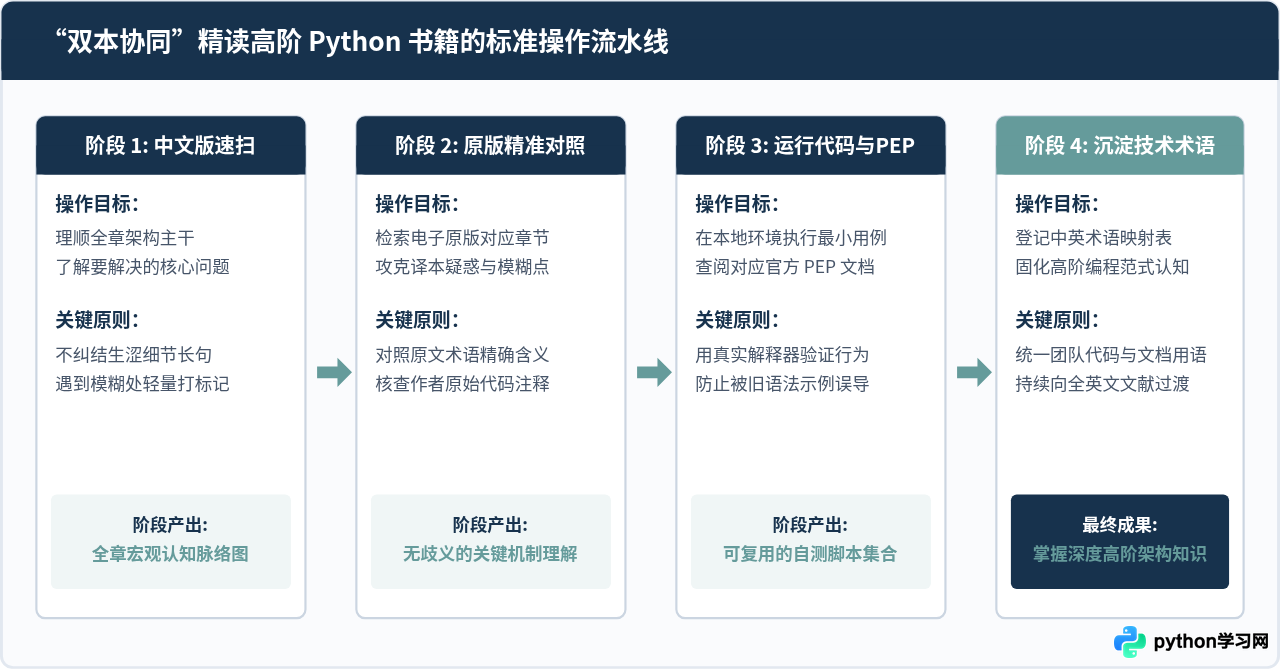
对于绝大多数自学 Python 的工程师,“双本协同”(纸质中文译本 + 电子英文原版)是效率最高、认知损耗最小的操作模式。该方法通过分离“宏观概念理解”与“微观语法求证”,实现快速通读与精确吸收的平衡。
1. 协同操作四步流水线
- 步骤一:母语扫读建立知识索引(速通)
打开中文译本,以较快速度通读整章。此阶段的核心任务是弄清作者的论述脉络:本章要解决 Python 中的什么痛点?核心类库是什么?其顶层抽象模型如何?遇到翻译拗口处先做标记,不反复回读。 - 步骤二:原版底本攻坚核心难点(精准)
遇到 Python 核心底层机制(如__set_name__、描述符查找顺序、async def的挂起机制)或读译本感到逻辑含糊时,立即在电子原版中用关键字(如__get__)精确定位对应章节,对照原文的英语原文表述,消除误译干扰。 - 步骤三:编写可运行示例与 PEP 交叉验证(落地)
书本上的所有关键机制必须在本地 Python 交互式命令行或代码文件中亲自实现一次,并对照 Python 官方 PEP 提案(如关于描述符的 PEP 252、关于结构化模式匹配的 PEP 634)进行验证。 - 步骤四:沉淀个人双语术语映射卡(内化)
将本章的关键术语以“英文原词 - 标准中文 - 机制本质”记录,形成长期可查的技术卡片。
2. 实操演示:如何通过代码与规范验证解决版本与术语分歧
以 Python 高阶知识中的“描述符(Descriptor)”为例。在某些较旧的中译本中,常常要求在 __init__ 中手动传入托管属性名称,代码繁琐且极易出错;而现代 Python 规范(PEP 487,Python 3.6+ 引入并在高阶书籍原版中详述)引入了 __set_name__ 钩子方法。在自学时,若仅读老旧译本,极易漏掉这一重大演进。
# 环境要求:Python 3.10+
# 验证目标:现代 Python 描述符协议的核心规范与错误拦截

class NonNegative:
    """描述符类:自动绑定属性名称并拦截非法赋值(PEP 487 规范)"""
    def __set_name__(self, owner, name):
        # 英文原版强调:__set_name__ 会在宿主类创建时被内置机制自动调用
        self.storage_name = f"_{name}"

    def __get__(self, instance, owner=None):
        if instance is None:
            return self  # 类属性直接访问时返回描述符本身
        return getattr(instance, self.storage_name, 0)

    def __set__(self, instance, value):
        if not isinstance(value, (int, float)):
            raise TypeError(f"属性 {self.storage_name[1:]} 必须是数值类型")
        if value < 0:
            raise ValueError(f"属性 {self.storage_name[1:]} 不能为负数(给定值: {value})")
        setattr(instance, self.storage_name, value)

class Product:
    # 使用描述符管理高阶业务实体属性
    price = NonNegative()
    weight = NonNegative()

    def __init__(self, name: str, price: float, weight: float):
        self.name = name
        self.price = price
        self.weight = weight

# 运行与验证
if __name__ == "__main__":
    p = Product("Python架构书籍", price=99.0, weight=1.5)
    print(f"商品创建成功: {p.name}, 价格: {p.price}, 净重: {p.weight}")

    try:
        p.price = -10.0  # 触发异常防御逻辑
    except ValueError as err:
        print(f"验证拦截成功 (预期输出): {err}")
owner 翻译成“持有者”或“主人”,而原版中指代的是当前的宿主类(Class object)。配合实际代码验证,读者能一眼看出 owner 是 Product 类本身,而非 Product 的实例 p。
四、自学高阶书籍常见的版本认知误区与避坑指南
在自学技术书籍的实践中,很多开发者往往因陷入以下几个常见误区而消耗了宝贵精力:
- 误区一:盲目信奉“原版崇拜”,造成进度永久卡死。
很多自学者受到“真正的大牛只读英文原版”的说教影响,即使阅读英文极其吃力,也强迫自己硬啃 800 页的纯英文教材。结果一个月只看了两章,不仅没掌握元编程,反而打击了自学信心。纠正做法:如果一个章节涉及的是通识性设计模式,直接读高质量中文译本迅速形成宏观印象,把有限的英文阅读精力留给最前沿的核心底层。 - 误区二:无视中译本出版年份,死啃已被弃用的陈旧语法。
部分销量很高的经典中译本可能出版于 2016 年甚至更早(针对 Python 3.4/3.5),书中关于异步@asyncio.coroutine和yield from的讲解在 Python 3.8+ 已经被弃用,在 3.11 中已被完全移除。纠正做法:看译本前务必看版权页的“原书出版年份”,凡涉及异步、类型系统(Typing)和并发等快速演进特性的主题,必须对照最新原版目录。 - 误区三:只读文字不跑代码,忽视原作者与译者的注释出入。
高阶书中最精妙的内容往往隐藏在代码块周围的“数字上标/小注”中。有些译本在排版时可能将代码注释直接省略或错译。纠正做法:永远以 GitHub 上作者官方开源的代码仓库(Repo)为准,将示例在本地解释器中敲一遍,绝不只进行纸上阅读。
五、进阶场景决策矩阵与能力进阶建议
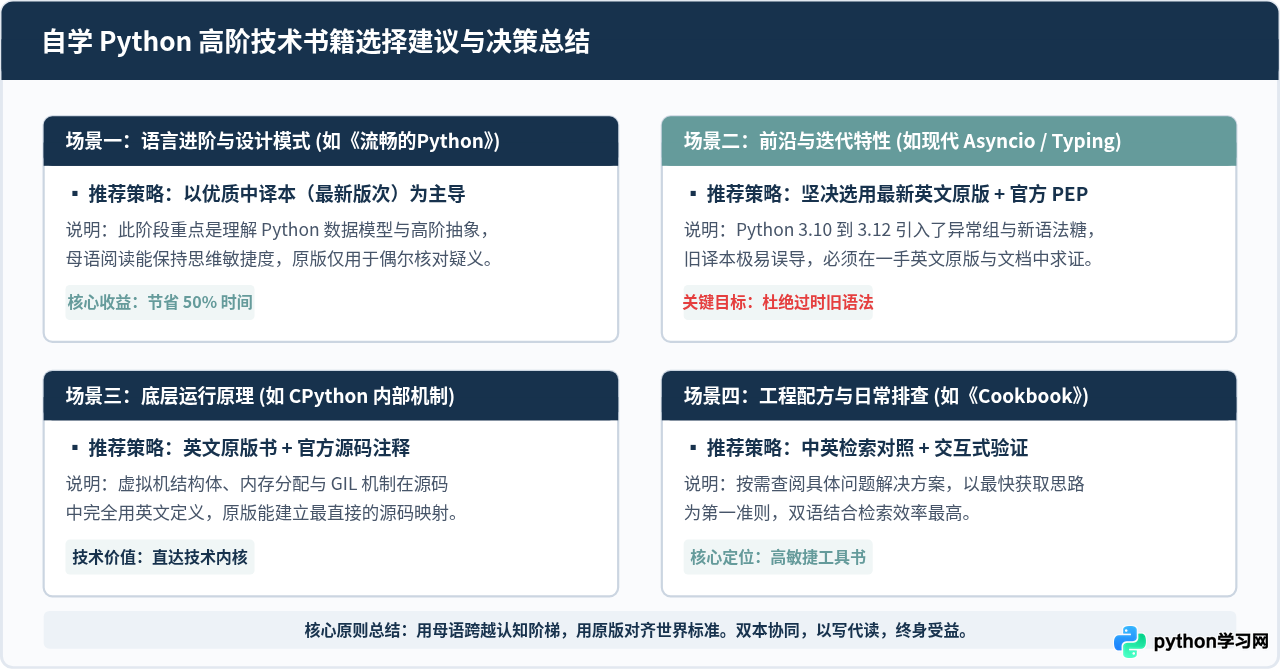
为了让读者能够根据当前正在阅读的具体书目迅速做出取舍,下表整理了四类典型 Python 高阶技术书目的选择策略:
| 学习场景 / 目标主题 | 代表性经典著作 | 首选推荐版本 | 推荐理由与操作建议 |
|---|---|---|---|
| Pythonic 惯用法与语言全貌 | 《Fluent Python》(流畅的Python) | 中译本第2版 + 原版电子书查漏 | 第二版中译本翻译质量扎实,全面涵盖 Python 3.10 特性,用中文通读省时高效。 |
| 工程实践与疑难排查配方 | 《Python Cookbook》 | 开源中文协作翻译版 | Cookbook 为词条/配方化结构,短小独立,开源社区版本更新频繁且易于搜索。 |
| CPython 虚拟机与解释器底层 | 《CPython Internals》 | 英文原版最新版 | 涉及 C 源码宏定义、GIL 演进与解释器分支优化,中文市面罕有高质量译本,原版更为严谨。 |
| 高并发与现代网络编程 | 《Using Asyncio in Python》 | 英文原版 | Python 异步生态(TaskGroup, ContextVars)变化极大,中文出版滞后明显,必须读一手英文文献。 |
六、自学者执行备忘清单
当你准备翻开下一本 Python 高阶技术著作时,可直接对照以下清单落实执行:
- 购书前:查清该书对应的 Python 大版本,检查中文译本版次是否与最新原版一致;
- 开读前:准备好电子版原版 PDF/ePub,确保全局全文搜索功能可用;
- 阅读中:以中文译本为骨架建立思维模型,遇到关键协议或晦涩语句,立即切到原版对齐英文术语;
- 精读后:在本地 Python 3.10+ 环境中跑通示例代码,记录一份专属个人的 Python 技术词汇英汉映射表。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















