


Python写入JSON文件时中文显示为Unicode编码怎么解决

详细讲解在Python中写入JSON文件时中文字符被自动转义为Unicode编码(如\u4e2d\u6587)的原因与完整解决方案,通过代码示例、流程图解与常见排错指南,帮助读者彻底解决中文JSON读写问题。
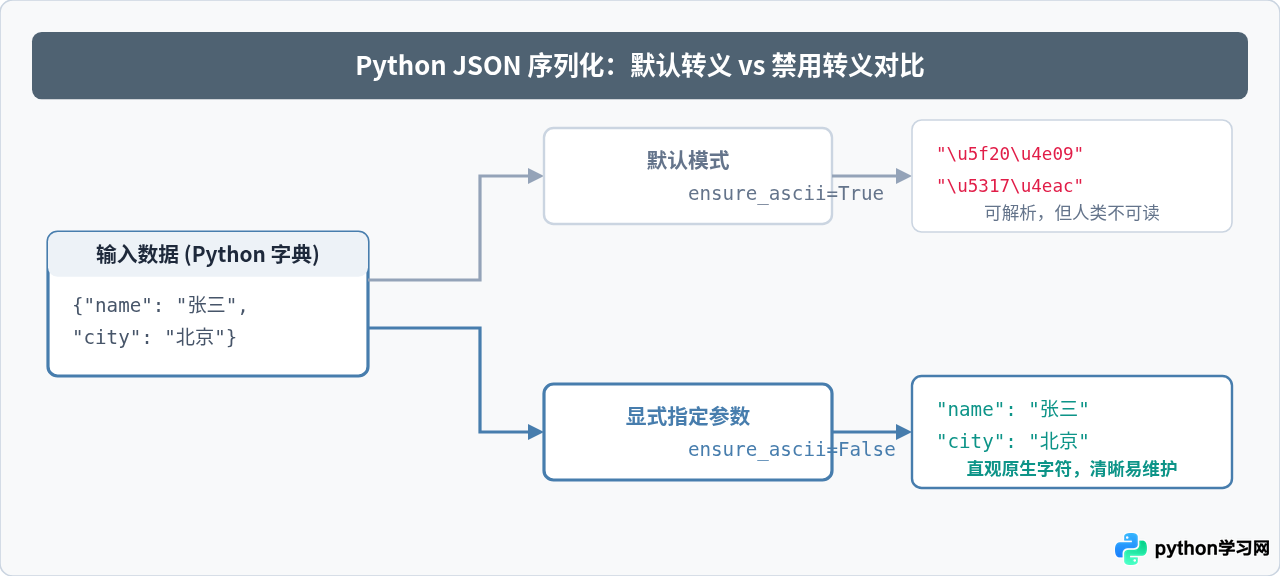
在 Python 中使用内置的 json 模块写入文件时,中文字符默认会被自动转换成形如 \u4e2d\u6587 的 Unicode 转义序列。要让 JSON 文件直接保存并显示清晰可读的中文字符,核心解决办法是:在调用 json.dump() 或 json.dumps() 时显式传入参数 ensure_ascii=False,同时在 open() 打开文件时指定 encoding='utf-8'。这两个配置协同作用,即可彻底避免非英文字符被转义和由于系统默认编码引起的乱码问题。
Unicode 转义现象与核心解决方案
许多初学者在第一次将含有中文的字典或列表写入本地 JSON 文件时,打开文件往往会看到类似下面的内容:
{"title": "\u6d4b\u8bd5\u6587\u7ae0", "author": "\u5f20\u4e09"}虽然这种格式能够被大多数 JSON 解析器正常读回为中文,但在日常开发、日志排查、配置文件维护或接口交付过程中,人类无法直接肉眼阅读这些转义串,大大降低了维护效率。核心解决代码非常简洁,只需在常规写入代码中加入两个关键参数:
import json

data = {
    "title": "测试文章",
    "author": "张三",
    "tags": ["编程", "Python", "数据存储"]
}

# 核心写法:指定 ensure_ascii=False 并明确 encoding='utf-8'
with open("article.json", "w", encoding="utf-8") as f:
    json.dump(data, f, ensure_ascii=False, indent=4)
执行这段代码后,生成的 article.json 文件将直接保存为正常中文:
{
    "title": "测试文章",
    "author": "张三",
    "tags": [
        "编程",
        "Python",
        "数据存储"
    ]
}
深入剖析:为什么 Python 默认会转义中文字符
了解这一现象的技术原因,有助于我们在不同场景下做出合适的架构选择。Python 的 json 模块遵循互联网工程任务组制定的早期 JSON 规范(如 RFC 4627/7159)。
在早期的网络协议中,许多数据传输管道(如历史邮件协议和旧式终端通信)仅支持 7 位 ASCII 编码。如果直接在报文中传输高位字符(例如 UTF-8 的双字节或三字节中文字符),容易被中间路由或不兼容的系统篡改甚至拦截。
为了保证最大程度的跨系统兼容性,Python 标准库将 ensure_ascii 的缺省值设定为 True。在此设置下:
- 所有的 ASCII 字符(英文字母、数字和常规英文标点)原样输出。
- 所有非 ASCII 字符(包括中文、日文、特殊表情符号等)都会被自动转换为 Unicode 转义格式
\uXXXX。
转义后的文件纯粹由 ASCII 字符构成,虽然安全,但在现代软件工程中,全链路 UTF-8 已经成为业界事实标准,盲目保留默认转义往往造成文件体积冗余,且给开发者人工核对带来极大不便。
标准操作流程与完整代码实现
在实际工程中,写入中文 JSON 文件并非单独调整一个参数即可,而是需要文件操作函数与序列化函数的共同配合。
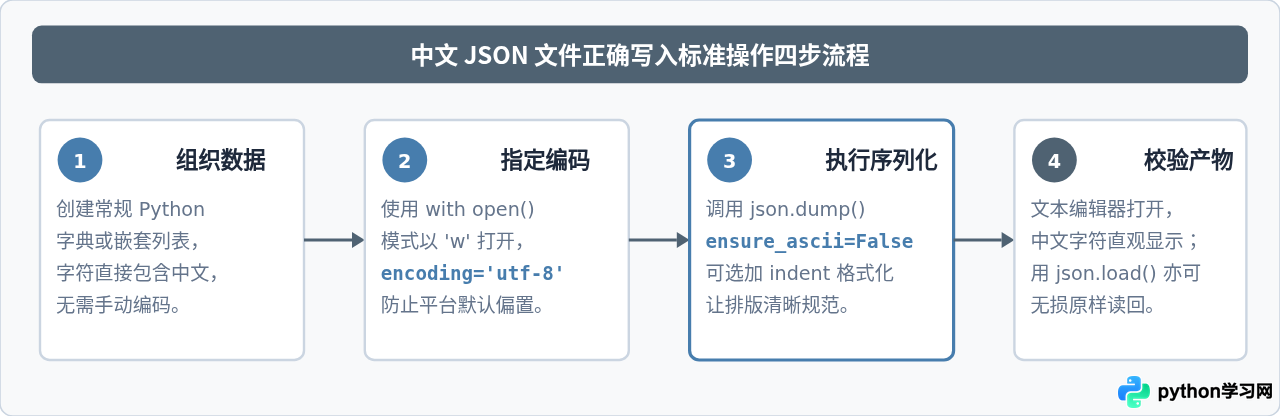
1. 写入文件:json.dump 标准写法
如果要将数据直接保存为物理文件,使用 json.dump() 是最推荐的方式,内存占用更低,写入速度快:
import json

user_profile = {
    "id": 10086,
    "nickname": "极客小明",
    "department": "人工智能研发中心",
    "city": "杭州",
    "active": True
}

# 最佳实践模版
target_file = "user_info.json"
with open(target_file, mode="w", encoding="utf-8") as file:
    json.dump(user_profile, file, ensure_ascii=False, indent=2)

print(f"数据已成功写入 {target_file}")
2. 生成字符串:json.dumps 标准写法
如果不需要直接写盘,而是需要将 JSON 作为字符串传递给网络请求或存入数据库,应使用 json.dumps():
import json

payload = {
    "status": "success",
    "message": "任务执行完成",
    "detail": "成功处理 128 条中文数据"
}

# 生成中文字符串
json_string = json.dumps(payload, ensure_ascii=False)
print("生成的 JSON 文本:", json_string)
# 输出: 生成的 JSON 文本: {"status": "success", "message": "任务执行完成", "detail": "成功处理 128 条中文数据"}
常见报错与异常排查指南
许多开发者在尝试解决中文显示问题时,仅仅加上了 ensure_ascii=False,但随后遇到了其他的编码报错或乱码现象。以下是三种最常见的问题与定位方案。
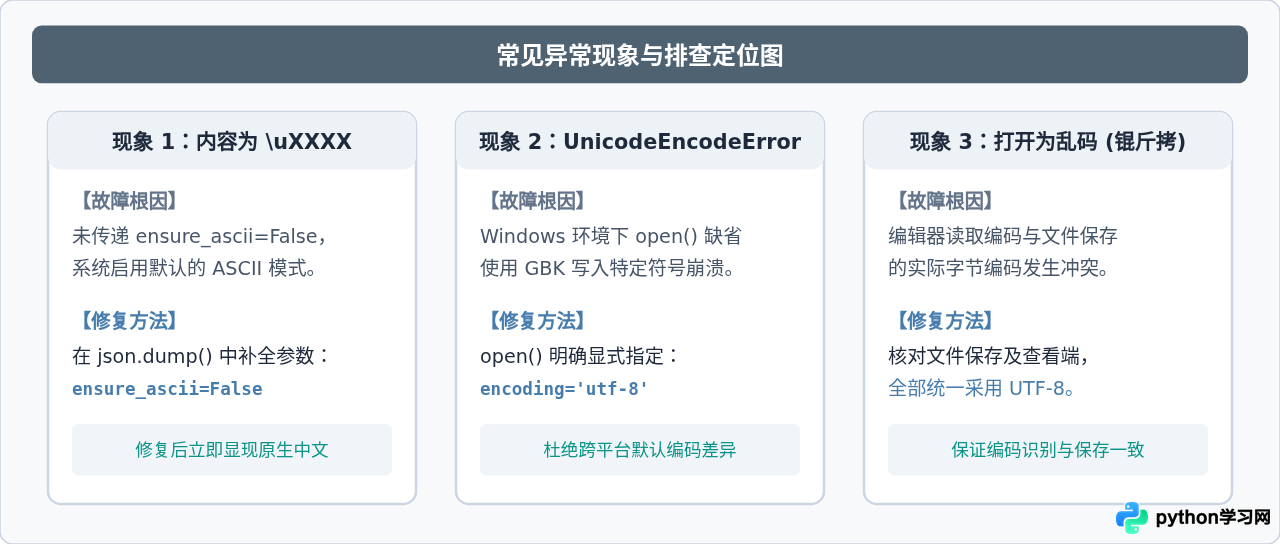
1. 忽视 open() 编码在 Windows 上的陷阱
这是最容易被忽略的隐患。在 Linux 或 macOS 系统中,系统的默认编码通常是 UTF-8,因此即便只写了 open("data.json", "w") 且指定了 ensure_ascii=False,可能碰巧运行正常。但在 Windows 系统中,系统默认编码通常是 GBK(CP936)。此时,由于 ensure_ascii=False,Python 会尝试直接把中文字符送入系统默认的文本流中,容易触发如下异常:
UnicodeEncodeError: 'gbk' codec can't encode character '\u2022' in position 42: illegal multibyte sequence因此,永远不要省略 open() 中的 encoding='utf-8',这是保证代码跨平台可靠运行的铁律。
2. 读取已保存中文文件的验证方式
写出包含中文的 JSON 后,许多人会担心读入时是否需要做反向解码。答案是完全不需要。json.load() 会自动解析合法的 JSON 内容,读出后在 Python 内部即为标准的 str 对象:
import json

# 读取时同样指定 encoding='utf-8' 即可
with open("article.json", "r", encoding="utf-8") as f:
    loaded_data = json.load(f)

print(loaded_data["title"])  # 直接输出: 测试文章
print(type(loaded_data["title"]))  # 输出: <class 'str'>
核心配置与最佳实践矩阵
在不同场景下,我们通常还会配合 indent 和 sort_keys 等参数,以达到最佳的代码规范与数据可维护性。
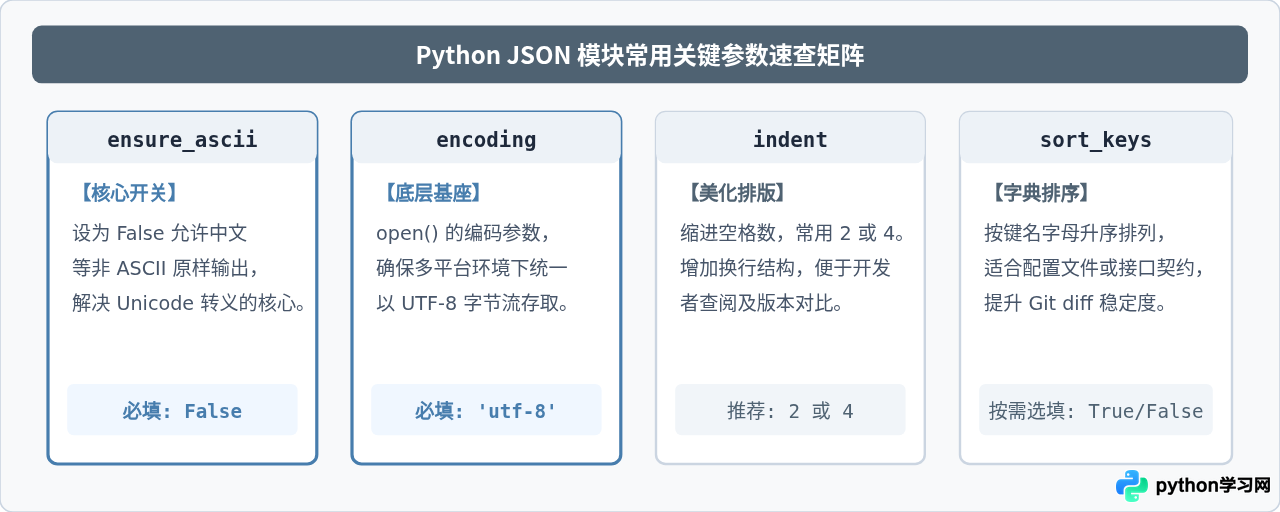
总结
解决 Python 写入 JSON 文件时中文变成 \uXXXX Unicode 转义的问题,本质上是解除 json 模块默认的 7-bit ASCII 限制,并确保文件写入流具备正确的 UTF-8 编码能力。只需记住以下公式:
标准写法公式:with open("file.json", "w", encoding="utf-8") as f: json.dump(data, f, ensure_ascii=False, indent=4)
只要保持“打开指定 UTF-8,导出关闭 ensure_ascii”这一固定搭配,无论是普通的中文文本、复合字典还是包含多语言的数据集,都能稳定、清晰地在 JSON 文件中原样呈现。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















