


面试问scikit-learn1.6新增ArrayAPI支持怎么答?
深入解析面试中关于scikit-learn 1.6新增Array API支持的标准回答方案。从四层应答架构、传统NumPy解耦原理、底层分发时序到技术选型与边界陷阱,提供具体可落地的代码与表达策略。
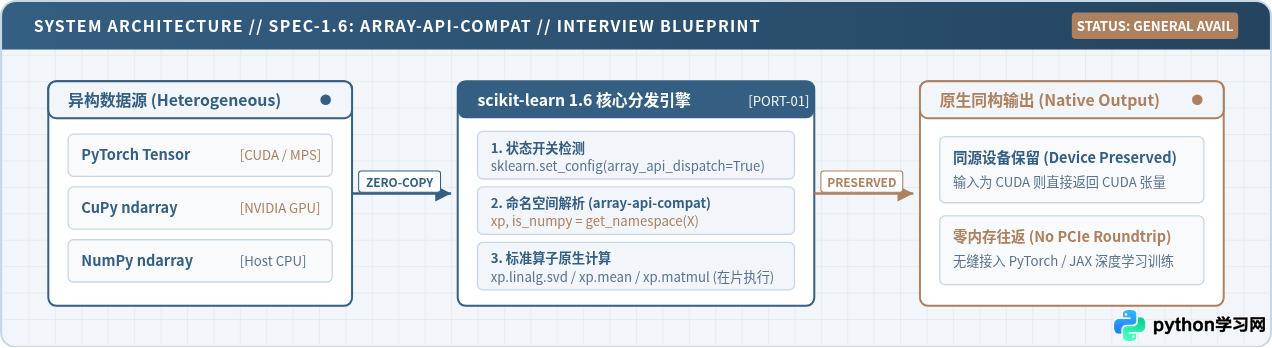
array-api-compat),使支持的算法能够直接在显存内接收并处理 PyTorch、CuPy 等异构张量,消除了过去必须在 CPU 内存与 GPU 显存之间频繁通过 PCIe 总线往返拷数据的通信瓶颈,为深度学习与经典机器学习的一体化流水线提供了无锁死任何专有硬件厂商的通用解法。
一、核心回答框架:四层递进式答题路径
面试中回答技术新特性的时间通常在 2 到 3 分钟之间。若逻辑散乱,面试官很难捕捉你的技术深度。推荐采用“一句话定性 → 底层解耦机制 → 工程代码实操 → 架构权衡边界”四层递进结构进行展开,既能展现全局规范视野,又能下沉到源码实现和避坑实践。
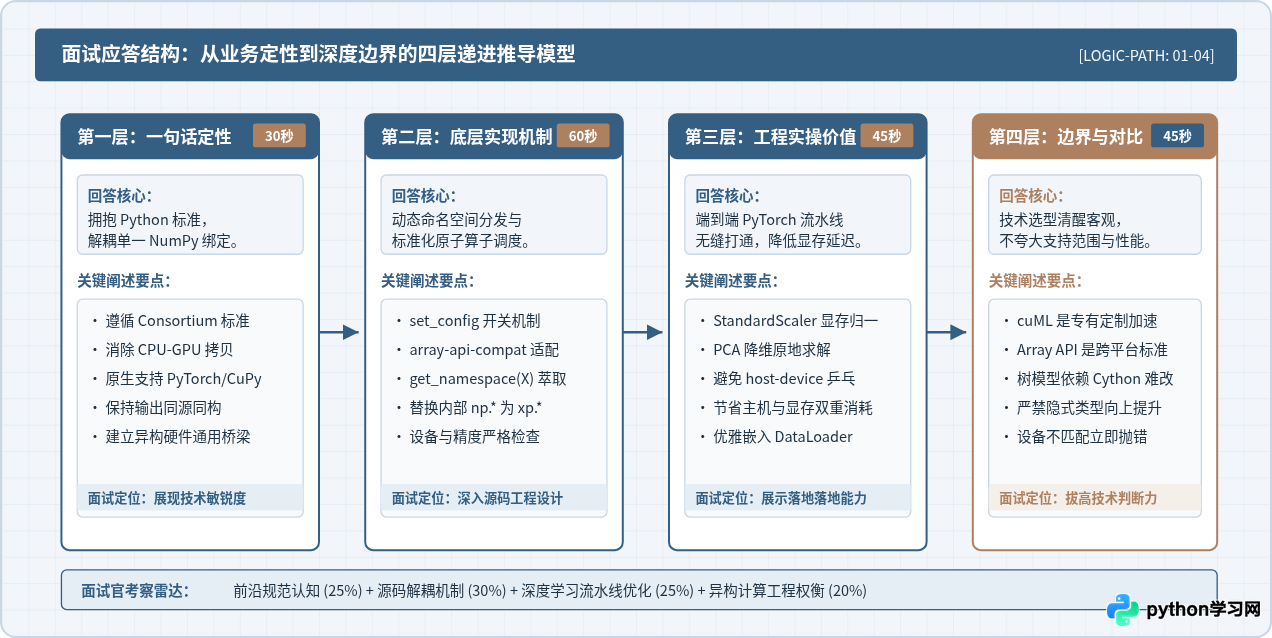
面试时可以按照如下节奏有条不紊地组织语言:
- 第一层:一句话定性(30秒):说明这不是针对某一家厂商写死 CUDA 代码,而是遵循统一标准,将 scikit-learn 从历史长达十余年的单一 NumPy 绑定中解耦,实现多设备“零拷贝”原地计算。
- 第二层:底层机制剖析(60秒):拆解全局配置开关
array_api_dispatch、命名空间提取机制get_namespace(X),以及算法底层将所有np.*替换为抽象命名空间xp.*的原子调度原理。 - 第三层:工程落地与代码(45秒):举一个具体的
StandardScaler或PCA与 PyTorch CUDA Tensor 结合的例子,强调输出与输入的 Device 及 Dtype 同构性,避免 PCIe 传输瓶颈。 - 第四层:边界与技术选型(45秒):客观指出局限性,对比 RAPIDS cuML 的专用性能优势,解释树模型(RandomForest/HistGradientBoosting)为何受限于 Cython 无法支持,体现成熟工程师的技术选型判断力。
二、技术本质:从传统 NumPy 强绑定到异构标准解耦
要让回答具有说服力,必须讲清 scikit-learn 过去的痛点。在 1.6 之前(早期实验性探索阶段除外),scikit-learn 的所有验证与数据预处理函数(如 check_array)内部几乎都无条件调用 np.asarray(X)。
这意味着无论你在 GPU 显存里准备了多大规模的 PyTorch Tensor 或 CuPy 数组,只要送进 scikit-learn 的评估器,底层就会发生一次同步阻塞式的主机内存拷贝(PCIe Host-to-Device 往返)。计算完成后,若下游还需要接 PyTorch 神经网络,开发者又必须手动执行一次显存上传。
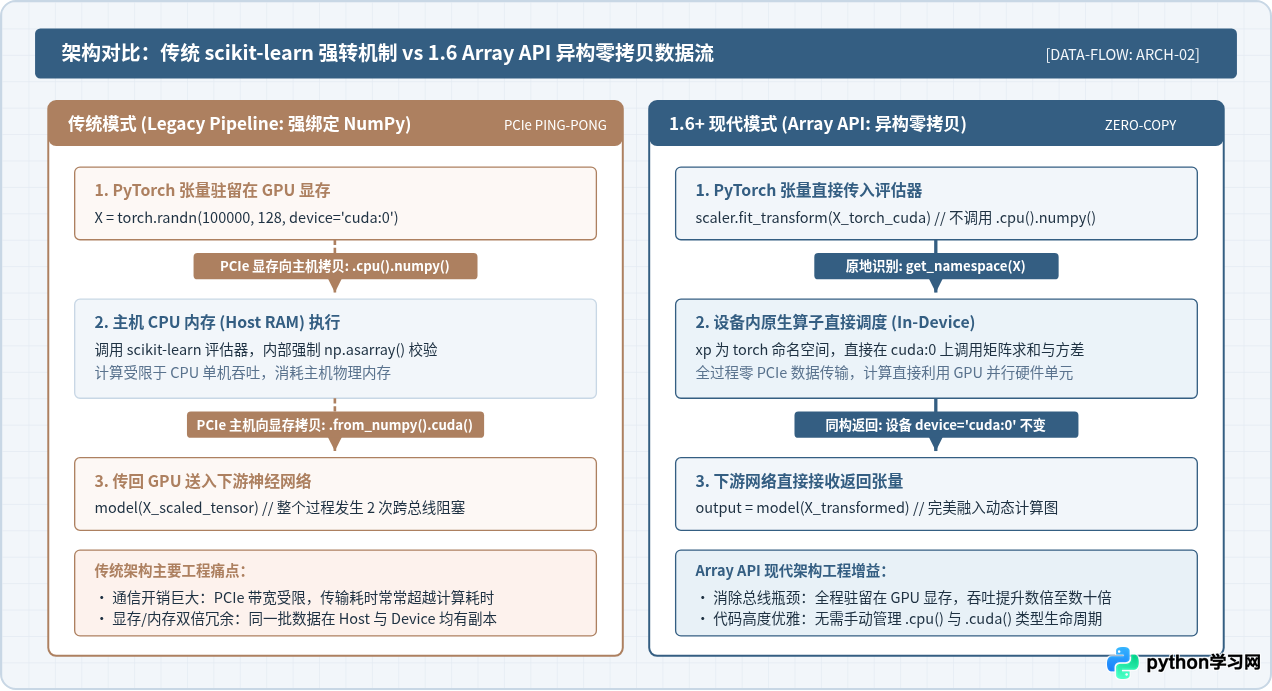
如上图所示,在现代数据密集型任务中,PCIe 通信带宽(即使是 PCIe 4.0/5.0 也是几十 GB/s 级别)往往远落后于 GPU 本地显存带宽(数百 GB/s 到数 TB/s)。对于像归一化、主成分分析或线性回归这类算子,跨总线的数据拷贝耗时甚至远远超过算法本身的计算耗时。
scikit-learn 1.6 的 Array API 支持彻底打通了这条闭环:输入直接是 GPU 张量,内部在 GPU 执行,输出仍然保留在相同的 GPU 设备上,彻底移除了中间层冗余拷贝。
三、底层运作机制与关键代码实操
面试官若对底层源码感兴趣,往往会进一步追问:“scikit-learn 内部并没有直接写 CUDA 内核,它是怎么做到让同一个算法既能在 CPU 上跑 NumPy,又能在 GPU 上跑 PyTorch 的?”
答案就在于标准命名空间注入与原子算子分发。执行步骤可以清晰梳理为五个阶段:
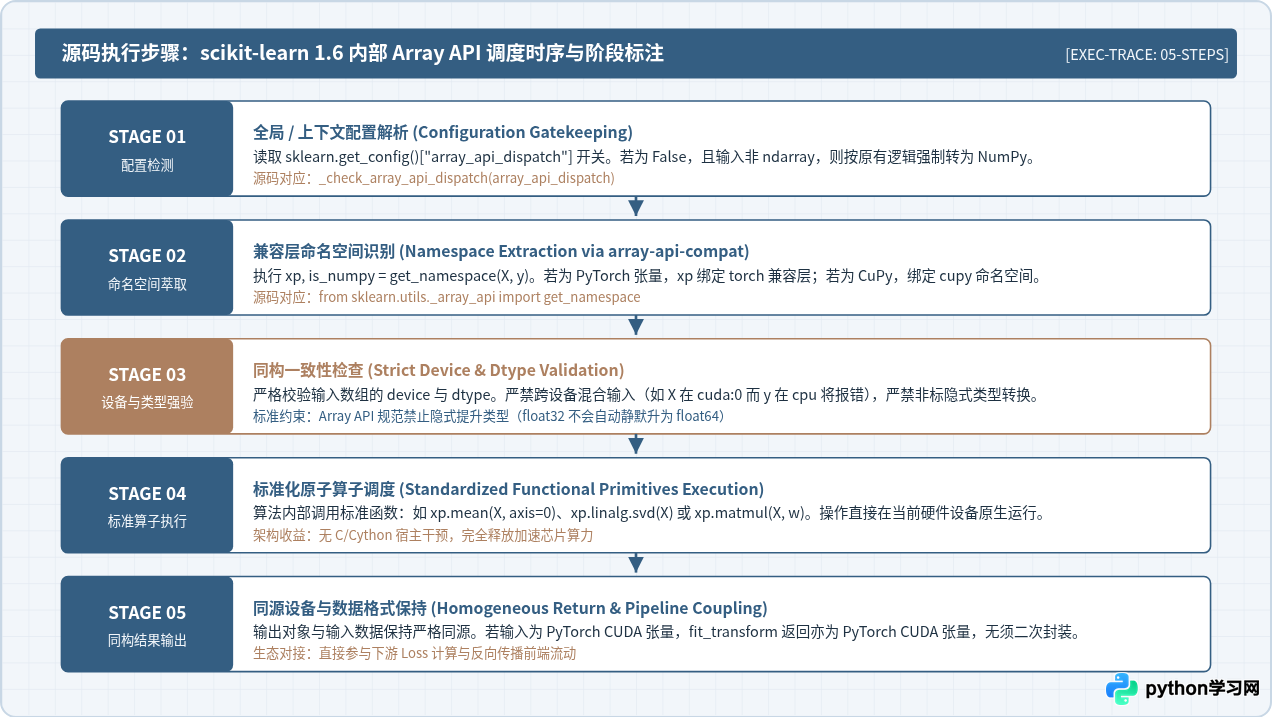
1. 运行时完整执行步骤
- 配置感知:首先检查
sklearn.get_config()["array_api_dispatch"]。若未显式开启,则保持旧版本的默认行为,确保现有遗留代码 100% 向后兼容。 - 命名空间探测:调用兼容层工具
get_namespace(*arrays)。该函数利用array-api-compat库自动检测传入数组的类型(如torch.Tensor、cupy.ndarray),并返回标准命名空间对象xp。 - 严格类型与设备校验:检查所有输入数组(如
X和y)是否驻留在同一个计算设备(Device)上,并验证数据类型是否满足标准(Array API 规定不会发生隐式类型向上提升)。 - 标准化数学运算调度:算法内部将以往硬编码的
np.mean、np.linalg.svd改为xp.mean、xp.linalg.svd。此时实际执行的是 PyTorch 或 CuPy 底层的原生加速算子。 - 同构设备结果返回:输出的矩阵直接继承原始输入的设备属性与内存上下文,直接返回原生后端张量。
2. 生产环境最小验证代码
在面试中口述或在白板上编写时,只需写出以下精炼的核心逻辑,即可准确证明你的上手经验:
import sklearn
import torch
from sklearn.preprocessing import StandardScaler
from sklearn.decomposition import PCA

# 1. 开启 Array API 调度机制(支持全局配置或上下文管理器)
sklearn.set_config(array_api_dispatch=True)

# 2. 模拟直接在 GPU 显存中生成的数据(假定存在 CUDA 设备)
device = "cuda:0" if torch.cuda.is_available() else "cpu"
X_gpu = torch.randn(100000, 64, device=device, dtype=torch.float32)

# 3. 原地执行标准化与降维
scaler = StandardScaler()
pca = PCA(n_components=16)

# 整个 fit_transform 全程在 GPU 显存内执行,无 CPU 内存拷贝
X_scaled = scaler.fit_transform(X_gpu)
X_reduced = pca.fit_transform(X_scaled)

# 4. 验证返回对象及其设备属性
print(f"输出类型: {type(X_reduced)}")
print(f"所处设备: {X_reduced.device}")
print(f"形状与精度: {X_reduced.shape}, {X_reduced.dtype}")所处设备: cuda:0
形状与精度: torch.Size([100000, 16]), torch.float32
float32 或 float64),且无需调用 .detach() 或 .cpu()。输出的张量仍是原生 torch.Tensor,可以直接无缝传入下游的 nn.Module 进行端到端训练。
四、高频追问与关键工程边界
有经验的面试官通常会在你讲完基本概念后,顺水推舟提出 2 到 3 个具有针对性的边界问题,用来区分候选人是“浅尝辄止地看过发布日志”还是“在真实系统中有深入思考”。
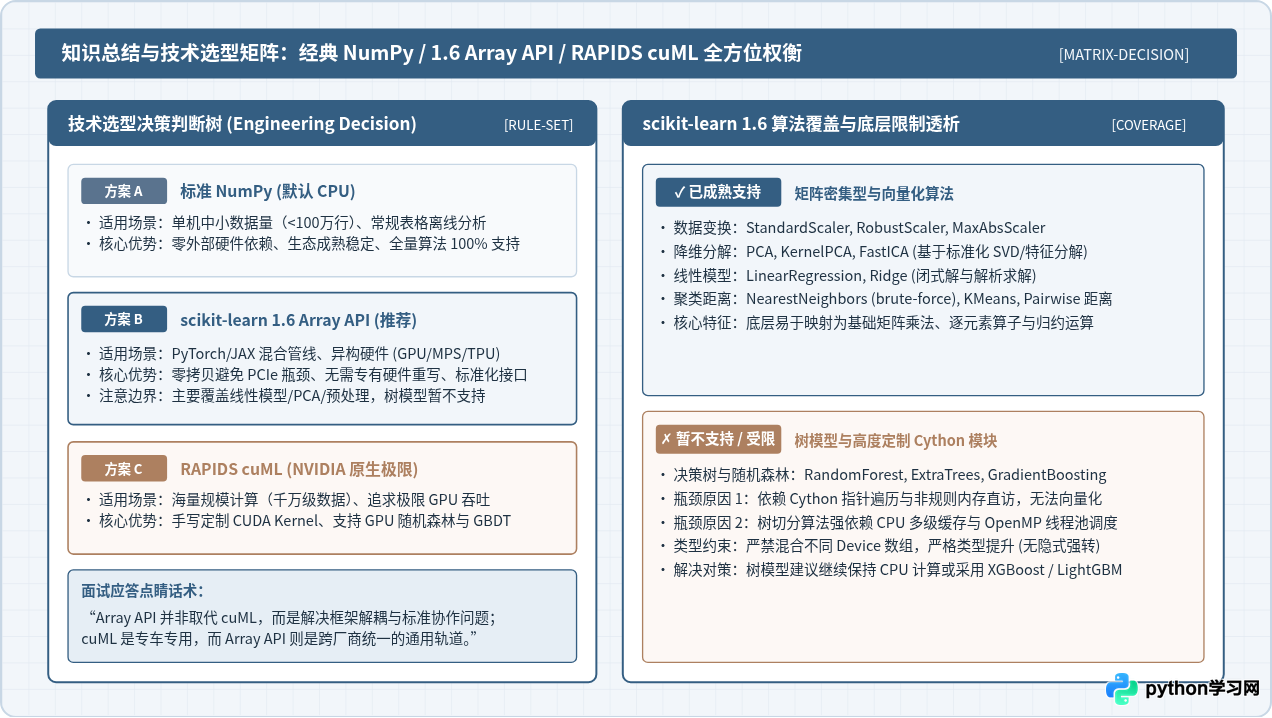
追问 1:既然有了 Array API 支持,是否还需要 NVIDIA RAPIDS cuML?
这是一个经典的“通用标准 vs 专有优化”的架构选型问题。不可简单回答“不需要”或“随便用哪个”。
- RAPIDS cuML:是专为 NVIDIA GPU 打造的专用库,内部有大量高度优化的底层 CUDA/C++ Kernel,且支持针对单机多卡与超大规模分布式(Dask-cuML)优化。在海量数据(例如几千万行密集特征)且硬件完全限定为 NVIDIA GPU 时,cuML 的绝对计算吞吐通常更高。
- scikit-learn 1.6 Array API:定位是统一标准化接口与跨框架互操作性。它不仅支持 NVIDIA CUDA,还能无缝支持 Apple Silicon(PyTorch MPS)、AMD ROCm 乃至 Google TPU(JAX 后端)。它最大的优势是零专有环境依赖,无需额外安装数十个 CUDA 轮子包,代码具有极强的便携性。
追问 2:哪些算法已经支持?哪些算法不支持?为什么不支持?
很多候选人会误以为“所有 scikit-learn 算法都自动支持 GPU 了”,这在面试中是一个扣分陷阱。
- 支持良好的算法:以稠密向量与矩阵代数运算为主的算法。例如
StandardScaler、RobustScaler、MinMaxScaler、LinearRegression、Ridge、PCA、FastICA、NearestNeighbors(Brute-force 模式)、基础聚类与常用距离度量。这类算法的数学形式天然可以映射为矩阵乘法、奇异值分解与按轴归约。 - 不支持或暂难支持的算法:主要是树模型(Tree-based Models),如
DecisionTreeClassifier、RandomForestClassifier、HistGradientBoostingClassifier。原因在于这些算法的底层核心完全由针对 CPU 缓存与指针寻址优化的 Cython 编写,内部包含高度离散的分支跳转与直访机制,无法简单重构为 Array API 的标准向量矩阵操作。若要在 GPU 上运行树模型,依然应当选用 XGBoost、LightGBM 或 cuML。
追问 3:在实际落地使用中,有哪些隐蔽的“坑”?
- 严格的类型提升规则(No Implicit Type Promotion):NumPy 在历史上有较宽松的隐式强转(例如 float32 遇到 float64 自动升阶),但 Array API 标准为了跨硬件一致性,严格禁止隐式类型提升。如果特征矩阵
X是float32而目标标签y是float64,在标准分发下会直接抛出类型不匹配异常。 - 多设备严格隔离(Device Mismatch):传入同一个评估器的所有张量必须驻留在严格一致的设备上。若
X在cuda:0而sample_weight在cpu,系统不会自动帮开发者搬运,而是立即报错阻断。 - 稀疏矩阵暂未完全覆盖:目前 Array API 标准的核心主要定义了稠密数组(Dense Array),对于
scipy.sparse类的压缩稀疏格式(CSR/CSC),目前在异构后端上的支持仍在演进中,大规模稀疏文本分类等场景仍应依托原有 CPU 链路。
五、面试现场应答话术模板与总结
为了在面试中达到最佳表达效果,可以直接参考以下整理好的90秒高分应答口径:
“面试官您好,scikit-learn 1.6 的 Array API 支持,核心是基于 Python 数据 API 联盟的通用规范,打破了过去与 NumPy 的死绑定,实现了跨硬件异构数组的原生支持与零拷贝计算。
在底层实现上,它通过 array-api-compat 兼容层动态识别输入张量的命名空间(比如 torch 或 cupy),并将算法内部的数学操作统一路由到标准化的 xp.* 原语中。这样如果我们在 GPU 上有一个 PyTorch Tensor,通过 StandardScaler 或 PCA 处理时,数据就完全不需要先执行 .cpu().numpy() 拷贝回主机内存,而是直接在显存内完成运算并返回原生的 GPU Tensor,彻底消除了 PCIe 总线传输的通信瓶颈。
不过在实际落地选型中我也非常关注它的边界:首先,它目前主要赋能矩阵与向量化密集的线性模型、降维与预处理,而像随机森林这种重度依赖 Cython 离散遍历的树模型依然保持 CPU 逻辑;其次,与 RAPIDS cuML 深度定制 CUDA Kernel 追求单机极限吞吐不同,Array API 的最大价值在于轻量、跨厂商(NVIDIA/AMD/Apple Silicon)以及与 PyTorch 深度学习流水线的无缝融合。”
按照上述路径回答,既回答了“是什么”和“怎么用”,又从“架构原理”上升到“系统权衡”,能够在短时间内建立技术扎实、善于工程落地的专业形象。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















