


项目技术选型:Java高并发性能与Python开发效率怎么权衡
面对项目技术选型时,Java的高并发运行性能与Python的敏捷开发效率往往各具优势。本文从运行机制、并发边界、量化评估步骤、双栈协同架构以及决策矩阵等维度,提供实用清晰的权衡与落地指南。
技术选型的本质不是在语言优劣之间分出胜负,而是在项目现阶段的核心瓶颈、交付周期约束与硬件承载成本之间找到契合点。如果在业务验证期因追求预设的千万级高并发而选用重型方案,团队可能会被漫长的开发周期拖垮;反之,若在确定存在高频交易与低延迟计算的核心场景坚持选用解释型语言,后续则容易面临严重的性能瓶颈与昂贵的重构开销。明确业务实际指标、分清I/O阻塞与CPU计算、结合团队熟练度进行分层架构设计,是解决这一权衡的核心路径。
一、运行机制与并发模型:性能与效率的底层差异
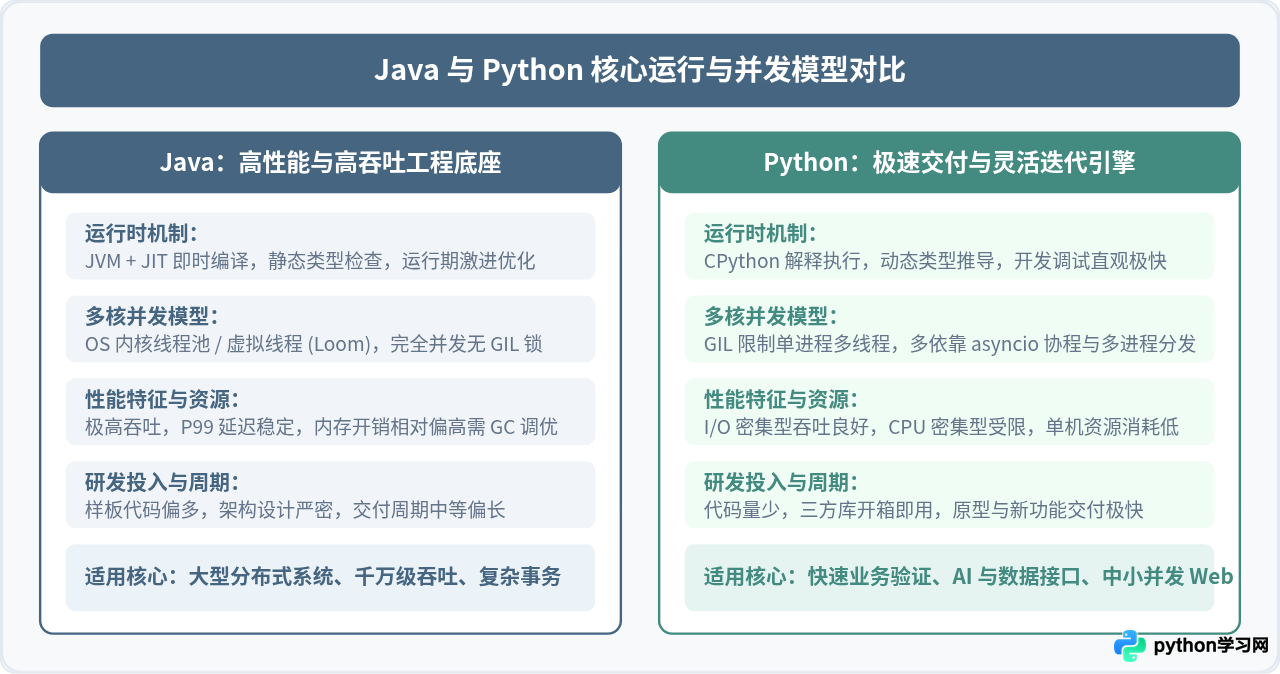
Java 与 Python 在高并发能力与开发效率上的明显差异,根源在于底层的运行时机制、内存管理与线程模型。理解这些底层差异,能够避免凭刻板印象做出非黑即白的判断。
Java 是静态强类型语言,源代码编译为字节码后在 JVM(Java虚拟机)中运行,经过 JIT(即时编译器)的热点代码编译与激进优化后,执行效率逼近原生 C/C++。在并发层面,Java 长期采用与操作系统内核线程直接映射的多线程模型,能够充分榨干多核 CPU 的计算资源。在现代 Java(如 Java 21+)中,虚拟线程(Virtual Threads)更是降低了大量并发网络连接的内存占用。因此,面对复杂的内存对象计算、高频状态流转与大规模并发线程切换,Java 具备极高的吞吐上限和稳定的响应延迟。
Python 则是动态强类型解释语言,语意简洁优雅,具有极高的开发与表达效率。但官方主流解释器 CPython 存在 GIL(全局解释器锁),这意味着在同一个 Python 进程中,哪怕拥有多核心 CPU,同一时刻也仅能执行一条字节码指令。对于 CPU 密集型任务,Python 无法依靠多线程直接利用多核;但在以网络请求、数据库查询为主的 I/O 密集型业务中,基于 asyncio 的异步事件循环或基于 Gunicorn/Uvicorn 的多进程模型,能够以极少的代码行数处理每秒数千次的并发请求。
二、代码与并发实现示例:直观感受两者的权衡代价
为了直观展现两者在编写高并发逻辑时的风格与复杂度差异,我们以一个常见的并发处理场景为例:接收一批订单请求,批量调用远程库存校验接口,并返回聚合结果。
1. Python 异步实现(FastAPI + aiohttp)
在 Python 中,通过 asyncio 可以用平铺直叙的同步语法结构书写高性能异步代码,代码紧凑,开发与联调耗时非常短:
# 运行环境:Python 3.10+, fastapi, aiohttp, uvicorn
from fastapi import FastAPI
import aiohttp
import asyncio

app = FastAPI()

async def check_inventory(session: aiohttp.ClientSession, item_id: str) -> dict:
    url = f"https://inventory.local/api/check/{item_id}"
    async with session.get(url, timeout=aiohttp.ClientTimeout(total=2.0)) as response:
        return await response.json()

@app.post("/orders/batch-check")
async def batch_check_orders(item_ids: list[str]):
    async with aiohttp.ClientSession() as session:
        # 并发派发所有库存查询任务
        tasks = [check_inventory(session, item_id) for item_id in item_ids]
        results = await asyncio.gather(*tasks, return_exceptions=True)
    return {"total": len(item_ids), "details": results}
在上述代码中,10 行核心逻辑便实现了并发非阻塞的网络 I/O 汇聚。对于多数每秒数百到数千次查询的电商前台系统,单台 4 核实例配合 Uvicorn 多 Worker 即可稳定运行。
2. Java 现代并发实现(Spring Boot 3 + 虚拟线程)
在 Java 中,为了获得更严格的类型安全、完整的链路追踪以及高承载力,代码结构通常更分层、更严谨:
// 运行环境:JDK 21+, Spring Boot 3.2+
package com.example.order;

import org.springframework.web.bind.annotation.*;
import org.springframework.web.client.RestClient;
import java.util.List;
import java.util.concurrent.*;

@RestController
@RequestMapping("/orders")
public class OrderBatchController {

    private final RestClient restClient = RestClient.create("https://inventory.local");

    @PostMapping("/batch-check")
    public BatchResult batchCheckOrders(@RequestBody List<String> itemIds) {
        // 利用 JDK 21 虚拟线程执行器,为每个并发调用分配轻量级虚拟线程
        try (var executor = Executors.newVirtualThreadPerTaskExecutor()) {
            List<Future<InventoryStatus>> futures = itemIds.stream()
                .map(id -> executor.submit(() ->
                    restClient.get()
                        .uri("/api/check/{id}", id)
                        .retrieve()
                        .body(InventoryStatus.class)
                ))
                .toList();

            List<InventoryStatus> results = futures.stream().map(f -> {
                try {
                    return f.get(2, TimeUnit.SECONDS);
                } catch (Exception e) {
                    return new InventoryStatus("FAILED", e.getMessage());
                }
            }).toList();

            return new BatchResult(itemIds.size(), results);
        }
    }

    public record InventoryStatus(String status, String message) {}
    public record BatchResult(int total, List<InventoryStatus> details) {}
}
虽然现代 Java 引入 record 和虚拟线程后代码已大幅精简,但工程上仍需配置依赖管理、编译打包流程、实体类映射及各类框架切面。这部分工程仪式感增加了前期交付工作量,但在百万级请求涌入或系统长期维护数十人团队协作时,强类型体系与 JVM 高度优化的内存管理能显著减少生产环境排错时间。
三、选型权衡的量化评估:四个关键步骤
权衡不能凭个人喜好,必须通过具体量化指标与团队现状推导。可以按照以下四个标准步骤展开评估:
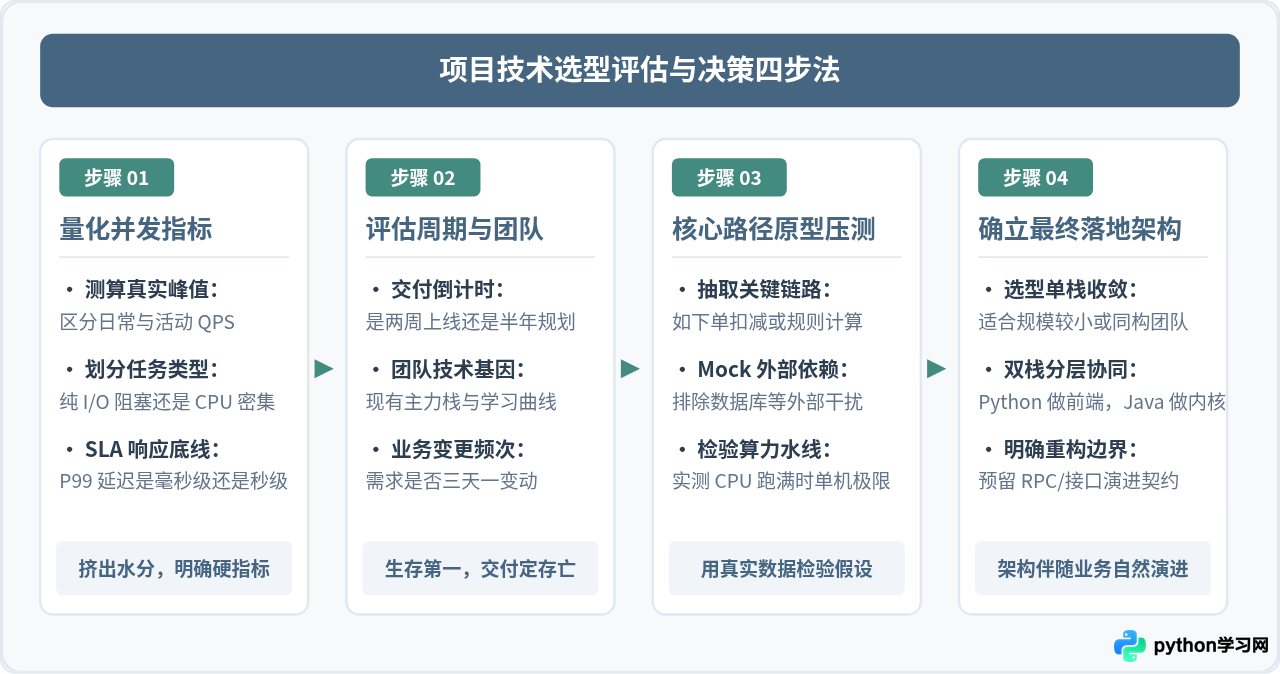
第一步:量化并发指标与业务类型。区分“日常平峰”与“活动峰值”。绝大多数企业系统或中小型 Web 产品的日常峰值 QPS 往往在几十到小几百之间。在这个量级下,性能瓶颈 90% 集中在数据库慢查询、缓存命中率或外部接口耗时上,语言执行速度的影响微乎其微。如果系统峰值稳定超过 10,000 QPS,或者包含大量内存加解密、排序聚合和密集运算,才需要将语言原生高并发性能作为一票否决项。
第二步:评估团队交付周期与人才储备。技术选型不仅看代码怎么跑,更要看团队怎么写。若团队全员精通 Python,且项目必须在 3 周内完成 MVP(最小可行性产品)验证并抢占市场,强行切换至 Java 会导致大量时间消耗在环境配置、脚手架搭建与框架磨合上;反之,若团队已有成熟的 Java 微服务中台基建与运维监控套件,选用 Java 则是交付阻力最小的路径。
第三步:核心路径原型压测。不要基于理论争吵,针对系统最核心的 1~2 个关键接口(如订单入库、规则匹配)编写最小原型,Mock 掉所有外部网络与数据库耗时,使用压测工具(如 wrk、locust)在同等规格机器上测量单机极限吞吐与 P99 响应延迟,用真实客观的数据验证假设。
第四步:确立最终落地架构。根据压测数据与交付底线,确定是采用单一技术栈收敛维护成本,还是采用前后分层的多语言协同架构。
四、跳出二选一:双栈协同分层架构实践
在大型企业或中大型互联网项目中,“Java 还是 Python”往往不是非此即彼的单选题。最成熟的工业界实践通常是各取所长:将两者部署在不同的系统分层,发挥各自最大的价值。
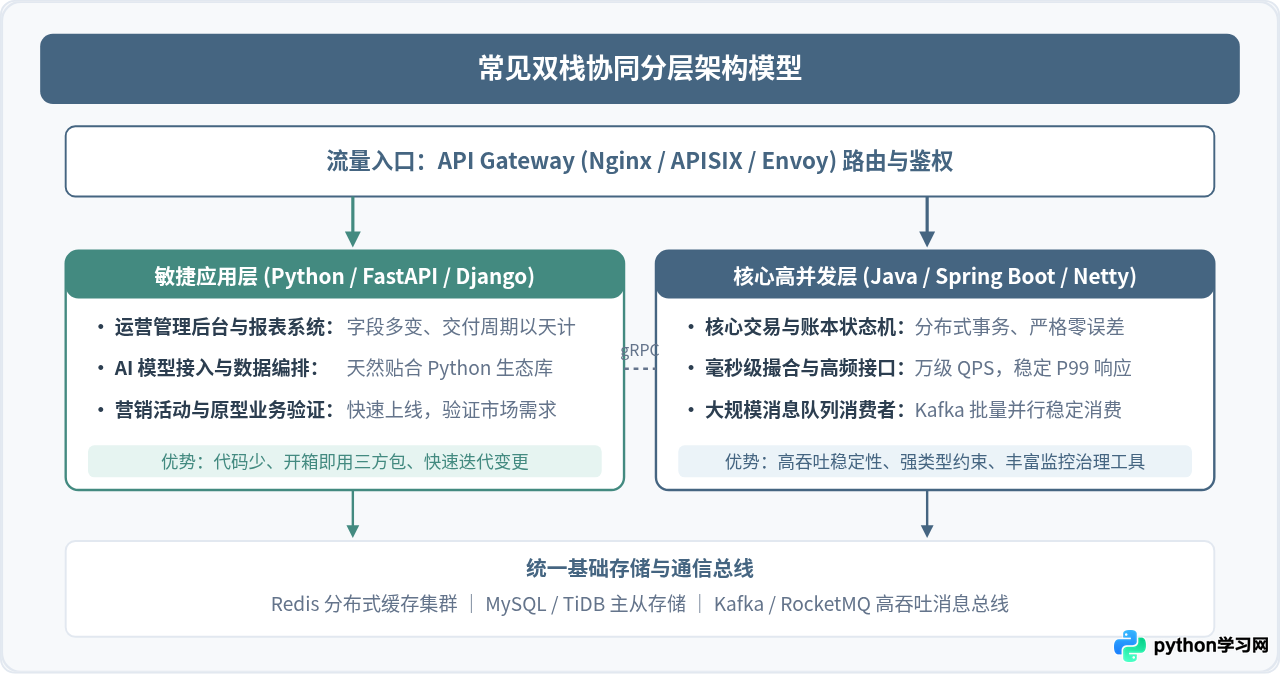
在这种双栈协作模式中,两个技术栈各自负责适合的领域:
- Python 负责“敏捷多变”的业务前端与边缘层:如活动营销系统、运营管理后台、数据分析平台及大语言模型(LLM)的 Prompt 流水线。这些业务要求周级别甚至天级别上线,需求频繁变更,单接口并发通常在数百 QPS 以内,Python 的高开发效率在此能节省大量人力成本。
- Java 负责“沉稳高负荷”的核心资产与高频交易层:如账户余额扣减、订单状态流转、高并发抽奖和账目对齐。此类业务逻辑严肃,一旦出错代价极大,且峰值并发高,Java 的强类型系统和完善的并发工具包可以保证系统的长期稳定。
- 两者通过契约解耦:两者之间通过基于 Protocol Buffers 的 gRPC 接口或者 Kafka 消息队列进行通信,既保持了接口的强类型校验,又避免了不同语言运行时互相干扰。
五、选型权衡全景矩阵与常见误区
为了帮助研发团队在面临实际项目时迅速达成共识,下表总结了典型业务特征下的技术选型倾向:
| 评估维度 | 更适合选择 Python 的场景 | 更适合选择 Java 的场景 |
|---|---|---|
| 预估并发量 | 峰值 QPS < 2,000,且以 I/O 等待为主 | 峰值 QPS > 10,000,或存在大量 CPU 密集计算 |
| 项目阶段 | 初创验证期、MVP 原型探索、外包定制项目 | 成熟期核心系统、大型企业级基石业务 |
| 交付时间要求 | 要求 1~3 周内快速交付并频繁迭代 | 规划周期充裕,重视后续数年的架构扩展性 |
| 团队协同规模 | 3~5 人的小型敏捷敏捷团队 | 数十人至数百人的大型跨部门协同团队 |
| 生态技术诉求 | 需深度集成 AI、机器学习或爬虫与数据分析 | 需深度对接已有企业微服务(Spring Cloud/Dubbo) |
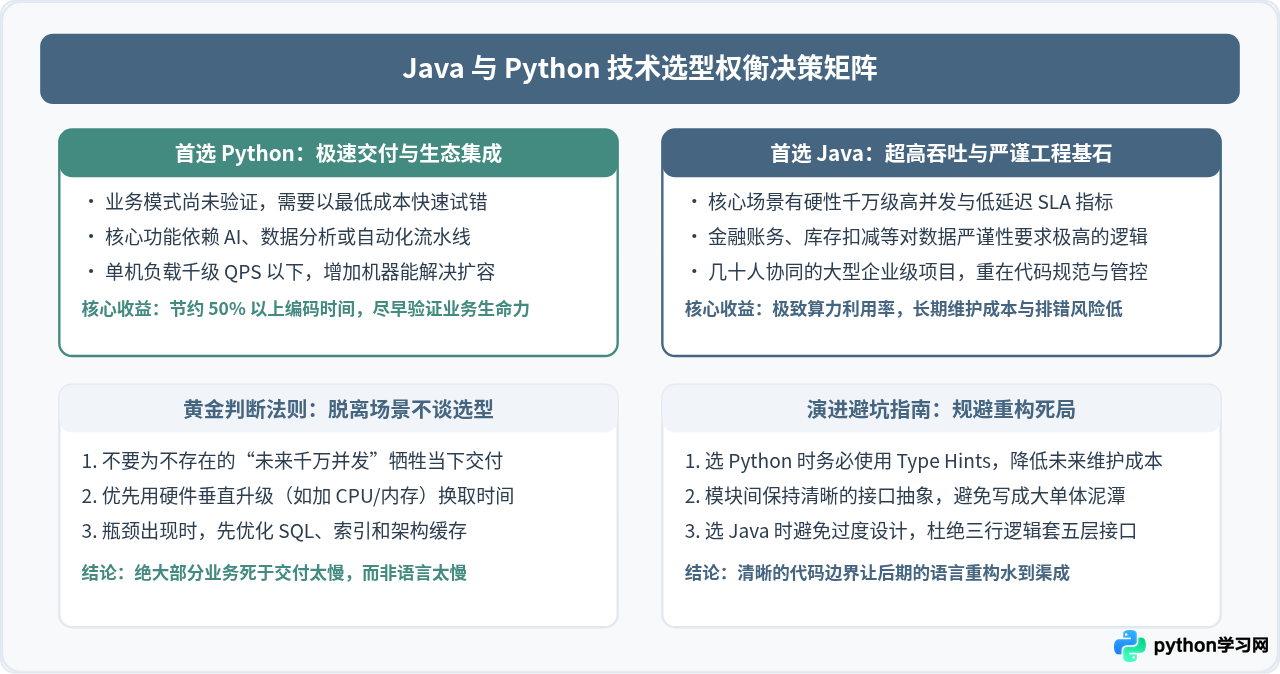
防坑要点:在项目早期切忌“过早优化”。绝大多数产品由于未能在规定时间内推向市场完成商业闭环而夭折,真正因为 Python 运行性能不足导致业务瘫痪的比例极低。当业务发展到一定规模、单节点并发真正成为吞吐瓶颈时,团队已经具备了充足的资金和精力,此时将瓶颈模块抽离出来使用 Java 重写微服务,是完全顺畅且符合软件演进规律的做法。
六、总结与落地建议
权衡 Java 的高并发性能与 Python 的开发效率,可以归纳为以下几条行动原则:
- 初创与敏捷期:若业务方向尚在摸索、需求变动剧烈且并发量有限,优先选择 Python。让团队在最短时间内拿出可用产品,依靠加云服务器硬件来换取前期的开发时间。
- 核心与基石期:若系统一上线就面临强监管、大规模资金结算或万级以上的确定性高并发,优先选择 Java。严格的类型检查和成熟的 JVM 生态能够在系统运行期提供极高的稳定性保障。
- 规模化扩张期:拥抱双栈协同架构。用 Python 快速承接前台轻量多变需求及 AI 数据编排,用 Java 夯实底层中台交易核心,通过标准 API 或消息总线解耦,实现研发效率与运行性能的双赢。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















