


Python Scrapy框架实战:构建电商商品列表爬虫
本教程深入讲解如何使用Python Scrapy框架构建高可用的电商商品列表爬虫,涵盖项目初始化、Item数据结构定义、CSS/XPath解析、多页自动化翻页、反爬请求配置及数据管道存储全流程。
在批量采集电商数据时,单线程请求脚本往往面临连接复用率低、翻页逻辑耦合与容错脆弱等问题。使用工业级爬虫框架 Scrapy 能够将网络调度、数据解析和持久化存储解耦。本文以抓取电商平台的商品列表页为例,通过建立标准工程、定义数据模型、编写 CSS 选择器、提取并自动发起下一页请求,以及在 Pipeline 中清洗导出的完整流程,带领读者构建一个健壮的商品列表爬虫。
一、Scrapy 工作架构与核心数据流
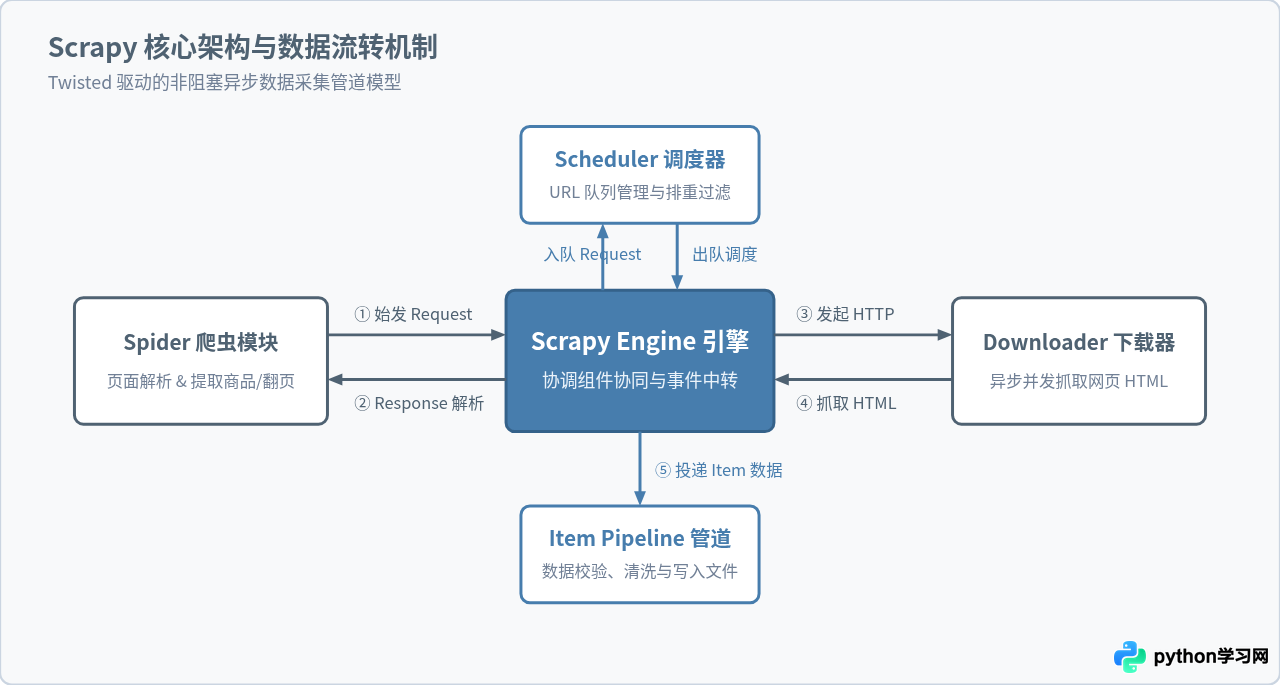
理解 Scrapy 内部组件的协作方式是写出高效爬虫的前提。Scrapy 基于 Twisted 异步网络库驱动,各模块之间并不直接相互调用,而是通过核心引擎统一中转调度。
在整个采集周期中,包含五个核心参与者:
- Scrapy Engine(引擎):整个系统的控制中心,负责在各组件之间传递信号和数据。
- Scheduler(调度器):接收引擎发来的请求并排入优先级队列,自动去重已请求过的 URL。
- Downloader(下载器):从网络中高速下载 HTML 网页内容,并将 Response 交付给引擎。
- Spider(爬虫):开发者编写核心解析逻辑的地方,负责解析 Response,产出提取到的商品 Item 或新的翻页 Request。
- Item Pipeline(管道):负责处理 Spider 产出的商品对象,执行清洗校验、去重及存储至文件或数据库。
二、项目工程初始化与数据模型规范
在终端中执行环境检查与工程创建。确保已安装 Python 3.8+ 及 Scrapy 运行环境:
# 安装 Scrapy 稳定发行版本
pip install scrapy

# 创建名为 mall_spider 的项目工程
scrapy startproject mall_spider

# 进入项目主目录
cd mall_spider
进入项目后,标准目录结构如下所示:
mall_spider/
├── mall_spider/
│   ├── spiders/          # 爬虫实现代码存放目录
│   ├── items.py          # 数据实体定义
│   ├── middlewares.py    # 爬虫中间件与下载中间件
│   ├── pipelines.py      # 数据清洗与入库管道
│   └── settings.py       # 全局参数与反爬配置
└── scrapy.cfg            # 部署配置文件
定义 Item 数据结构
电商商品列表通常包括商品名称、价格、销量/评论数、商品详情页链接以及唯一的商品 SKU ID。直接使用原生 Python 字典容易出现键名拼写错误,Scrapy 提供了 scrapy.Item 类用于规范字段契约。
编辑 mall_spider/items.py 文件:
import scrapy

class MallProductItem(scrapy.Item):
    # 商品唯一识别码
    product_id = scrapy.Field()
    # 商品标题
    title = scrapy.Field()
    # 标价(清洗后通常为浮点数)
    price = scrapy.Field()
    # 评价总数或已售件数
    comments_count = scrapy.Field()
    # 商品详情页链接
    detail_url = scrapy.Field()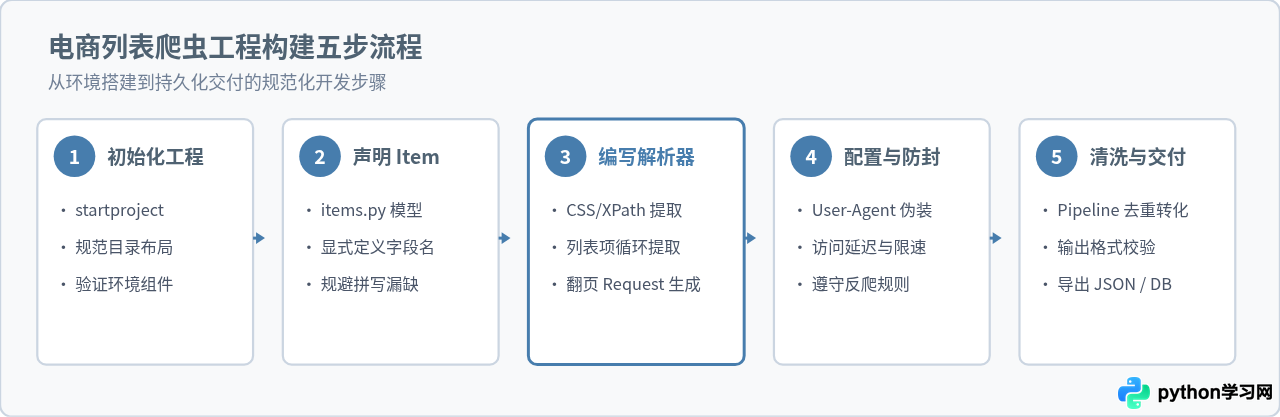
三、商品列表页解析与自动化翻页实现
使用脚手架命令生成爬虫核心文件:
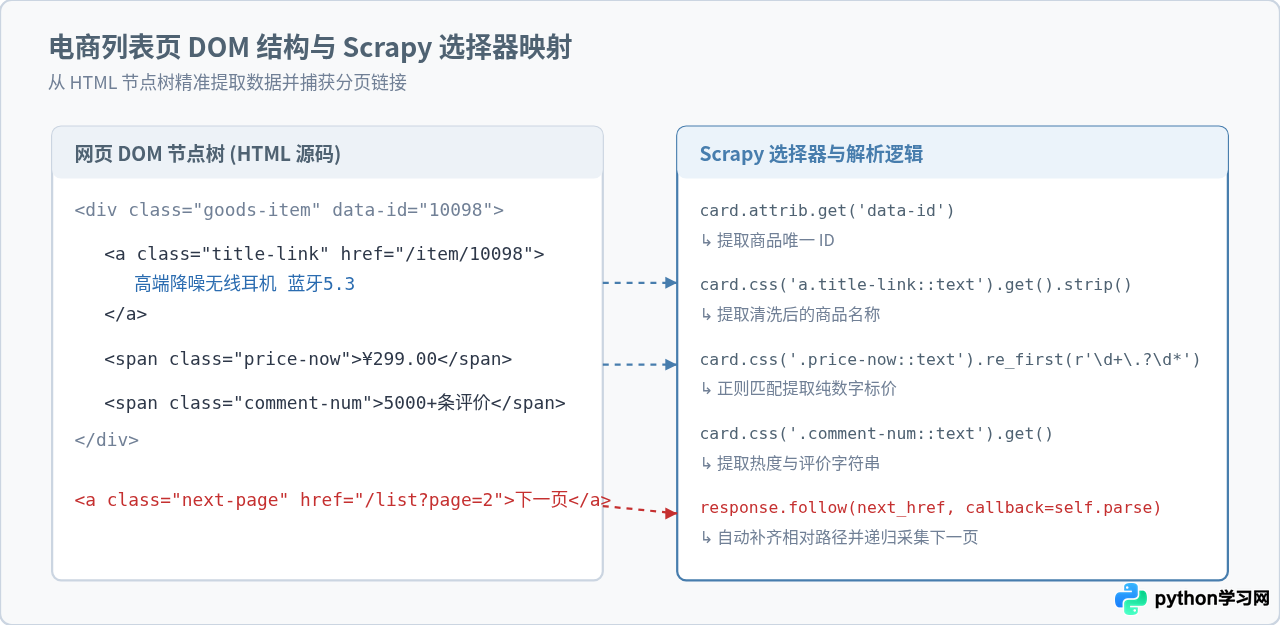
scrapy genspider goods_list "example-shop.com"该命令将在 mall_spider/spiders/ 下生成 goods_list.py。电商列表页的特征在于:页面包含一个父级卡片容器,每个卡片内部含有该商品的结构化信息;在页面底端则存在指示下一页的链接标签。
编写 Spider 解析逻辑代码
在 mall_spider/spiders/goods_list.py 中编写核心业务逻辑。注意优先使用 response.follow() 替代手动的绝对路径拼接,它会自动结合当前页面域名处理 /list?page=2 这类相对路径:
import scrapy
from mall_spider.items import MallProductItem

class GoodsListSpider(scrapy.Spider):
    name = "goods_list"
    allowed_domains = ["example-shop.com"]
    start_urls = ["https://www.example-shop.com/products?category=electronics"]

    def parse(self, response):
        # 1. 匹配所有商品容器节点
        product_cards = response.css("div.goods-item")

        for card in product_cards:
            item = MallProductItem()
            item["product_id"] = card.attrib.get("data-id")

            # 获取标题文本并移除首尾空白字符
            raw_title = card.css("a.title-link::text").get()
            item["title"] = raw_title.strip() if raw_title else ""

            # 使用正则表达式直接过滤掉货币符号,只保留数字
            item["price"] = card.css(".price-now::text").re_first(r"\d+\.?\d*", default="0.00")

            item["comments_count"] = card.css(".comment-num::text").get(default="0")

            # 获取商品相对链接
            relative_url = card.css("a.title-link::attr(href)").get()
            item["detail_url"] = response.urljoin(relative_url) if relative_url else ""

            # 产出 Item 交付给引擎
            yield item

        # 2. 捕获分页控件并递归抓取下一页
        next_page = response.css("a.next-page::attr(href)").get()
        if next_page:
            # response.follow 自动处理相对链接并把 callback 绑定至当前 parse 方法
yield response.follow(next_page, callback=self.parse)<script id="__NEXT_DATA__"> 的 JSON 块中,或通过 AJAX 异步拉取。如果使用 CSS 选择器抓取到空列表,应先在终端执行 scrapy view https://target-url,检查无头浏览器下载的静态 HTML 是否包含商品 DOM。
四、反爬策略配置与数据管道(Pipeline)处理
电商网站通常具备频次监控、User-Agent 校验和机器人协议拦截。直接使用 Scrapy 默认配置请求容易收到 403 Forbidden 响应。需要在 settings.py 中合理设置采集节奏与伪装参数。
修改 settings.py 关键反爬参数
# 1. 关闭默认严格遵守 robots.txt(部分电商 robots 禁止爬虫访问分类页)
ROBOTSTXT_OBEY = False

# 2. 设置合法的浏览器默认 User-Agent
USER_AGENT = "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36"

# 3. 设置下载延迟,避免对目标站点产生瞬时冲击触发风控(单位:秒)
DOWNLOAD_DELAY = 1.5

# 4. 降低单个域名的最大并发数
CONCURRENT_REQUESTS_PER_DOMAIN = 4

# 5. 开启默认请求头,模拟真实浏览器 Accept 协商
DEFAULT_REQUEST_HEADERS = {
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,*/*;q=0.8",
    "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
}

# 6. 激活自定义数据处理管道
ITEM_PIPELINES = {
    "mall_spider.pipelines.MallDataPipeline": 300,
}
编写 pipelines.py 数据清洗与去重
Spider 提取出的原始数据往往混杂着格式噪声。Pipeline 负责进行类型转换(如将价格转为 float)、过滤无效数据,并维护内存集合防止跨页时爬取到重复推流的商品。
from scrapy.exceptions import DropItem

class MallDataPipeline:
    def __init__(self):
        # 维护一个内存 ID 集合用于增量去重
        self.seen_ids = set()

    def process_item(self, item, spider):
        # 1. 验证关键字段完整性
        if not item.get("title") or not item.get("product_id"):
            raise DropItem(f"缺少必要标识,丢弃此条数据: {item}")

        # 2. 去重过滤
        if item["product_id"] in self.seen_ids:
            raise DropItem(f"重复商品项,忽略抓取: {item['product_id']}")
        self.seen_ids.add(item["product_id"])

        # 3. 价格字段标准化为浮点型
        try:
            item["price"] = float(item["price"])
        except (ValueError, TypeError):
            item["price"] = 0.0

        return item
五、爬虫运行验证与结果检查
完成编码与配置后,在项目根目录启动爬虫,并通过 -o 参数直接导出结构化数据文件:
# 启动爬虫并导出为 JSONLines 格式(推荐,按行流式写入,容错率高)
scrapy crawl goods_list -o products.jsonl

# 或导出为标准 CSV 表格
scrapy crawl goods_list -o products.csv
终端日志排查要点
爬虫启动后,Scrapy 会在终端输出详细的运行统计信息。重点关注以下三项指标:
downloader/response_status_count/200:正常返回的 HTTP 状态码计数。若出现大比例403或302,说明被风控拦截或重定向到了登录验证页。item_scraped_count:成功通过 Pipeline 的商品总数。如果抓取响应为 200 但该项为 0,说明 CSS 选择器规则未能匹配到当前页面的 DOM 节点。dupefilter/filtered:调度器识别并过滤掉的重复 URL 数量,用于验证翻页机制是否陷入死循环。
六、电商列表爬虫工程最佳实践总结
在长期的生产采集场景中,电商网站的 DOM 结构会频繁迭代更新。保持爬虫代码的高鲁棒性需要遵循以下设计准则:
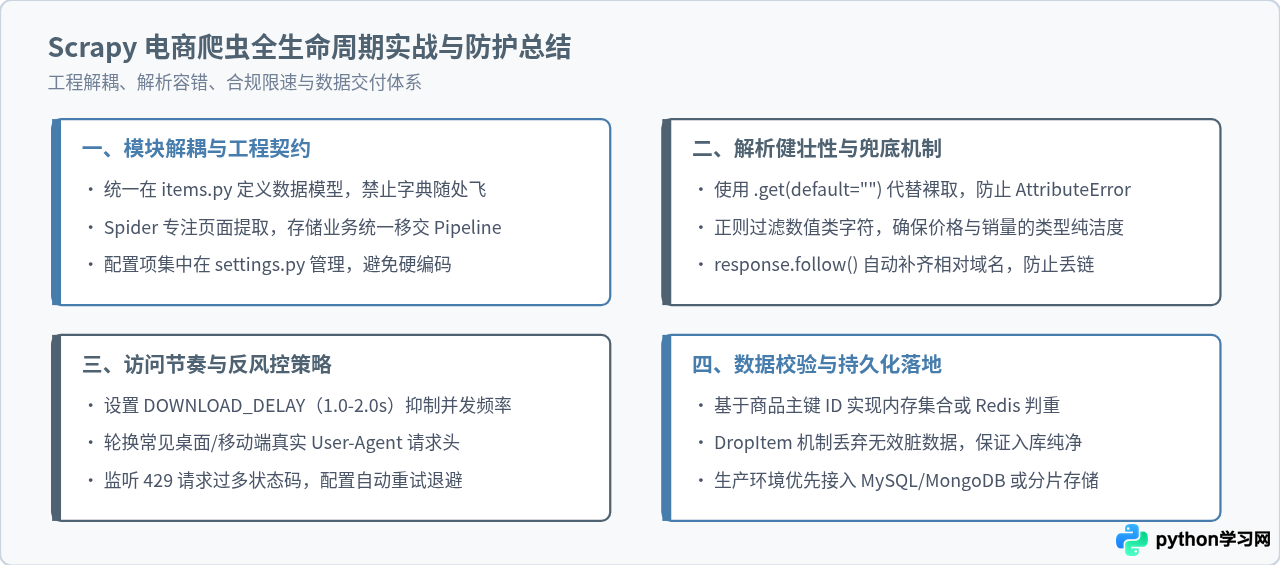
通过本文搭建的工程模板,读者已具备采集常规电商列表页的实战能力。针对未来可能遇到的复杂场景(如点击翻页触发的加密参数、动态加载的瀑布流等),可以在此框架基础上进一步引入 scrapy-playwright 渲染中间件或替换 API 请求接口,实现兼顾开发效率与抓取稳定性的数据采集系统。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















