


Python用str.isalpha()判断字符串是否只含字母
深入解析Python内置字符串方法str.isalpha()的工作机制、判定规则、Unicode特性陷阱,以及如何准确区分纯英文字母与多语言字母字符。
在 Python 中,判断一个字符串是否完全由字母构成,最直接的内置手段是调用字符串对象的 str.isalpha() 方法。当字符串长度至少为 1,且其中每一个字符都被判定为“字母”时,该方法返回 True,否则返回 False。但在实际业务开发中,该方法定义的“字母”涵盖了 Unicode 规范中的全部字母字符(包括汉字、日文假名、带变音符号的拉丁字母等),因此理解其底层机制与边界条件,是正确编写校验逻辑的关键。
一、str.isalpha() 的基本用法与返回值机制
str.isalpha() 是 Python 字符串对象的内置无参方法。它的调用形式非常简洁:直接通过目标字符串实例调用,返回一个布尔值(True 或 False)。
判定条件遵循一个明确的核心原则:“非空且全员为字母”。若字符串为空字符串(""),或者包含任何非字母字符(包括空格、制表符、标点符号、数字、换行符),isalpha() 都会立即返回 False。
# 基础验证示例
s1 = "Python"
s2 = "Python3"
s3 = "Hello World"
s4 = ""

print(s1.isalpha())  # 示例输出: True (全部为ASCII英文字母)
print(s2.isalpha())  # 示例输出: False(包含数字 3)
print(s3.isalpha())  # 示例输出: False(包含中间的空格)
print(s4.isalpha())  # 示例输出: False(空字符串直接返回 False)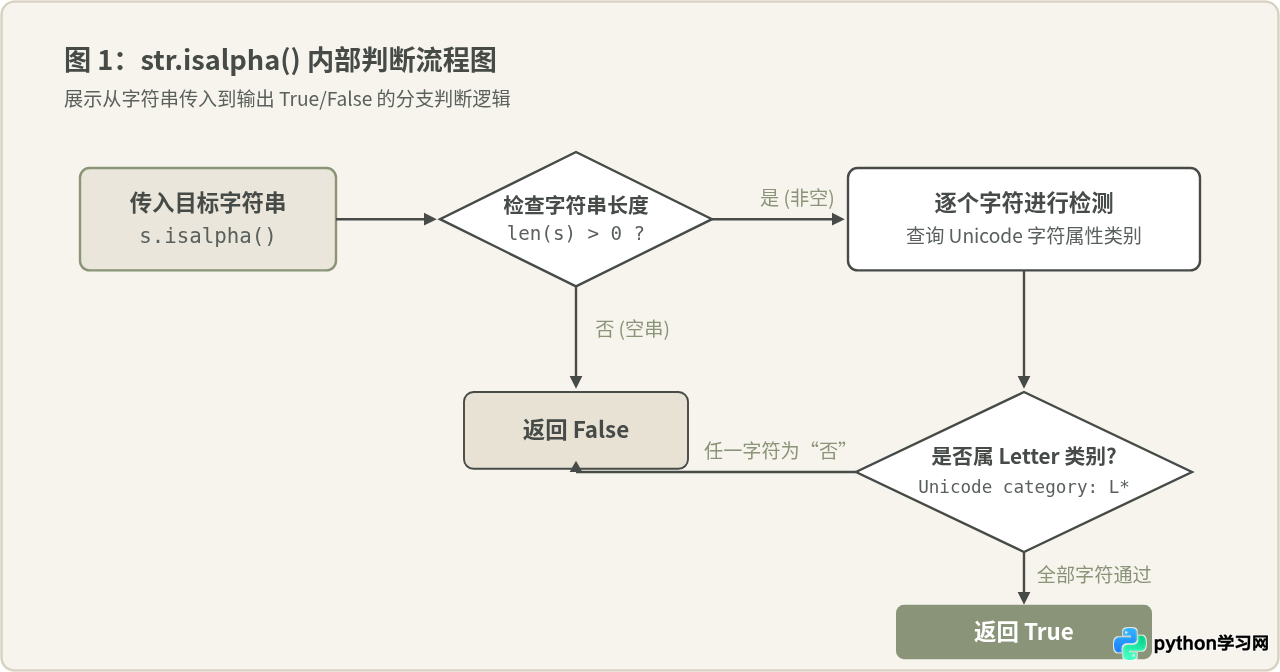
二、核心认知差异:Unicode 字母与纯英文字母
初学者使用 isalpha() 时最常遇到的困惑是:“为什么传入中文、韩文或德语变音符号,也会返回 True?”
在 Python 3 中,字符串对象原生采用 Unicode 编码。官方文档对 str.isalpha() 的标准定义是:
True。所谓“字母字符”,是指在 Unicode 字符数据库中被定义为“Letter”大类的字符,具体包括类别编码为 Lu(大写)、Ll(小写)、Lt(词首大写)、Lm(修饰符字母)或 Lo(其他字母,例如汉字和各种语系的表意文字)。
因此,中文字符(汉字)在 Unicode 标准中属于 Lo(Letter, other),完全符合 isalpha() 的认定范围。
# 多语言字符的 isalpha() 结果
print("Python".isalpha())   # 示例输出: True (ASCII 字母)
print("你好世界".isalpha()) # 示例输出: True (汉字属于 Unicode 字母类别)
print("مرحبا".isalpha())   # 示例输出: True (阿拉伯语字母)
print("café".isalpha())     # 示例输出: True (带重音的拉丁字母)
print("12345".isalpha())    # 示例输出: False (数字属于 Nd 类别)
print("hello!".isalpha())   # 示例输出: False (包含感叹号标点 Po 类别)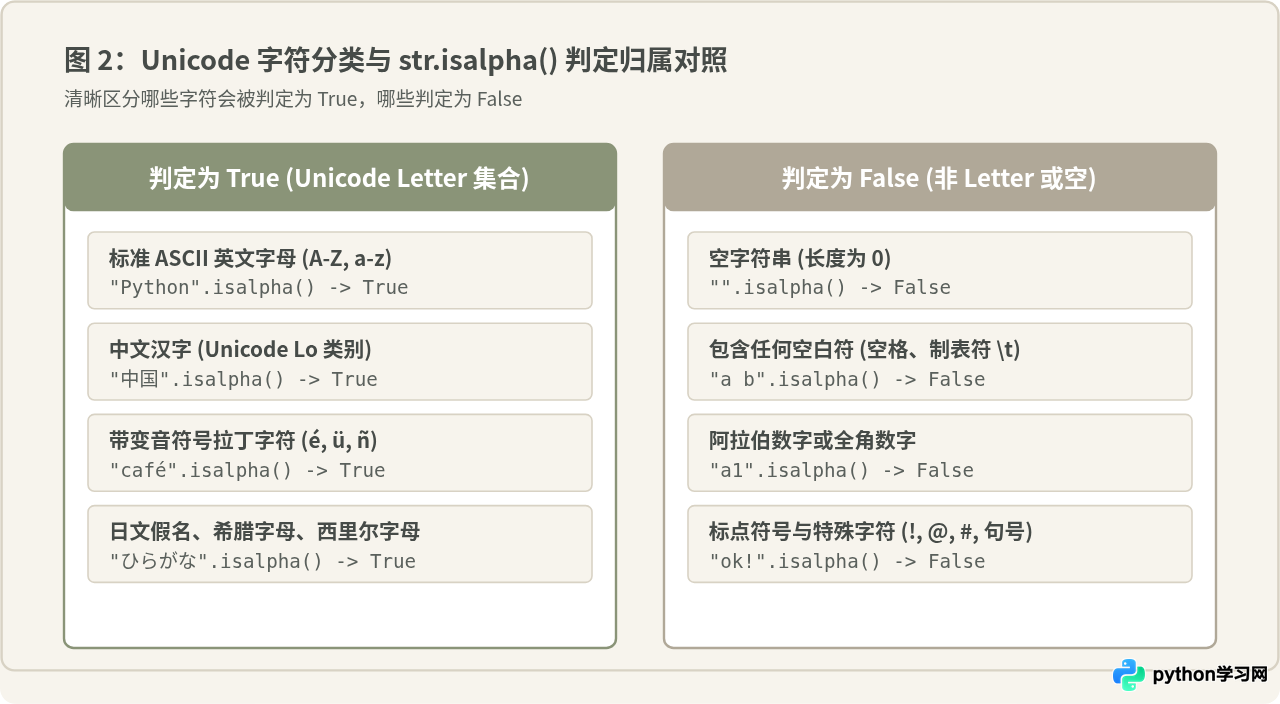
三、业务场景选型:如何区分“只含英文字母”与“全语言字母”
在很多实际业务场景(例如校验英文用户名、变量名标识符、机场三字码)中,开发者的真实诉求往往是“仅允许 26 个 ASCII 英文字母(a-z、A-Z)”。如果直接套用 s.isalpha(),输入汉字或变音字母就会导致校验被绕过。
根据具体需求,我们可以采用以下三种解决方案:
- 方案 1:结合
s.isascii()与s.isalpha()(最推荐):Python 3.7+ 提供了isascii()方法。当一个字符串同时满足“全为 ASCII 字符”和“全为字母”时,即可严密锁定为纯英文字母。语法简洁且执行效率最高。 - 方案 2:使用正则表达式
^[a-zA-Z]+$:通过正则明确限定字符集,适合集成到统一的表单正则验证规则中。 - 方案 3:使用
string.ascii_letters集合比对:直观表达语义,适合对集合操作较熟悉的场景。
import re
import string

def is_pure_english(s: str) -> bool:
    # 方法 1:内置方法组合(性能最好、推荐)
    return s.isascii() and s.isalpha()

def is_pure_english_regex(s: str) -> bool:
    # 方法 2:正则表达式
    return bool(re.fullmatch(r'[A-Za-z]+', s))

def is_pure_english_set(s: str) -> bool:
    # 方法 3:字符集合判断
    return bool(s) and all(c in string.ascii_letters for c in s)

# 测试对比
test_samples = ["HelloWorld", "Hello World", "你好", "café", "Code123"]

for text in test_samples:
    print(f"原字符串: {text!r:<12} -> isalpha: {text.isalpha():<6} -> 纯英文: {is_pure_english(text)}")

# 示例输出:
# 原字符串: 'HelloWorld'   -> isalpha: True   -> 纯英文: True
# 原字符串: 'Hello World'  -> isalpha: False  -> 纯英文: False
# 原字符串: '你好'         -> isalpha: True   -> 纯英文: False
# 原字符串: 'café'         -> isalpha: True   -> 纯英文: False
# 原字符串: 'Code123'      -> isalpha: False  -> 纯英文: False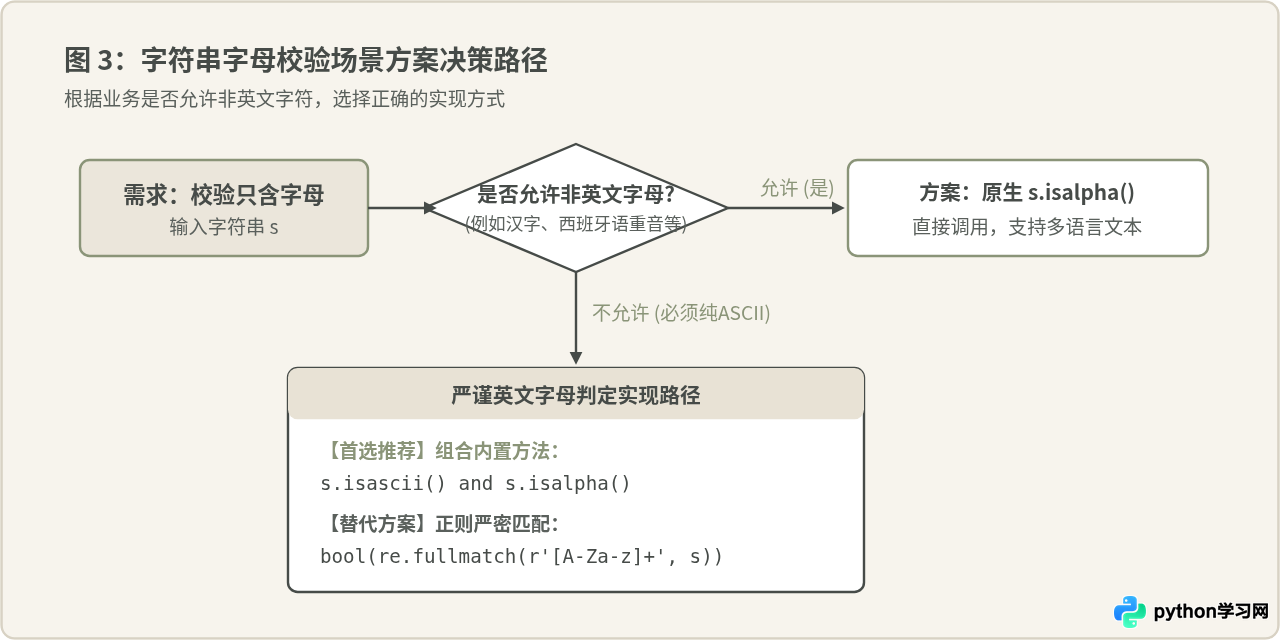
四、常见开发陷阱与注意事项
在编写包含 str.isalpha() 的代码时,以下几个容易疏漏的边界情况需要特别留意:
- 1. 空字符串不会通过校验:
"".isalpha()恒为False。如果在某些可选填字段中允许空值,必须提前进行长度或默认值分流,例如not s or s.isalpha()。 - 2. 包含空格即失效:很多初学者期望校验“全由英文字母组成的句子”,例如
"I am a developer"。由于单词之间含有空格,isalpha()会直接返回False。若要校验英文句子,需先去除空格(如s.replace(" ", "").isalpha())或使用专门正则。 - 3. 标点符号与控制字符:句号、破折号、下划线
_以及换行符\n均不属于字母类别,出现任意一个均会导致返回False。 - 4. 性能考量:
str.isalpha()是 Python 底层由 C 语言直接实现的内置方法,遍历判定速度极快。在没有复杂的字符规则时,优先使用内置方法组合,性能大幅优于加载正则引擎。
五、核心要点总结速查
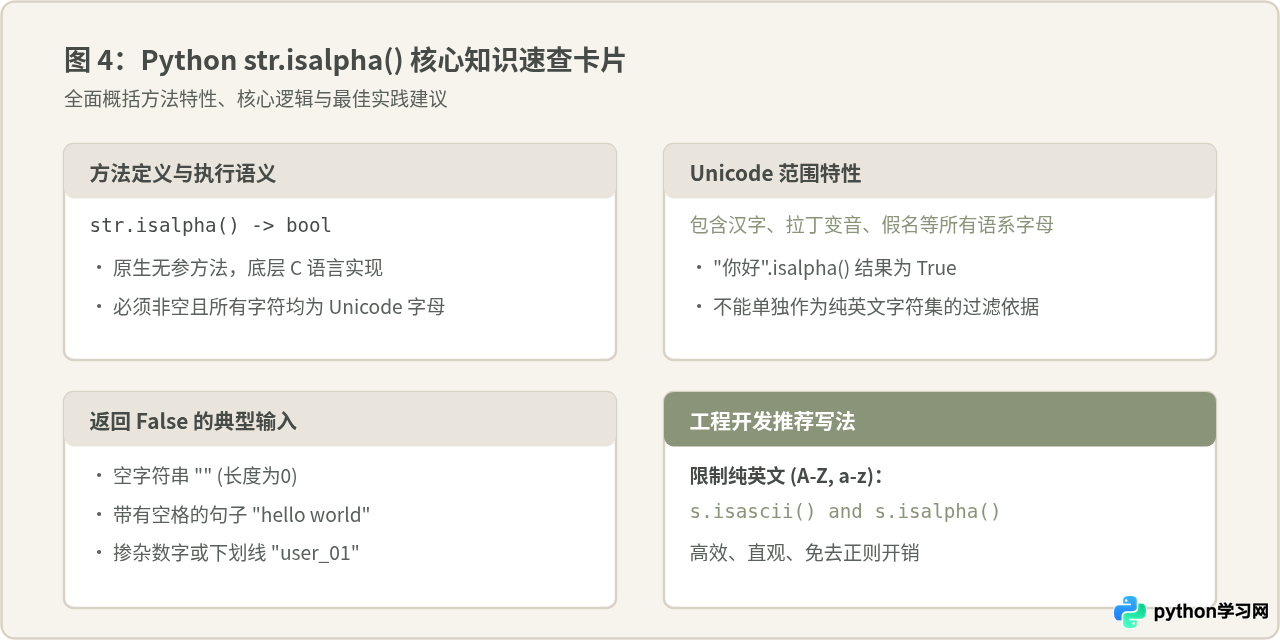
为了方便日常开发查阅,下表与总结卡片对 str.isalpha() 的关键要素进行了梳理:
| 输入字符串示例 | str.isalpha() 返回值 | 原因说明 |
|---|---|---|
"HelloWorld" |
True |
全部为标准 ASCII 大小写英文字母 |
"你好世界" |
True |
Unicode 汉字属于 Lo(Letter, other)字母类别 |
"Python 3" |
False |
包含空格与数字字符 |
""(空串) |
False |
必须至少包含一个字符 |
"data_list" |
False |
下划线属于标点/连接符,非字母 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















