


做数据科学选Anaconda还是原生Python?场景对比
深入对比数据科学场景下Anaconda与原生Python在底层架构、包管理、依赖解决、磁盘占用及生产部署等维度的差异,提供清晰的决策矩阵与操作指南。
做数据科学时,如果是初学者入门、日常科研探索、以交互式 Notebook 分析为主,直接选择 Anaconda 可以省去绝大多数复杂的 C 语言依赖编译与多环境冲突烦恼;如果是工业级模型工程化、容器化微服务部署、Web 混合开发或对轻量级资源控制有严格要求,原生 Python 配合现代虚拟环境与包管理工具则是更稳健的选择。本文将从核心机制、典型工作场景、实操对比及选择路径四个维度展开详述。
一、核心机制与包管理差异:底层逻辑决定适用场景
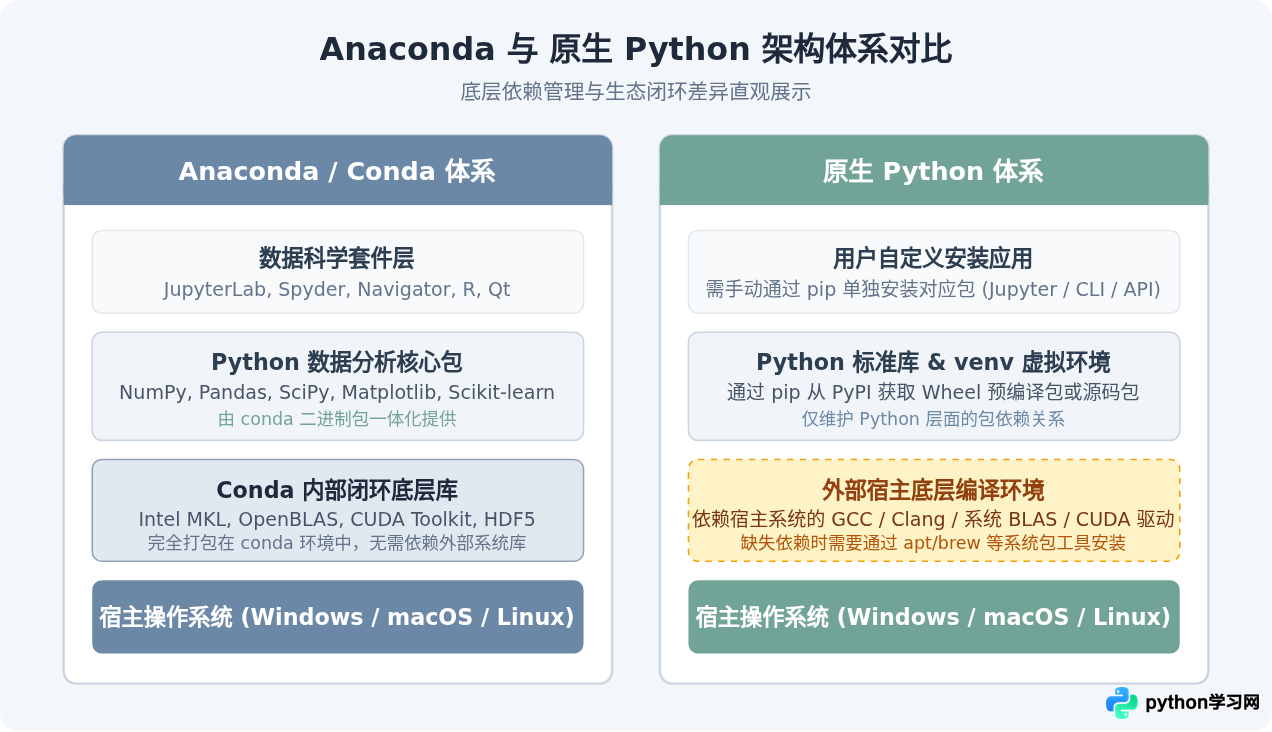
在做选择前,必须先厘清 Anaconda 与原生 Python 在包管理和系统依赖处理上的根本差异。许多人简单地把 Anaconda 理解为“打包了很多库的 Python”,但本质上两者解决问题的层级并不相同。
原生 Python 依赖自带的 pip 工具管理包,pip 主要是针对 Python 语言生态构建的包管理器,通常从 PyPI(Python Package Index)下载 Wheel 二进制包或源码包。数据科学中许多高性能计算库(例如 NumPy、SciPy、PyTorch、LightGBM 等)底层依赖大量的 C/C++、Fortran 科学计算库以及特定的 BLAS/LAPACK、CUDA 动态链接库。如果本地环境缺少匹配的编译链或系统级动态库,使用原生 pip 安装时极易出现编译失败或运行时找不到共享对象的报错。
Anaconda 则采用 conda 作为包与环境管理器。conda 是一个跨语言的通用二进制包管理器,它不仅管理 Python 代码,还直接将预编译好的系统级底层依赖(如 Intel MKL、OpenBLAS、CUDA Toolkit、C++ 运行时等)打包为一个整体。这意味着使用 Conda 安装数据分析栈时,几乎无需关心宿主机底层编译环境,所有 C 动态链接库都由 Conda 闭环维护。
二、关键维度综合对比
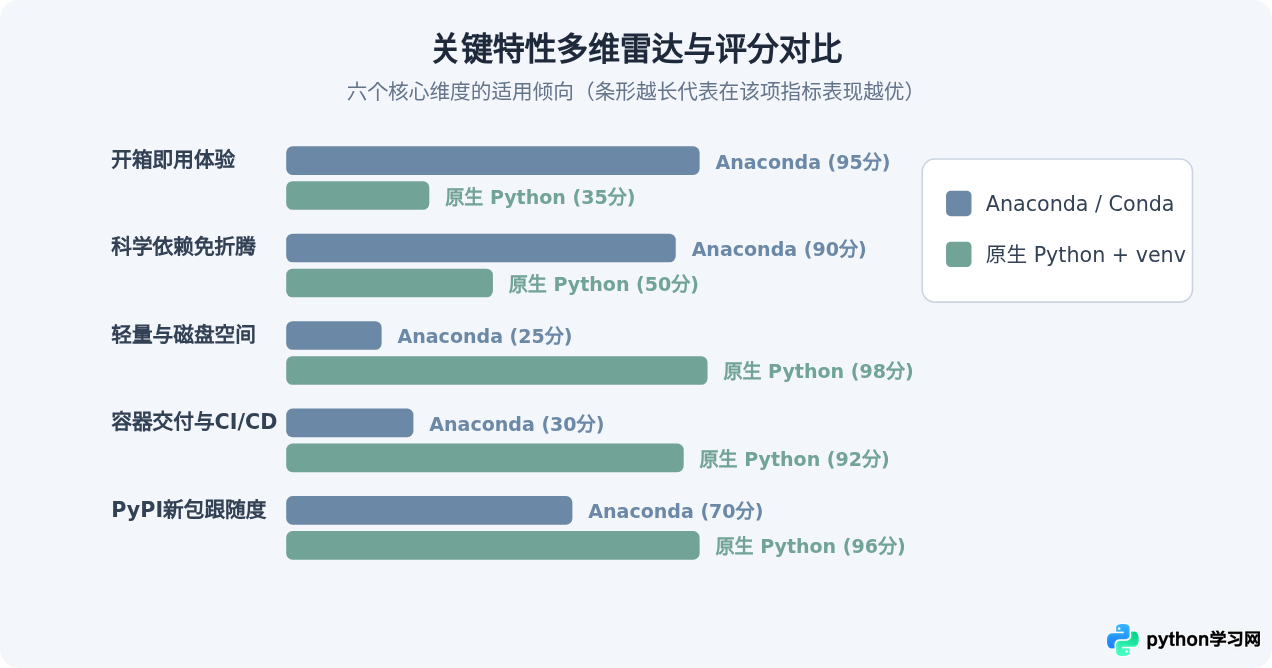
为了让选择更清晰,我们将开发者最关心的六个关键指标整理为下表:
| 对比维度 | Anaconda (完整版) | 原生 Python (+ venv / pip) |
|---|---|---|
| 安装包与磁盘开销 | 安装器约 1GB,解压后占用 3GB~5GB+ 空间。 | 安装包仅数十 MB,基础运行时占用 100MB 左右。 |
| 开箱即用程度 | 极高。自带 Jupyter Notebook、Pandas、Scikit-learn、绘图库等常用科学计算套件。 | 低。仅包含标准库,所有第三方科学计算库均需手动安装。 |
| C/C++ 与科学计算底层依赖 | 通过 Conda 二进制闭环解决,自动匹配 MKL、BLAS 与 CUDA。 | 依赖 PyPI 的预编译 Wheel;无对应 Wheel 时需宿主机具备本地 C/C++ 编译链。 |
| 解析依赖速度 | 历史版本依赖解析较慢(新版已内置 libmamba 求解器大幅改善)。 | pip 解析逻辑相对简单直白,安装纯 Python 库速度极快。 |
| 容器化与生产交付 | 体积庞大,通常不作为生产容器镜像的基础镜像。 | 极度轻量,非常适合制作精简的 Docker 生产镜像。 |
| 图形界面管理工具 | 提供 Anaconda Navigator,支持点选安装包与切换环境。 | 纯命令行操作(或通过 VS Code、PyCharm 等 IDE 插件交互)。 |
三、典型使用场景下的具体取舍
1. 高校科研、数据挖掘与入门学习:优先选择 Anaconda
在这个场景中,用户的核心诉求是“快速验证算法与分析数据”,而不是“排查编译环境”。安装完整版 Anaconda 后,只需在终端输入 jupyter lab,即可立即调用 Pandas 读写表格、Matplotlib 绘制图表、Scikit-learn 拟合模型。此外,Conda 官方源中提供的 NumPy、SciPy 默认链接了高度优化的 Intel MKL 数学核心库,在 CPU 密集型的矩阵运算时能够自动获得良好的多线程加速效果。
2. 深度学习与 GPU 加速环境搭建:选择 Anaconda 或 Miniconda
深度学习需要配合 NVIDIA CUDA 和 cuDNN 驱动库。在原生 Python 下,开发者往往需要在宿主机上先独立安装特定版本的 CUDA Toolkit,并将环境变量与系统动态链接库路径配置准确,否则 PyTorch 或 TensorFlow 极难调用 GPU。而在 Conda 体系下,安装 GPU 版本框架时,Conda 会直接将兼容的 CUDA 二进制运行时一并安装在虚拟环境中,无需改动宿主机全局驱动配置。
3. 生产微服务、FastAPI/Flask 数据接口与 Docker 镜像:坚决选择原生 Python
当模型训练完成,需要封装为 RESTful API 部署到 Kubernetes 或云服务器时,镜像体积与构建速度至关重要。一个基于 Anaconda 基础镜像构建的容器通常在 3GB 以上,拉取与启动非常缓慢;而基于原生 Python 官方精简镜像(例如 python:3.11-slim)构建的镜像通常只有 200MB~400MB,极大地节省了云端存储、带宽并提升了弹性伸缩时的冷启动速度。
4. 混合项目与团队通用协作:原生 Python 生态更贴合现代工程实践
在大型工程团队中,项目往往包含 Web 后端、数据入库脚本与数据分析模块。原生 Python 生态下的现代工具链(如 uv、poetry 或标准 pip-tools)具备极快且确定性的锁文件(Lockfile)机制,能严格确保生产与开发环境版本完全一致,与其他常规 Python 服务的 CI/CD 流水线天然兼容。
四、两套环境的日常实操工作流对比
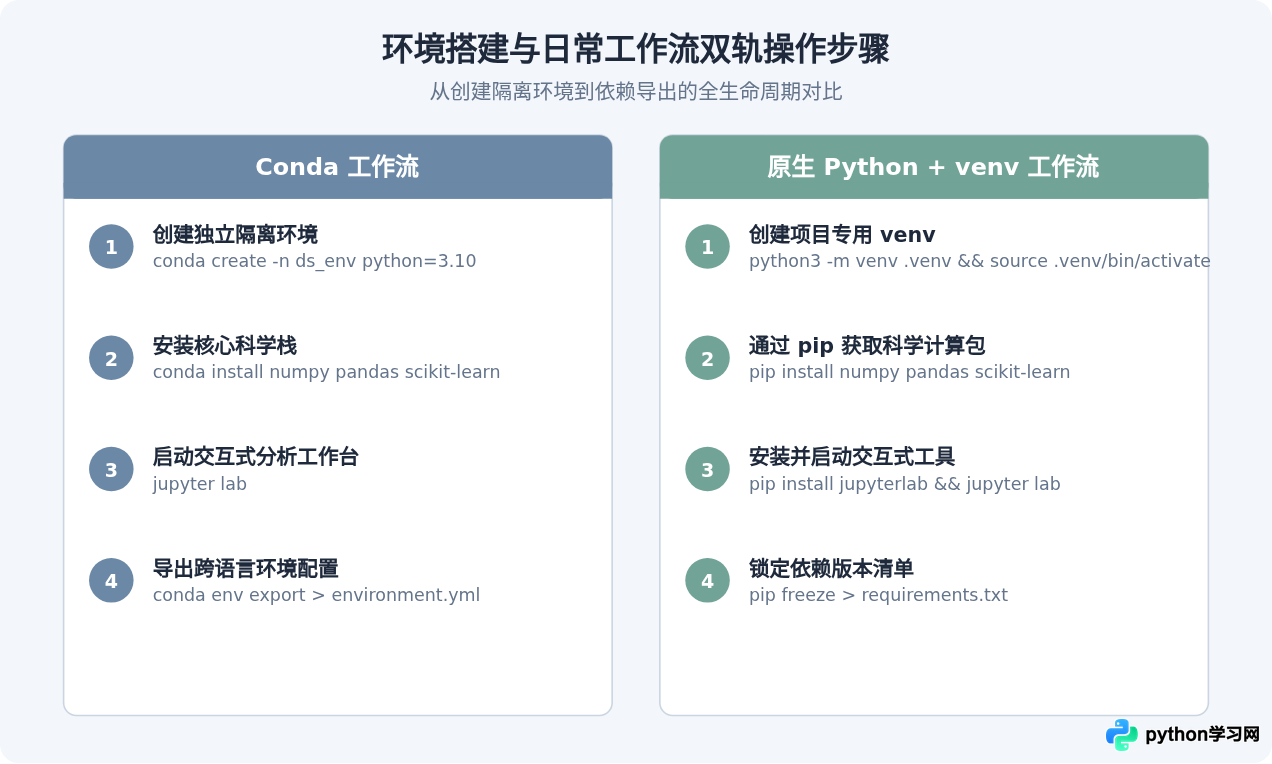
为了直观展现两者在实际工作流中的差异,以下分别演示两种方式从创建环境、安装依赖、启动交互分析到导出环境配置的完整命令链:
实操代码对比演示
方案 A:使用 Conda 进行环境管理与安装
# 1. 创建指定 Python 版本的数据科学隔离环境
conda create -n ds_env python=3.10 -y

# 2. 激活新建的环境
conda activate ds_env

# 3. 通过 conda 安装核心数据科学包
conda install numpy pandas scikit-learn matplotlib jupyterlab -y

# 4. 导出当前环境定义(便于他人完整复现)
conda env export --no-builds > environment.yml
方案 B:使用原生 Python + venv 进行管理与安装
# 1. 在当前项目目录下创建名为 .venv 的虚拟环境
python3 -m venv .venv

# 2. 激活虚拟环境 (macOS/Linux)
source .venv/bin/activate
# Windows PowerShell 请使用: .venv\Scripts\Activate.ps1

# 3. 升级 pip 并安装核心数据分析依赖
pip install --upgrade pip
pip install numpy pandas scikit-learn matplotlib jupyterlab

# 4. 固化当前依赖到 requirements 文件
pip freeze > requirements.txt在使用 Conda 环境时,最常见的报错源自无序混用 pip 与 conda。由于 conda 对包的元数据管理是自主闭环的,而 pip 并不完全理解 Conda 的内部链接,一旦使用 pip 覆盖了 Conda 安装的底层包(如底层 C 依赖),极易造成整个环境依赖崩溃。正确做法是:优先使用 conda install <package>;若某个小众包只存在于 PyPI,且 Conda 官方与 conda-forge 均无提供,再在最后阶段使用 pip 安装,并避免更新基础包。
五、折中方案:Miniconda / Pixi 是否是更优解?
如果你既想要 Conda 强大的底层 C 库依赖管理能力,又觉得 Anaconda 默认预装 3GB~5GB 的全家桶过于臃肿,那么 Miniconda 是一个非常受资深数据科学家青睐的折中方案。Miniconda 仅包含 Conda 包管理器和极小化的 Python 基础运行时,安装包仅几十兆,之后只需根据实际项目需求逐步 conda install 所需库,既保持了环境轻简,又享有跨平台二进制支持。
此外,近年来数据工程界兴起的新一代工具(如基于 Rust 开发的 pixi,或者基于原生 Python 生态的高性能工具 uv),正进一步缩小 Conda 与原生 Python 之间的体验差距。pixi 采用 Conda 生态的包源,但解析与安装速度极快;而 uv 则将原生 pip 与 venv 的速度提升了数十倍。
六、总结与决策指南
选型并不存在绝对的优劣,只有与当下工作流程是否契合。根据实际需求,可参考以下决策路径:
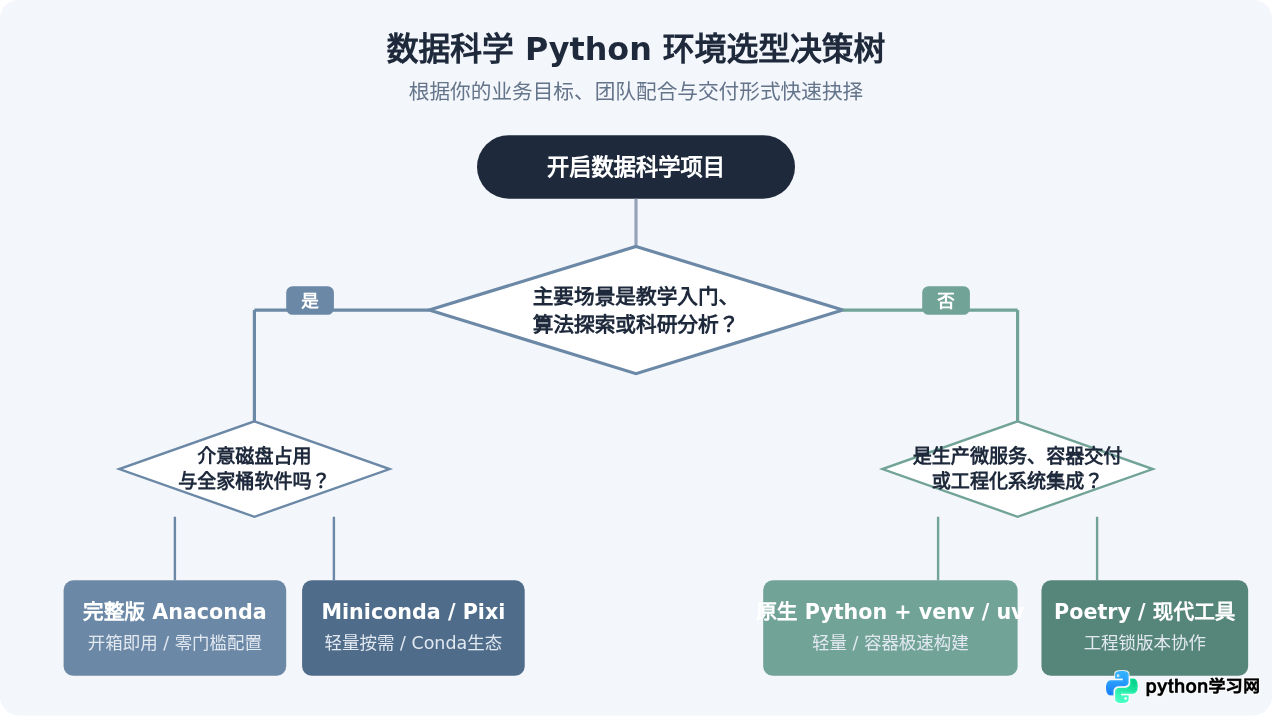
- 初学者、在校师生、算法研究员:毫不犹豫选用 Anaconda(或者使用 Miniconda 手动安装 Jupyter),将宝贵的时间投入在统计模型与数据挖掘逻辑本身,避开底层动态库报错的困扰。
- 全栈工程师、MLOps 部署人员、后端工程师:推荐坚持使用 原生 Python + venv / uv,保持生产镜像精简稳定,与云原生和自动化构建链路保持无缝接轨。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















