


Anaconda环境与原生Python 3安装pandas的区别及推荐
深入解析在Anaconda环境与原生Python 3下安装pandas的本质区别,涵盖底层C库依赖管理、磁盘开销、版本时效、操作步骤与多场景选型推荐。
pandas,最终在 Python 脚本中所调用的 DataFrame API 与数据处理功能没有任何区别。二者的根本差异在于底层依赖治理模式、系统级二进制库(C/Fortran/MKL)分发机制、磁盘空间消耗以及环境在生产或科研场景中的交付成本。本文将系统拆解两条安装路径的技术本质,提供规范的操作与验证步骤,并给出针对不同应用阶段的明确选型建议。
一、一个常被忽视的现象:为什么“同样是安装”,底层完全不同?
很多初次接触 Python 数据分析的学习者和开发者,常把 Anaconda 简单视作“自带 pandas、numpy 和 Jupyter Notebook 的 Python 整合包”,把原生 Python 3 视作“需要自己手动敲 pip install pandas 的简装版”。这种理解忽略了底层最核心的包管理哲学。
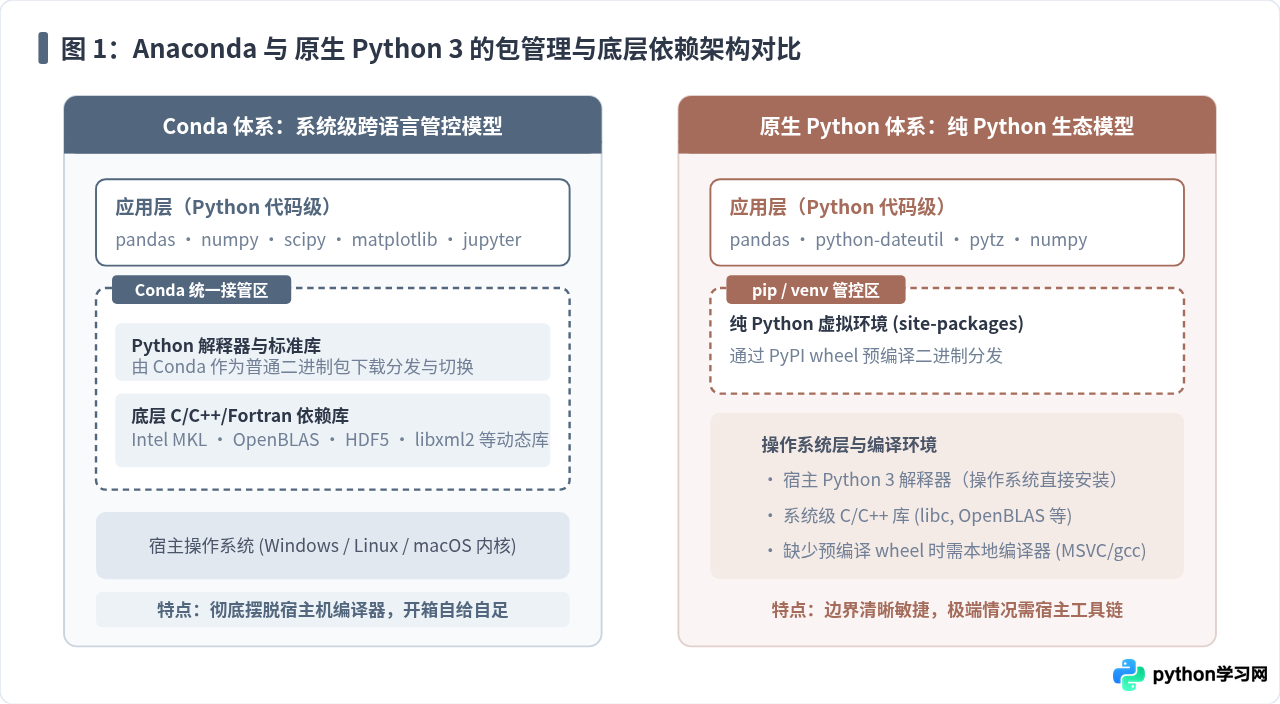
当你在原生 Python 3 中执行 pip install pandas 时,pip 主要是作为 Python 语言生态的包管理器工作,它默认从 Python Package Index (PyPI) 下载 Python 代码以及预编译的 Wheel 二进制包,并将其放置于 Python 解释器对应的 site-packages 目录中。而 Anaconda 所采用的 conda,从设计之初就不是单纯的 Python 包管理器,而是一个跨语言的系统级包和环境管理器。在 conda 的视角里,不仅 pandas 是一个包,连 Python 解释器自身、底层的 C++ 运行时库、以及 Intel MKL / OpenBLAS 等高性能数学计算库,都是平级的系统二进制依赖。
二、底层架构与依赖管理模型深度剖析
pandas 并不是一个纯 Python 编写的轻量库,它大量基于 C 语言编写的 Cython 扩展,并高度依赖 numpy 进行底层连续内存向量计算。了解这一点,是搞清二者区别的关键起点。
1. Anaconda (Conda) 的依赖捆绑闭环
Anaconda 借助 Conda 的二进制分发机制,将经过预编译和兼容性测试的整个科学计算工具链作为一个闭环生态提供给用户。当通过 conda install pandas 安装时,Conda 会一并解析并安装经过官方调优的底层线性代数加速库(在 x86 架构下通常直接绑定 Intel MKL 高性能数学核心库,或高质量配置的 OpenBLAS)。
这种机制的最大优势是自洽性极强:用户计算机上即使没有安装任何 C/C++ 编译器(如 Windows 上的 Visual C++ Build Tools 或 Linux 上的 gcc/gfortran),也绝不会遇到编译失败的问题。Conda 连同动态链接库及其在操作系统中的链接路径都一并做了沙箱化隔离。
2. 原生 Python 3 (pip) 的依赖链条与 Wheel 机制
官方原生 Python 3 强调轻量化与通用语言标准。在早期的 Python 生态中,直接在 Windows 或部分 Linux 机器上使用 pip install pandas 容易遇到缺少 C 编译器的报错。但随着 PEP 513、PEP 571 等 manylinux 规范和通用预编译 wheel 格式的普及,现在在绝大部分主流操作系统(Windows、macOS、主流 Linux 发行版)上执行 pip install pandas,都会直接从 PyPI 下载预先编译好机器码的 .whl 文件,通常内嵌了标准的 OpenBLAS 动态库,无需本地编译即可快速安装。
然而,pip 的管理边界严格停留在 Python 语言层面。如果涉及复杂的系统级底层依赖(例如特殊的硬件驱动绑定、特殊的动态库链接或特殊架构芯片),pip 无法像 conda 那样直接调度底层的系统软件资产。
三、两套环境的标准安装与验证实操
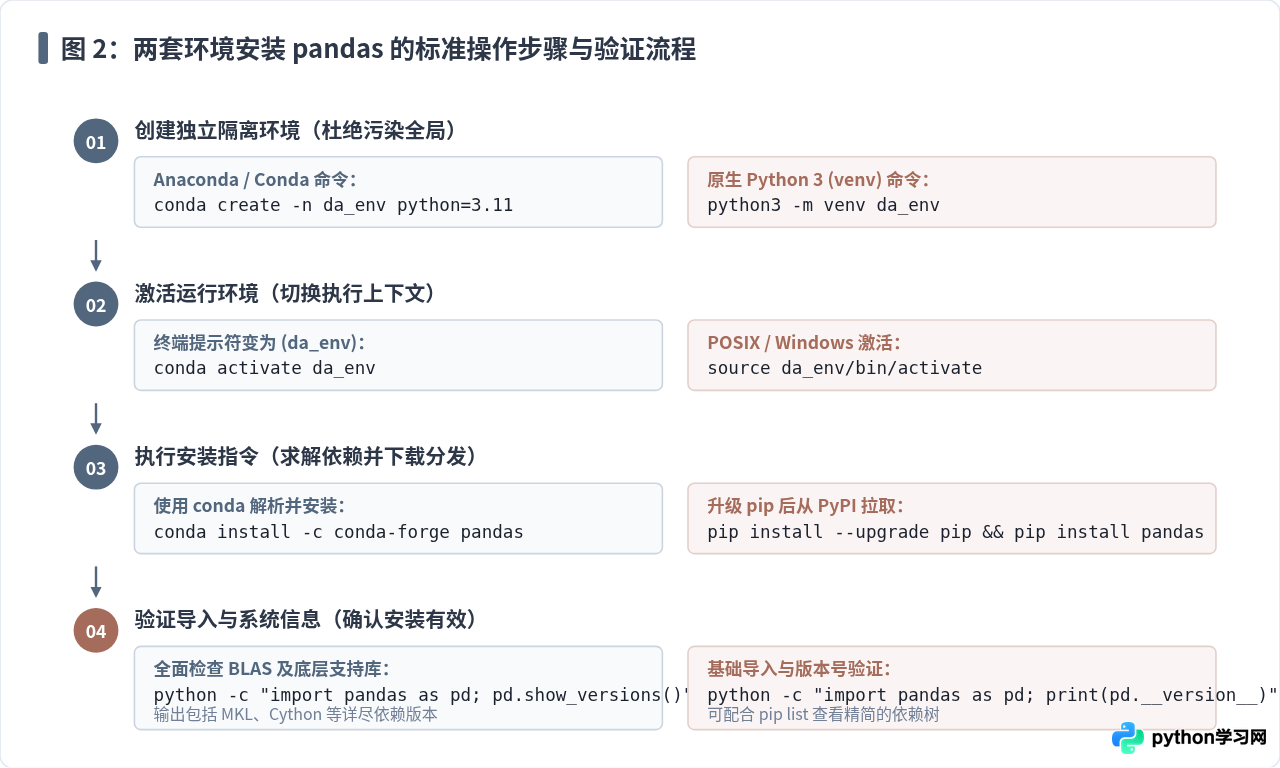
无论选用哪套环境,最核心的工程规范是:永远不要直接在全局默认环境(如 Anaconda 的 base 环境或操作系统的全局 Python)中无节制堆砌第三方库。必须为特定项目建立独立的虚拟环境。
方案 A:Anaconda / Conda 环境下的规范安装
在已经安装了 Anaconda(或轻量版 Miniconda)的终端中,规范操作流程如下:
# 1. 创建指定 Python 版本的独立环境(避免污染 base 环境)
conda create -n my_analysis_env python=3.11 -y

# 2. 激活新建的虚拟环境
conda activate my_analysis_env

# 3. 安装 pandas(推荐通过官方或活跃的 conda-forge 频道)
conda install -c conda-forge pandas -y
安装完成后,我们需要验证 pandas 是否成功载入,并检查其底层的运行时信息:
# 4. 执行详细依赖检查命令
python -c "import pandas as pd; pd.show_versions()"------------------
commit : None
python : 3.11.8.final.0
python-bits : 64
OS : Darwin
pandas : 2.2.1
numpy : 1.26.4
pytz : 2024.1
dateutil : 2.9.0
openpyxl : None
方案 B:原生 Python 3 环境下的规范安装
从 Python 官方网站(python.org)下载安装的 Python 3,内置了 venv 虚拟环境模块与 pip 工具包。规范操作步骤如下:
# 1. 在项目目录中利用标准库 venv 创建虚拟环境
python3 -m venv my_da_env

# 2. 激活虚拟环境
# Linux / macOS 环境执行:
source my_da_env/bin/activate
# Windows PowerShell 环境执行:
# .\my_da_env\Scripts\Activate.ps1

# 3. 升级 pip 并从 PyPI 安装 pandas
pip install --upgrade pip
pip install pandas
安装完毕后,执行快速测试以确认基础功能与版本:
# 4. 验证 pandas 导入与版本号
python -c "import pandas as pd; print(f'pandas version: {pd.__version__}'); df = pd.DataFrame({'A': [1, 2]}); print(df)"A
0 1
1 2
四、核心维度全面对比
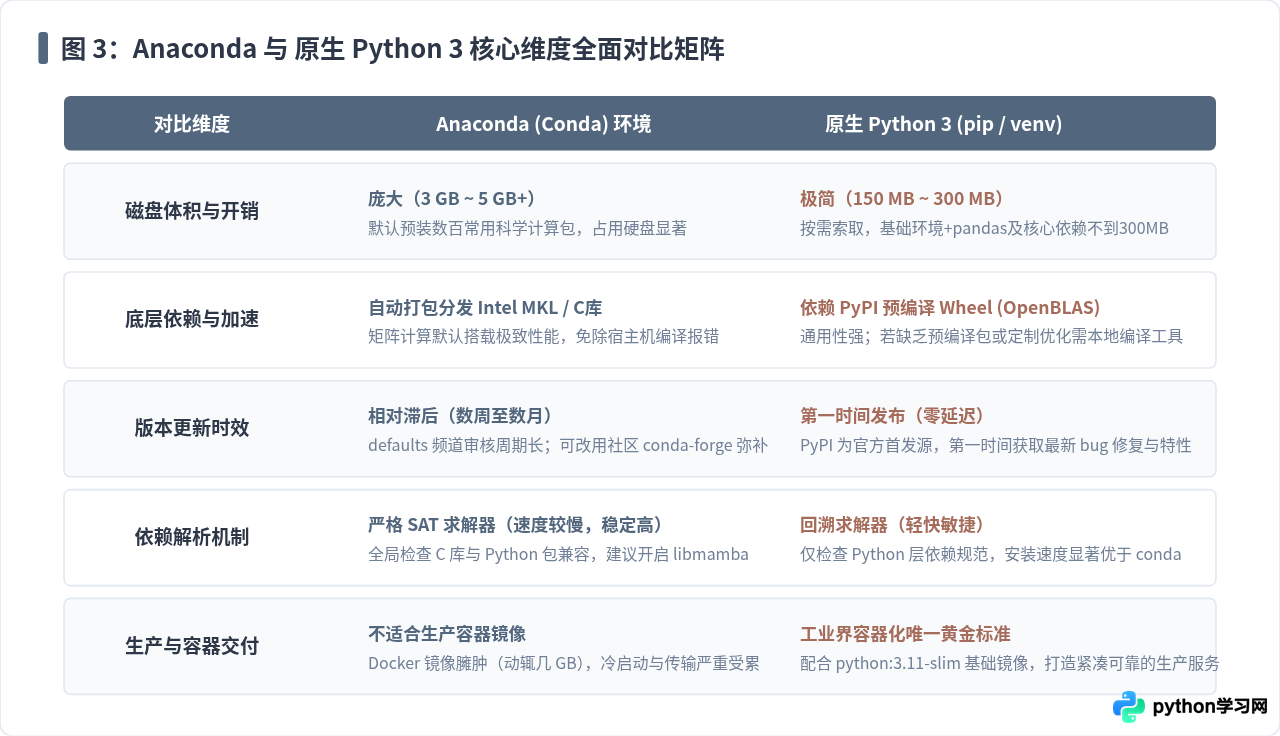
为了帮助读者根据实际工作场景进行理性权衡,我们将两者的关键指标整理在下述对比矩阵中:
Anaconda (Conda) 体系
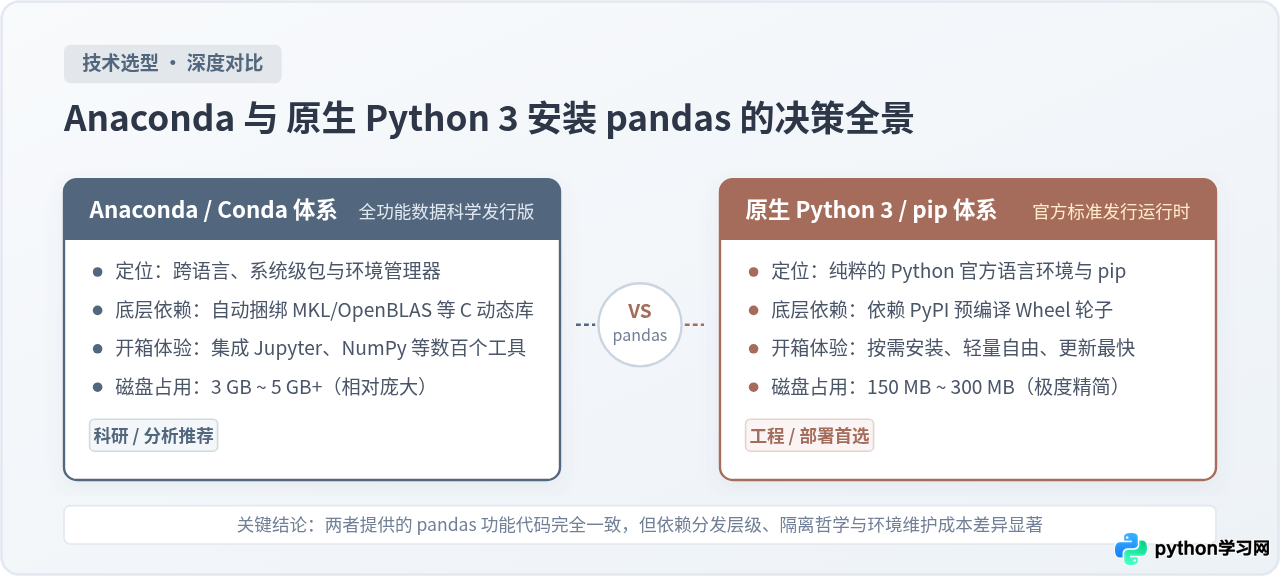
- 磁盘占用:完整版 Anaconda 占用约 3~5 GB+,若环境较多容易迅速吞噬几十 GB 空间。
- 求解器效率:Conda 需要同时计算 C 依赖与 Python 依赖的全局相容性,早期的 SAT 求解器耗时较长(可通过更新
conda-libmamba-solver提速)。 - 版本发布:Anaconda 官方默认 (defaults) 频道对新版本的跟进通常滞后数周至数月;conda-forge 相对及时。
- 适用开发流:非常适合搭配 Jupyter Lab / Notebook 进行探索式分析、统计科研和本地教学演示。
原生 Python 3 (pip) 体系
- 磁盘占用:Python 解释器约 50~100 MB,虚拟环境中包含 pandas、numpy 等全部核心依赖仅约 150~300 MB,极其精简。
- 求解器效率:pip 现代版本具备回溯求解机制,只针对 Python 生态的依赖元数据求解,解析与下载速度极快。
- 版本发布:PyPI 是 Python 生态的官方发布第一线,随时可安装到 pandas 的最新稳定版或预发布版。
- 适用开发流:非常适合微服务 API、Web 后端、持续集成 (CI/CD) 流水线以及轻量 Docker 容器。
五、精准选型指南:我到底应该选哪个?
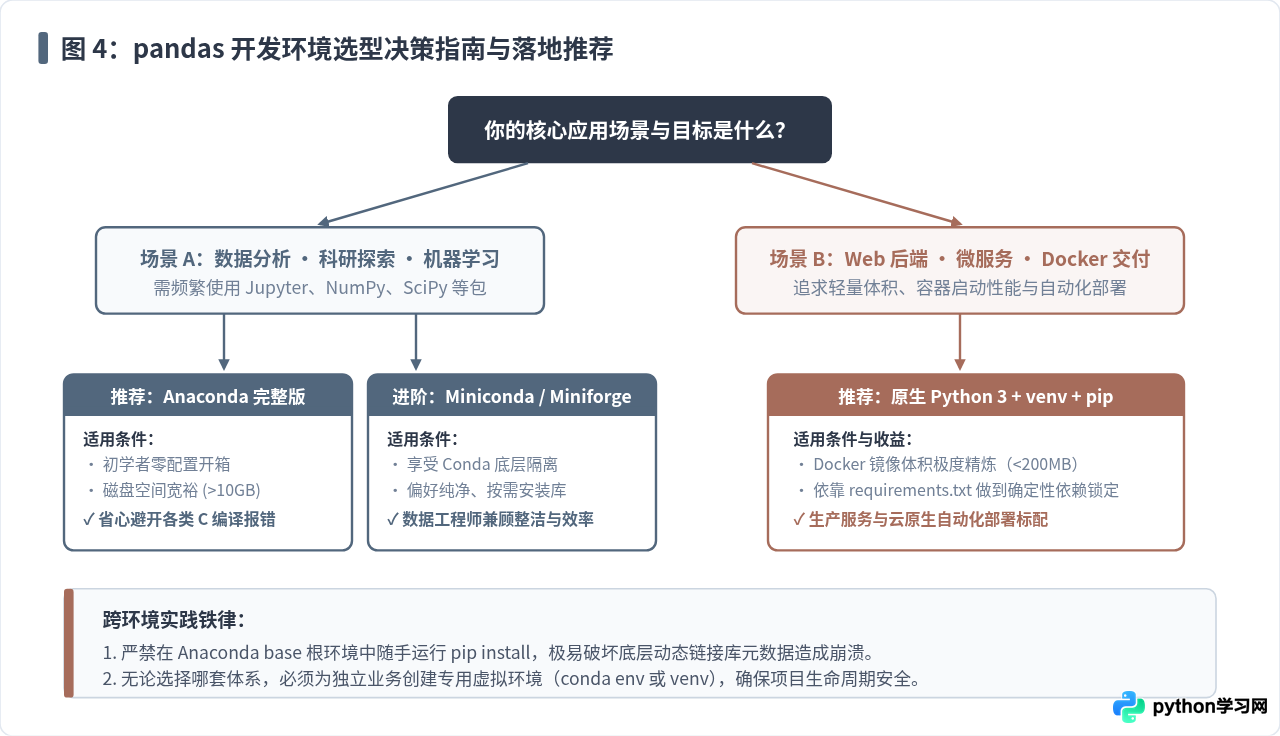
没有一种工具能够脱离上下文成为绝对的“最优解”。选型的关键在于你的工作目标是“本地探索式数据研究”还是“可交付的软件工程”。
1. 坚定推荐 Anaconda(或 Miniconda / Miniforge)的场景
- 初涉数据科学、统计学与机器学习:如果你不想在一开始就被配置 PATH 环境变量、缺少 C 运行时、配置 Jupyter 扩展等繁琐的运维细节打退堂鼓,Anaconda 的全家桶体验是最省心的选择。
- 科研实验与跨语言分析:研究项目中若需要混合调用 R 语言、C++ 动态库、特定版本 CUDA 或复杂地理信息库(如 GDAL、GEOS),Conda 能够提供无可替代的跨语言依赖解析能力。
- 折中推荐(Miniconda / Miniforge):如果你既想要 Conda 强悍的系统依赖隔离,又难以容忍 Anaconda 动辄几个 GB 的预装膨胀,强烈推荐直接使用 Miniconda 或 Miniforge。它只包含 Python 与 Conda 基础引擎,体积仅约 400 MB,后续所需的所有科学库完全由你通过命令行按需安装。
2. 坚定推荐 原生 Python 3 + pip (venv) 的场景
- 生产环境与 Web / API 后端:若项目需使用 FastAPI、Django 或 Flask 搭建服务,而 pandas 仅用于后台报表导出或简单数据汇总,坚决使用原生 Python 3。
- Docker 容器化交付:在构建生产镜像时,基于官方
python:3.11-slim基础镜像构建并配合pip install pandas,构建出的镜像体积通常仅需 200~300 MB,冷启动只需几十毫秒;而若把完整 Anaconda 塞进 Docker 镜像,体积将膨胀至数 GB,拉取与伸缩性能大幅退化。 - 规范化工程交付:在跨团队协作中,
requirements.txt或基于poetry、uv、pip-tools的依赖锁定文件是现代 Python 工程的事实标准,原生工具链在各类 CI/CD 平台(如 GitHub Actions、GitLab CI)上支持最为原生和敏捷。
六、实践中的高频陷阱与避坑准则
许多初学者在激活 Anaconda 后,习惯性地直接输入
pip install pandas 或其他库。在 base 环境中混用 pip 与 conda 会导致两者相互覆盖动态链接库与包元数据,久而久之会引发 Conda 求解器报出诡异的环境破坏性冲突(如 Solving environment: failed with initial frozen solve),最终往往只能推倒重装 Anaconda。
- 如果使用 Conda,优先在每个项目中建立独立隔离环境:
conda create -n proj_env,并在该环境中优先通过conda install安装库,仅在 conda 频道缺失该库时才在当前环境内使用pip。 - 如果使用原生 Python 3,安装完成 Python 后务必养成在项目根目录下执行
python -m venv .venv的肌肉记忆,始终在虚拟环境中利用pip管理依赖。
结语
无论是通过 Anaconda 还是原生 Python 3 安装 pandas,你在 Python 交互层所编写的 pd.read_csv()、df.groupby() 逻辑与性能表现并无本质差别。理解二者的区别,实质上是在理解“面向数据科学的闭环集成体系”与“面向现代软件工程的微型解耦生态”之间的设计取舍。根据项目所处的阶段、团队交付的标准以及机器硬件的约束合理选用,便能兼顾开发效率与工程稳定性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















