


Python怎么根据指定字段对对象列表去重
深入解析在Python中如何根据自定义对象的特定属性或字典的指定键对列表进行去重,涵盖保持顺序的集合辅助法、字典覆盖法、itertools分组以及不同场景下的选型策略。
在处理业务数据、解析接口返回或整合多源数据时,我们经常需要对一个由对象(如自定义类的实例或字典)构成的列表进行去重。Python原生的 list(set(items)) 仅适用于纯数字、字符串等可哈希且不需要指定维度的简单场景;而对于复杂的对象列表,若直接使用 set(),往往会因为对象未实现哈希方法而抛出异常,或者因为每个实例内存地址不同而导致完全无法去重。本文将介绍几种根据指定字段去重的标准解法,并对比它们的执行机制与适用场景。
一、问题根源与去重逻辑拆解
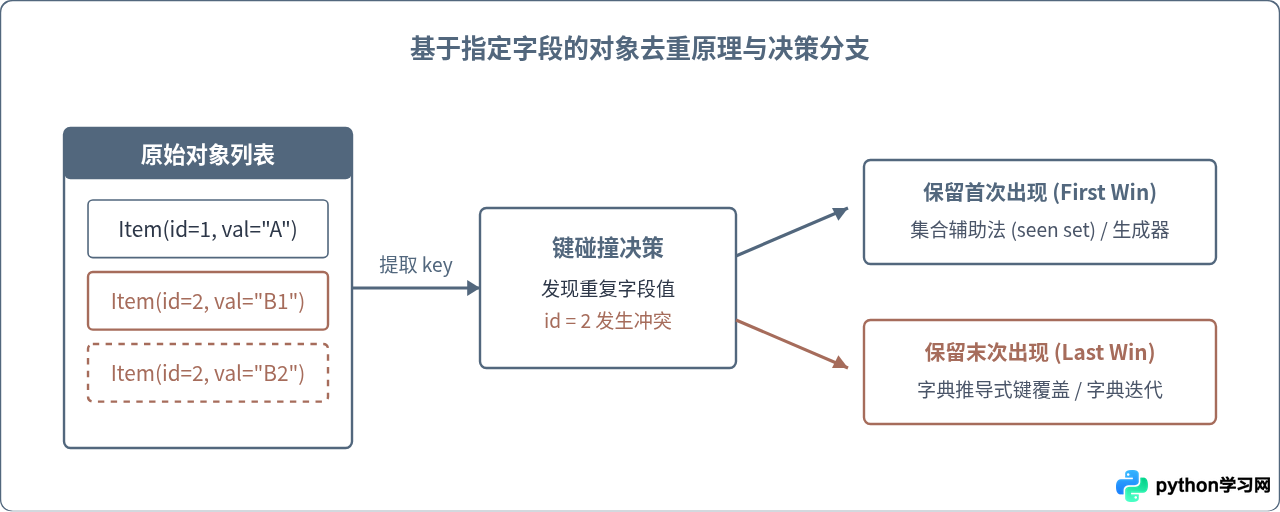
在Python中,对包含自定义对象或字典的列表执行基于特定字段的去重,核心矛盾在于“判定相等的准则”由对象自身整体属性退化为了“某个特定字段的等值性”。与此同时,去重通常伴随着次序选择:当存在重复记录时,是保留第一次出现的元素,还是保留最后一次出现的元素?
理解这两种需求走向,能够帮我们迅速选出最优的去重架构。
二、方法一:集合辅助遍历法(保持原序且保留首次出现)
在绝大多数业务场景下,我们希望去重后的列表严格维持原始列表的排列顺序,并且在出现重复字段时,优先保留最先出现的那一项。最地道、高效的做法是使用一个临时的 set 记录已经扫描过的字段值。
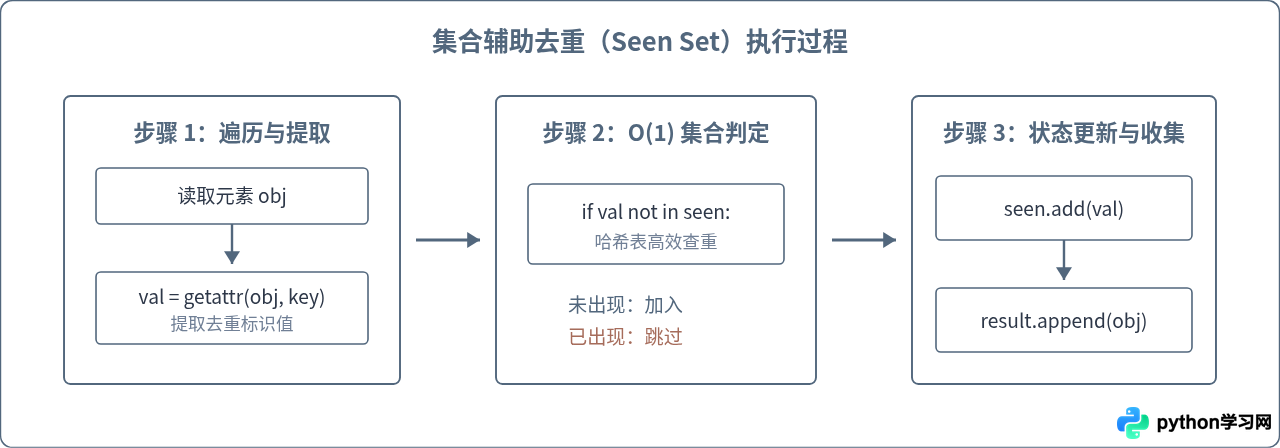
下面是通用函数的完整实现。该实现同时兼容自定义对象属性(如 user.id)以及字典键(如 user['id']):
def deduplicate_by_field(items, key_extractor):
    """
    根据指定字段对列表去重,保留首次出现的元素并保持原有次序
    :param items: 待去重对象列表
    :param key_extractor: 提取字段值的函数,或字符串字段名
    :return: 去重后的新列表
    """
    seen = set()
    result = []

    # 支持传入字段名字符串或自定义提取函数
    is_callable = callable(key_extractor)

    for item in items:
        if is_callable:
            val = key_extractor(item)
        elif isinstance(item, dict):
            val = item.get(key_extractor)
        else:
            val = getattr(item, key_extractor, None)

        if val not in seen:
            seen.add(val)
            result.append(item)

    return result

# 示例验证:自定义用户类
class User:
    def __init__(self, uid, name):
        self.uid = uid
        self.name = name

    def __repr__(self):
        return f"User(uid={self.uid}, name='{self.name}')"

user_list = [
    User(101, "Alice"),
    User(102, "Bob"),
    User(101, "Alice_Duplicate"),
    User(103, "Charlie")
]

cleaned_users = deduplicate_by_field(user_list, "uid")
print("示例输出 (对象列表):", cleaned_users)
# 示例输出 (对象列表): [User(uid=101, name='Alice'), User(uid=102, name='Bob'), User(uid=103, name='Charlie')]
对于数据量庞大、追求内存效率的场景,可以将上面的循环包装成生成器(Generator),边处理边消费:
def deduplicate_generator(items, key):
    seen = set()
    for item in items:
        val = getattr(item, key) if not isinstance(item, dict) else item.get(key)
        if val not in seen:
            seen.add(val)
            yield item
三、方法二:字典推导式键覆盖(一行代码与保留末次出现)
从 Python 3.7 开始,标准字典正式保证维护键的插入顺序。当我们将一个列表转换为字典时,如果出现重复的键,后插入的值会自然覆盖先插入的值。
利用这个特性,我们可以写出极其精炼的单行推导式:
# 场景:字典列表,按 "id" 去重,保留最后一次出现的记录
raw_records = [
    {"id": 1, "status": "pending"},
    {"id": 2, "status": "completed"},
    {"id": 1, "status": "resolved"}  # 与第一条冲突
]

# 利用字典覆盖特性
deduped_last = list({item["id"]: item for item in raw_records}.values())

print("示例输出 (保留末项):", deduped_last)
# 示例输出 (保留末项): [{'id': 1, 'status': 'resolved'}, {'id': 2, 'status': 'completed'}]
reversed(raw_records)),最后再次反转结果。虽然可行,但此时代码可读性与执行开销不及集合辅助法直观。
四、方法三:itertools.groupby(适合已排序的流水线数据)
在数据分析与管道处理中,如果输入的数据流本身已经按照目标字段排好序,或者需要进行阶段性分批,可以使用标准库中的 itertools.groupby。
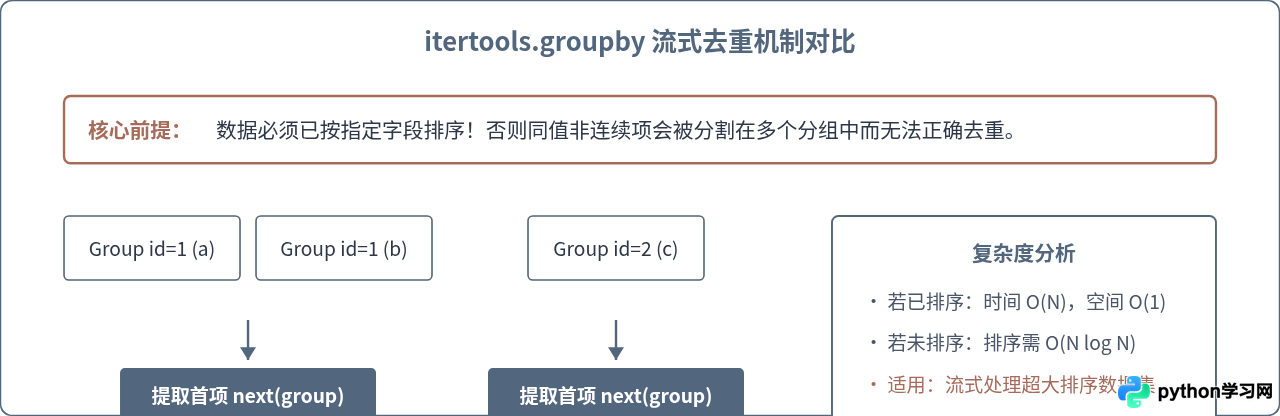
from itertools import groupby
from operator import itemgetter

sorted_data = [
    {"uid": 1, "region": "North"},
    {"uid": 1, "region": "North_Duplicate"},
    {"uid": 2, "region": "South"},
    {"uid": 3, "region": "East"}
]

# 每组只取第一个元素
deduped_iter = [next(group) for _, group in groupby(sorted_data, key=itemgetter("uid"))]

print("示例输出 (groupby):", deduped_iter)
# 示例输出 (groupby): [{'uid': 1, 'region': 'North'}, {'uid': 2, 'region': 'South'}, {'uid': 3, 'region': 'East'}]
五、综合对比与选型指南
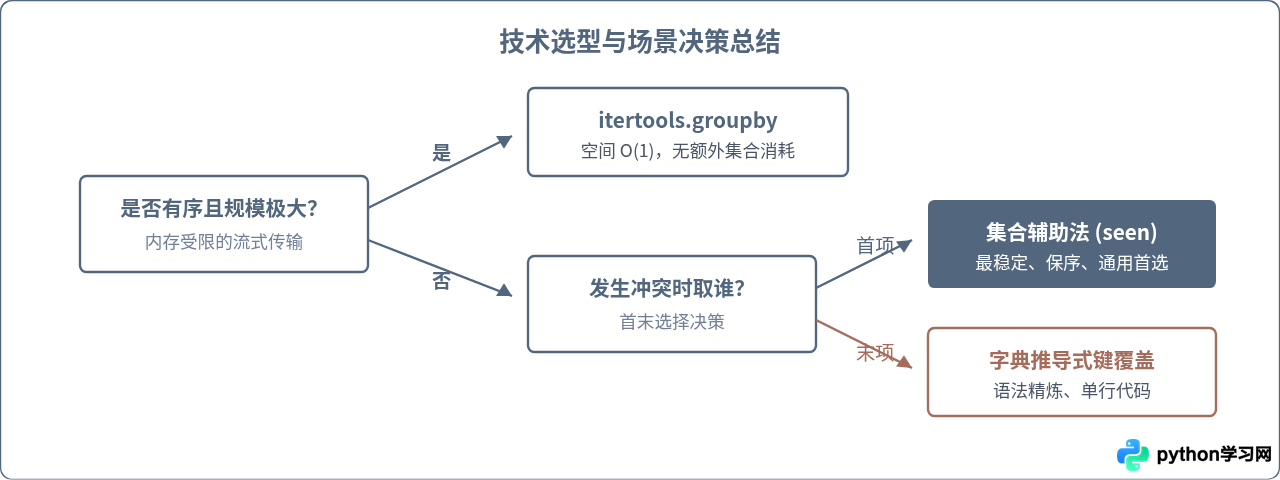
不同方法在时间复杂度、空间消耗、代码简洁性以及次序保留方面各有差异。下表汇总了三种主要实现的核心技术指标:
| 方案 | 时间复杂度 | 空间复杂度 | 保留冲突策略 | 典型适用场景 |
|---|---|---|---|---|
| 集合辅助法 (seen set) | O(N) | O(K) (唯一键数量) | 保留首次出现 (First Win) | 通用业务逻辑,需严格保序与高稳定性 |
| 字典推导式覆盖 | O(N) | O(K) | 保留末次出现 (Last Win) | 快速脚本,或业务逻辑规定以最新记录为准 |
| itertools.groupby | O(N) (若已排序) | O(1) | 分组首项 | 数据库已游标排序的流式或海量管道处理 |
六、容易忽略的边界陷阱
- 字段值不可哈希:去重依据的字段值本身必须是可哈希的(例如
int、str、tuple)。如果作为依据的字段本身又是嵌套列表或字典,直接放入seen会抛出TypeError: unhashable type: 'dict'。遇到此类情况,可以先将嵌套结构序列化(如转为json.dumps(val, sort_keys=True)或不可变元组)后再进行查重。 - 字段缺失与 None 值:当对象列表中部分元素缺少该字段时,
getattr(obj, key, None)或dict.get(key)会返回None。如果None被加入seen,所有缺失该字段的后续元素将被全部当作重复项过滤掉。如果业务要求缺失字段的对象各自独立存在,需对None单独编写穿透放行逻辑。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















