


scikit-learn1.6里__sklearn_tags__有什么实际用途?
深入解析 scikit-learn 1.6 引入的 __sklearn_tags__ 协议的核心定位与实际用途,涵盖强类型 Tags 架构、自定义估计器规范化、Pipeline 运行前拦截与第三方库生态兼容。
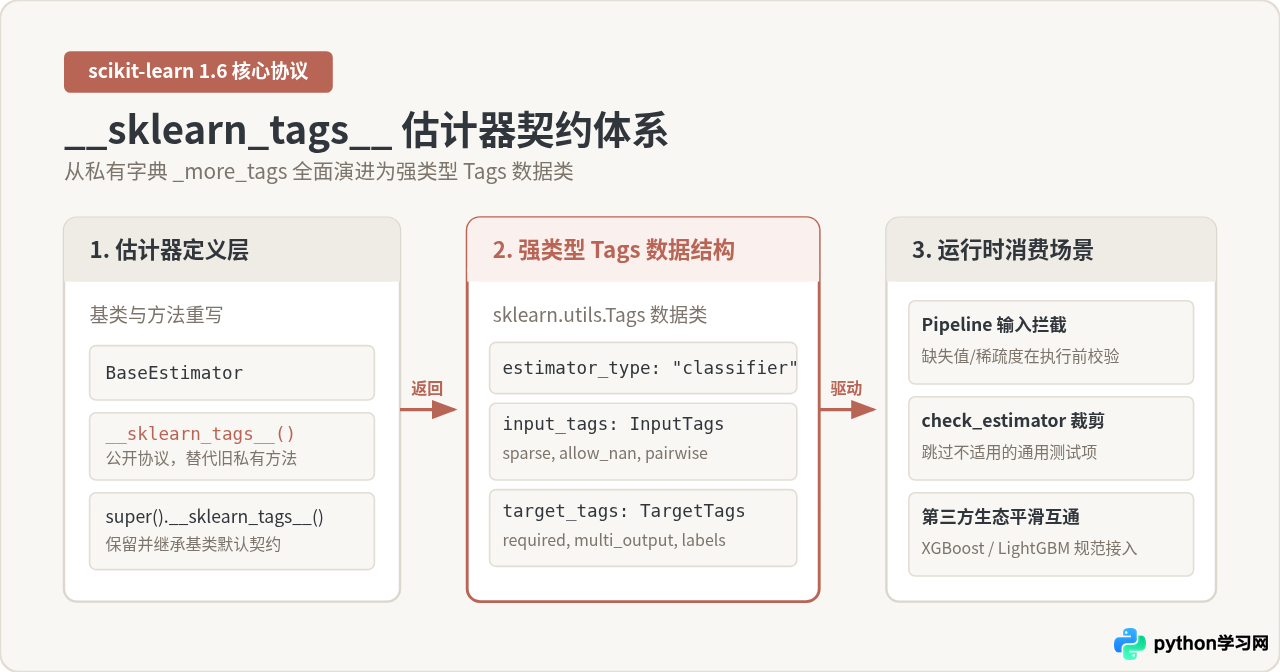
__sklearn_tags__ 是一套正式由私有走向公开的估计器契约方法,返回结构化的 sklearn.utils.Tags 数据类对象。它的核心实际用途是让估计器(Estimator)以强类型、可被 IDE 感知的方式向框架声明自身的数据输入约束、目标变量形态及运行时特性。通过它,Pipeline 可以在拟合前主动拦截非法数据,测试套件 check_estimator 能够精准裁剪不适用的边界用例,而第三方库(如 XGBoost、LightGBM 及自研模型)则获得了稳定、规范的生态互通接口。
从非结构化字典到强类型契约:为什么引入 __sklearn_tags__
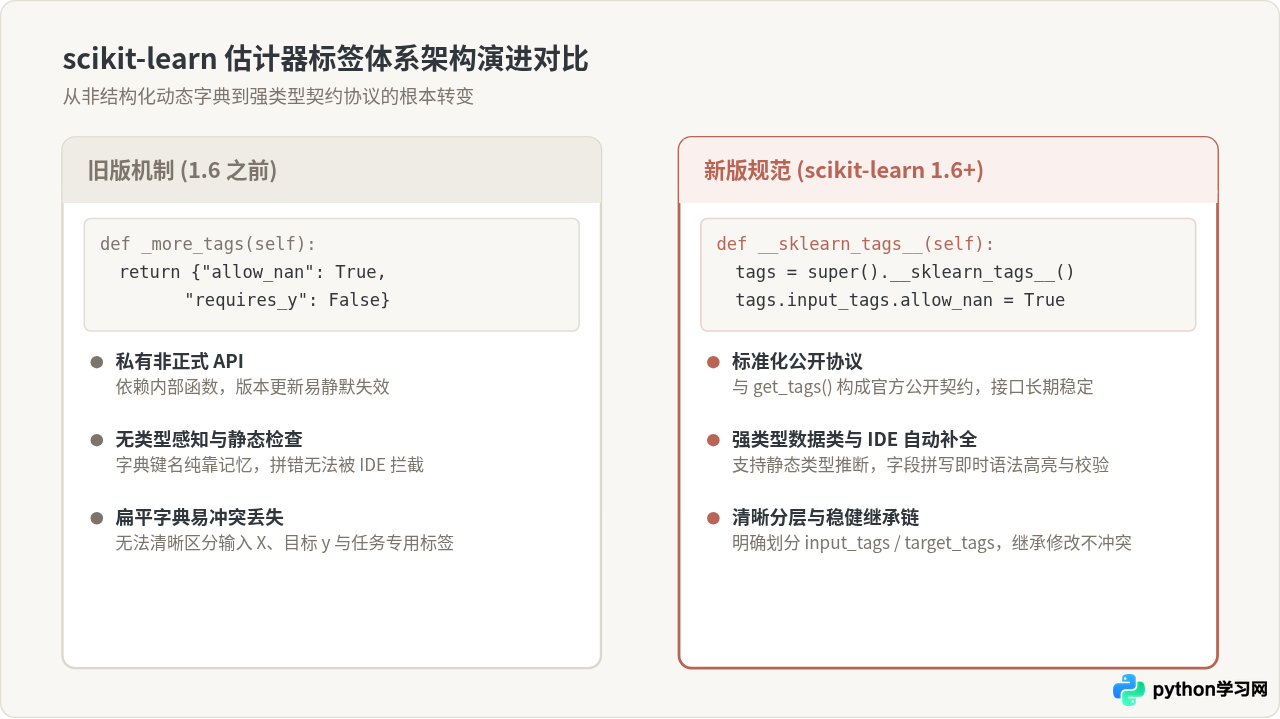
在 scikit-learn 1.6 发布前,估计器的特性管理长期依赖私有的 _more_tags() 或 _get_tags() 方法。当算法开发者需要声明“本模型支持缺失值 NaN”或“本模型不需要目标变量 y”时,必须在类中重载 _more_tags(),并返回一个扁平的 Python 字典,例如 {"allow_nan": True, "requires_y": False}。
这种字典机制在工程实践中暴露出三个明显短板:
- 无编译期检查与 IDE 自动补全:字典键名均为纯字符串,开发者容易出现微小的拼写错误(例如将
allow_nan误写为allow_NaN,或将requires_y误写为require_y)。由于 Python 字典对未知键不做校验,这些手误会被静默忽略,最终导致模型在特定测试或管线中产生难以排查的隐蔽异常。 - 继承覆盖逻辑脆弱:当子类在多重继承链中重写
_more_tags()时,必须手工进行字典的解构合并(dict(super()._more_tags(), ...))。深层嵌套的字典键非常容易被覆盖或产生合并冲突,破坏基类的默认保证。 - 私有接口的稳定性隐患:XGBoost、LightGBM 等第三方算法库为了适配 scikit-learn 生态,常常直接侵入式调用私有下划线方法
_get_tags()。一旦框架内部重构,第三方库便会发生AttributeError崩溃。
scikit-learn 1.6 正式通过 SLEP 022 规范,将这一底层机制重构为正式公开协议 __sklearn_tags__,并使用具有完整类型注解的 dataclass 替代原先松散的字典对象。
强类型 Tags 数据结构与层级架构
调用估计器的 __sklearn_tags__() 方法返回的是一个 sklearn.utils.Tags 实例。与原先所有键平铺在单个字典中不同,新架构按照机器学习任务的物理边界进行了严密的分层:
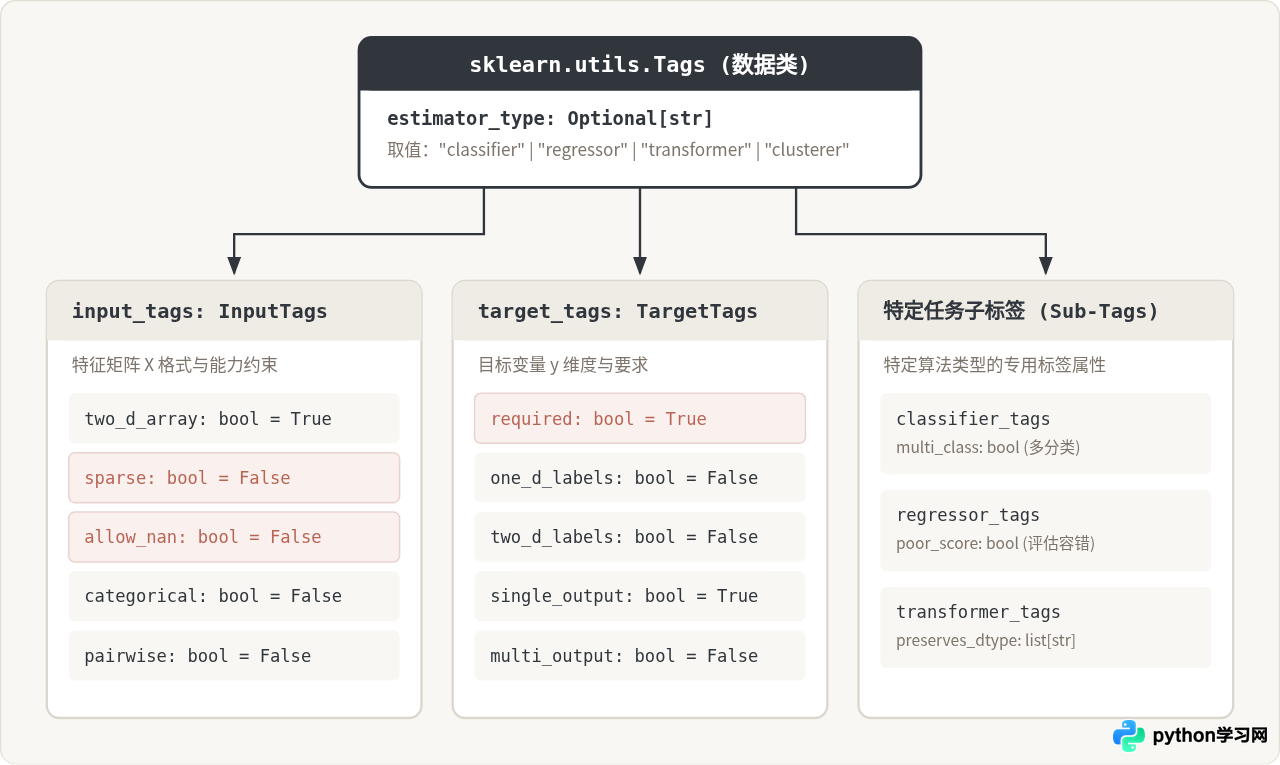
Tags 对象主要包含以下三个维度的强类型属性分支:
- estimator_type:字符串标量或 None,明确声明估计器的基础角色,如
"classifier"、"regressor"、"transformer"、"clusterer"等。 - input_tags (InputTags 数据类):专门描述特征矩阵
X的物理形态与容忍边界。例如sparse(是否支持稀疏矩阵,默认为 False)、allow_nan(是否允许输入包含缺失值 NaN,默认为 False)、two_d_array(是否只接收二维数组,默认为 True)、pairwise(是否属于核矩阵或距离矩阵)等。 - target_tags (TargetTags 数据类):专门定义对监督目标
y的要求。例如required(是否必须提供 y,分类与回归器默认为 True,无监督聚类器为 False)、one_d_labels(是否要求 1D 数组标签)、multi_output(是否支持多任务/多标签输出)等。
此外,对于特定算法类型,还提供了按需扩展的专用子标签(例如 classifier_tags.multi_class 声明多分类能力,transformer_tags.preserves_dtype 声明转换器对数据类型的保真特性)。这种层次化的设计消除了命名冲突,并且在现代 IDE 中可以享受立竿见影的自动提示。
实际用途一:规范化开发自定义估计器
在开发团队自研的算法模型或数据转换器时,通过实现 __sklearn_tags__,可以显式、安全地告知 scikit-learn 该算法的运行特性。
在 1.6 之前,我们需要定义 def _more_tags(self): return {"allow_nan": True};而在 1.6 及更高版本中,标准实现方式如下:
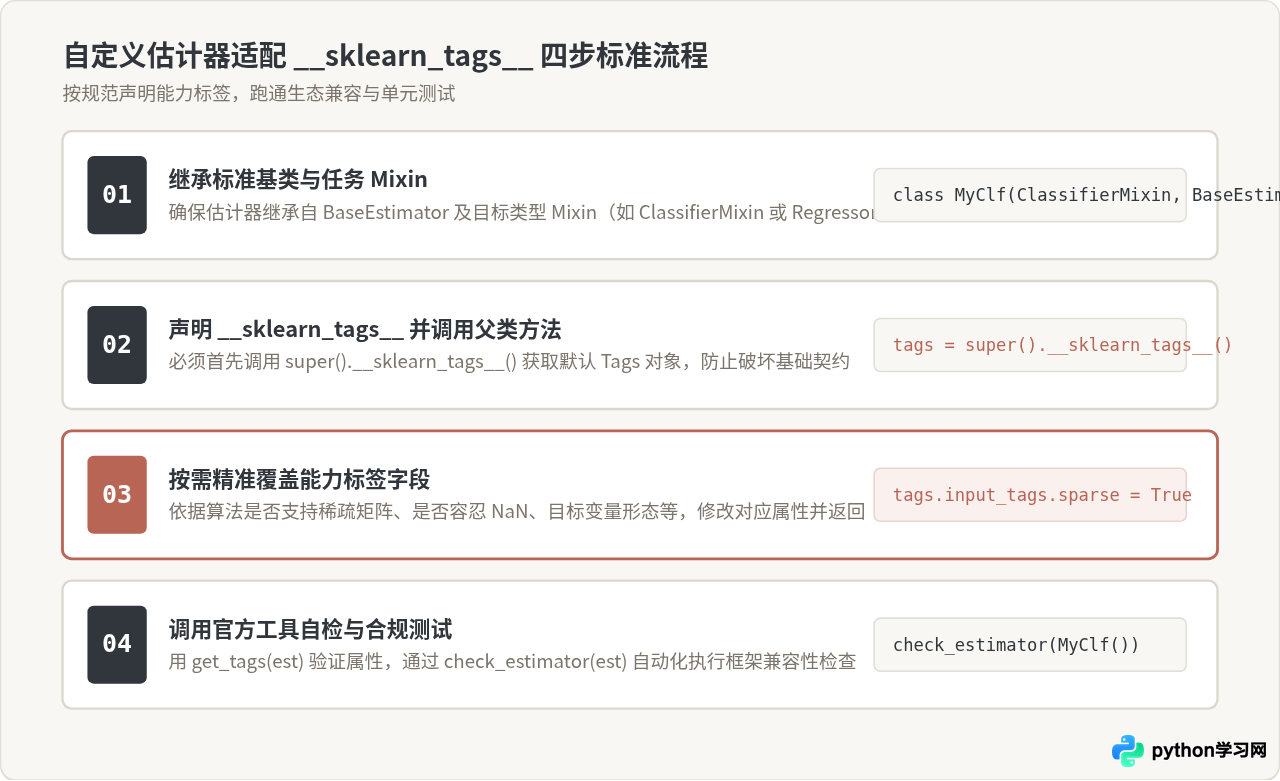
完整代码示例:支持缺失值与稀疏矩阵的自定义分类器
以下展示了一个能够原生容忍缺失值与 Scipy 稀疏矩阵的自定义分类器示例。代码通过 super().__sklearn_tags__() 获取基类预设的标签,随后直接对属性执行类型化修改:
import numpy as np
from sklearn.base import BaseEstimator, ClassifierMixin
from sklearn.utils import get_tags

class RobustCustomClassifier(ClassifierMixin, BaseEstimator):
    def __init__(self, threshold=0.5):
        self.threshold = threshold

    def __sklearn_tags__(self):
        # 1. 获取 BaseEstimator 和 ClassifierMixin 初始化的基础标签
        tags = super().__sklearn_tags__()

        # 2. 显式声明本算法对特殊输入数据的兼容能力
        tags.input_tags.allow_nan = True   # 允许特征矩阵 X 含有 np.nan
        tags.input_tags.sparse = True      # 支持 scipy.sparse 格式输入
        return tags

    def fit(self, X, y):
        # 校验目标变量及输入结构
        self.classes_ = np.unique(y)
        return self

    def predict(self, X):
        # 预测逻辑
        return np.zeros(X.shape[0], dtype=int)

# 实例化并查询标签验证
clf = RobustCustomClassifier()
tags = get_tags(clf)

print("估计器类别:", tags.estimator_type)          # 示例输出: 'classifier'
print("是否容忍 NaN:", tags.input_tags.allow_nan)    # 示例输出: True
print("是否支持稀疏矩阵:", tags.input_tags.sparse)    # 示例输出: True
print("是否要求目标变量:", tags.target_tags.required) # 示例输出: True
在外部查询任意估计器的标签时,应当统一调用官方工具函数 sklearn.utils.get_tags(estimator),而不要直接调用 estimator.__sklearn_tags__()。get_tags() 函数内部包含兼容性垫片逻辑,即使传入的是尚未完全改造的旧模型,它也能提供平滑降级处理。
实际用途二:让 check_estimator 智能裁剪合规测试
在 scikit-learn 生态中,评估一个自定义模型是否合格的最高标准是运行 sklearn.utils.estimator_checks.check_estimator。该函数会对传入的估计器执行上百项严苛的边界用例检测,包括数据重排不变性、类型强制转换、克隆有效性、奇异矩阵鲁棒性等。
然而,并非所有算法都具备完全相同的数据适应力:
- 例如,基于树模型的算法天然能够切分带有缺失值的数据,而基于欧氏距离的算法则不能。
- 某些非负矩阵分解(NMF)仅支持非负特征矩阵输入,一旦传入负数样本必然抛出异常。
- 文本处理相关的转换器只接受一维字符串数组,不接受标准的二维数值特征。
如果缺少标签体系,check_estimator 会将所有通用测试一视同仁地施加给模型,导致合规算法因为不具备“不属于自身职责范围的能力”而发生误判测试失败。
__sklearn_tags__ 在此处承担了测试裁剪开关的实际任务。当 check_estimator 执行测试前,它会先通过 get_tags(estimator) 读取模型声明:
- 如果
tags.input_tags.allow_nan为False,测试套件就会自动过滤掉“向模型注入 NaN 并检验容错”的测试用例,只有当该字段显式声明为True时,才会触发专门的缺失值验证; - 如果
tags.input_tags.positive_only为True,测试套件会自适应地将测试数据集限定在非负区间,避免因算法抛出合理的数值异常而导致 CI 构建失败。
实际用途三:驱动 Pipeline 运行前防御与第三方库互通
除了在开发测试期提供校验,__sklearn_tags__ 在运行期同样发挥着防御性架构的作用。
在构建复杂的机器学习工作流(如 Pipeline 或 ColumnTransformer)时,数据往往需要跨越多个预处理步骤才送入最终估计器。如果用户的数据集包含了稀疏矩阵(如文本 TF-IDF 输出),而管道末端的分类器不支持稀疏输入:
- 在旧机制中,数据会一路传递进底层 Cython 或 C 核心,最终爆出令人困惑的内存访问错误或低层维度不匹配异常;
- 在新机制中,Pipeline 可以在调用拟合逻辑前读取末端估计器的
tags.input_tags.sparse。一旦发现不匹配,即可在 Python 层面直接抛出清晰、友好的TypeError或ValueError,指出具体哪个步骤不支持当前数据格式。
生态第三方库的规范化互操作
scikit-learn 不仅是一个独立的包,更是整个 Python 机器学习事实上的接口标准。XGBoost、LightGBM、CatBoost、SciKeras 等知名框架均以 scikit-learn API 规范对外提供封装类。
引入 __sklearn_tags__ 为外部生态提供了第一方正式支持的协议通道。第三方工具在编写泛型模型适配器或自动化机器学习(AutoML)框架时,不再需要使用 hasattr(clf, "_more_tags") 这种不稳定的探测方式,而是直接依赖官方契约即可获知模型边界。
升级避坑:常见报错与第三方库版本适配
在将运行环境升级至 scikit-learn 1.6+ 时,开发者最常遇到的实际报错是:
AttributeError: 'super' object has no attribute '__sklearn_tags__'该报错的本质根因通常包括两类场景:
- 第三方库版本落后:旧版 XGBoost(例如 < 2.1.4)或旧版 SciKeras 的估计器在内部继承了
ClassifierMixin。在 scikit-learn 1.6 中,基类的方法查找链发生了变化,老版本第三方库的 mixin 调用了旧规范或未更新方法,导致属性缺失。解决办法:将 XGBoost 升级至>= 2.1.4或对应最新兼容版本。 - 自定义估计器缺少基类继承:部分开发者编写自定义类时未继承
BaseEstimator,却直接在方法中调用了super().__sklearn_tags__()。解决办法:确保自定义估计器的类声明中完整继承BaseEstimator。
总结与核心价值全景
__sklearn_tags__ 不是一个仅供框架内部使用的装饰性方法,而是 scikit-learn 迈向现代软件工程化与强类型契约的重要基石。
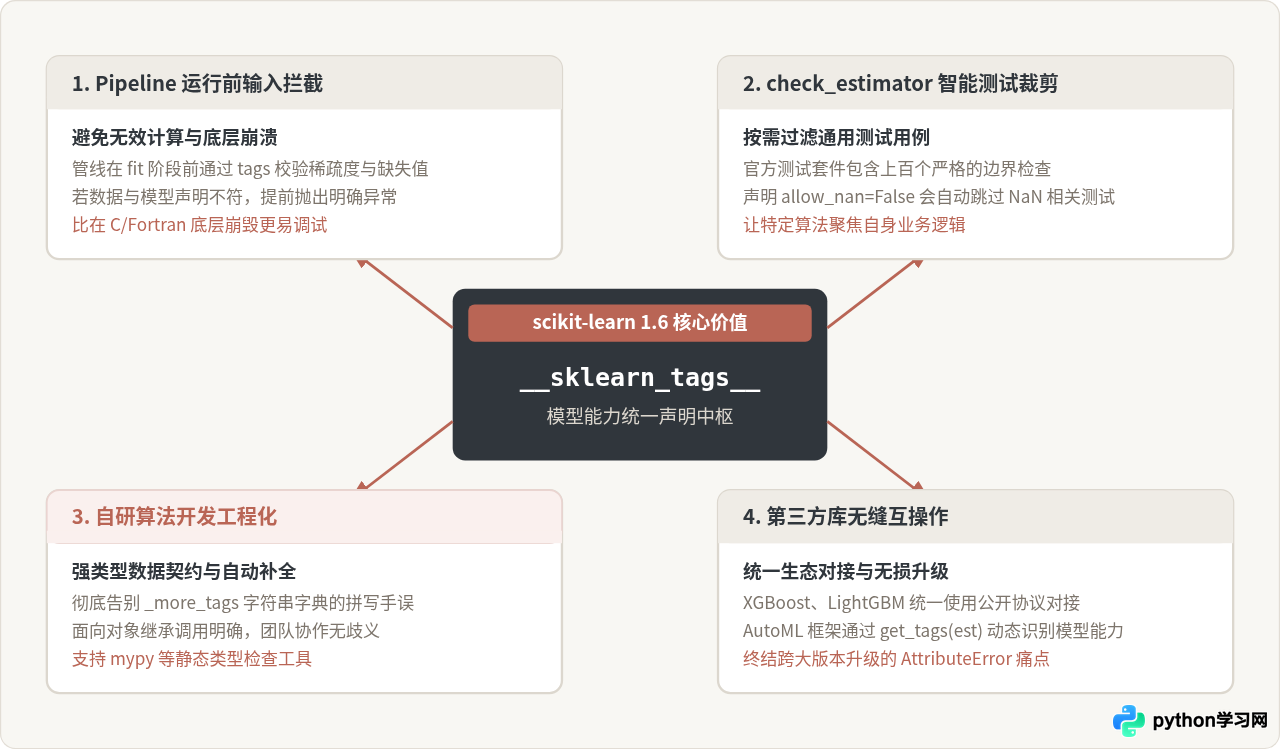
简而言之,当我们在 scikit-learn 1.6 及后续版本中构建、测试或升级模型时:
- 如果只是调用现有内置模型,
__sklearn_tags__在后台保障了 Pipeline 输入拦截的精准性与稳定性; - 如果是编写自研的扩展估计器,
__sklearn_tags__提供了类型安全、补全完备的声明入口,帮助我们跑通check_estimator合规校验; - 如果维护着机器学习公共库或算法插件,迁移至
__sklearn_tags__则是消除跨版本弃用警告、保障生态兼容的必由之路。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















