


Python中csv模块与pandas读取CSV的区别及选择建议
深入对比Python内置csv模块与第三方库pandas在读取CSV文件时的底层机制、内存占用、解析速度、类型推断与易用性差异,并提供清晰明确的场景选型建议与实战代码。
在Python开发与数据处理任务中,读取CSV格式数据是最高频的操作之一。核心答案非常明确:内置的 csv 模块是一个零外部依赖的流式迭代解析器,逐行读取字符串并保持极低且恒定的内存消耗,适合轻量脚本、单行数据清洗与受限环境;而第三方库 pandas 的 read_csv 是一个高性能表格计算引擎的入口,它基于底层C/PyArrow引擎一次性构建多维数据表(DataFrame),支持自动类型推断与向量化计算,但代价是较大的导入开销和通常数倍于文件体积的内存占用。本文将逐层剖析两者在底层机制、资源开销及操作模式上的差异,并给出清晰的选型决策依据。
一、底层运作机制与架构定位
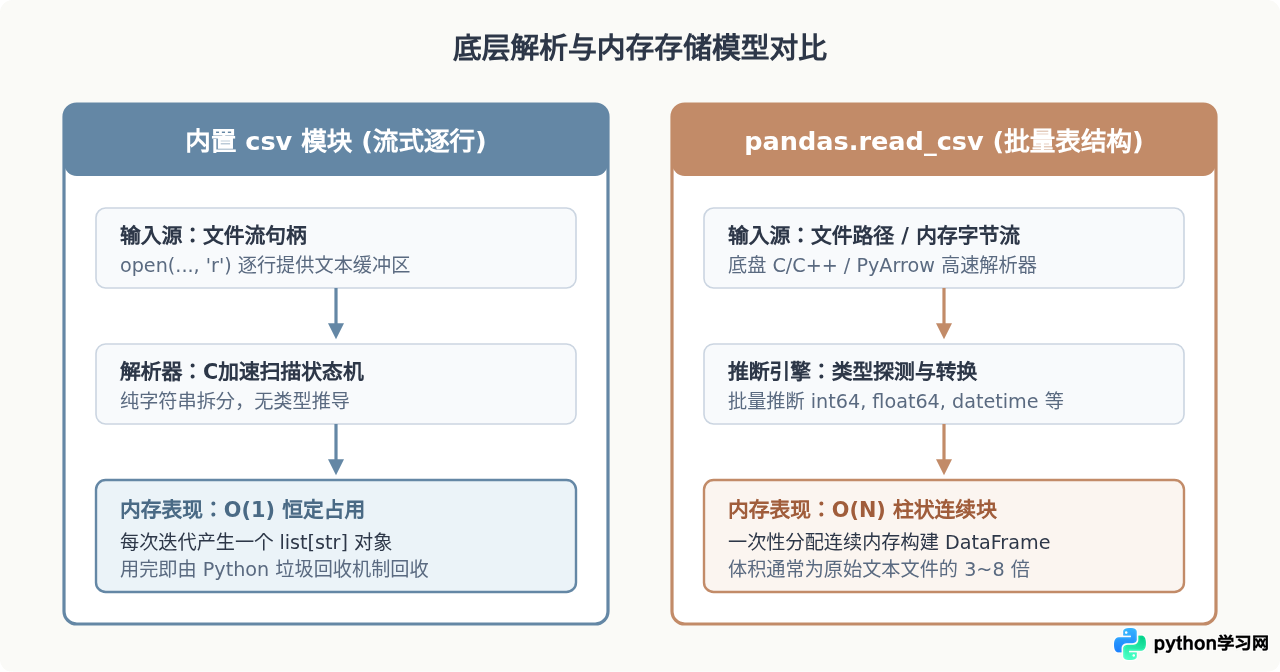
理解两者的区别,首先需要厘清它们在设计定位上的本质分歧。csv 模块是 Python 标准库(PEP 305)的一部分,其核心目标是提供一个符合 RFC 4180 标准的轻量级序列化与反序列化工具。它把 CSV 文件视作由换行符分隔的纯文本行序列,通过内部的有限状态机逐字符扫描分隔符与双引号边界。
相比之下,pandas.read_csv 绝不仅是一个单纯的读取器,而是将外部纯文本转换为内存多维数组的转换器。它调用 C 语言或 PyArrow 编写的解析核心,在快速扫描文本的同时探测数据类型(整型、浮点型、布尔型、时间戳),并将整列数据连续排列在内存块(BlockManager 或 Arrow ChunkedArray)中,为后续的快速列式矩阵运算服务。
二、核心特性与技术指标多维度对比
为了直观展现两者在工程实践中的权衡差异,以下从依赖度、启动速度、数据转换及错误容忍等核心指标进行综合对照:
| 评估维度 | 标准库 csv 模块 | 第三方 pandas 库 |
|---|---|---|
| 环境依赖 | 内置无依赖,开箱即用 | 需额外安装(包含 NumPy 及 C 扩展),体积极大 |
| 启动耗时 | 接近 0 毫秒(毫秒级瞬时冷启动) | 约 150~400 毫秒(取决于机器性能与依赖链加载) |
| 返回结构 | 迭代器产生原生 list[str] 或 dict[str, str] |
二维结构化数据表 pandas.DataFrame |
| 类型推断 | 无自动推断,所有单元格均输出为字符串 | 自动且精确推断整型、浮点型、布尔值及缺失值体系 |
| 内存控制 | 极低且平稳,不受总文件体积限制(恒定几兆) | 高,默认一次性全量加载至内存,大文件易触发 OOM |
| 缺失值处理 | 原样读出空字符串 "",需用户自定义逻辑 |
标准化为 NaN 或新型可空类型,提供完备填充与过滤 API |
| 分析计算 | 需编写原生循环或结合列表推导式、itertools | 高度优化的底层向量化运算、聚合、透视与多表连接 |
三、处理流水线与执行步骤差异
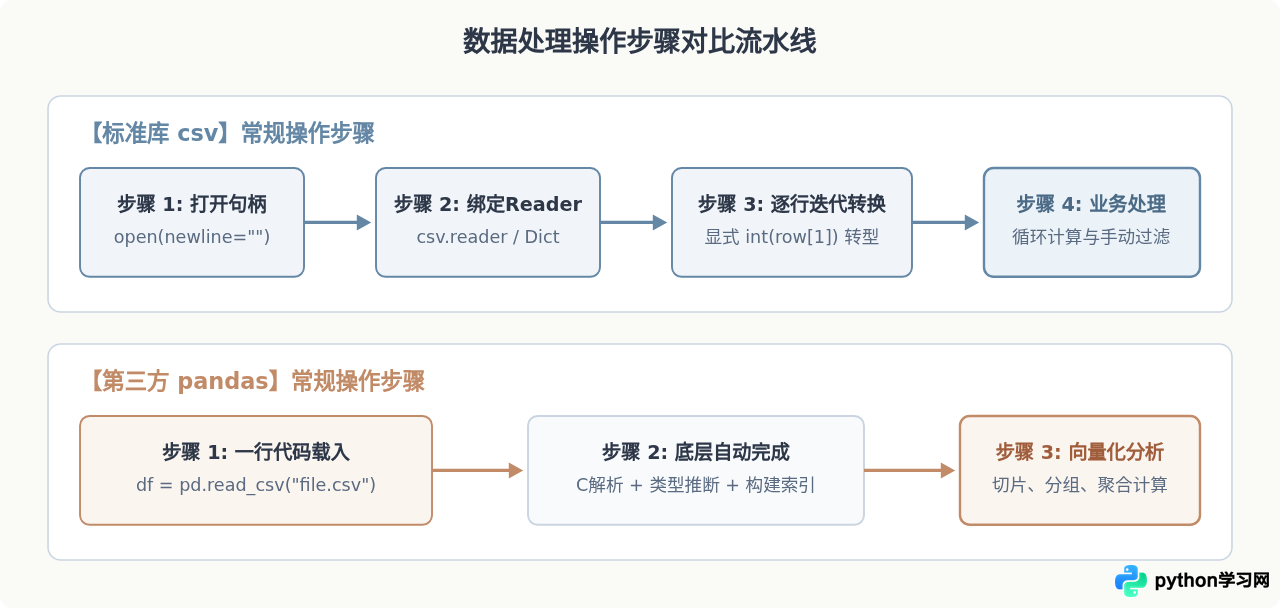
在实际编码阶段,两个工具的操作范式呈现出完全不同的设计哲学。csv 模块要求开发者负责从打开文件到逐行遍历、显式转换数据类型、手动累加过滤的完整流水线;而 pandas 则是通过高度封装的单行函数调用,将加载、推断与结构化操作收敛为一步完成。
四、数据规模对性能与资源开销的影响
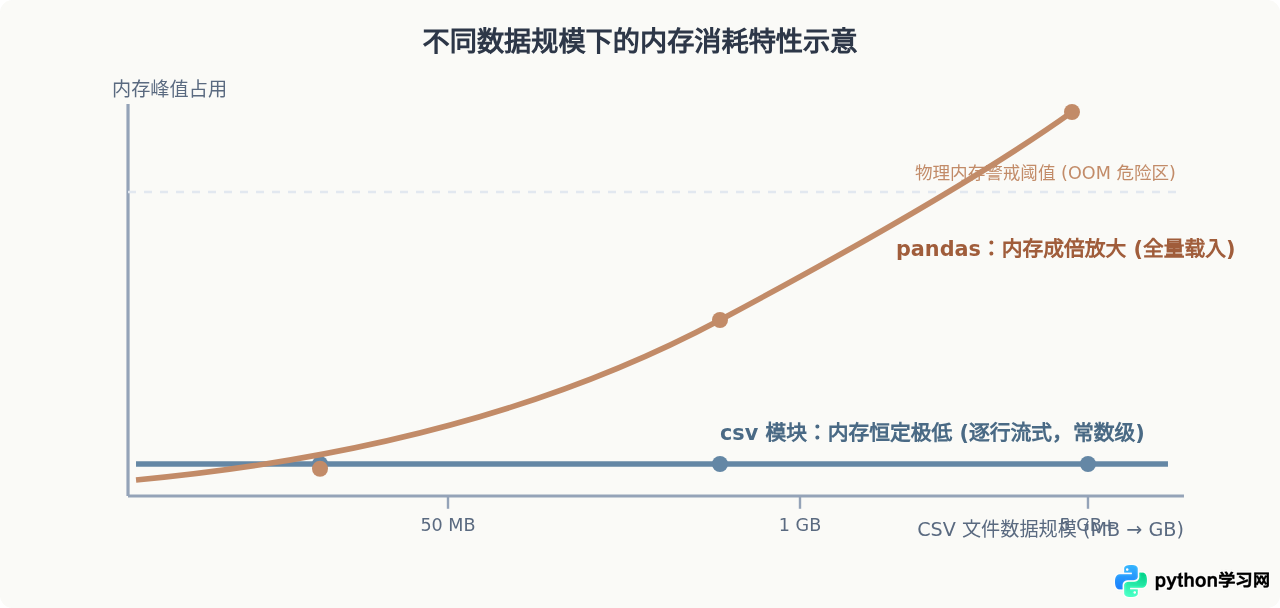
选择这两个工具的关键边界往往取决于数据体量以及宿主机硬件限制。许多开发者容易产生“使用 pandas 就必然比原生 Python 慢”或者“pandas 一定更快”的片面认知。真相取决于具体任务阶段:
- 小型文件(小于 10MB):如果仅需要提取几列数据或写入日志,
csv模块的总体体验更优。因为此时import pandas自身引入的启动耗时(数百毫秒)可能远远超过解析十几兆文本本身的耗时。 - 中大型文件(10MB ~ 1GB):如果在内存容量充足(通常需要预留文件体积 3~5 倍的可用内存)且需要执行均值计算、列间运算或按字段聚合,
pandas依托 C 级别的快速批量解析和向量化列计算,执行速度往往比纯 Python 写的for循环高出数倍甚至数十倍。 - 超大型文件(超过数 GB 或大于可用内存):如果不加参数直接执行
pd.read_csv(),程序会尝试一次性申请超大连续内存,极易导致MemoryError甚至造成操作系统严重卡顿。而csv模块凭借严格的逐行流式读取,即使处理 50GB 的海量日志,内存消耗也始终稳定在数兆字节(O(1) 复杂度)。
五、具体代码实现与实践范式
为了明确展示具体写法的差异,以下针对同一份典型的销售数据 sales_data.csv,分别展示两个工具的读取、筛选与统计实现。
假设示例数据结构:包含四列 order_id,category,amount,date,其中 amount 为浮点数字符串。
1. 使用标准库 csv 模块实现轻量统计
在使用 csv 模块时,最标准且安全的做法是配合 with open() 语句,并务必指定 newline=""(避免在 Windows 等跨平台场景下由于换行符转换导致空行解析错误)。针对有表头的表格,推荐使用 csv.DictReader 以提升代码可读性:
import csv

total_electronics = 0.0
count = 0

# 必须指定 newline="",并显式指定 utf-8 编码
with open("sales_data.csv", mode="r", encoding="utf-8", newline="") as file:
    reader = csv.DictReader(file)
    for row in reader:
        # 必须显式判断空值并手动做类型转换
        if row["category"] == "Electronics" and row["amount"].strip():
            try:
                amount_val = float(row["amount"])
                total_electronics += amount_val
                count += 1
            except ValueError:
                # 针对非标准浮点数的跳过或日志记录
                continue

avg_amount = total_electronics / count if count > 0 else 0.0
print(f"Electronics 订单均额: {avg_amount:.2f}")
Electronics 订单均额: 1428.50
2. 使用 pandas 模块实现向量化分析
使用 pandas 时,代码大幅简化,解析、类型转换、条件切片与聚合均可在两三行内以向量化语法优雅完成:
import pandas as pd

# 读取 CSV,底层自动完成类型探测与 NaN 识别
df = pd.read_csv("sales_data.csv", encoding="utf-8")

# 向量化布尔索引筛选,并计算均值
avg_amount = df.loc[df["category"] == "Electronics", "amount"].mean()

print(f"Electronics 订单均额: {avg_amount:.2f}")
Electronics 订单均额: 1428.50
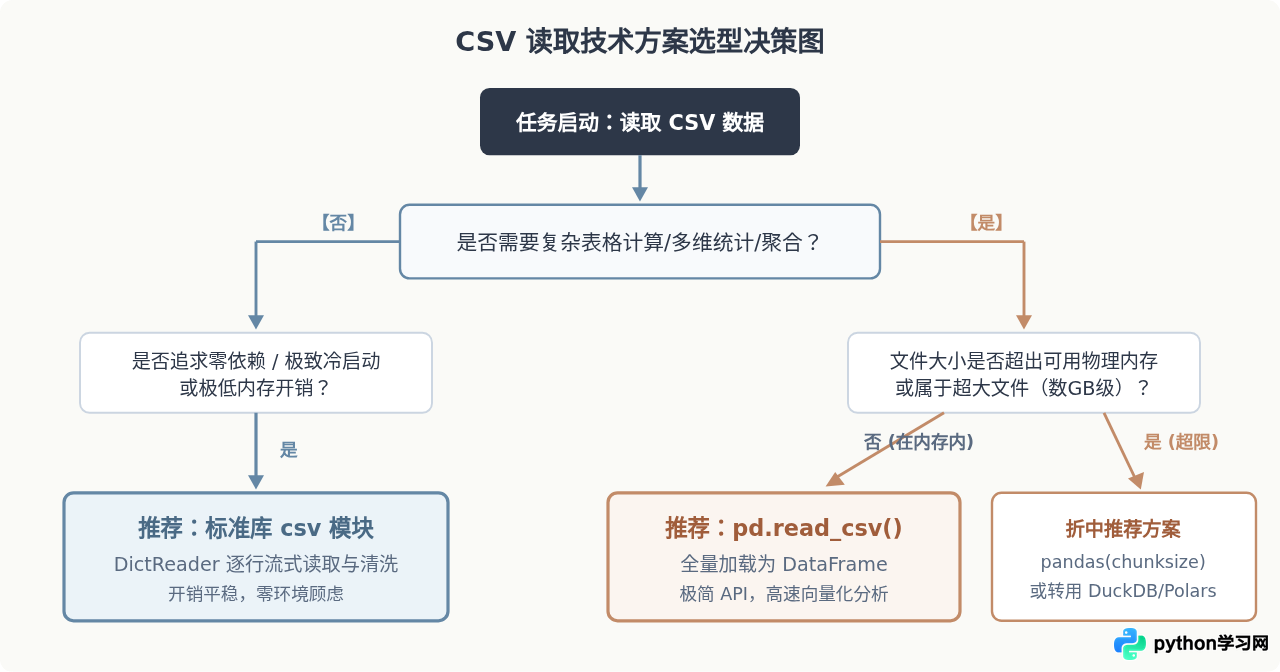
六、明确的选择建议与决策路径
根据团队的技术栈、部署目标以及数据特征,可以遵循以下原则进行清晰决策:
坚决选择 csv 模块的场景
- 轻量级脚本或自动化运维运维工具:脚本需要在最小化环境(如 Alpine Linux 容器、无外网权限的基础服务器)中运行,无法也不允许安装数百兆的编译依赖。
- 无服务器计算(Serverless / AWS Lambda):启动时间(Cold Start)至关重要,
import pandas自身耗时过长,且部署包体积受到严格限制。 - 简单的逐行提取与流式清洗:任务仅是将超大日志文件逐行解包、过滤若干关键字并实时发送至网络队列或数据库,无需保留上下文数据结构。
- 零依赖分发需求:编写独立的 Python CLI 工具供第三方无门槛直接执行。
坚决选择 pandas 的场景
- 探索性数据分析(EDA)与数据清洗:需要快速识别异常值、查看数据分布、处理多样化的缺失值与时间序列重采样。
- 复杂的统计建模与机器学习前置步骤:需要进行多表 Join/Merge、透视表(Pivot Table)、矩阵运算或输入至 Scikit-Learn、PyTorch 等模型。
- 中等规模文件的批处理:可用内存远超数据文件大小(至少有 4 倍以上冗余),追求极高的开发效率与整列批量运算性能。
总结
Python 标准库的 csv 模块和第三方库 pandas 并不构成简单的替代关系,而是针对不同工程侧重点的两种解法。当你需要编写健壮、可移植、低驻留内存的系统脚本或流式数据中转管道时,使用 csv 模块是性价比最高且没有维护包袱的方案;而当你处于数据科学探索、商业报表计算或需要充分利用现代多核 CPU 的连续内存运算优势时,pandas.read_csv 则是带来最高开发与运行效率的不二之选。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















