


Python列表sort按指定值排序:key参数与lambda用法
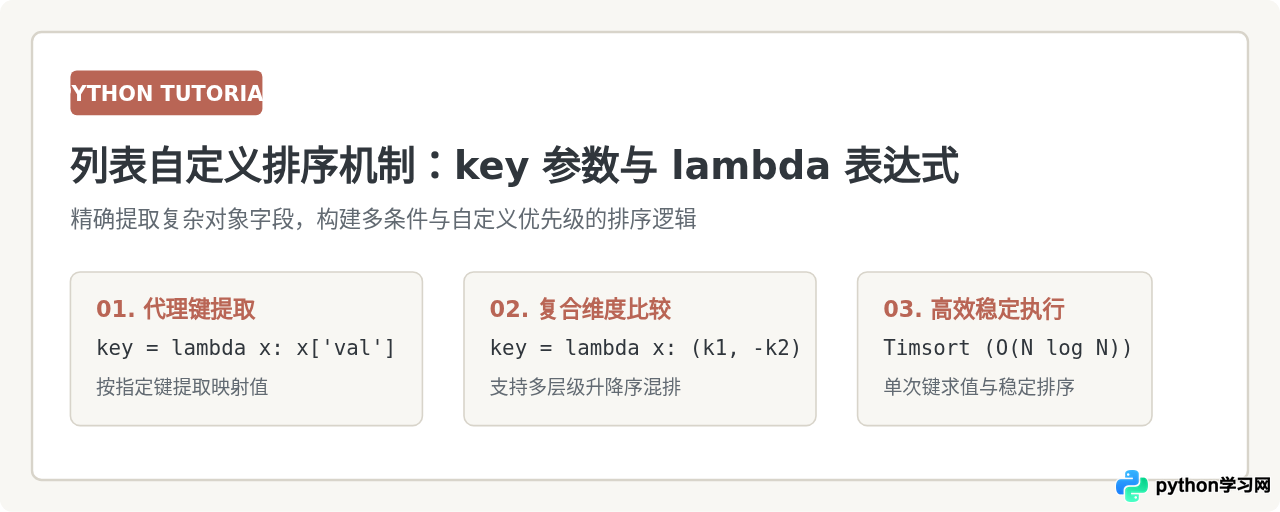
深入解析Python列表sort方法中key参数与lambda表达式的工作原理与实用技巧,涵盖字段提取、多条件升降序、特定值置顶及性能优化方案。
在 Python 编程中,对包含复合数据结构(如字典、元组或自定义对象)的列表进行排序时,默认的自然大小比对往往无法满足需求。解决这一问题的标准路径是使用 list.sort() 方法的 key 参数,并结合 lambda 匿名函数提取目标字段作为比对依据。本文将直接拆解 key 参数的单次计算机制,详解 lambda 的语法规范,并针对单一字段、多级升降序组合以及特定元素置顶等核心场景给出完整可执行的代码与设计方案。
一、key 参数的运作机制:单次计算与代理键比较
在 Python 中,list.sort() 是一个就地(In-Place)修改列表元素顺序的方法。默认情况下,Python 会依次调用列表元素自身的比较操作符(如 <)完成排序。但当列表元素是字典、自定义类实例,或需要按照计算值排序时,原生比较操作会直接抛出类型错误(例如字典之间不支持大小比较)或得出非预期结果。
key 参数接收一个仅接受单参数的函数。Python 在执行排序算法前,会严格遍历列表一次,为每一个元素调用该函数,并将其返回值存储为临时“代理键”(Proxy Key)。后续的整个比对与重排过程完全基于这些代理键进行,排序完成后再还原为原始元素。这种模式在算法层面被称为施瓦茨变换(Schwartzian Transform)。
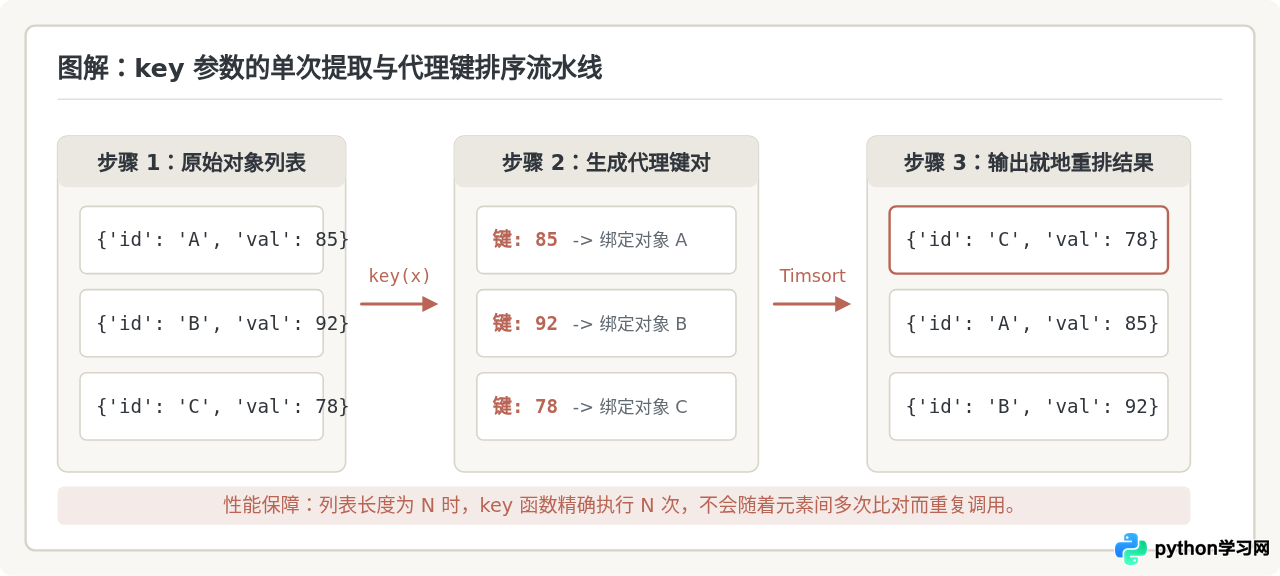
了解这一机制至关重要:在常规的快速排序或归并排序中,两次元素比较就需要求值一次。而 Python 的 key 参数设计确保了对于包含 N 个元素的列表,无论排序过程中元素交换比对了多少次,key 函数仅被调用恰好 N 次。这保证了即使在 key 函数中执行相对耗时的属性提取或格式转换,整体时间复杂度依然稳定在 O(N log N)。
二、lambda 表达式语法与单字段指定值排序
lambda 是 Python 用于定义轻量级匿名函数的关键字。其语法结构非常紧凑:
lambda 参数: 返回表达式在排序场景中,传入 list.sort(key=...) 的 lambda 表达式通常接收当前迭代到的单个元素,并在冒号后返回需要参与排序的具体值。
1. 字典列表:按指定键的值排序
假设我们有一组员工信息列表,需要按照员工的年龄升序排序:
# 待排序的员工数据
employees = [
    {"name": "赵云", "age": 28, "department": "研发部"},
    {"name": "关羽", "age": 35, "department": "市场部"},
    {"name": "张飞", "age": 24, "department": "运维部"}
]

# 按 'age' 键对应的值升序排序
employees.sort(key=lambda item: item["age"])

# 验证排序结果
for emp in employees:
    print(emp)

# 示例输出:
# {'name': '张飞', 'age': 24, 'department': '运维部'}
# {'name': '赵云', 'age': 28, 'department': '研发部'}
# {'name': '关羽', 'age': 35, 'department': '市场部'}
如果需要降序排列,只需配合 reverse=True 参数即可:
employees.sort(key=lambda item: item["age"], reverse=True)2. 元组与嵌套列表:按指定索引排序
当列表元素为元组时,通过下标即可指定排序列。例如针对 (商品编号, 单价, 销量) 的结构按销量(索引 2)排序:
products = [
    ("P101", 199.0, 450),
    ("P102", 49.9, 1200),
    ("P103", 89.0, 800)
]

# 按销量降序排序
products.sort(key=lambda p: p[2], reverse=True)

# 示例输出:
# [('P102', 49.9, 1200), ('P103', 89.0, 800), ('P101', 199.0, 450)]
三、多条件组合排序:元组机制与方向混排
在实际业务中,单字段排序往往不够用。例如在成绩排名中,当总分相同时,需要按数学单科成绩继续比对;或者要求“部门按字母升序,薪资按数值降序”。
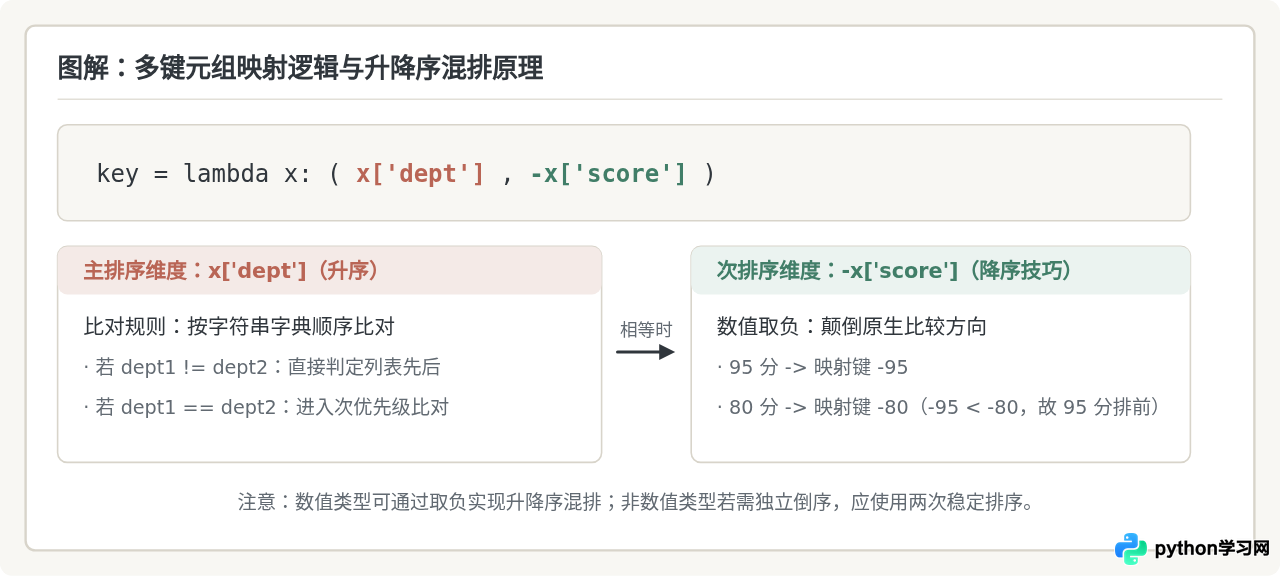
Python 原生支持元组的比对规则:比较两个元组 (a1, b1) 和 (a2, b2) 时,先比对首个元素 a1 与 a2。若不相等则直接得出大小结果;若相等,则向后比对第二个元素 b1 与 b2。利用这一规则,我们只需让 lambda 返回一个元组,即可实现多级优先级排序。
升降序混排代码实战:数值取负法
students = [
    {"name": "小明", "class": "A", "score": 88},
    {"name": "小红", "class": "B", "score": 95},
    {"name": "小李", "class": "A", "score": 95},
    {"name": "小王", "class": "B", "score": 88}
]

# 要求:班级升序;若班级相同,按成绩降序
students.sort(key=lambda s: (s["class"], -s["score"]))

for stu in students:
    print(stu)

# 示例输出:
# {'name': '小李', 'class': 'A', 'score': 95}
# {'name': '小明', 'class': 'A', 'score': 88}
# {'name': '小红', 'class': 'B', 'score': 95}
# {'name': '小王', 'class': 'B', 'score': 88}在上面的代码中,s["class"] 作为元组第一项正常升序。而对于第二项 s["score"],由于加上了负号 -,原本较大的数值(如 95)变为 -95,在升序比对中比 -88 更小,从而自然排在前面,巧妙实现了单字段降序的效果。
四、按特定值优先排序:布尔映射与权重大法
在开发管理系统、列表过滤与展示时,常有一个特殊需求:将某些特定标志的值固定排在最前面(例如“置顶帖子”、“急诊挂号”、“当前登录用户自身”),而其余元素依然按照常规的数值或时间排序。
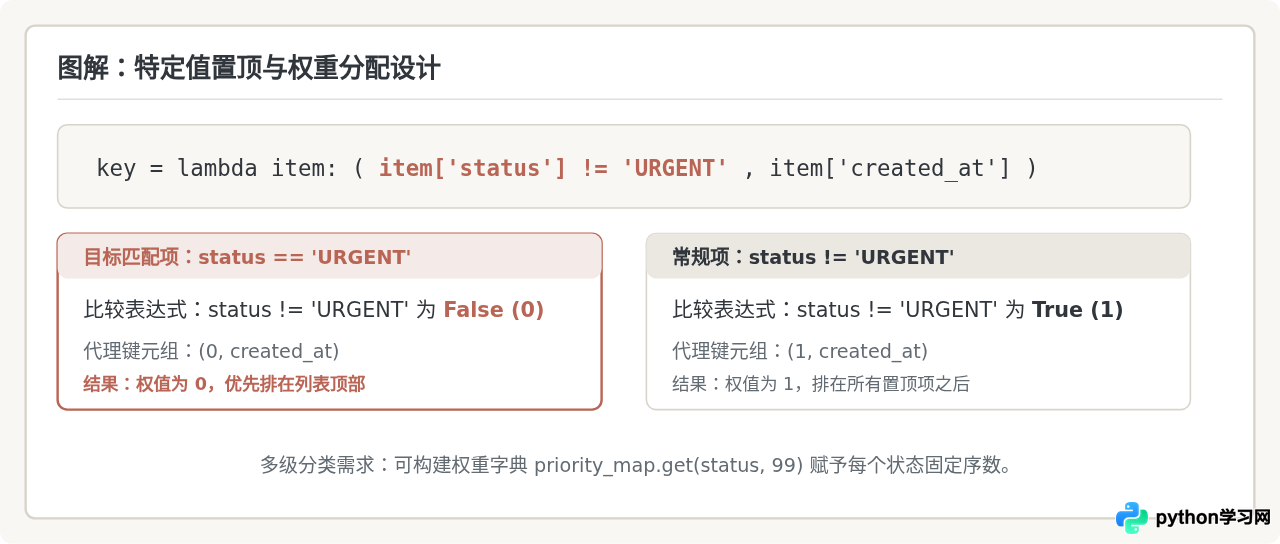
在 Python 中,布尔类型 bool 是整数 int 的子类,具有严格的数值等价关系:False == 0 且 True == 1。利用这一特性,我们可以把需要置顶的目标设计为返回布尔值或整数权重。
实战:工单列表紧急状态置顶
tasks = [
    {"task_id": 101, "status": "NORMAL", "timestamp": 169001},
    {"task_id": 102, "status": "URGENT", "timestamp": 169005},
    {"task_id": 103, "status": "NORMAL", "timestamp": 169002},
    {"task_id": 104, "status": "URGENT", "timestamp": 169000}
]

# 排序规则:
# 1. 紧急工单(URGENT)最前;
# 2. 同状态下按 timestamp 升序排列。
tasks.sort(key=lambda t: (t["status"] != "URGENT", t["timestamp"]))

for t in tasks:
    print(t)

# 示例输出:
# {'task_id': 104, 'status': 'URGENT', 'timestamp': 169000}
# {'task_id': 102, 'status': 'URGENT', 'timestamp': 169005}
# {'task_id': 101, 'status': 'NORMAL', 'timestamp': 169001}
# {'task_id': 103, 'status': 'NORMAL', 'timestamp': 169002}
在上面的代码中,当 status == "URGENT" 时,条件 t["status"] != "URGENT" 为 False(即数值 0);对于其他工单,该条件为 True(即数值 1)。因此,在升序比对中,所有紧急工单的第一项均为 0,排在前面;在第二项中再比对时间戳,保证了逻辑的严密与高效。
五、list.sort() 与内置函数 sorted() 的对比
在实际编码中,除了列表自带的 list.sort(),Python 还提供了全局内置函数 sorted()。二者均支持 key 和 reverse 参数,但在内存与返回值机制上存在明确差异:
| 特性维度 | list.sort() | sorted() |
|---|---|---|
| 操作对象 | 仅限 Python list 类型 |
任意可迭代对象(list, tuple, dict, set, 生成器等) |
| 修改方式 | 原地就地修改(In-Place),改变原列表内部顺序 | 不改变原数据,构造并返回一个全新的排序列对象 |
| 返回值 | 严格返回 None |
返回新的 list 实例 |
| 内存开销 | 极低(无需开辟新列表空间) | 需要额外申请容纳 N 个元素的内存列表空间 |
| 常见误区 | 误写 res = lst.sort() 导致变量 res 为 None |
对超大列表使用时忽略了额外的内存分配 |
六、性能优化与生产环境避坑指南
虽然 key=lambda ... 语法简单直观,但在处理十万级甚至百万级数据或高频调用接口时,以下工程细节直接决定程序的稳定性与执行效率:
1. 简单字段提取:优先使用 operator 模块
对于仅提取已有字典键或对象属性的场景,Python 标准库 operator 模块提供了由 C 语言实现的函数:itemgetter 和 attrgetter。它们省去了 Python 虚拟机解释执行 lambda 字节码的开销,通常可带来 20%~40% 的速度提升。
from operator import itemgetter, attrgetter

data = [{"id": i, "val": -i} for i in range(100000)]

# 方式一:lambda 表达式(通用但有轻微函数调用开销)
data.sort(key=lambda x: x["val"])

# 方式二:operator.itemgetter(底层 C 实现,性能更优)
data.sort(key=itemgetter("val"))
2. None 值的比对异常处理
在 Python 3 中,不同类型之间(如 None 与 int)不支持大小比对。如果排序字段可能存在 None 或缺失键,直接运行会抛出 TypeError: '<' not supported between instances of 'NoneType' and 'int'。稳妥的做法是将其转换为元组,显式赋予 None 最大或最小权值:
records = [{"val": 10}, {"val": None}, {"val": 5}]

# 将 None 值视作最大,放置在列表末尾
records.sort(key=lambda x: (x["val"] is None, x["val"]))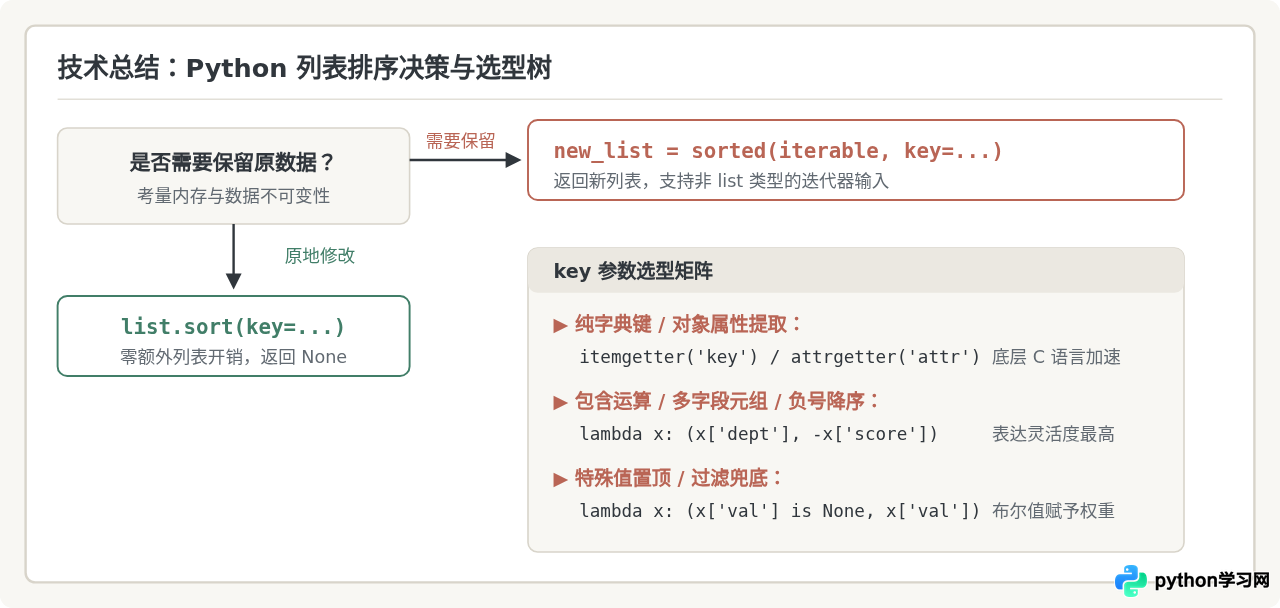
总结:list.sort() 的强大之处在于将“如何排序”(高效稳定的 Timsort 算法)与“按什么排序”(通过 key 指定的投影映射)完全解耦。掌握 lambda 返回单值、多键元组以及布尔权重的技巧,不仅能从容应对复杂业务场景中的多维度排序,更能写出高效、简洁且符合 Python 规范的代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















