



连续登录天数看起来像一道普通聚合题,但只要数据里出现断连、同天多次登录、跨月日期,甚至时区转换,这个问题就很容易算错。更稳妥的办法,是先用窗口函数把“连续的日期”识别成同一组,再统计每组长度;本文按这个思路拆开说明,并补上跨库写法和几个最常见的坑。
为什么用 ROW_NUMBER() 加日期相减就能识别连续段
核心思路是:对同一用户的登录日期按时间升序排列后,连续日期的“日期序数 - 行号”会保持不变,这个固定差值就可以当作连续段的分组标识。
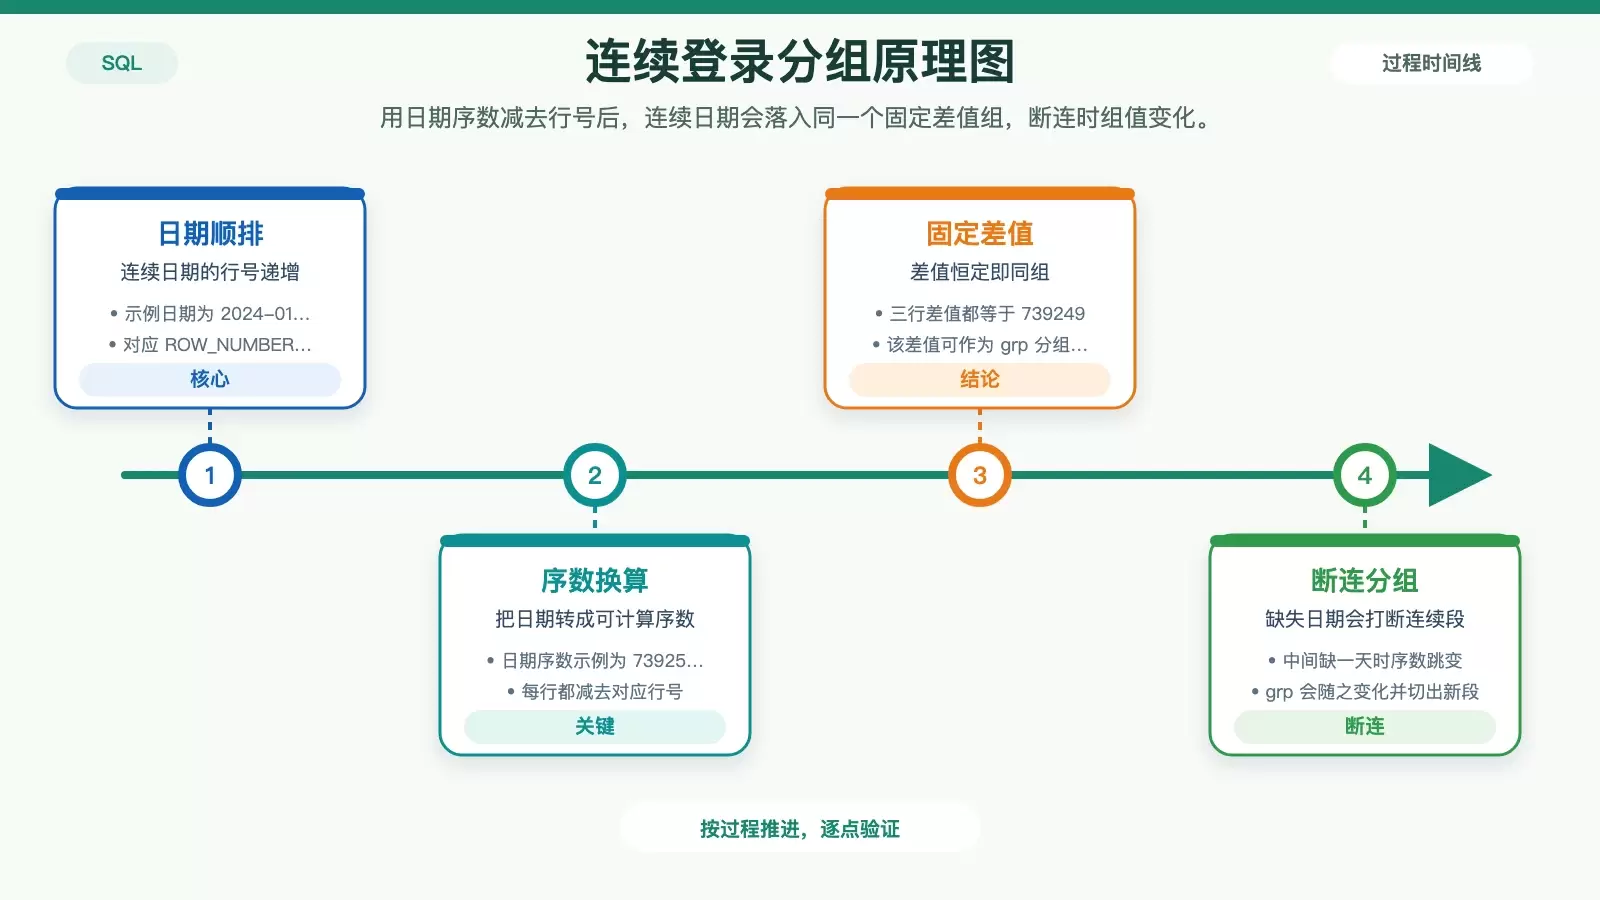
比如某用户在 2024-01-01、2024-01-02、2024-01-03 登录,ROW_NUMBER() 会得到 1/2/3;如果把日期转成序数,像 TO_DAYS(date) 那样处理,则可能得到 739250/739251/739252,三者分别减去行号后的结果都等于 739249。一旦中间断一天,这个差值就会变化,连续组也就被自然切开了。
这套方法成立的前提
- 必须先按
user_id分组,再按login_date升序排序,否则ROW_NUMBER()的结果没有业务意义。 - 日期必须先转换成可比较的“日序数”,不能直接把不同数据库的日期类型写法混用。
- 如果同一用户同一天有多条登录记录,先去重,否则连续天数会被放大。
不同数据库的日期序数写法
- MySQL:
TO_DAYS(login_date) - PostgreSQL:
login_date::date - '1970-01-01'::date - SQLite:
julianday(login_date)
这部分不要直接照搬 MySQL 写法到其他数据库,否则 SQL 语义可能一致,结果却不一致。
同一天多次登录要先去重
如果原始日志表记录的是每次登录行为,而不是“每日是否登录”,那统计连续天数前必须先按用户和日期去重。常见做法包括:
- PostgreSQL:
DISTINCT ON (user_id, login_date) - 通用思路:
GROUP BY user_id, login_date
LAG() 能不能用:可以,但更适合判断是否断连
LAG(login_date, 1) OVER (PARTITION BY user_id ORDER BY login_date) 可以拿到前一次登录日期,再和当前日期比较,判断两次登录是否相隔 1 天。这种写法适合检查“今天是否接上昨天”,但不适合直接算出最长连续登录天数。
LAG() 的几个限制
- 它只能比较相邻两行,无法直接产出“最长连续多少天”,要继续配合递归或自连接才能完成量化。
- 跨月场景如
2024-01-31 → 2024-02-01,用DATE_ADD(lag_date, INTERVAL 1 DAY)比lag_date + 1更安全。 - 如果中间某天缺失、后面又恢复登录,
LAG()不会自动帮你分段,还需要额外处理首行的lag_date IS NULL。
所以,LAG() 更像是“断连检测工具”,而不是完整的“连续段统计方案”。
怎么查每个用户的最长连续登录天数
要得到每个用户的最长连续登录天数,通用做法是两步:
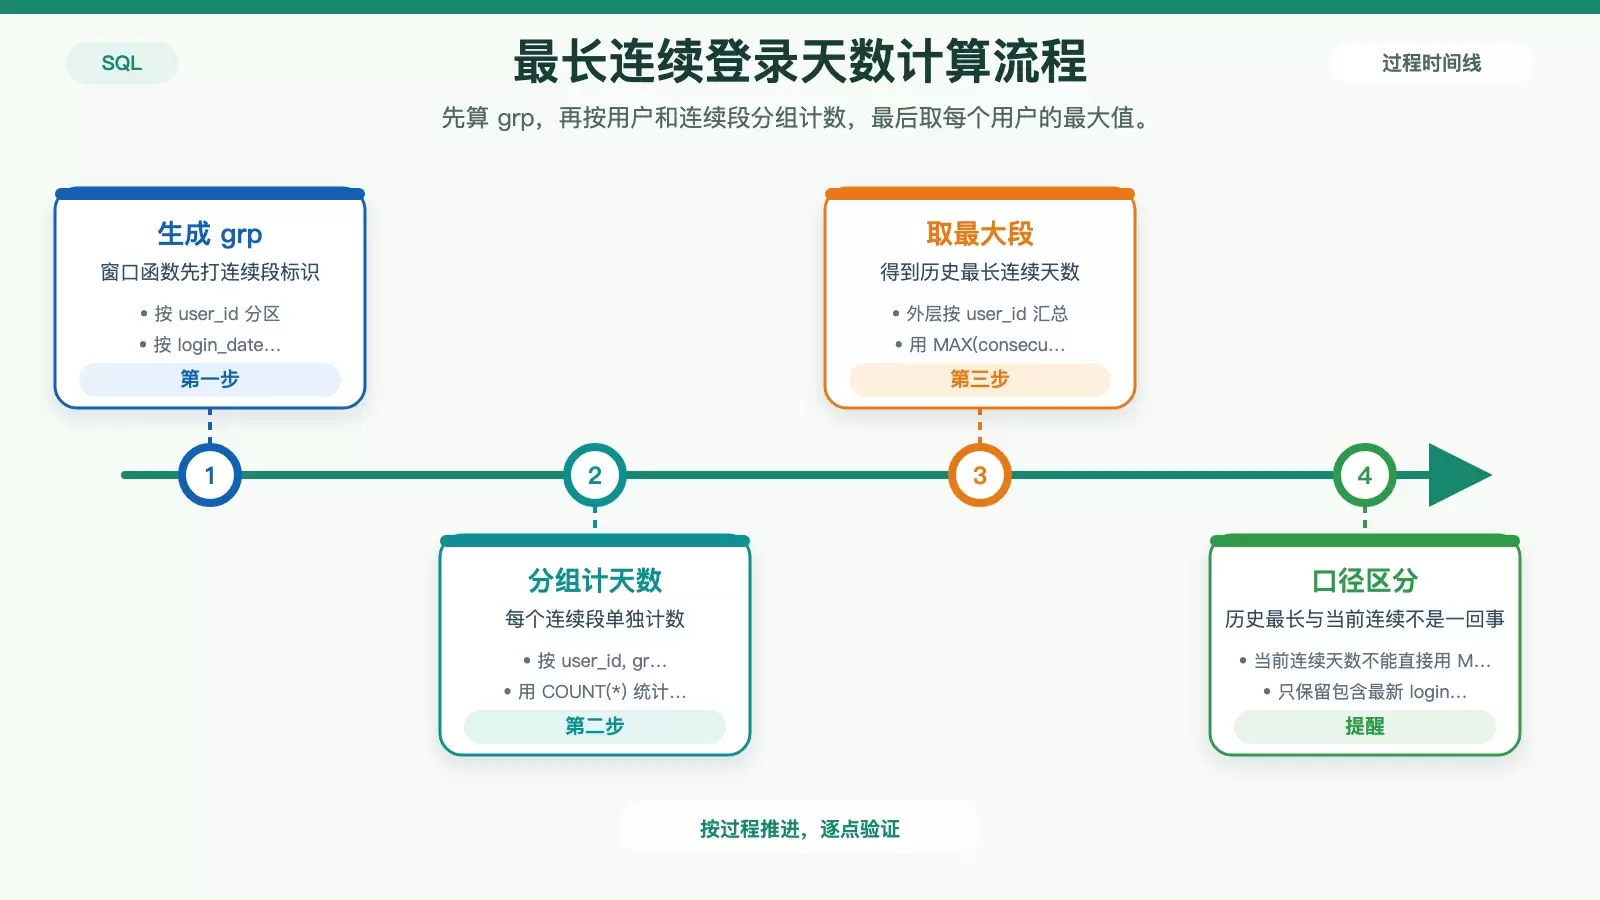
- 先用窗口函数为连续日期打上同一个组标识
grp - 再按
user_id + grp聚合,统计每段长度,最后取最大值
典型 SQL 如下:
SELECT user_id, MAX(consecutive_days) AS max_streak
FROM (
SELECT user_id,
 COUNT(*) AS consecutive_days,
 grp
FROM (
SELECT user_id,
 login_date,
 TO_DAYS(login_date) - ROW_NUMBER() OVER (
 PARTITION BY user_id ORDER BY login_date
 ) AS grp
FROM login_log
) t1
GROUP BY user_id, grp
) t2
GROUP BY user_id;
这段 SQL 的关键拆解
- 内层的
grp计算是核心:连续日期会映射到同一个整数,出现断连时grp会改变。 - 中层按
user_id, grp分组后,用COUNT(*)统计每段连续登录天数。 - 最外层再用
MAX(),取出每个用户历史上的最长连续段。
如果要的是“当前连续登录天数”
这里要和“历史最长连续天数”区分开。若业务想看的是截至最新登录日仍未中断的连续天数,就不能直接取 MAX(),而是要只保留包含最新 login_date 的那个 grp。否则很可能算出一段历史上更长、但现在已经中断的记录。
最容易被忽略的坑:时间精度和时区
很多 SQL 在测试表里能跑通,到了真实业务数据却开始偏差,问题往往不在窗口函数本身,而在时间字段处理。日志表如果存的是 DATETIME 或带时区的 TIMESTAMP,直接拿原始字段判断“哪一天登录过”就可能出错。
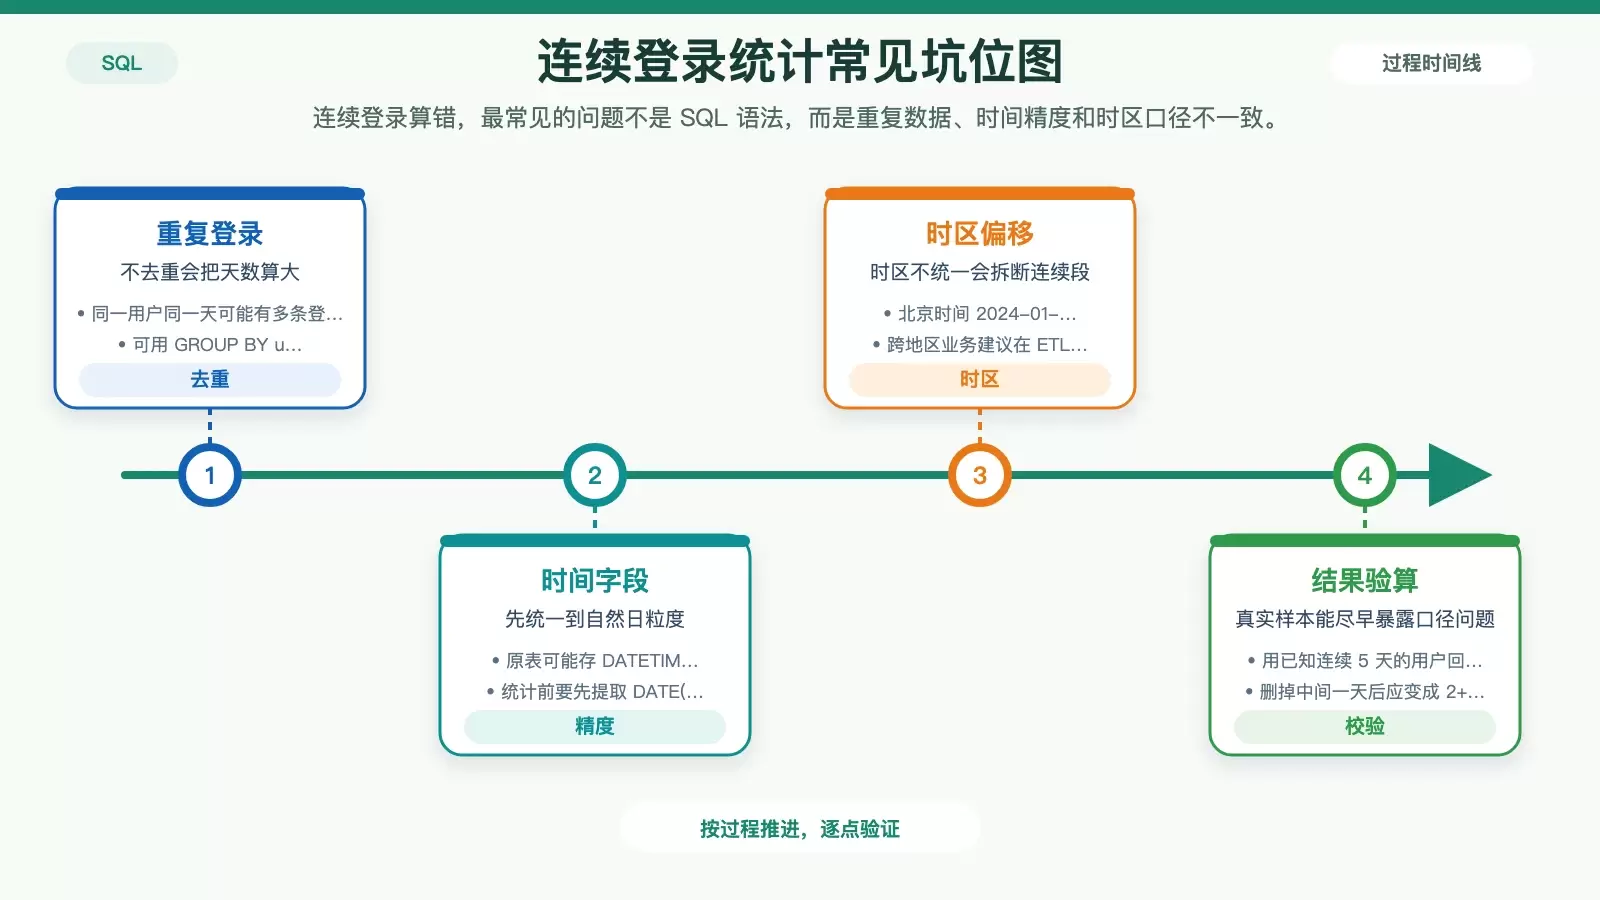
例如用户在北京时间 2024-01-01 23:59:59 登录,若数据库按 UTC 存储且查询时没有转换,落到 UTC 可能会被识别成另一自然日,连续天数也就被拆断了。
实际处理建议
- 统一使用
DATE(login_time)或login_time::date提取日期部分,不要直接依赖原始时间字段。 - 跨地区业务尽量在 ETL 阶段就把时间转换成业务时区对应的日期,避免查询时临时换算。
- 验证时用真实样本跑一遍:先找一个已知连续登录 5 天的用户确认结果为 5,再故意删掉中间一天,检查是否正确变成
2+2而不是4。
实战里该怎么选方案
如果你要的是“识别连续段并统计最长连续登录天数”,ROW_NUMBER() 加日期序数分组是更直接也更通用的方案;如果只是判断某次登录是否接上前一天,LAG() 足够轻便。真正决定结果是否可信的,通常不是窗口函数本身,而是排序、去重、日期转换和时区口径有没有先统一好。















