


MySQL 索引原理:深入解析 B-Tree 与 B+Tree 数据结构差异

本文详细解析 MySQL 数据库中 B-Tree 与 B+Tree 索引数据结构的演进逻辑与技术细节。针对传统二叉查找树在高数据量下导致的频繁磁盘 I/O 问题,阐述了通过降低树深度来提升性能的必要性,并深入对比了两种多叉平衡树在节点设计、查询轨迹及范围扫描上的核心差异,明确 B+Tree 成为主流索引结构的技术依据。
背景:从二叉树到多叉树的演进
在数据库初始阶段,二叉查找树因其查找时间复杂度为 O(logN) 而受到青睐。然而,当数据量达到千万级甚至更高时,二叉树的结构缺陷暴露无遗。由于每个节点仅包含一个关键字和两个指针,为了容纳海量数据,树的高度会急剧增加,退化为“瘦高”的形状。
这种结构会导致严重的性能瓶颈:
- 频繁磁盘 I/O: 无法将所有数据加载至内存,必须逐一从磁盘读取节点页面。最坏情况下,I/O 次数等于树的高度,导致查询效率极低。
- 平衡成本高昂: 维持平衡二叉树的旋转操作开销大,且深度过大直接阻碍了缓存命中率。
为解决此问题,核心思路是降低树的高度,将“瘦高”的树变得“矮胖”。具体技术要求如下:
- 增加节点容量: 每个节点能存储多个元素,而非单一关键字。
- 采用多叉结构: 摒弃二叉树限制,使用多叉搜索树,从而在相同数据量下大幅减少层级数。
B-Tree 结构详解
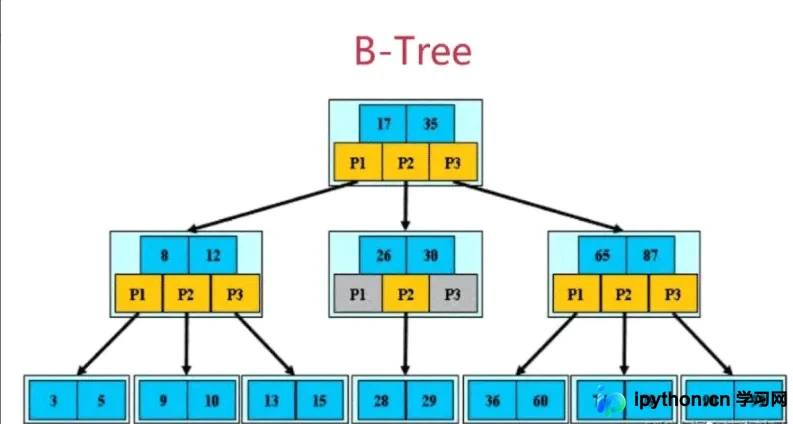
B-Tree(Balanced Tree)是一种多叉平衡搜索树。以三阶 B-Tree 为例,其每个存储块(节点)包含关键字和指向子节点的指针。阶数 M 决定了最大子节点数量,M 的大小取决于存储页(Page)的物理容量及数据库配置。
特性与设计规则
B-Tree 遵循严格的数学约束以保证平衡性:
- 根节点: 至少包含两个孩子节点,子节点数范围为
[2, M]。 - 非根/非叶节点: 除根节点和叶子节点外,其他节点至少有
ceil(M/2)个孩子节点,最多有 M 个。 - 叶子节点: 所有叶子节点位于同一层,且不携带数据指针(在典型数据库实现中,叶子节点往往不直接指向记录,而是作为有序序列的一部分,但在经典定义中叶子节点也存储关键值)。
关键字与指针映射逻辑
假设一个非叶子节点包含 n 个关键字 K1, K2... Kn 和 n+1 个指针 P1, P2... Pn+1:
- 关键字有序排列:
Ki-1 < Ki。 - 节点大小约束:关键字个数 n 满足
[ceil(M/2)-1] <= n <= m-1。 - 指针指向区间: 这是 B-Tree 的关键特征。指针
P[i]指向的子树中,关键字属于开区间(K[i-1], K[i])。
例如:若节点关键字为 8 和 12,则P1指向小于 8 的子树,P2指向 (8, 12) 之间的子树,P3指向大于 12 的子树。
查询演示: 在 B-Tree 中查询数据 15(假设根节点为 17,左子树含 8, 12):
1. 15 < 17,进入左子树。
2. 在左子树中,15 > 12,根据开区间逻辑,落入最后一个指针 P3 的范围。
3. 沿 P3 找到包含 13, 15 的节点,最终定位数据。
4. 整个过程只需访问路径上的节点,时间复杂度稳定在 O(logN)。
B+Tree 结构详解
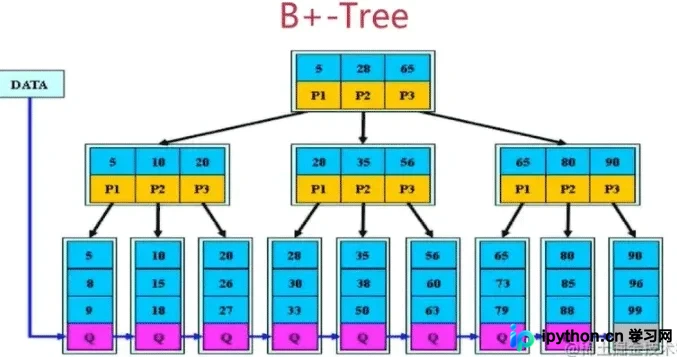
B+Tree 是 B-Tree 的变种,专为文件系统或数据库索引优化设计。它在保留 B-Tree 平衡特性的基础上,做出了以下关键改进:
核心特性对比
- 数据仅存于叶子节点: 非叶子节点仅作为索引目录,不存储实际业务数据。这使得单个节点可以容纳更多关键字索引。
- 指针区间改为左闭右开: 非叶子节点的指针
P[i]指向关键字值属于[Ki, Ki+1)的子树。这意味着最小值由其父节点指针引导,最大值由自身存储。 - 叶子节点双向链表: 所有叶子节点通过链指针相互连接,形成有序链表。
- 更“矮壮”的结构: 由于内部节点不存数据,单节点可存储更多键值对,进一步压缩树高,提升缓存利用率。
为什么 MySQL 选择 B+Tree?
相较于 B-Tree,B+Tree 在关系型数据库场景中具有显著优势,这也是 InnoDB 等引擎默认使用它的原因:
- I/O 代价更低: 非叶子节点只存索引不存数据,使得节点体积变小。在相同的磁盘页(如 16KB)中能放入更多索引项,树更加扁平,从而减少磁盘读写次数。
- 查询效率更稳定: B-Tree 可能在非叶子节点命中目标数据,也可能需要深入到叶子节点;而 B+Tree 的所有查询都必须走到叶子节点才能获取完整记录。这种“长路径”反而保证了每次查询的操作步数一致,性能波动小。
- 范围扫描能力更强: 得益于叶子节点间的链表结构,B+Tree 在进行范围查询(Range Query)或全表遍历时代无需回溯父节点,只需顺着链表顺序读取即可,极大地提升了连续读取的性能。
以上就是 MySQL B-Tree与B+Tree索引数据结构剖析的详细内容,更多关于MySQL索引优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















