


MySQL Join查询优化实战:从原理到性能提升

在MySQL开发中,随着数据量增长,Join查询往往成为性能瓶颈。本文深入解析Nested Loop Join算法原理,通过EXPLAIN工具分析执行计划,掌握驱动表选择规则与索引优化技巧,提供将Low Left Join转化为高效Inner Join等实战方案,帮助开发者显著降低查询耗时。
理解Join查询优化的核心目标
在日常开发中,SELECT * FROM TableA INNER JOIN TableB... 这类语句在数据量少时响应迅速,但随着数据增长,查询速度突然变慢是常见痛点。解决这一问题的关键在于理解MySQL的底层连接算法以及执行计划的解读。
Nested Loop Join 原理
MySQL主要采用 Nested Loop Join(嵌套循环连接) 算法。其核心逻辑是将驱动表的结果集作为循环基础数据,然后逐条利用这些数据作为过滤条件,去下一个表中查找匹配记录,最后合并结果。
优化Join的核心目标正是减少Nested Loop的循环次数。原则很简单:永远用小结果集驱动大结果集。
以下代码展示了一个典型的关联查询场景:
// 假设 user 表有10000条数据,class 表只有20条数据
SELECT * FROM user u LEFT JOIN class c ON u.userid = c.userid;
如果以user表为驱动表,MySQL需要循环查询10000次;若交换位置,以class表驱动user表,则仅需循环20次。差异巨大。
如何正确识别驱动表
确定谁是驱动表是优化的第一步。不同Join类型下,MySQL的处理机制有所不同:
- 指定了联接条件时:满足查询条件的记录行数少的表为驱动表。
- 未指定联接条件时:行数少的表为驱动表(这一点至关重要)。
- Left/Right Join:左连接通常由左边表驱动右边表,右连接反之。但如果不确定哪个表数据量更小且业务允许,建议不强制指定Left/Right,而是交给MySQL优化器决定,或者统一转为Inner Join以获得最大灵活性。
使用 EXPLAIN 工具验证
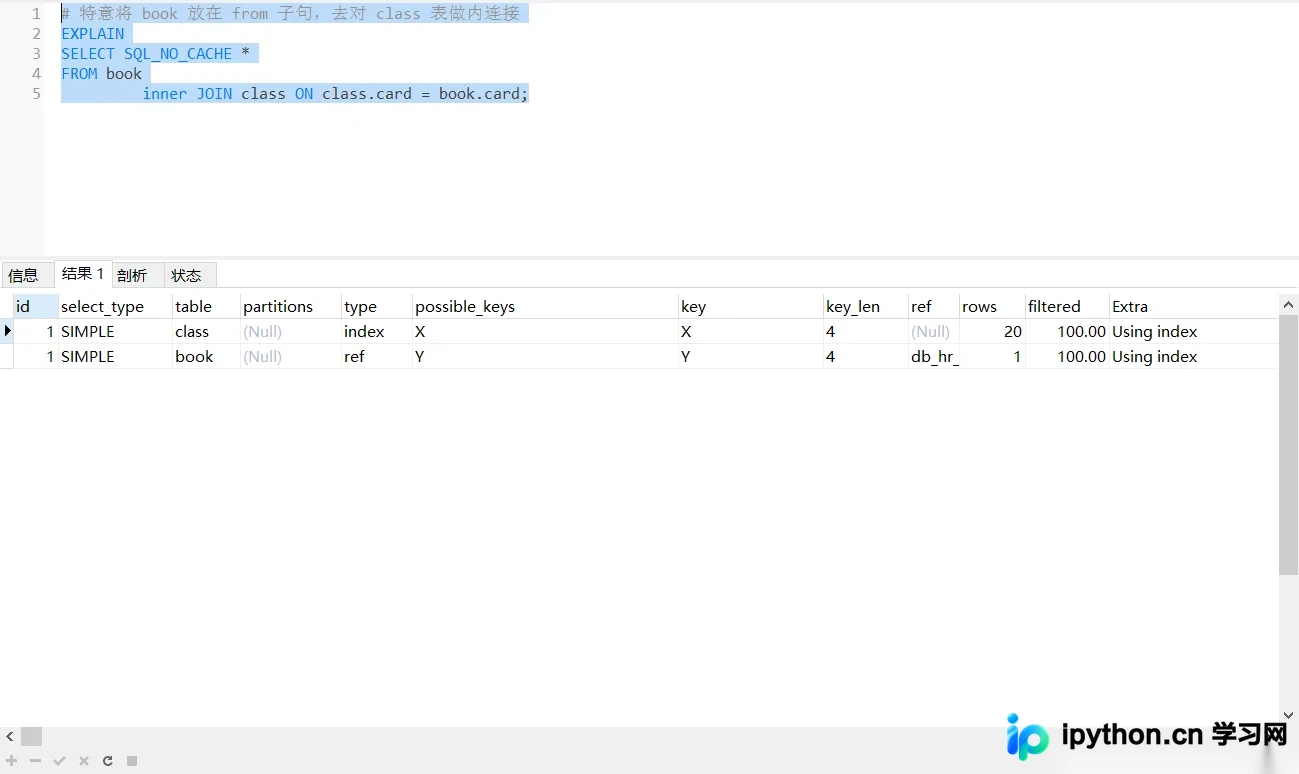
最准确的识别方式是使用 EXPLAIN 命令分析SQL。在输出的结果集中,第一行出现的表即为驱动表。
常见Join模式优化策略
1. Inner Join:让优化器自动调度
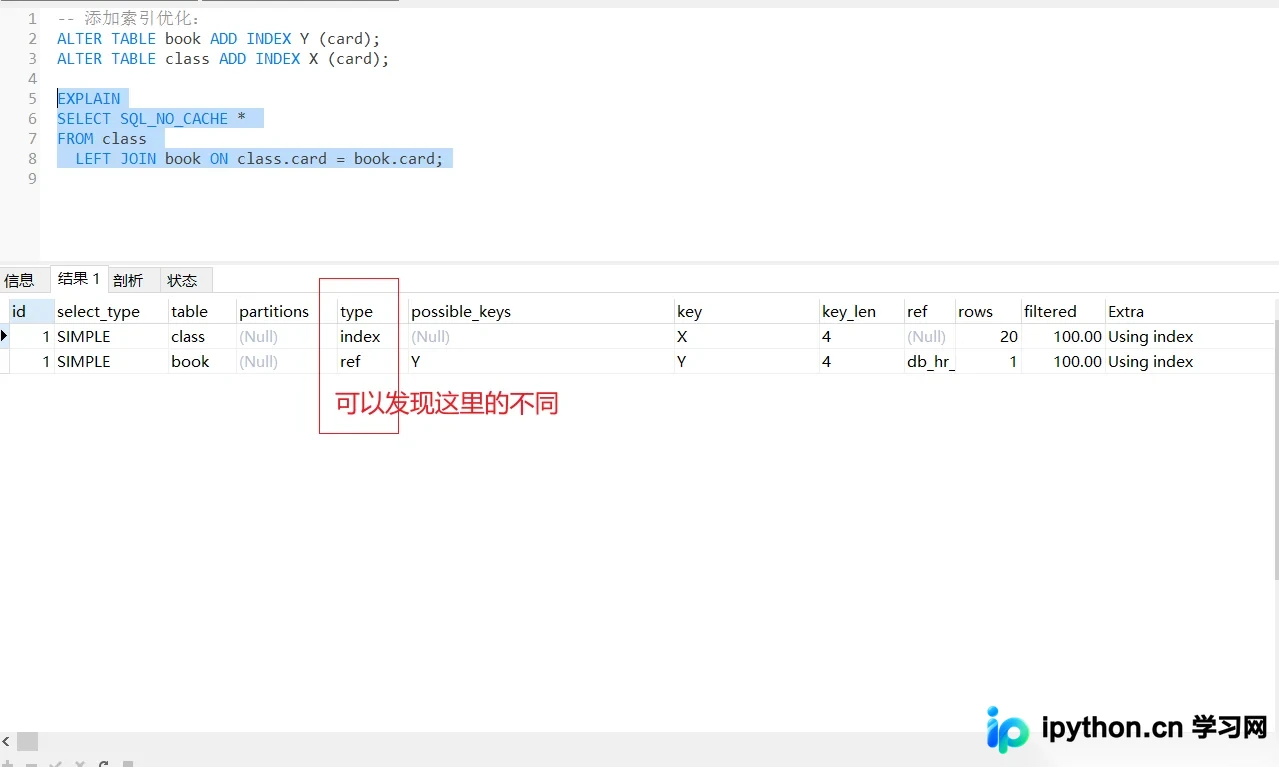
在使用 INNER JOIN 时,MySQL会自动根据统计信息选择小结果集的表作为驱动表。因此,只需确保参与连接的字段上建有索引即可大幅提升效率。被驱动表的Join字段必须有索引,这样可以从全表扫描(ALL)提升为索引查找(ref)。
2. Left/Right Join:人工干预驱动顺序
对于外连接,MySQL的执行计划相对固定。以 LEFT JOIN 为例,左表永远是驱动表。因此,务必将数据量较小的小表放在LEFT JOIN的左侧,大表放在右侧。
结论与最佳实践:
- 小表驱动大表:尽量保证驱动表的数据量少。
- 索引 placement:建议在被驱动表(即右边的表)的Join字段上加索引。因为被驱动表每次都要进行探测,索引收益最明显(从ALL变为ref)。
- 避免子查询作为被驱动表:衍生出来的临时表通常无法使用索引,会导致性能骤降。
实战优化案例:复杂查询调优
下面通过一个包含多表关联、排序和分页的复杂SQL案例,演示具体的优化步骤。
原始 SQL
EXPLAIN SELECT * FROM user u
LEFT JOIN class c ON u.userid = c.userid
INNER JOIN subject s ON c.subjectId = s.id
WHERE 1=1
ORDER BY u.create_time DESC
LIMIT 0,10;
假设 user 表有千万级数据,class 表较少。由于使用了 LEFT JOIN,MySQL强制 user 表为驱动表。这可能导致巨大的循环开销,且由于对驱动表的字段排序,容易产生Using filesort。
优化步骤一:去除不必要的Left Join
如果业务逻辑允许(即class表中必须有匹配数据才能显示),应将 LEFT JOIN 改为 INNER JOIN。这使得MySQL优化器可以自由选择驱动表,不再被迫以大数据量的 user 表开头。
EXPLAIN SELECT * FROM user u
JOIN class c ON u.userid = c.userid
INNER JOIN subject s ON c.subjectId = s.id
WHERE 1=1
ORDER BY u.create_time DESC
LIMIT 0,10;
优化步骤二:解决 Using temporary & Using filesort
优化后观察执行计划,如果发现 Using temporary 或 Using filesort,通常是因为排序字段不在索引覆盖范围内,或者排序的是非驱动表的字段导致需要在合并后的临时表中排序。
根据前文提到的原则:“对驱动表可以直接排序,对非驱动表排序会产生临时表”。如果能调整业务需求,改为对驱动表的某个索引字段排序,或者确保排序字段能走索引,即可消除文件排序。
// 尝试调整 ORDER BY 字段,使其更利于走索引或减少排序开销
EXPLAIN SELECT * FROM user u
JOIN class c ON u.userid = c.userid
INNER JOIN subject s ON c.subjectId = s.id
WHERE 1=1
ORDER BY c.id DESC
LIMIT 0,10;
总结
MySQL Join优化的核心在于控制循环次数。通过EXPLAIN分析执行计划,识别驱动表与被驱动表,遵循“小表驱动大表”的原则,并在被驱动表的连接字段上建立索引。同时,善用Inner Join代替Left Join以发挥优化器的最大潜能,并合理设计排序字段以避免额外的磁盘排序操作。
以上就是MySQL之join查询优化方式的详细内容,更多关于MySQL Join查询优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















