


Python新手画图用哪个库?Matplotlib与Seaborn入门推荐

一、层级关系与核心定位认知
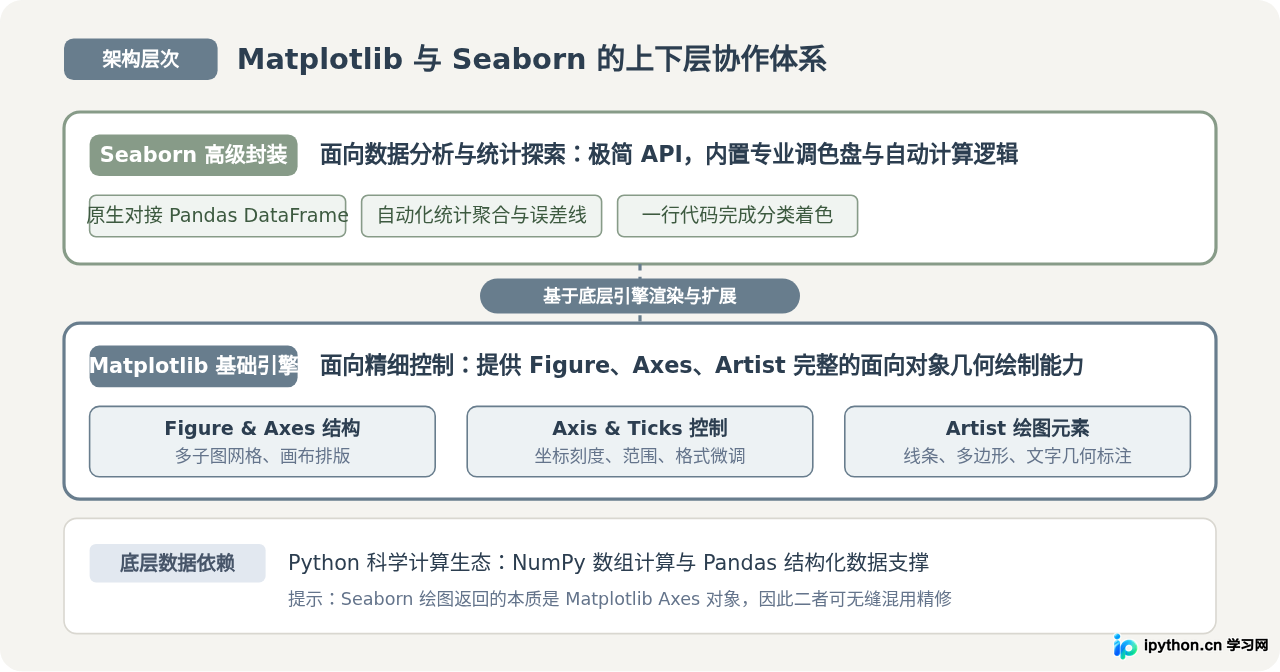
很多初学者在刚开始画图时容易产生非此即彼的纠结,误以为学会了 Seaborn 就可以彻底抛弃 Matplotlib,或者认为学 Matplotlib 才能打牢所有基础。要理清二者的选择逻辑,首先需要理解它们在 Python 科学计算生态中所处的层级结构。
Matplotlib 是 Python 数据可视化领域的奠基工具,历史悠久且功能完备。它的底层设计采用了严谨的面向对象结构,将一幅图纸解构为 Figure(整幅画布)、Axes(独立子图与坐标系)、Axis(坐标轴)、Tick(刻度标记)以及各种几何 Artist(线条、多边形、文本标签)。这种设计的优势在于几乎没有表达上限,画布上的每一个像素点、每条线段的虚实间距都可以由代码精准控制;但劣势也同样明显——绘制常规统计图表时,开发者需要手动编写大量样板代码来处理数据聚合与视觉映射。
Seaborn 则是针对上述痛点诞生的高级统计可视化库。它并不直接操控屏幕上的像素绘制,而是完全依托 Matplotlib 作为其底层渲染引擎。Seaborn 在顶层封装了一套语义化的绘图函数,将原本繁复的统计计算(如计算置信区间、分箱统计、分组均值)与美学配置(专业调色盘、网格主题)自动化处理,并深度绑定 Pandas 的 DataFrame 数据结构。读者可以把 Matplotlib 理解为一套包含画框、底纸和各色画笔的基础绘画工具箱,而 Seaborn 则是一位熟悉现代信息图表规范的资深绘图助手。
二、从代码风格看两者的心智模型差异
为了直观展现两者在实际编写时的感受,我们可以观察它们在完成同一绘图任务时的思维差异。假定我们需要对一组带有分类标签的观测数据绘制散点图并呈现规律:
1. Matplotlib 的心智模型:命令驱动与几何图元思维
在 Matplotlib 中,作者需要显式向程序说明“如何摆放每一个视觉构件”。如果数据包含不同类别,你需要自行根据类别过滤数据,分批调用绘制方法,或者手动构造颜色映射数组,最后再显式调用图例生成指令:
import matplotlib.pyplot as plt
import numpy as np

# 1. 准备样本数据
np.random.seed(42)
x = np.linspace(0, 10, 80)
y = np.sin(x) + np.random.normal(0, 0.25, 80)

# 2. 显式创建面向对象画布与坐标系
fig, ax = plt.subplots(figsize=(8, 4.5))

# 3. 逐项绘制图元
ax.plot(x, np.sin(x), color='#687D8D', linewidth=2, label='理论正弦曲线')
ax.scatter(x, y, color='#879B88', alpha=0.7, s=30, label='观测带噪点集')

# 4. 手动配置细节
ax.set_title('Matplotlib 面向对象绘图示例', fontsize=13)
ax.set_xlabel('时间序列 (t)')
ax.set_ylabel('物理振幅 (A)')
ax.grid(True, linestyle='--', alpha=0.5)
ax.legend(frameon=True)

plt.tight_layout()
plt.show()
这段代码展示了 Matplotlib 最推荐的面向对象风格(通过 fig, ax = plt.subplots() 显式获取句柄)。它的优点是每一步都绝对透明,读者能明确知道哪个属性改变了哪处标签;但如果分类有五六个,就需要编写循环与颜色列表来管理图例,过程较为繁琐。
2. Seaborn 的心智模型:数据语义驱动思维
在 Seaborn 中,思维方式从“几何图元绘制”转变为“数据语义绑定”。你只需要把整理好的 DataFrame 交给函数,并通过参数指出哪些列对应 X 轴、Y 轴以及分组类别,Seaborn 会全自动完成分组着色、比例映射和图例整合:
import seaborn as sns
import matplotlib.pyplot as plt
import pandas as pd
import numpy as np

# 1. 构建长格式表格数据
np.random.seed(42)
df = pd.DataFrame({
    'study_hours': np.random.uniform(1, 10, 120),
    'exam_score': np.random.uniform(50, 100, 120),
    'department': np.random.choice(['文科组', '理科组', '工科组'], 120)
})

# 2. 应用现代美学样式
sns.set_theme(style='whitegrid', palette=['#687D8D', '#879B88', '#D97706'])

# 3. 一行代码绑定数据语义
ax = sns.scatterplot(
    data=df,
    x='study_hours',
    y='exam_score',
    hue='department',
    style='department',
    s=70
)

# 4. 利用返回的 ax 对象进行局部微调
ax.set_title('Seaborn 语义映射分类散点图', fontsize=13)
ax.set_xlabel('每周自习时长 (小时)')
ax.set_ylabel('期末测验得分 (分)')

plt.tight_layout()
plt.show()
注意上述代码中 ax = sns.scatterplot(...) 这一行:Seaborn 函数执行后返回的正是一个 Matplotlib 的 Axes 对象。这意味着在享受 Seaborn 高效语义绑定的同时,后续依然可以使用所有熟悉的 Matplotlib 方法(如 ax.set_title)进行精雕细琢。
三、科学绘图的标准化四步工作流
无论选用 Matplotlib 还是 Seaborn,规范的数据可视化开发都遵循一致的生命周期流程。建立起标准化的四步思维,能够有效防止代码前后混乱、样式冲突或图表重叠问题。
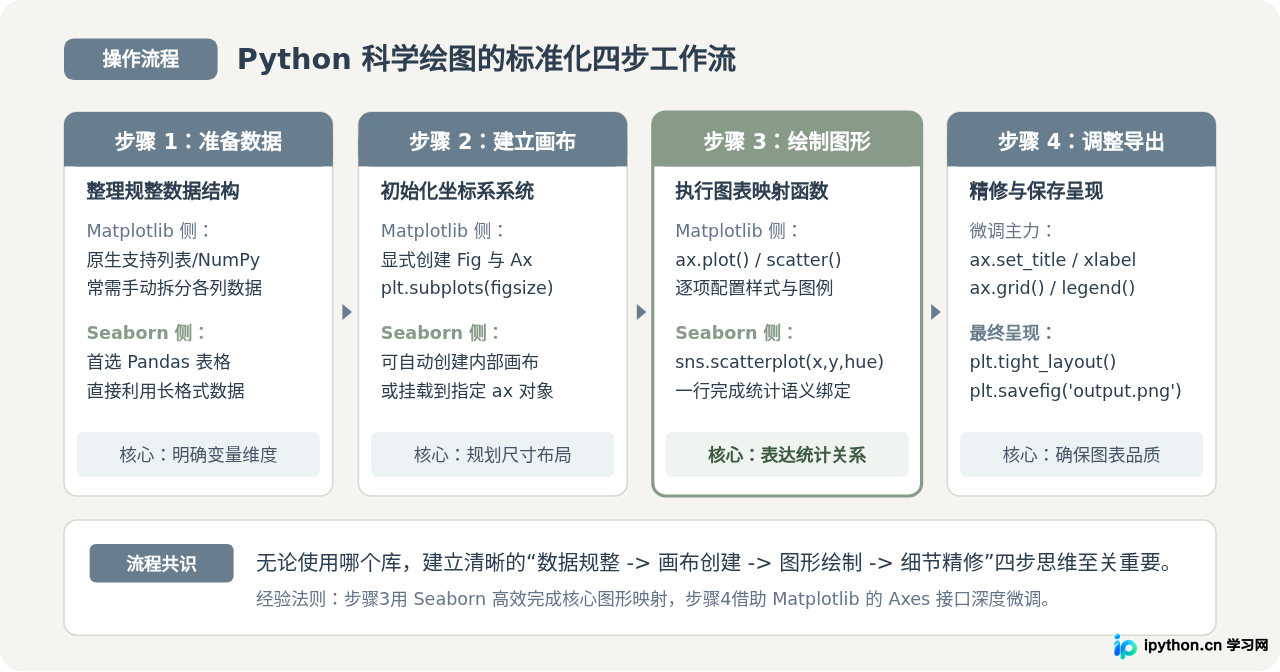
- 步骤一:数据规整与预处理。绘图失败往往不是出在绘图代码本身,而是数据结构不适配。如果打算使用 Seaborn,请务必保证数据以“长格式”(Tidy Data)组织,即每一行代表一个独立样本观测,每一列代表一个明确属性。
- 步骤二:创建画布与坐标网格。推荐统一使用
fig, ax = plt.subplots(figsize=(w, h), dpi=100)创建受控的底图结构。无论接下来使用哪个库,明确画布比例都是避免元素拉伸变形的第一步。 - 步骤三:绘制图形。在特定 Axes 上执行图元绑定。探索统计关系优先调用
sns.*(..., ax=ax),基础几何折线则调用ax.plot(...)。 - 步骤四:细节精修与导出保存。配置标题、坐标轴单位、图例位置及网格线样式,最后使用
plt.tight_layout()自动计算排版边距,并用plt.savefig('output.png', dpi=300)导出清晰位图或矢量文件。
四、新手实际任务选择决策路径
当面临具体任务时,新手应如何快速判断该选择哪一个库?根据业务场景、数据来源与排版要求,判定逻辑可以清晰拆解为以下三条路径:
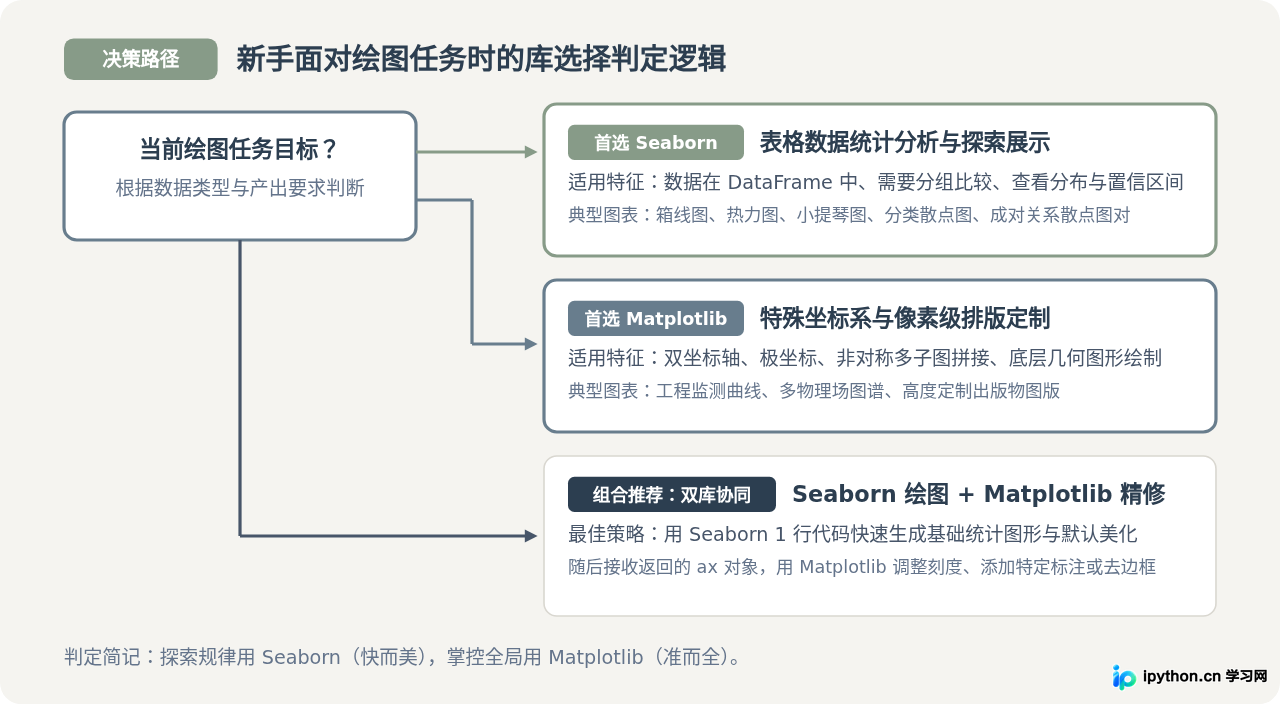
路径一:业务数据分析与探索性汇报(首选 Seaborn)
如果手头的数据已经存储在 Pandas DataFrame 中,任务是观察变量之间的关联、比较不同分类的数据分布特征,或者生成汇报图表,强烈建议直接使用 Seaborn:
- 分类变量分布对比:例如比较不同部门员工的薪资分布,使用
sns.boxplot()或sns.violinplot()仅需一行代码,且自动完成四分位数与离群点计算。 - 相关性与热力矩阵:计算各指标相关系数后,使用
sns.heatmap(df.corr(), annot=True)可以快速生成带数值标注的专业热力图。 - 多变量散点矩阵:使用
sns.pairplot(df, hue='category')可以瞬间展示所有数值变量之间的成对散点分布与单变量直方分布。
路径二:非标准工程制图与特殊坐标系统(首选 Matplotlib)
当图表脱离了常规统计学范畴,进入工程测量、物理仿真或极具个性化的版面设计时,Seaborn 的高级抽象反而会成为限制,此时应直接使用 Matplotlib:
- 双 Y 轴对比图:主坐标轴与副坐标轴量纲悬殊(例如左轴为销售额,右轴为同比增长率),需使用
ax.twinx()机制显式管理两个 Axes。 - 复杂非对称子图排版:使用
plt.GridSpec划分不规则网格(例如上方主图占 3/4 面积,下方辅助图占 1/4 面积并共享 X 轴)。 - 特殊坐标系与纯几何绘制:雷达图、极坐标图、三维曲面图,或在图纸上绘制箭头标注、几何区域遮罩与自定义公差带。
路径三:实战中的黄金搭档——双库混用模式
在实际生产环境中,资深工程师最常用的工作流实际上是“双库协同”:先使用 Seaborn 的高层函数完成繁重的统计聚合与主体图形映射,随后利用返回的 Axes 句柄调用 Matplotlib 接口完成局部微调。这种组合方式兼具了开发效率与定制自由度。
五、新手容易踩坑的高频问题与规避建议
初学者在学习画图过程中经常会遇到一些阻碍进度的典型问题,提前了解这些陷阱可以节省大量排查时间:
Matplotlib 默认采用英文字体配置,直接在标题或轴标签输入中文会导致图表出现方形乱码(豆腐块),负号也可能显示为异常方块。解决该问题只需在脚本开头设置两项全局参数:
import matplotlib.pyplot as plt

# 配置中文字体优先回退列表(适配 macOS 与 Windows)
plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Microsoft YaHei', 'SimHei', 'sans-serif']

# 解决坐标轴负号无法正常显示的问题
plt.rcParams['axes.unicode_minus'] = False避开接口混用陷阱:Matplotlib 提供了两种调用风格——早期的 plt.plot() 全局状态机风格,以及推荐的 fig, ax = plt.subplots() 面向对象风格。新手切忌在同一个脚本中混用这两种写法,否则在多子图场景下极易发生“代码设置了属性却修改到了别的图上”的现象。建议从第一个脚本开始就坚持使用面向对象句柄。
六、新手循序渐进的学习路径规划
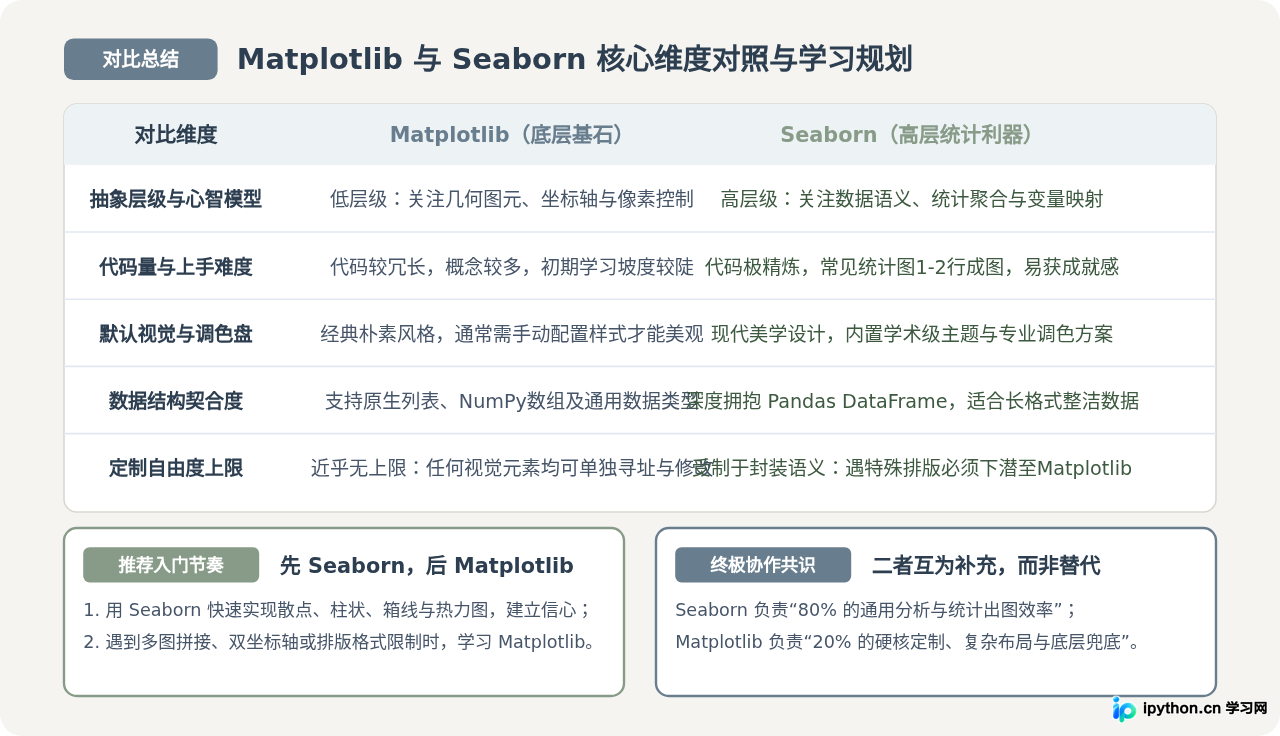
综合以上分析,新手最平稳、阻力最小的学习路径可以规划为三个明确阶段:
- 第一阶段:用 Seaborn 建立图表直觉(第 1~3 天)
跳过繁重的几何控制,直接学习常用的统计图形函数:散点图(scatterplot)、柱状图(barplot/countplot)、分布图(histplot/kdeplot)和箱线图(boxplot)。重点体会hue、style等参数如何将表格数据映射为视觉元素,快速产出美观实用的分析图表,建立学习正反馈。 - 第二阶段:掌握 Matplotlib 的面向对象控制(第 4~7 天)
学习Figure与Axes的层级模型。熟练掌握使用fig, ax = plt.subplots()调整子图比例、添加标题、设置坐标轴刻度与范围、添加图例和网格线。此时即使需要绘制折线图或简单条形图,也能完全脱离全局状态机接口。 - 第三阶段:掌握双库协同与工业化排版(进阶实战)
在实际项目分析中,养成“以 Seaborn 快速成图,以 Matplotlib 丰富细节”的开发直觉。学会查阅 Matplotlib 官方文档的AxesAPI,处理双坐标轴、误差棒、非对称网格切分等高级课题,形成稳定、专业的 Python 数据可视化工作流。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















