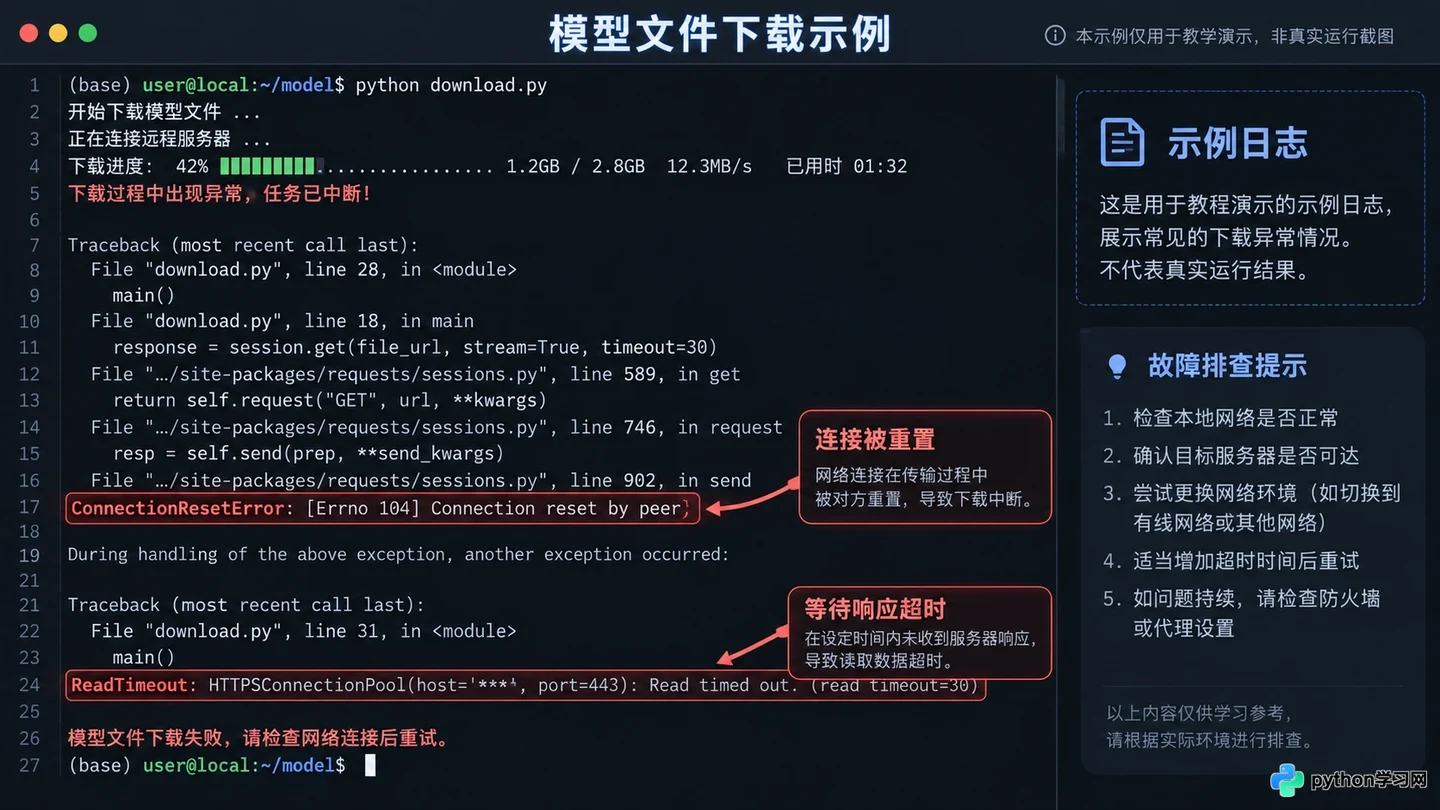
Python离线翻译中文怎么实现?使用transformers本地模型方案
详细讲解如何使用 Python 与 Hugging Face transformers 库实现纯离线环境下的英文到中文翻译,涵盖本地模型权重下载、环境配置、断网加载机制、长文本与批量推理处理及常见报错排查。
11-02
7




详细讲解如何使用 Python 与 Hugging Face transformers 库实现纯离线环境下的英文到中文翻译,涵盖本地模型权重下载、环境配置、断网加载机制、长文本与批量推理处理及常见报错排查。
本文从社区活跃度、审核机制及下载便利性对比 Civitai 与 Hugging Face。Civitai 适合通过视觉案例快速筛选风格,Hugging Face 则便于核对模型依赖与技术细节。文章指出,复现失败往往源于版本与工作流不匹配,而非平台本身。建议用户根据“视觉探索”或“工程部署”的需求选择平台,并强调记录具体版本与许可条件的重要性。
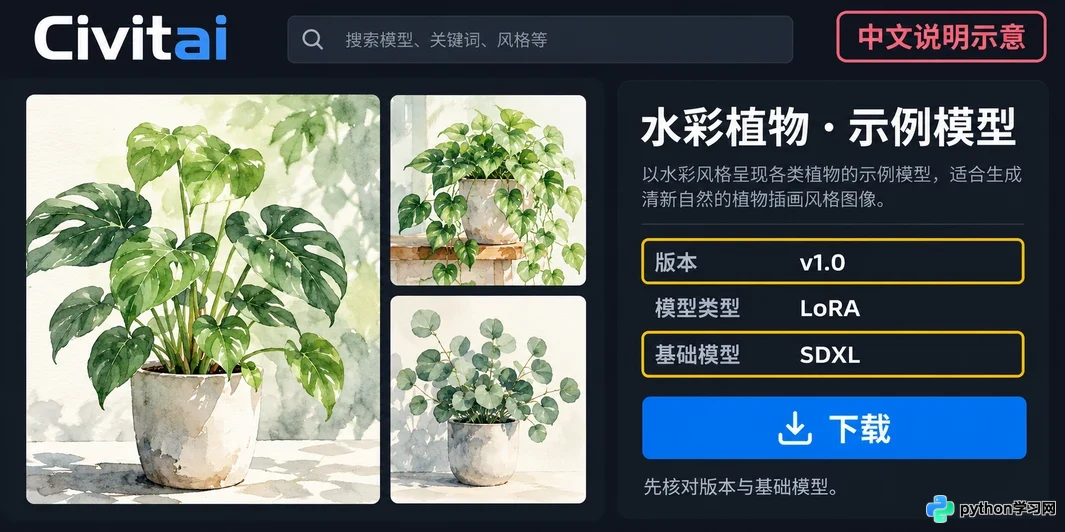
本文通过具体的中文信息抽取任务,对比 Hugging Face 与阿里云百炼在模型获取、在线调用、地域合规及成本结构上的差异。文章不虚构性能排名,而是提供一套可执行的选型核对流程,帮助开发者根据数据敏感性、维护能力和业务场景做出合理选择。
本文对比Hugging Face、ModelScope与Ollama三大主流大模型获取渠道。指出前两者侧重完整权重与开发资料,后者侧重本地运行体验。强调在下载前应明确使用场景(微调研究或本地对话),核对发布来源、文件格式及许可证,避免盲目下载导致环境配置失败或资源浪费。
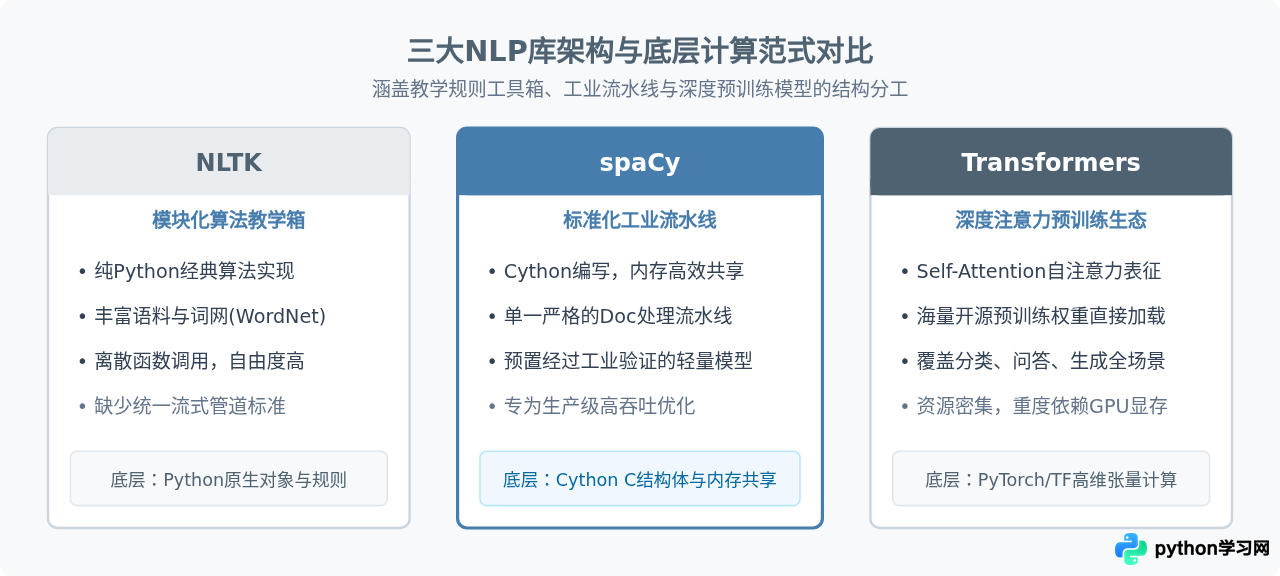
面向Python自然语言处理初学者,全面对比NLTK、spaCy与Transformers三大核心库的架构定位、处理流程、性能差异与应用场景,提供清晰实用的选型指南与工程建议。
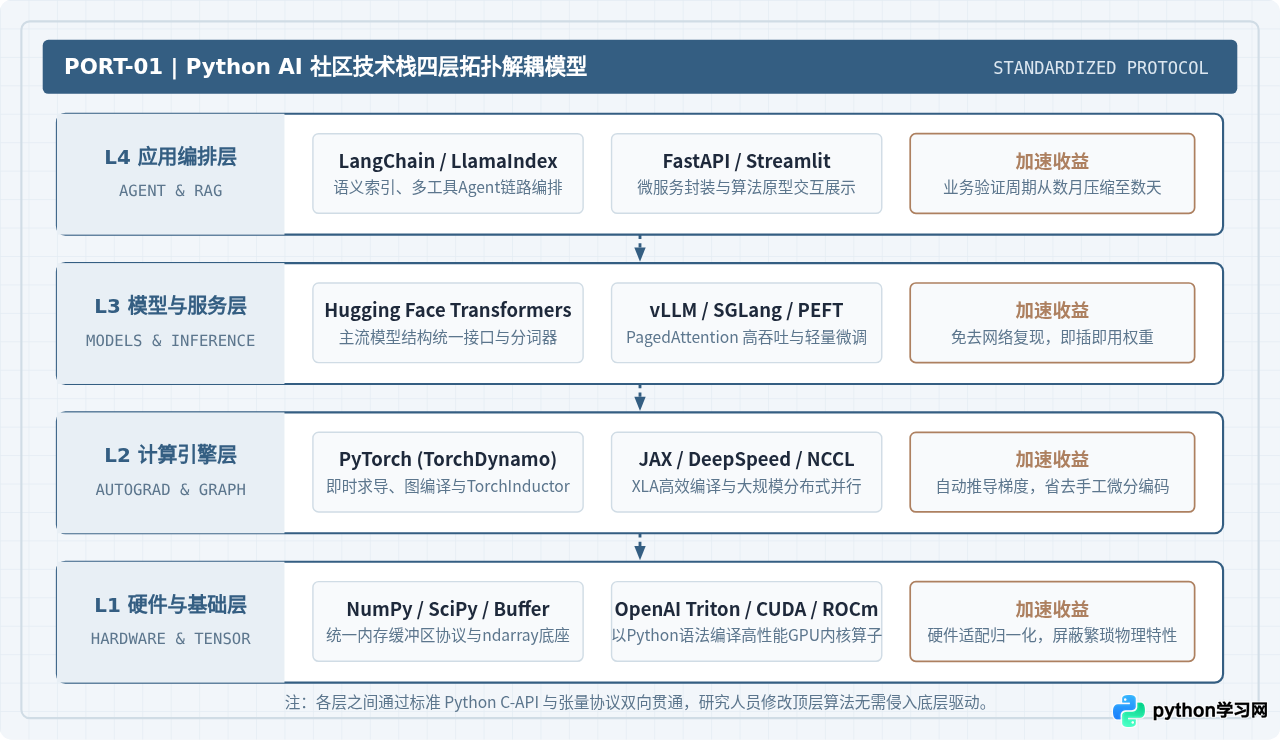
深入解析Python社区资源如何通过解耦的技术栈、开箱即用的预训练资产、全球协同验证机制及工程化闭环,全方位加速人工智能技术的研发迭代与应用创新。
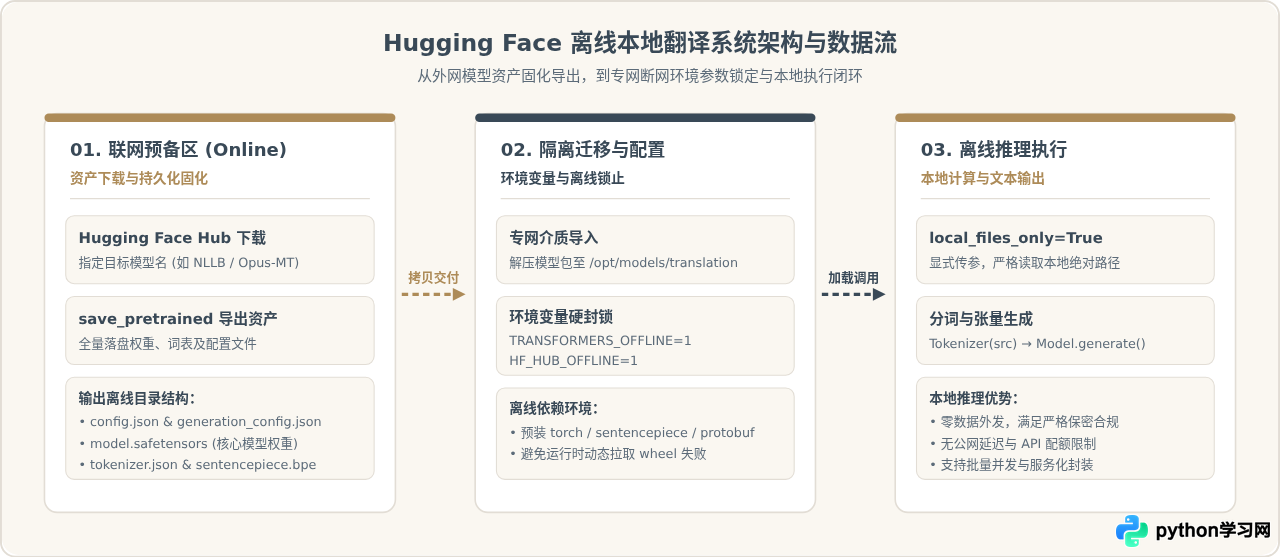
详解如何在完全离线的内网环境中使用Python与Hugging Face开源模型实现高质量本地机器翻译,涵盖模型固化下载、路径锁定、Transformers与CTranslate2推理代码及长文本批处理优化。
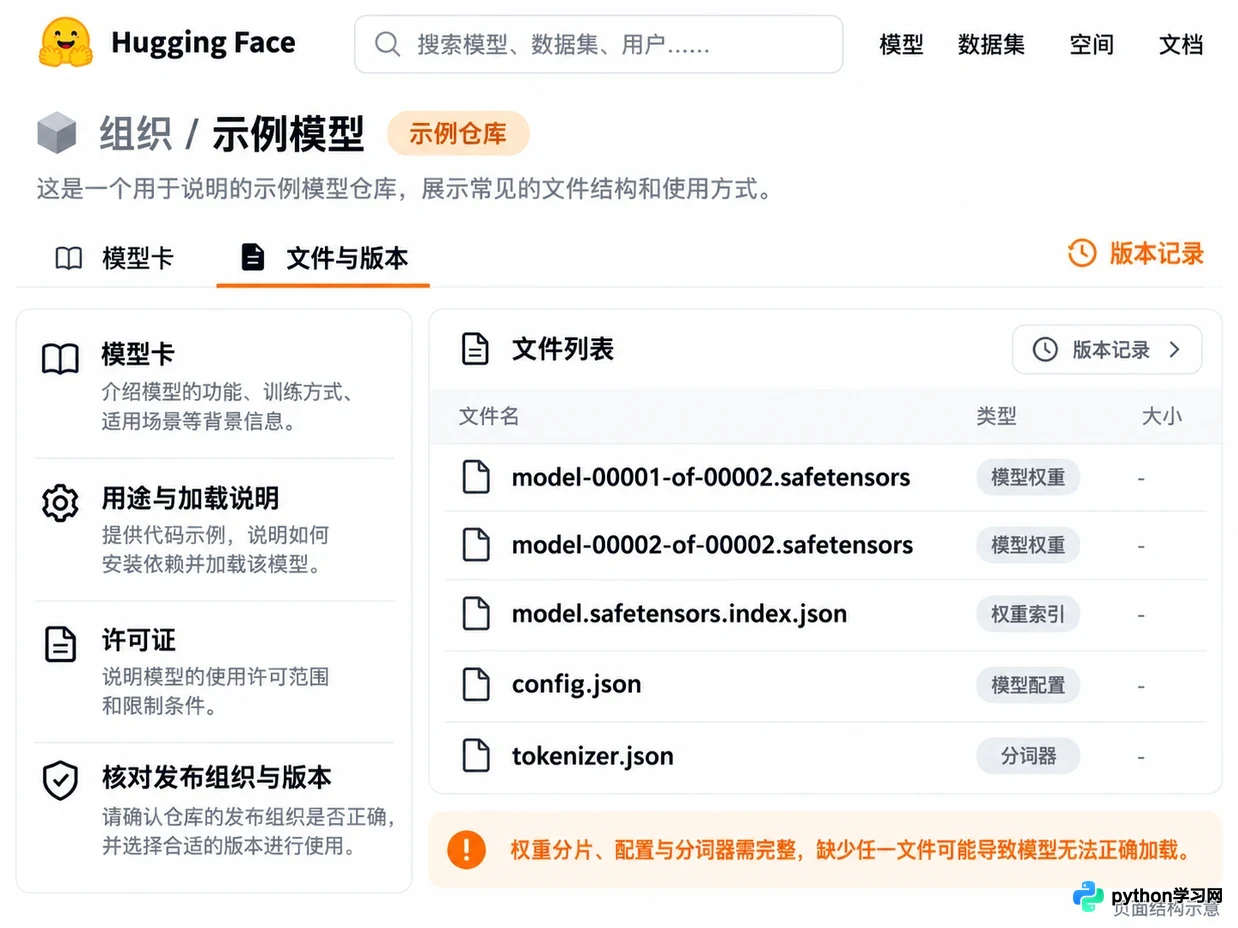
针对国内用户访问Hugging Face下载大模型慢或失败的问题,本文提供基于HF-Mirror镜像站的PowerShell配置方案。通过环境变量切换端点、小文件先行验证链路、精确指定版本与文件、以及处理权限与证书错误四个场景,确保下载过程既快速又安全合规。
针对本地部署DeepSeek模型时常见的显存溢出(OOM)和模型下载失败问题,提供基于CUDA环境配置、量化策略调整及网络代理设置的具体排查思路与解决方案,帮助用户跨越从下载到运行的技术门槛。