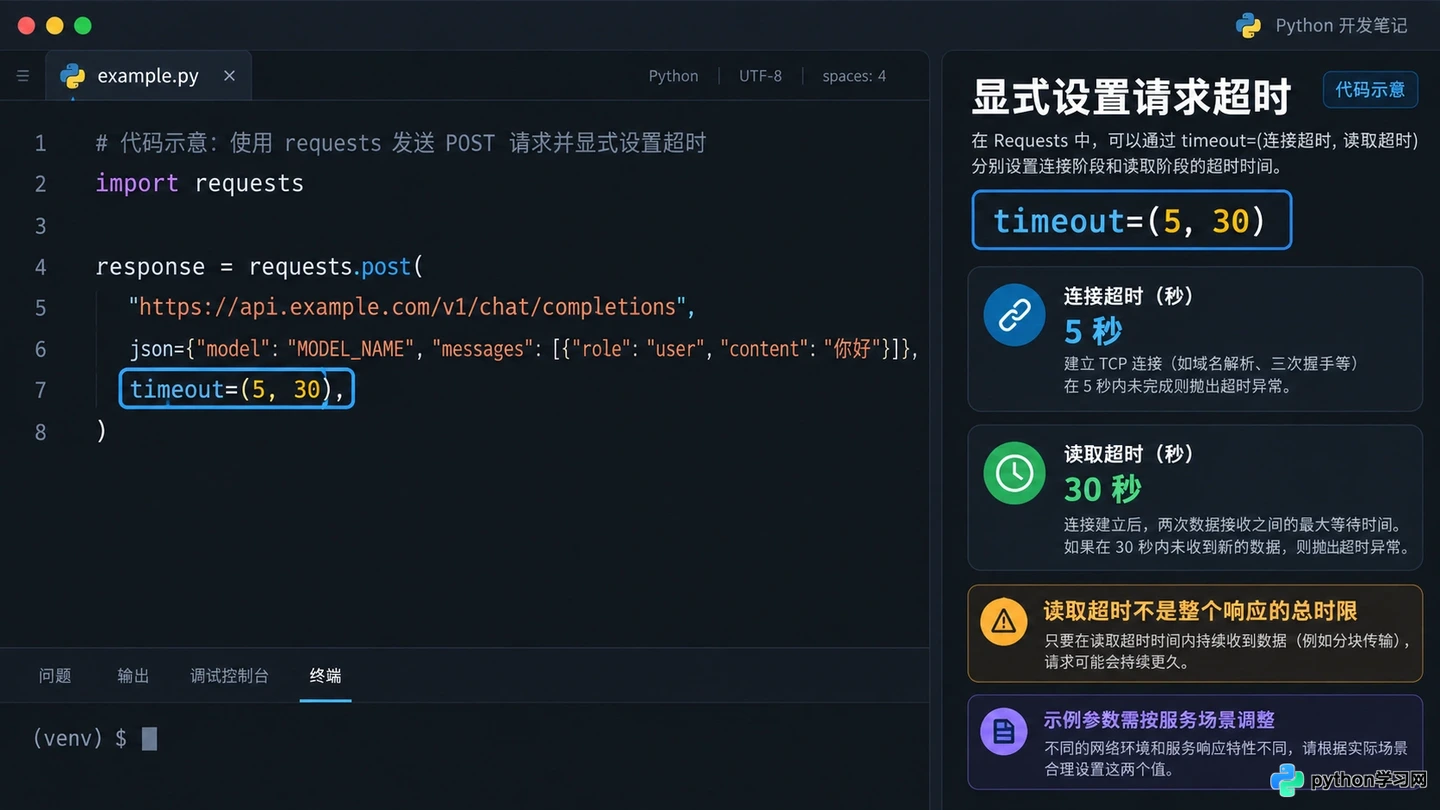
大模型应用开发常见报错解析:API连接超时与速率限制处理
针对大模型应用开发中高频出现的API连接超时、429速率限制及参数错误,提供从网络环境检查、重试机制设计到请求参数校验的实战排查指南,帮助开发者快速定位并解决接口调用问题。
10-20
50




针对大模型应用开发中高频出现的API连接超时、429速率限制及参数错误,提供从网络环境检查、重试机制设计到请求参数校验的实战排查指南,帮助开发者快速定位并解决接口调用问题。
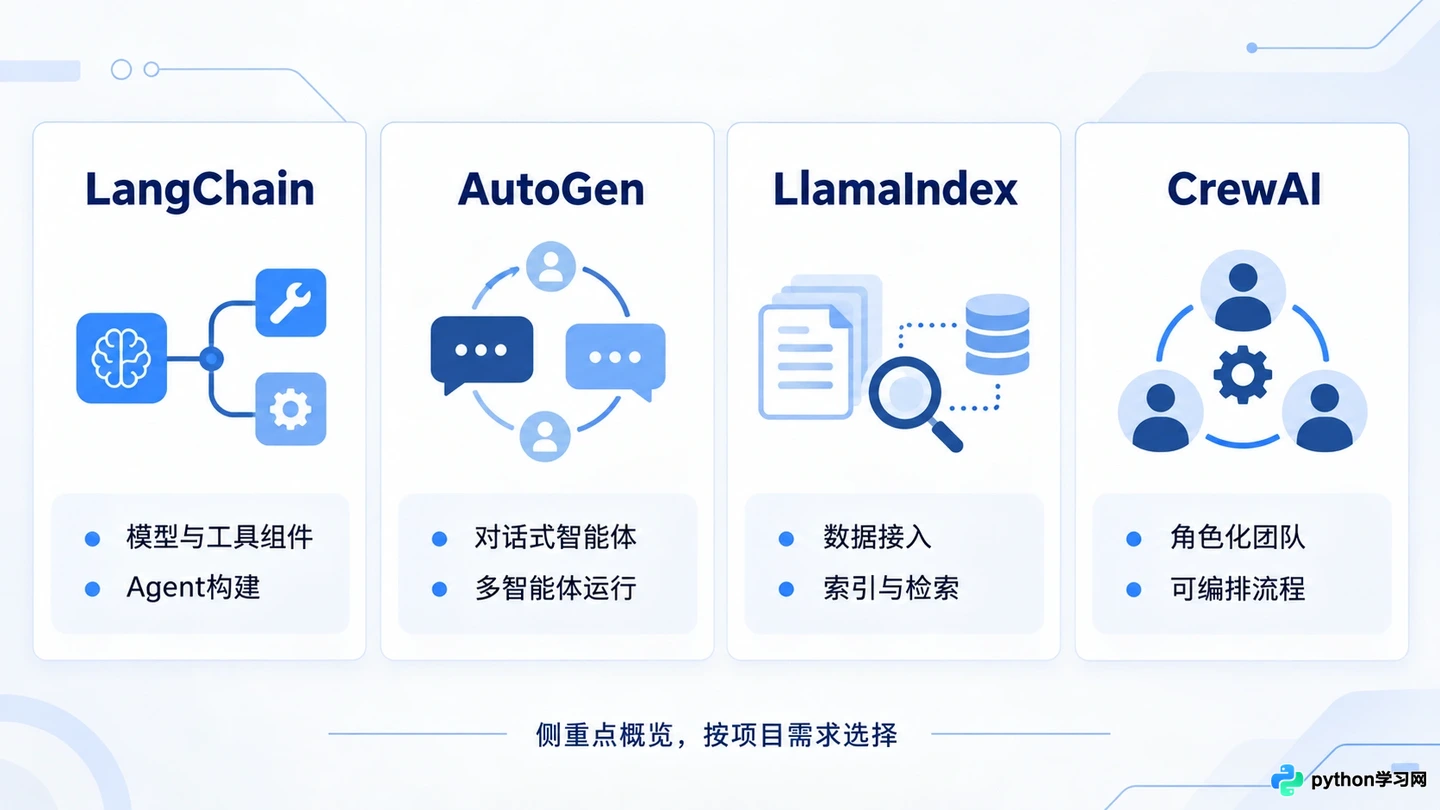
本文对比LangChain、AutoGen、LlamaIndex和CrewAI四大主流AI智能体框架,从核心架构、适用场景及代码实现维度解析其差异,帮助开发者根据单任务编排或多智能体协作需求选择合适技术栈。
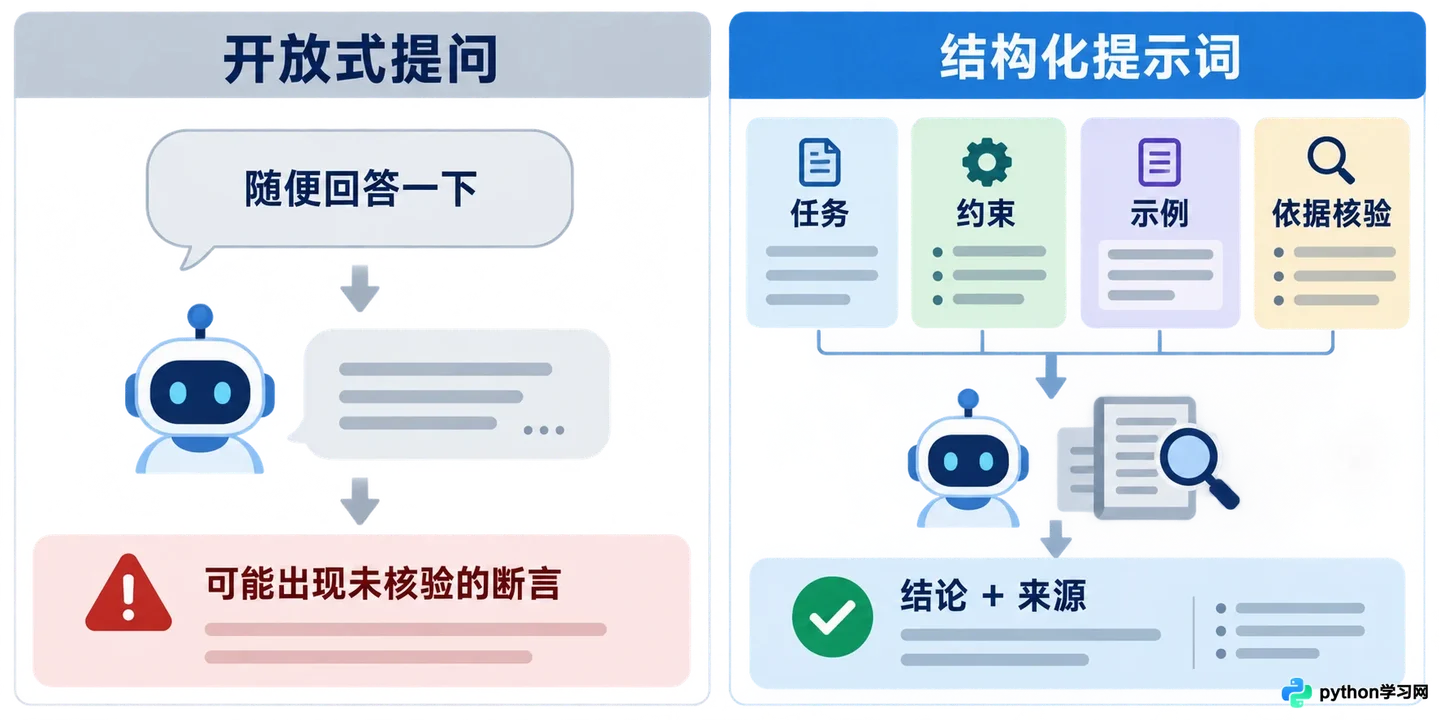
本文从实际业务场景出发,探讨在大模型应用开发中如何通过精细化的提示词工程(如思维链、少样本学习)和多层级的输出校验策略(如引用溯源、逻辑一致性检查)来抑制模型幻觉。文章不堆砌参数,而是聚焦于“如何让AI说真话”的工程实践,帮助开发者在准确性与灵活性之间找到平衡点。
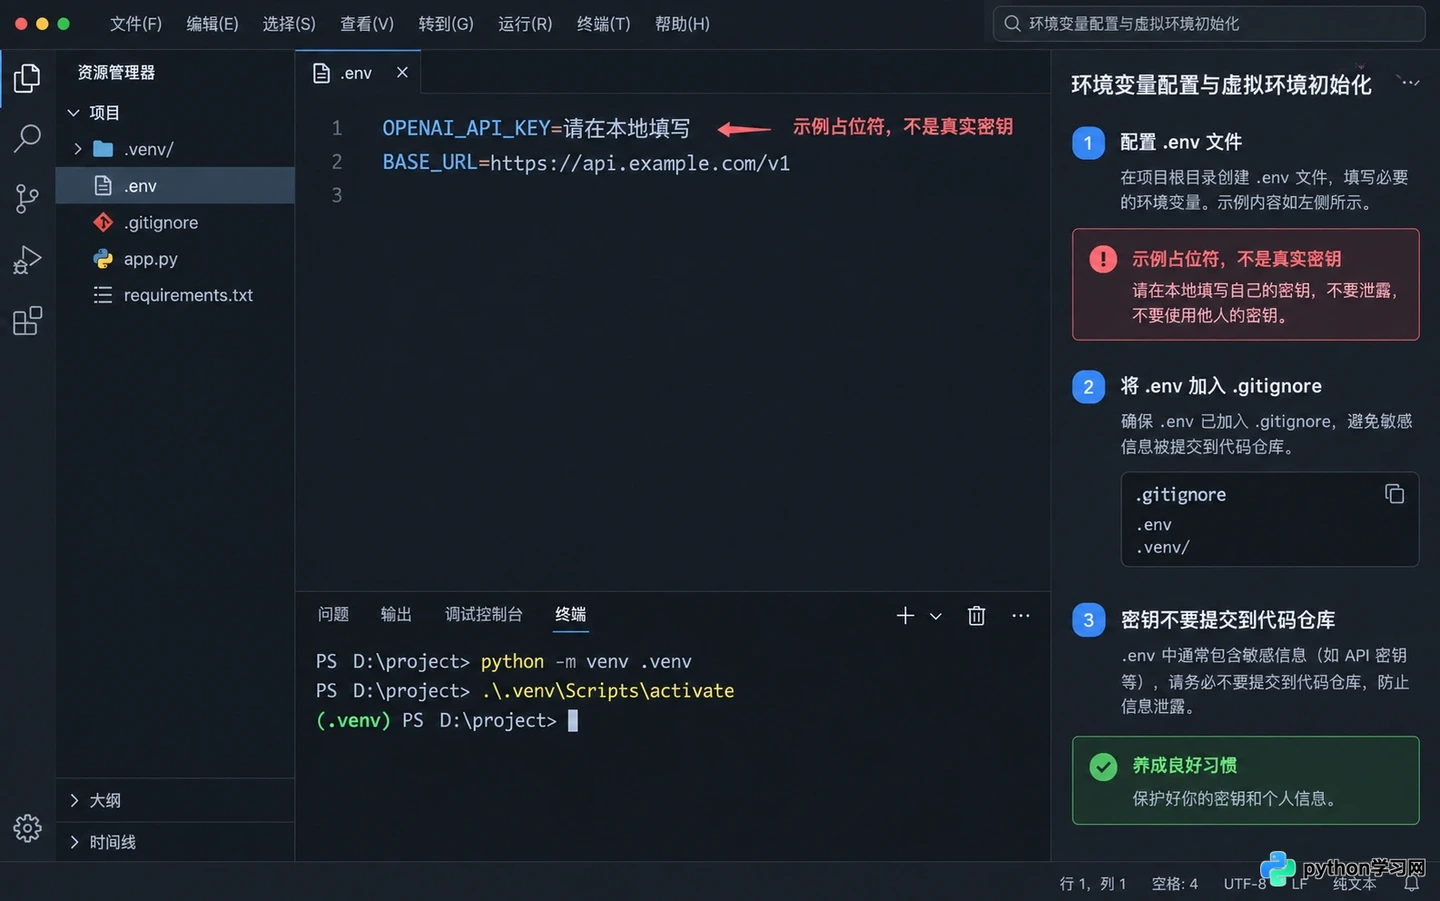
本文摒弃复杂的模型训练理论,聚焦于应用层开发。通过梳理环境配置、密钥管理与基础代码逻辑,帮助开发者快速构建第一个基于大语言模型API的Python应用,理解提示词工程与程序逻辑的结合点。
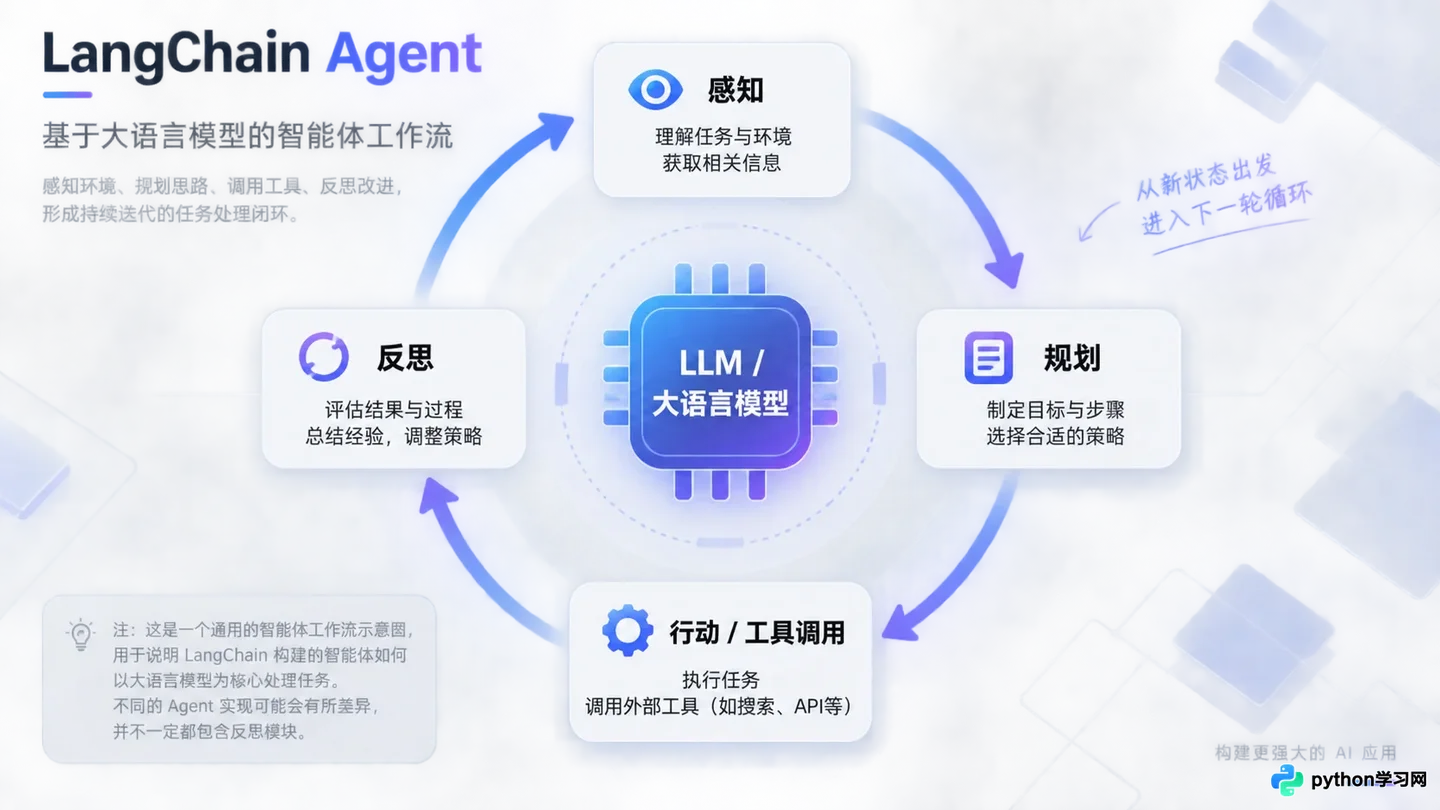
本文通过实战代码演示如何使用LangChain框架构建具备自主规划能力的AI智能体。重点讲解ReAct模式的原理,以及如何将搜索、计算等外部工具集成到智能体中,使其能够根据用户意图自动拆解任务并执行多步操作。
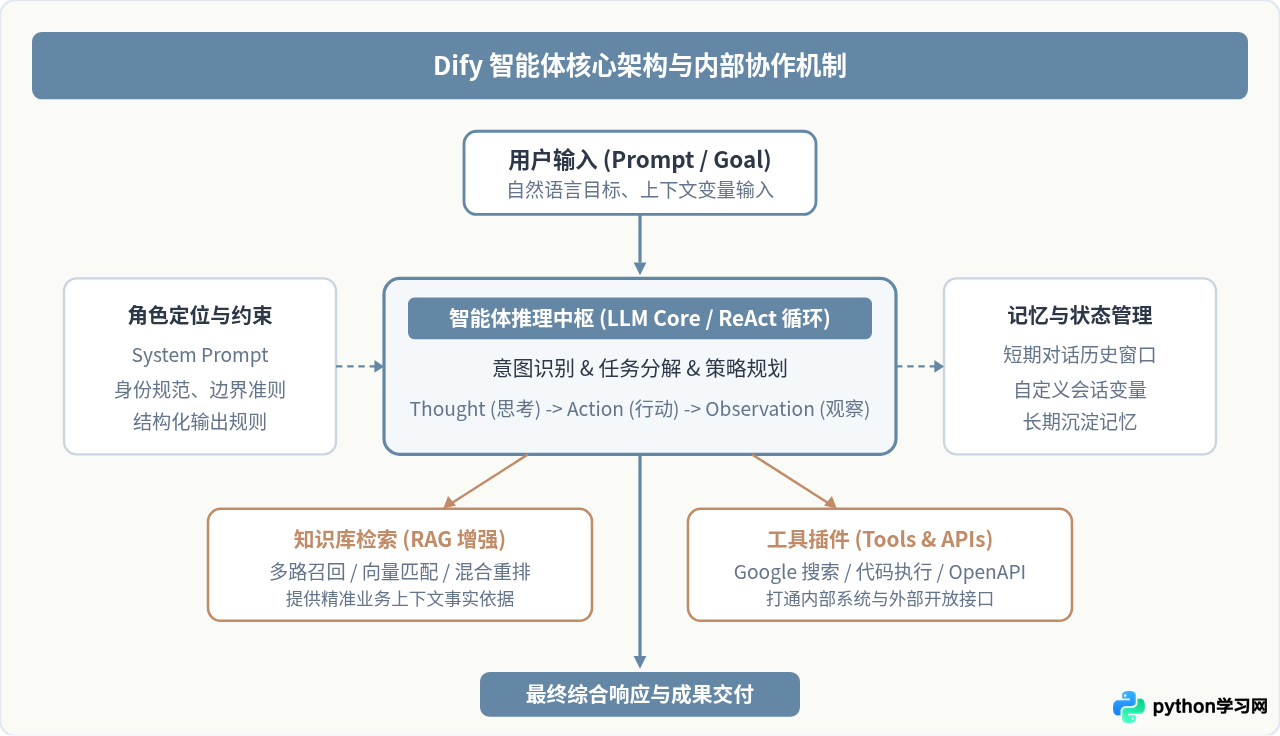
深入解析 Dify 智能体的核心概念、内在运行机制、核心功能模块、零代码搭建实操流程以及四大典型落地场景,帮助读者全面理解并掌握基于 Dify 的智能体构建与应用。
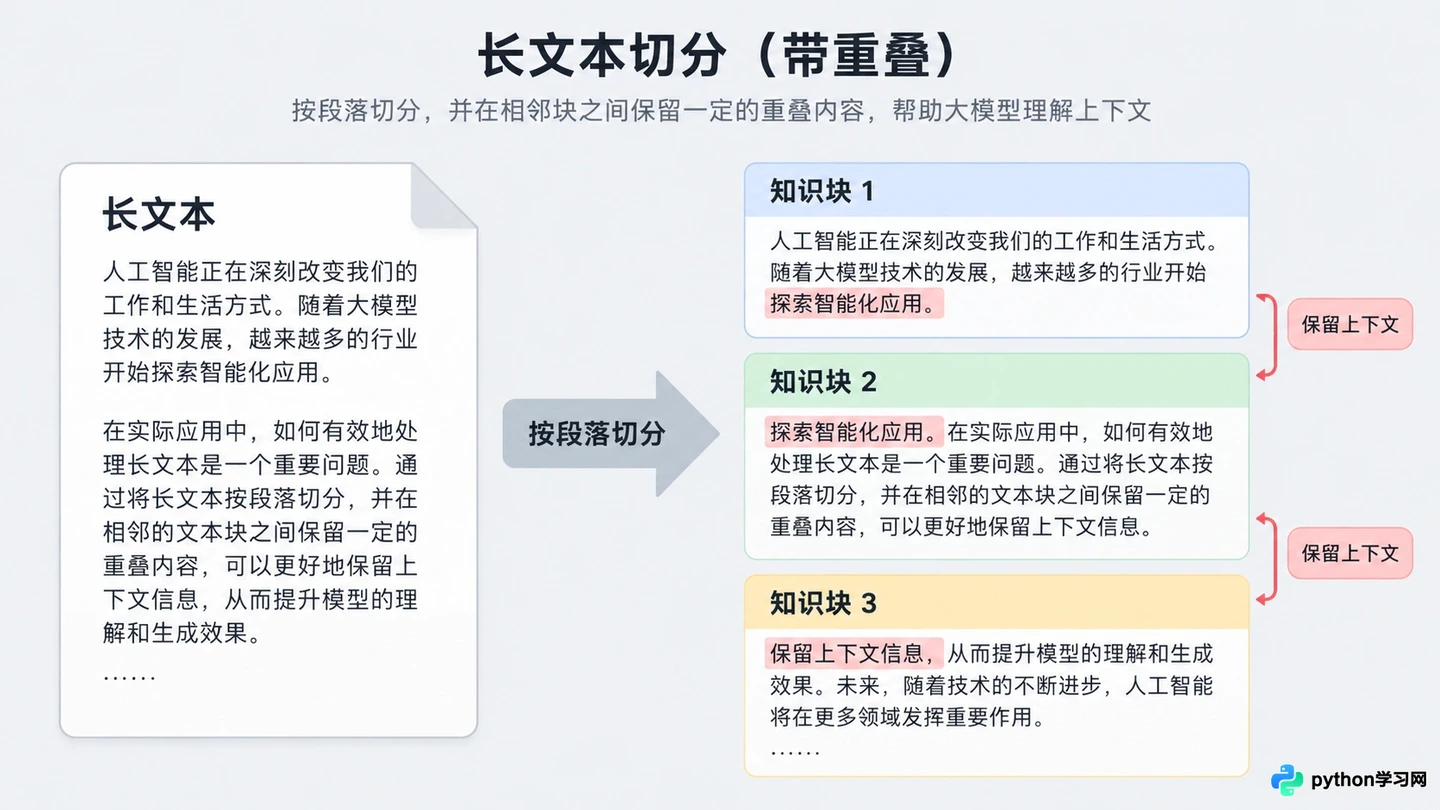
本文详解如何从零构建RAG系统,涵盖文本切片策略、向量数据库选型与接入、以及检索优化技巧,帮助开发者快速落地基于私有数据的问答应用。
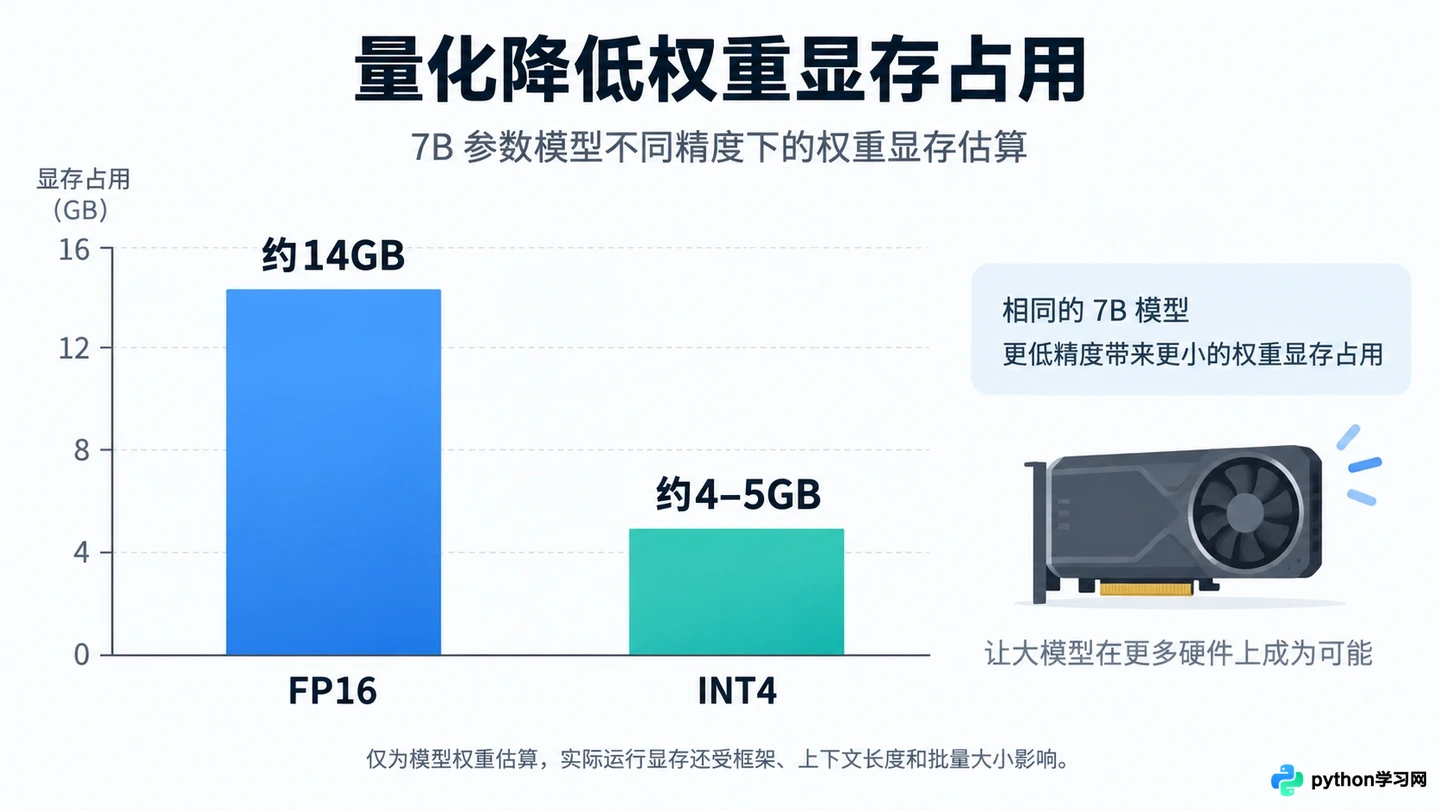
针对企业对数据安全的顾虑,本文探讨如何通过开源模型本地化部署构建私有知识库。内容涵盖从硬件选型、模型量化到RAG架构中的权限隔离策略,帮助技术团队在合规前提下落地大模型应用,避免敏感数据外泄风险。
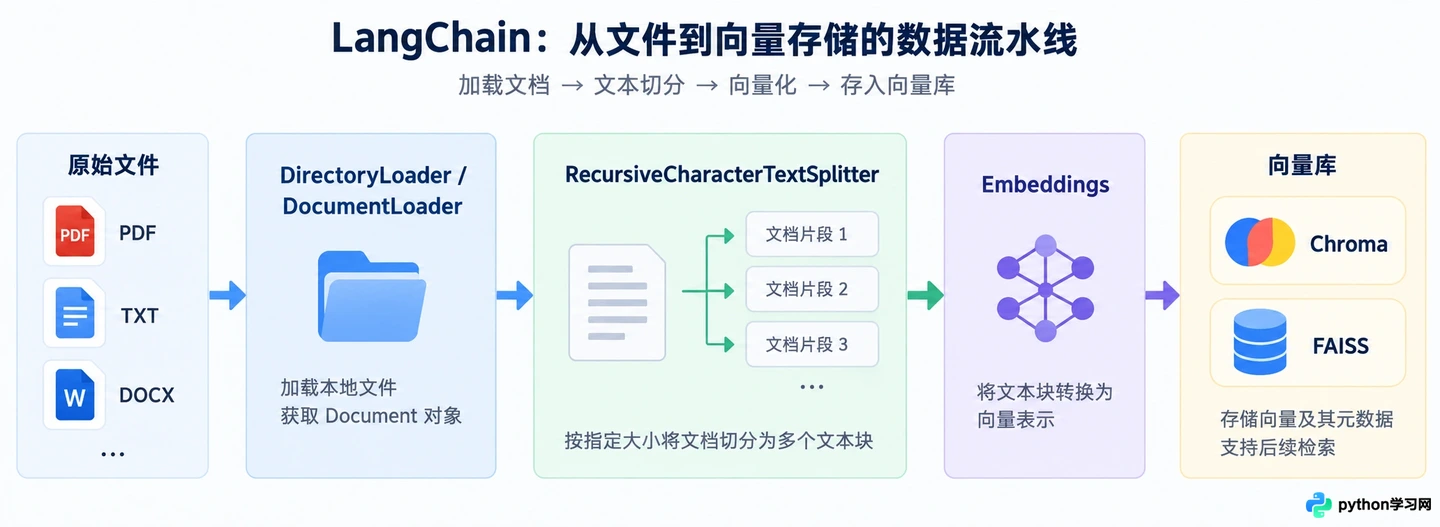
本文详解如何在LangChain和LlamaIndex两大主流框架中接入自定义数据源,构建高效的RAG知识库。涵盖从数据加载、文本分割到向量存储的关键步骤,帮助开发者快速实现私有数据的检索增强生成。
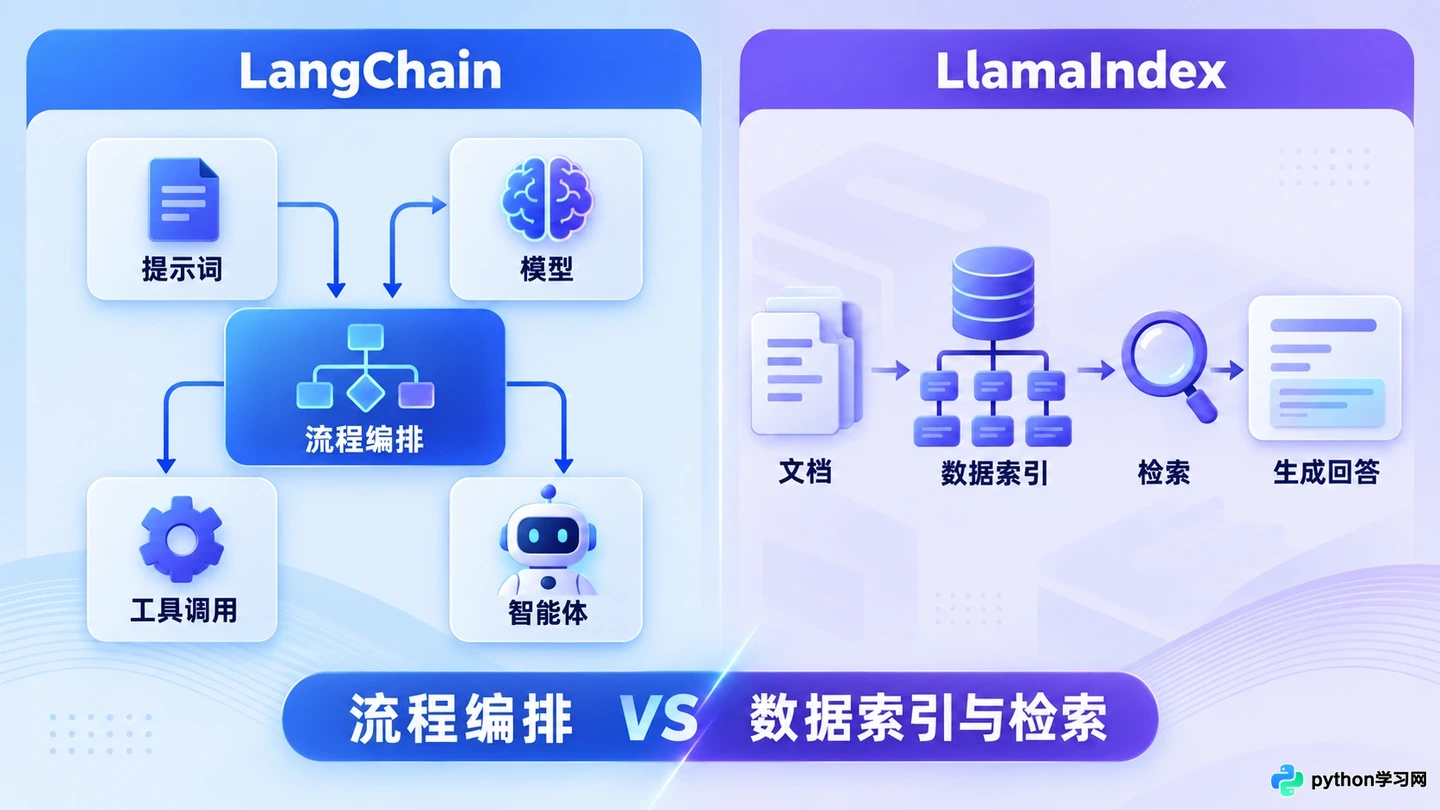
本文深入对比LangChain和LlamaIndex两大主流大模型应用开发框架,从核心设计理念、数据索引能力、生态灵活性及适用场景四个维度进行分析,帮助开发者根据项目需求做出精准的技术选型。