Python爬虫实战:从页面解析到基金基本信息抓取
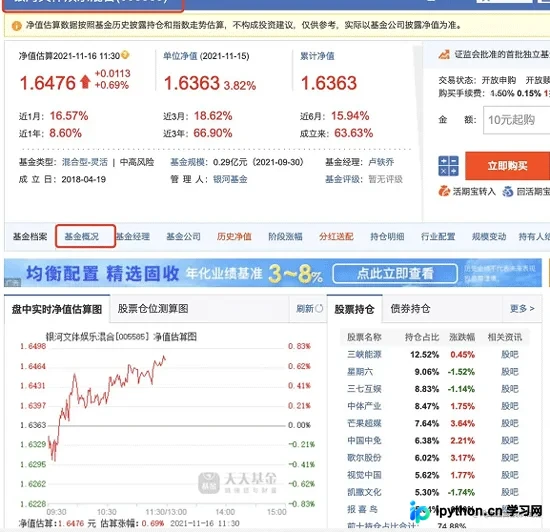
本文详细讲解如何使用Python爬虫获取基金基本信息。针对XPath定位失效的情况,文章演示了如何利用BeautifulSoup库解析HTML页面,通过定位table和td标签提取基金公司、经理、成立时间等关键数据,并展示最终代码实现与结果输出。
10-16
7




本文详细讲解如何使用Python爬虫获取基金基本信息。针对XPath定位失效的情况,文章演示了如何利用BeautifulSoup库解析HTML页面,通过定位table和td标签提取基金公司、经理、成立时间等关键数据,并展示最终代码实现与结果输出。
本文详细介绍Python中requests-html库的安装与核心用法。该库基于requests封装,支持CSS选择器与XPath定位,并能通过Chromium引擎执行JavaScript实现动态页面爬取。文章涵盖元素提取、分页处理及源码解析,帮助开发者快速掌握现代网页数据抓取技巧。
本文介绍在Python爬虫中获取非唯一指定内容的方法。当XPath无法直接定位目标时,可通过遍历节点并结合条件判断进行筛选。文章提供基于urllib和lxml的完整代码示例,展示如何构建请求、解析HTML并过滤关键词,同时指出原代码存在冗余问题,旨在为开发者提供清晰的筛选逻辑参考。
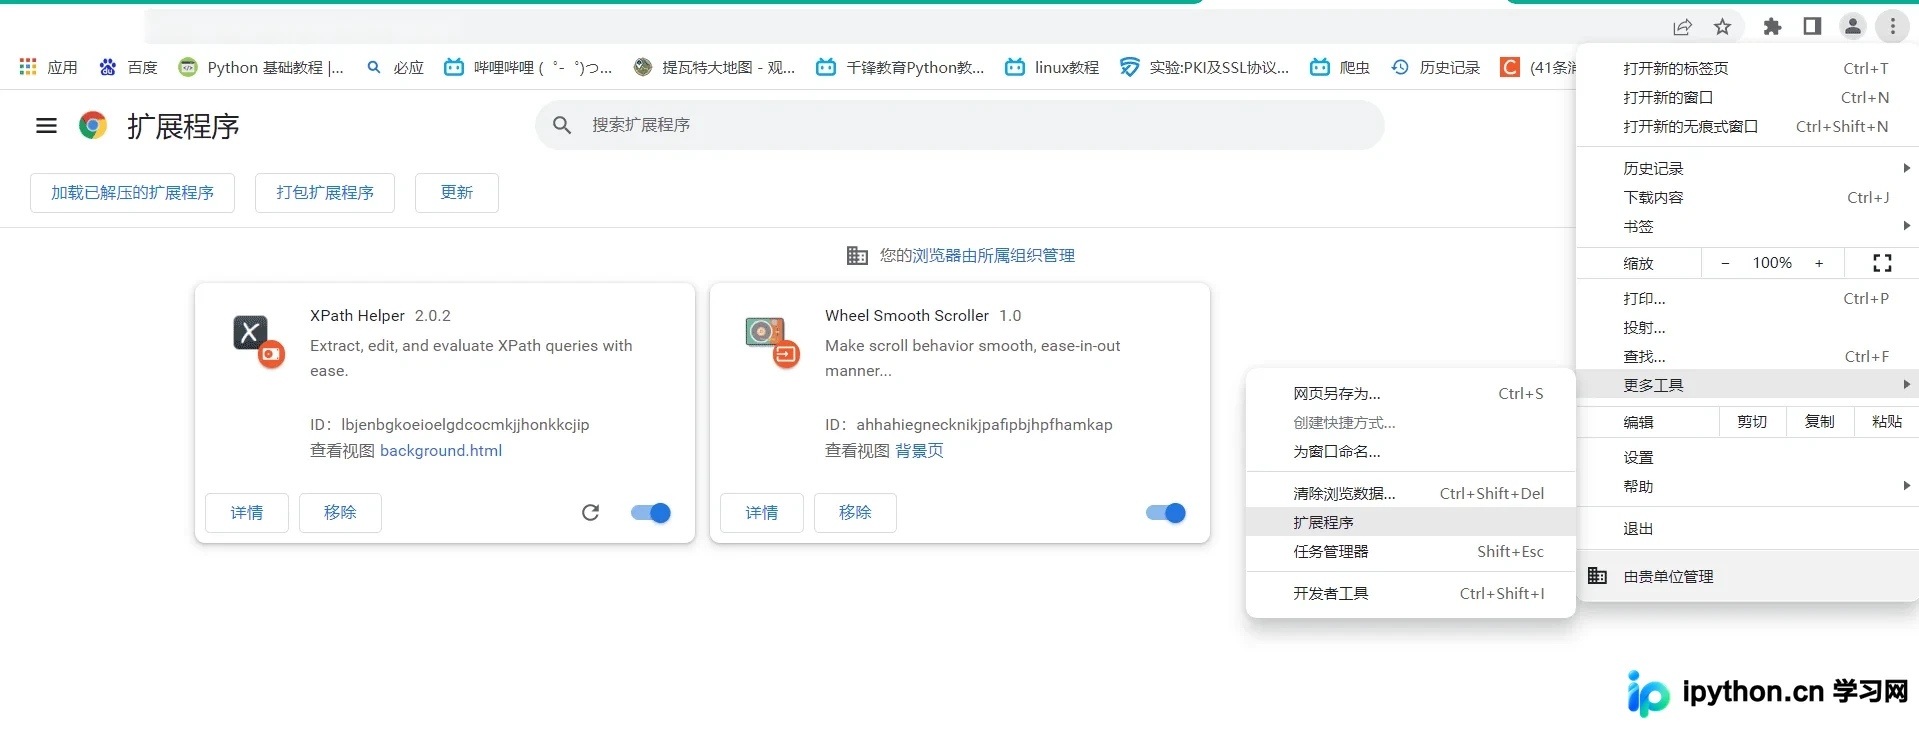
本文详细介绍Python爬虫中如何使用Beautiful Soup模块快速定位网页元素。涵盖模块安装、基础用法、四大核心对象(BeautifulSoup、Tag、NavigableString、Comment)解析,以及find与find_all方法的参数详解与实战代码示例,帮助初学者掌握高效的数据提取技巧。
本文详解Python爬虫中如何使用lxml库结合XPath技术高效提取网页局部内容。涵盖XPath基础语法、谓词与属性查询,以及lxml库在PyCharm中的安装配置。通过本地文件解析、服务器响应处理及百度关键词搜索等完整代码示例,展示从数据抓取到节点定位的全过程,帮助开发者快速掌握精准数据提取技巧。
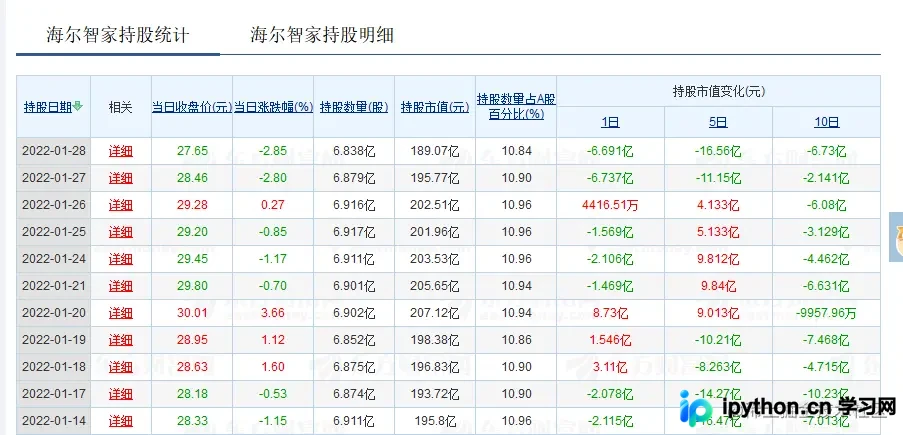
本文详细介绍如何使用Python爬虫技术抓取东方财富网北上资金逐日持仓数据。通过逆向分析API接口参数,利用requests库获取JSON数据,并结合prettyTable进行格式化展示。此外,文章还构建了一个简单的线性筛选模型,用于识别近期连续加仓且幅度超过流通股份1%的股票,为量化分析提供基础参考。
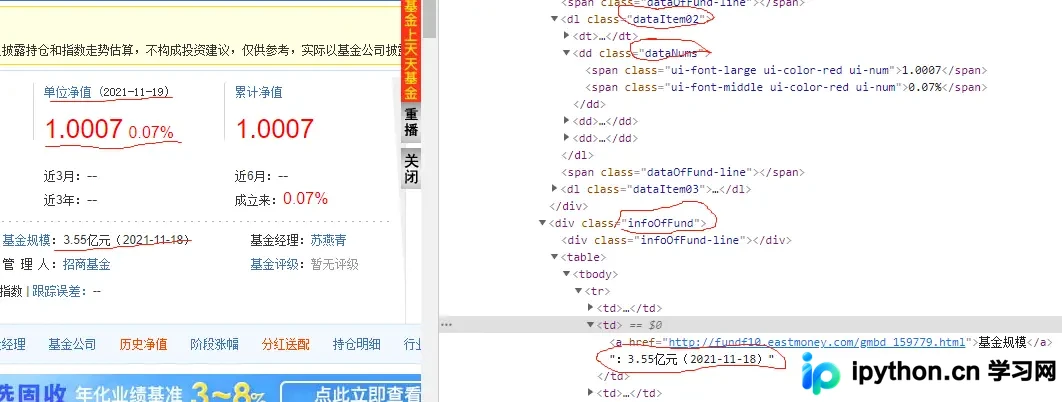
本文详解如何使用Python爬虫获取基金最新交易日的单位净值、涨跌幅及基金规模数据。通过解析HTML标签定位关键信息,并结合pymysql库进行数据库连接配置与SQL操作,实现数据的结构化存储,为后续基金分析与投资决策提供数据支持。
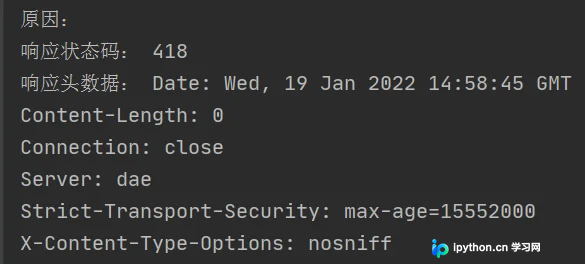
本文详解Python爬虫中的三大核心要素:IP代理(透明、匿名、高匿)用于规避频率限制;Cookie机制解决HTTP无状态问题,通过MozillaCookieJar实现持久化存储;以及urllib.error模块对URLError和HTTPError的捕获与属性解析,帮助开发者构建稳定的网络请求程序。
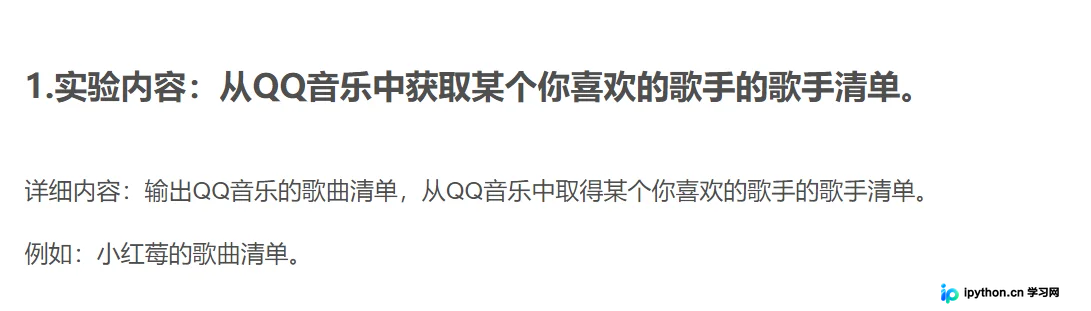
本文介绍如何使用Python语言结合requests和json库,从QQ音乐网站抓取指定歌手的歌曲清单。通过解析网页请求头、分析API参数及编写自动化脚本,实现以CSV格式输出歌曲数据。文章包含详细操作步骤、完整代码示例及运行结果分析,帮助开发者掌握基础的网络爬虫技能。
本文详细介绍如何利用Python的Requests库发送HTTP请求获取网页源码,并结合BeautifulSoup解析HTML结构以提取特定标签数据。通过分步示例,演示从环境配置、单页抓取到多页循环爬取的完整流程,帮助开发者快速掌握基础爬虫技术。
本文介绍如何使用Python抓取第三方网站的阿里云盘资源,并通过解析网页获取资源名称、日期及链接。脚本自动按时间降序排列结果,解决原网站排序混乱问题。同时,利用模板生成可直接访问的HTML报告,提升使用便捷性。
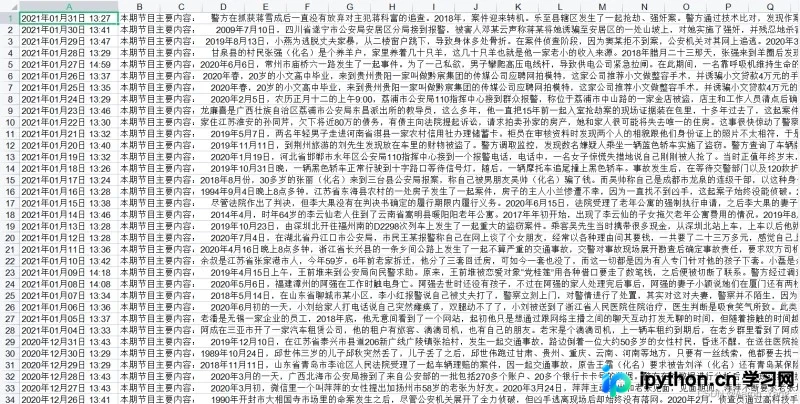
本文介绍使用Python爬取CCTV《今日说法》节目数据的方法。通过调用CCTV视频API接口获取每期节目的时间与简介,利用requests库发起请求,并结合xlwt库将结果保存为Excel文件。文章提供了完整的代码示例,展示了如何解析JSON数据并处理分页逻辑,适合希望学习基础爬虫技术的数据爱好者参考。