



很多 SQL 注入并不是扫一遍就能下结论,真正决定是否成立的,往往是请求改动后响应有没有出现稳定、可解释的差异。用 Burp Suite 做验证时,比较稳妥的路径是先在 Repeater 里确认参数是否可控,再判断是 Union-Based 还是盲注,最后配合 Intruder 做批量验证,同时把 Scanner 的结果当作线索而不是终点。
用 Repeater 手动确认注入点
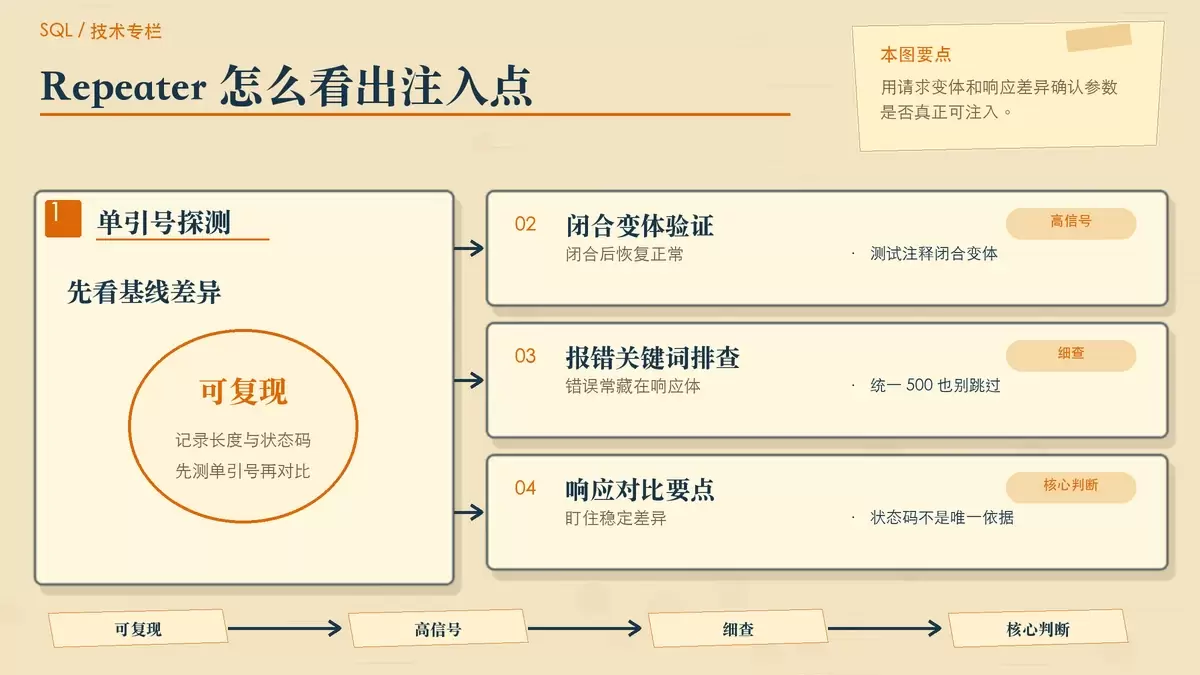
先别急着开 Scanner。遇到可疑参数,优先把请求送进 Repeater,单独观察输入变化是否会引起响应差异。这里不能只盯着报错,还要同时看响应长度、HTTP 状态码以及页面内容结构有没有变化。
- 把目标请求,比如
GET /user?id=1,右键后选择Send to Repeater - 先在
id参数后加一个单引号:id=1',发送后记录响应长度和状态码 - 再尝试几种闭合变体:
id=1'-- -、id=1" -- -、id=1') -- -,对比页面是否恢复“正常” - 如果
id=1' -- -返回 200 且内容完整,而id=1'返回 500 或空白页,通常说明后端 SQL 语句被截断,而且异常没有被妥善处理,这是比较典型的可利用信号
这一步的核心判断标准是:同一个参数在不同输入下,响应是否出现了稳定且可重复的差异。如果差异只偶尔出现,很可能是页面本身波动;如果每次都能复现,就值得继续深挖。
另外,有些应用即使报错也会统一返回 500,这时不要只看状态码。应切到 Repeater 的 Response 标签页逐行查看,留意像 MySQL、ORA-、syntax error 这类数据库或语法错误关键词。很多时候,漏洞线索就藏在响应体里,而不是直接显示在页面上。
判断是 Union-Based 还是盲注
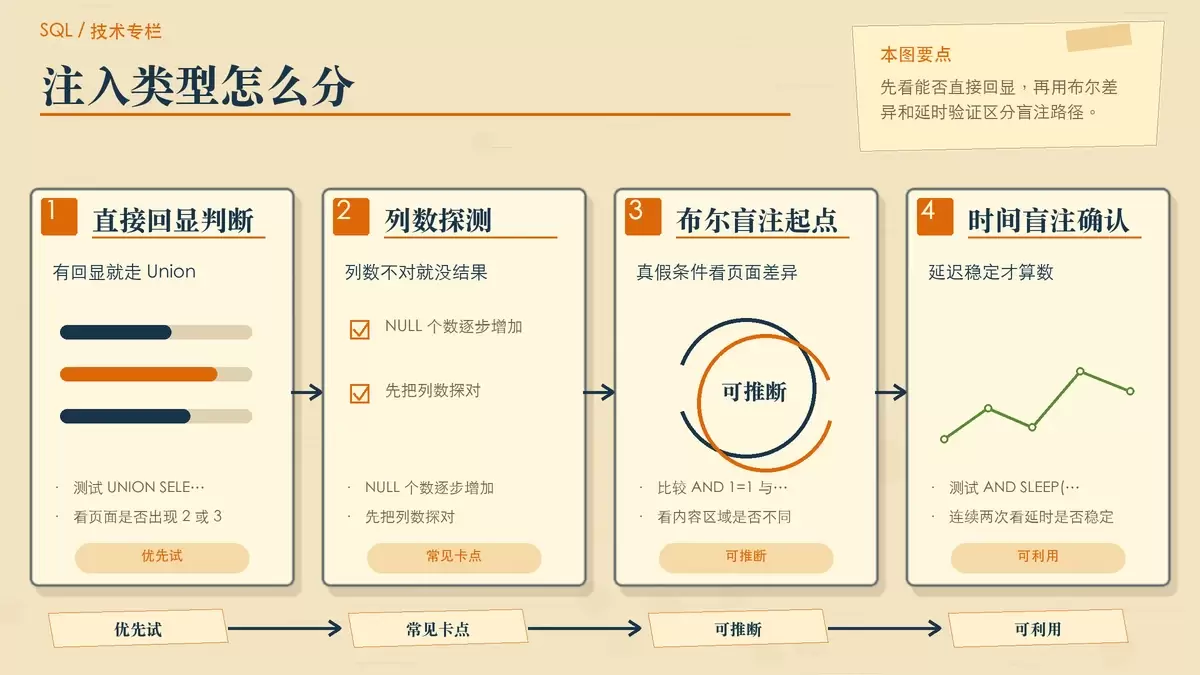
确认参数可能存在注入后,下一步要分清注入类型。思路很直接:如果能让后端把查询结果直接回显到页面上,通常就是 Union-Based;如果页面不直接显示数据,只能通过真假条件或时间变化推断结果,那就是盲注。
先试是否存在直接回显
- 先测试:
id=1 UNION SELECT 1,2,3-- - - 如果页面某个位置出现了
2或3,说明列数匹配成功,而且存在可回显位置,可以继续走 Union 路径
这里最容易卡住的是列数不匹配。页面没反应,不一定说明没有 Union 注入,可能只是 SELECT 的列数写错了。
列数探测不要跳过
遇到没有回显的情况,先用 UNION SELECT NULL,NULL,NULL 这种形式逐步增加 NULL 的个数,直到请求不再报错。只有列数正确,Union 语句才有机会成功执行。很多新手以为“没显示就是没洞”,其实只是卡在了列数探测上。
没有回显时看布尔与延时差异
- 如果页面对
id=1 AND 1=1和id=1 AND 1=2的返回内容明显不同,比如一个有用户头像,另一个只剩空白div,这通常就是布尔盲注的起点 - 再测试
id=1 AND SLEEP(3),在 Repeater 中连续发两次,观察响应时间是否稳定延迟 3 秒以上
如果布尔差异成立,说明可以通过真假条件做逻辑推断;如果延时也稳定成立,说明目标还支持时间盲注。两者都能说明参数可利用,只是后续利用方式不同。
用 Intruder 跑布尔盲注 Payload
布尔盲注的本质是不断向后端“提问”,看返回结果是“真”还是“假”。Repeater 适合单次验证,到了需要批量测试字符、位置或条件时,Intruder 才更高效。重点不在 Payload 写得多复杂,而在于你能否让响应差异足够明显,并且能被自动识别。
- 先在 Repeater 中选中要测试的参数值,比如
1,点击Add §标记位置 Payload type选择Simple list- 加入两个基础 Payload:
AND SUBSTRING((SELECT password FROM users WHERE id=1),1,1)='a'和AND SUBSTRING((SELECT password FROM users WHERE id=1),1,1)='b' - 进入
Options → Grep-Match,填入可区分响应的关键词,例如Thank you或invalid - 勾选
Make browser match highlight,请求发完后直接查看哪一行被高亮,对应的那条通常就是真条件 Payload
这套方法的价值在于,它把原本需要手工逐条对比的过程,变成了可批量观察的结果列表。只要真假条件能在响应中留下稳定痕迹,就能持续往后枚举更多字符和位置。
实际操作里,很多人会习惯直接看 Length 列排序,但这一步并不总可靠。页面如果有动态渲染、广告位、时间戳或个性化内容,响应长度可能会自然波动,导致真假条件混在一起。这种情况下,优先使用 Grep-Match 抓固定关键词,或者用 Compare 模块人工比对两组响应的 DOM 结构差异,通常更稳。
为什么 Scanner 经常漏报
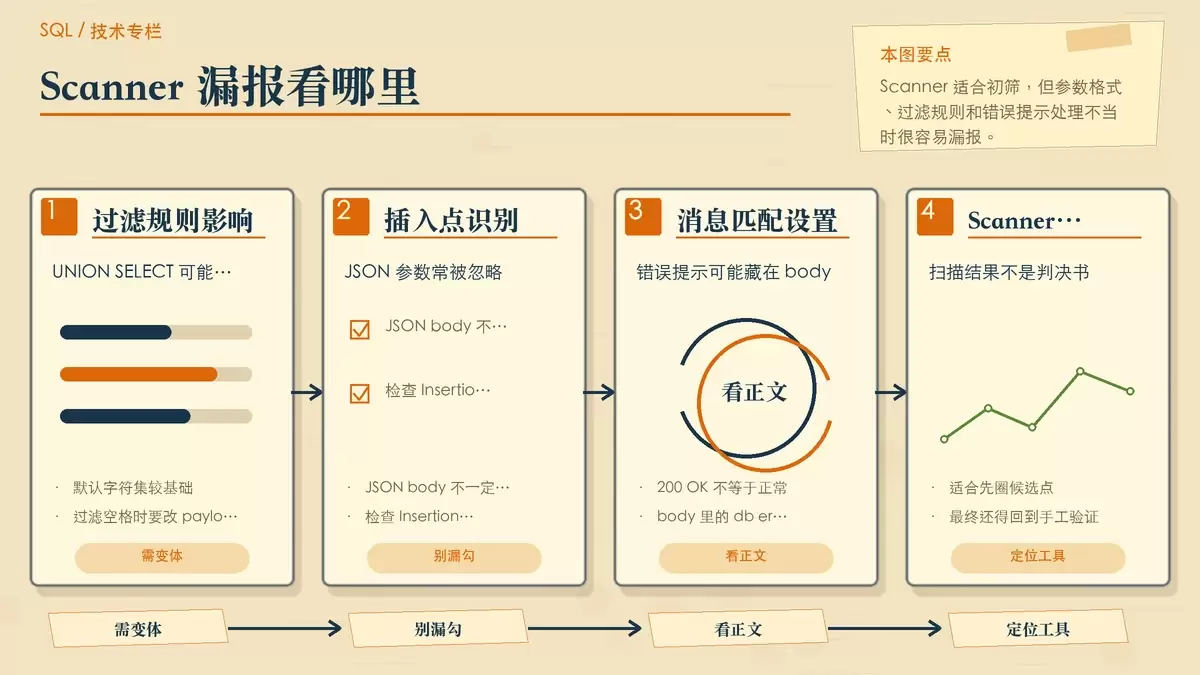
Scanner 的作用更像是初筛工具,而不是最终判定器。它确实能帮你快速找出一批可疑点,但遇到稍复杂的场景,漏报非常常见。常见原因大致有三类:WAF 拦截、应用层异常处理、以及参数上下文没有正确识别。
- 默认 Scanner 多半只尝试
'、"、;这类基础字符;如果目标会过滤空格,像UNION SELECT这样的语句可能直接失效,这时就需要到Scanner Options → Payloads里手动增加UNION/**/SELECT之类的变体 - 如果目标使用 JSON 传参,例如
{"id":1},Scanner 默认未必会把它当作插入点处理,需要在Insertion Points中勾选JSON parameter values - 有些 API 虽然始终返回
200 OK,但响应体里写着{"success":false,"msg":"db error"},这种情况 Scanner 可能会忽略,需要开启Grep for messages并加入db error这类提示词
所以,扫描器没有报出来,不代表漏洞不存在;它只是没有准确理解这个参数是如何进入后端查询逻辑的。真正可靠的验证,仍然要回到 Repeater 的手工确认和 Intruder 的定向测试上。Scanner 适合帮你圈出候选目标,但不能代替最终判断。
一套更稳妥的验证顺序
如果要把这篇文章的方法落到实际操作,可以按下面的顺序来判断:
- 先用 Repeater 对单引号、闭合变体、布尔条件和延时语句做单点测试,确认响应差异是否稳定存在。
- 再判断有没有直接回显,能回显就优先尝试 Union-Based,不能回显就转向布尔盲注或时间盲注。
- 需要批量验证时,把已经确认有效的条件搬到 Intruder,用
Grep-Match或结构对比放大真假差异。 - 最后再回头利用 Scanner 做补充筛查,并按目标的参数格式、过滤规则和报错方式调整扫描选项。
这样做的好处是,判断链路更清楚:你知道自己是因为哪一个输入、哪一种响应变化,才认定这里存在 SQL 注入,而不是只凭一次扫描结果下结论。对于漏洞验证来说,这种可复现、可解释的过程,往往比“扫到了一个高危”更重要。















