



很多慢查询并不是数据量突然变大,而是 JOIN 条件里多写了一个函数、一次类型转换,执行计划就完全变了。判断这类问题时,关键不是盯着“函数快不快”,而是看它是否改写了字段原值、破坏了索引匹配,或者让优化器失去可用的判断依据。本文按几类最常见场景拆开分析,顺着执行计划的思路看清为什么会慢,以及应该怎么改。
JOIN 条件一旦包函数,索引通常就用不上了
最典型的问题,就是在 JOIN 条件里直接对字段做函数处理。例如:
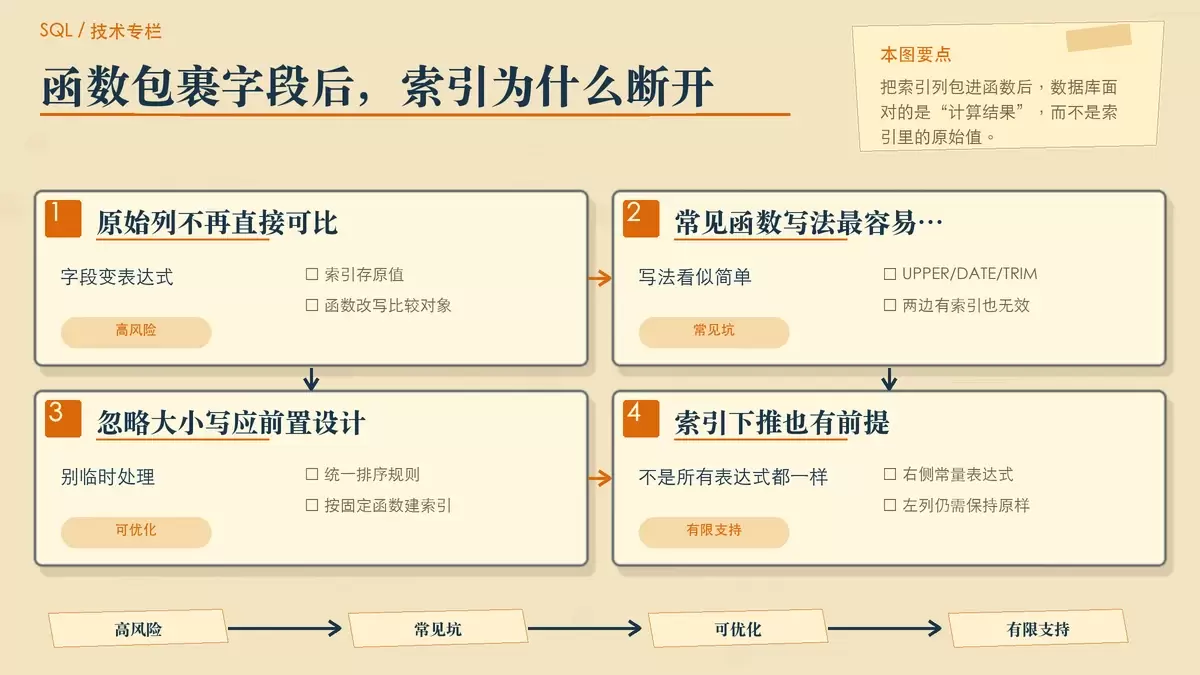
ON UPPER(a.code) = UPPER(b.code)这类写法看上去只是为了统一比较规则,但对数据库来说,字段原始值已经被改写,优化器无法再按已有索引定义去匹配。结果通常不是走高效索引访问,而是退化成全表扫描,或者全索引扫描后再逐行计算。
这也是为什么即使 a.code 和 b.code 两边都建了索引,查询依然可能很慢。索引存的是原始列值,而不是函数计算后的结果;一旦你在列外面包了函数,数据库就很难直接利用现成索引。
常见的高风险写法包括:
DATE(created_at) = DATE(updated_at)CONCAT(a.first, a.last) = b.fullnameTRIM(c.name) = d.name
如果需求只是大小写不敏感比较,更稳妥的做法是统一字符集和排序规则,而不是在 JOIN 时临时调用函数。原文提到,MySQL 中可以考虑使用 COLLATE utf8mb4_0900_as_cs,或者直接建立函数索引:
CREATE INDEX idx_lower_name ON users ((lower(name)))不过函数索引也不是万能的,它只对固定函数表达式有效。换句话说,索引建在 lower(name) 上,并不等于其他写法也能自动受益。
还有一个容易混淆的点是:并不是所有表达式都会完全挡住索引。比如 MySQL 5.7+ 对 DATE_SUB(b.dt, INTERVAL 1 DAY) 这类右侧常量表达式,支持一定程度的索引下推,但前提仍然是左侧字段本身没有被函数包裹。真正敏感的是“把索引列本身变成一个表达式”。
隐式转换会把简单 JOIN 变成逐行计算
有些 SQL 看起来没写函数,但执行时一样会产生“每行都在算”的问题。典型例子是:
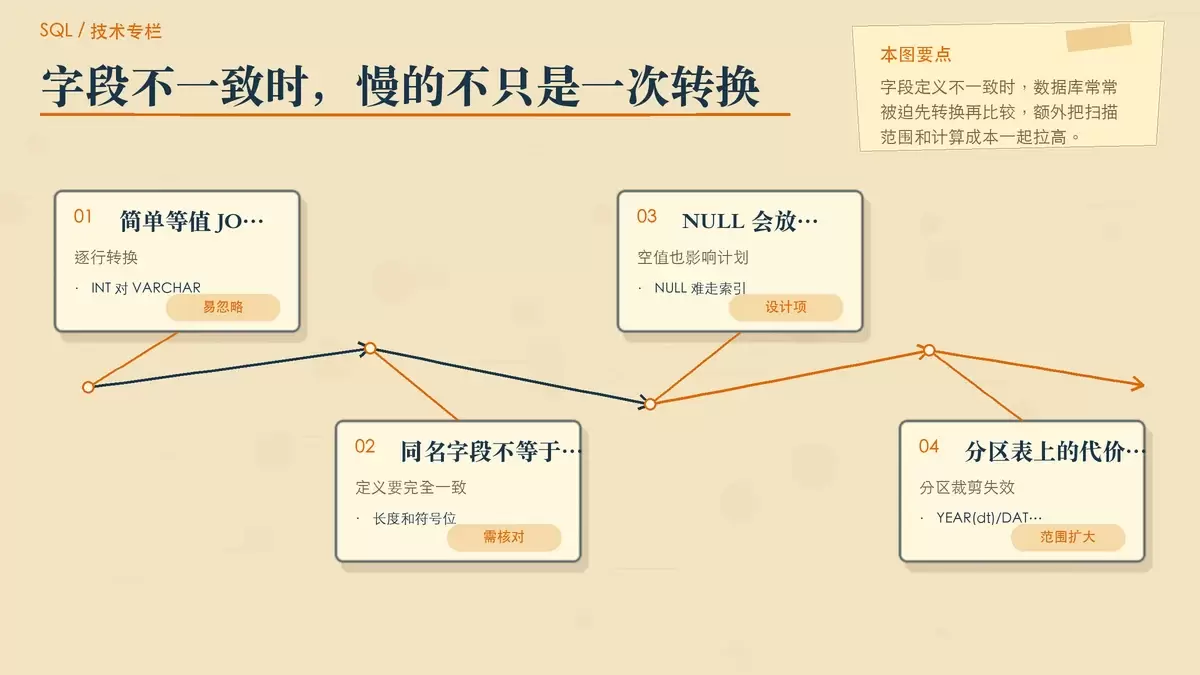
ON a.user_id = b.uid如果 a.user_id 是 INT,而 b.uid 是 VARCHAR,数据库就必须先把一侧转换成另一侧可比较的类型。在 MySQL 里,常见情况是把整列 b.uid 转成数字再比较。这样一来,原本应该直接用索引定位的 JOIN,变成了逐行转换、逐行比对。
这类问题之所以隐蔽,是因为 SQL 能执行、结果也未必错,但代价会直接落在 CPU 和扫描范围上。如果再叠加字符集或排序规则不一致,例如 utf8_general_ci 和 utf8mb4_0900_ai_ci 混用,还可能触发额外转换,进一步放大开销。
排查时,不要只看字段名是否“语义一致”,而要确认定义是否完全一致。可以先用:
SHOW CREATE TABLE重点检查这些细节:
- 字段类型是否一致,例如
INT对VARCHAR - 长度是否一致,例如
VARCHAR(20)对VARCHAR(50) - 符号性是否一致,例如
SIGNED与UNSIGNED - 字符集和排序规则是否一致
NULL 也是 JOIN 里经常被低估的问题。原文指出,NULL 值在 JOIN 条件中基本无法走索引;如果业务允许,使用默认值,比如 0 或 'unknown',通常比保留空值更可控。这不只是语义设计问题,也会直接影响可优化性。
对于分区表,影响会更明显。如果分区键是 dt,但 JOIN 或过滤条件写成 YEAR(dt)、DATE(dt) 这类形式,数据库往往无法完成分区裁剪,结果不是访问必要分区,而是把几十个无关分区也一起扫过去。
标量函数真正拖慢的,是上下文切换和成本失真
另一个高频误区,是把业务逻辑封装进标量函数,然后在 SELECT 或 ON 子句里调用。例如:
dbo.CalculateTax(@Amount)问题不只是“多执行了一个函数”,而是每一行数据都可能触发一次上下文切换:SQL 引擎切到函数运行环境,执行结束后再切回来。数据量一上来,百万行就意味着百万次切换,CPU 利用率很容易明显升高。
更麻烦的是,优化器往往把这类自定义标量函数当成黑盒,无法准确估算它的执行代价,也无法像处理普通表达式那样灵活重排计划。结果就是执行计划可能从一开始就选错路径,后面再怎么跑都慢。
几种特别容易放大代价的情况包括:
- 函数内部还嵌套查询,比如再去查税率表,会把 I/O 开销一起带进来
- 非确定性函数如
GETDATE()、NEWID(),会阻止结果缓存,每次都得重新计算 - 原本只是简单公式,却被包装成函数,白白增加调用成本
如果逻辑只是类似 @Amount * 0.1 这样的简单运算,直接写在 SQL 表达式里更合适。复杂一些的逻辑,也优先考虑用 CTE 或临时表先预计算,再参与 JOIN,而不是把所有成本都压到逐行函数调用上。
OR 条件和复杂表达式,常常让优化器直接放弃索引
除了函数本身,JOIN 条件里的复杂表达式也会让索引利用率急剧下降。典型例子是:
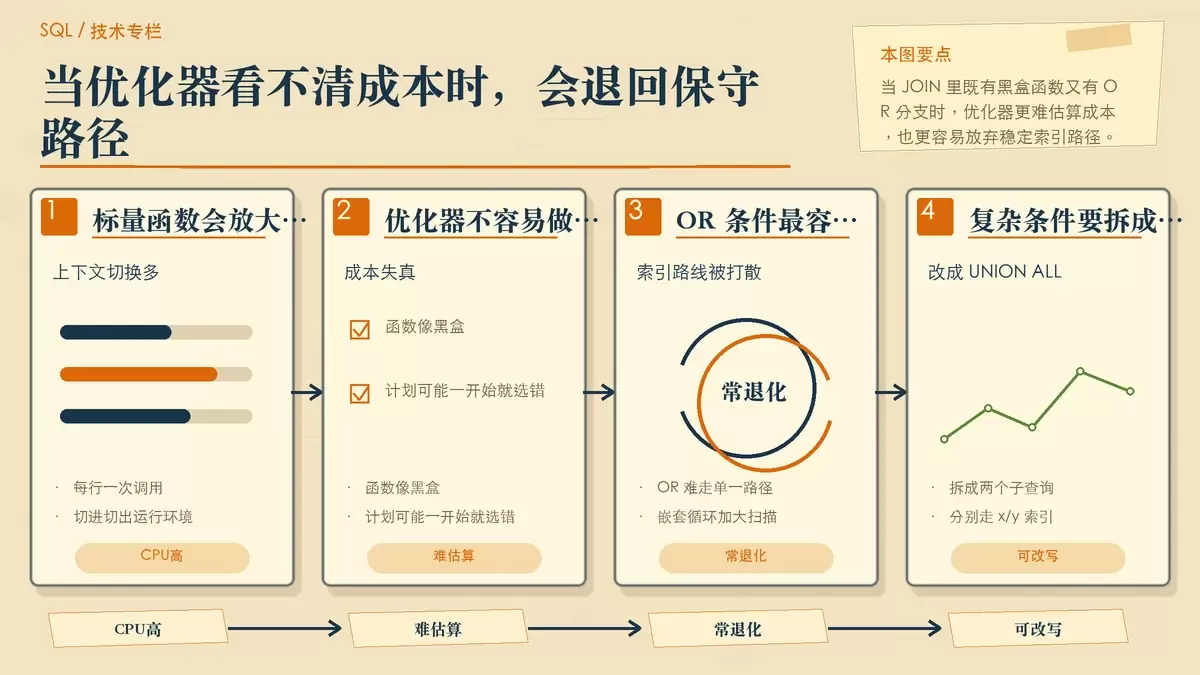
ON b.x = a.x OR b.y = a.y这种写法的问题在于,优化器很难为 OR 选择一条稳定、单一的索引访问路径。结果在大多数数据库里,都会倾向于放弃理想索引方案,退化成嵌套循环加大范围扫描。
更实用的改法,是把一个复杂 JOIN 拆成两个可预测的分支,再用 UNION ALL 合并。例如分别基于 b.x = a.x 和 b.y = a.y 做两个子查询,各自走各自的索引路径。前提是 b.x 和 b.y 都有单列索引,或者有以它们为前导列的复合索引。
同类问题也出现在时间表达式上。比如:
ON a.created_at + INTERVAL '1 day' = b.event_time这里左侧字段被表达式包裹,优化器更难下推索引。改写成右侧计算,通常更有机会命中索引:
ON a.created_at = b.event_time - INTERVAL '1 day'关键原则还是一样:尽量让索引列保持“原样参与比较”,不要把它变成临时计算结果。
判断 JOIN 为什么慢,可以先抓这四个点
回到开头那个问题,慢的并不是函数这个语法动作本身,而是它带来的连锁反应:索引失效、隐式计算、分区裁剪失效、优化器误判成本。这些问题叠加后,JOIN 的执行方式就会从“按索引定位”退回到“大量扫描后再逐行判断”。
实际排查时,可以优先从四个方向判断:
- JOIN 字段是否被
UPPER()、DATE()、TRIM()之类函数包裹 - 两边字段类型、长度、符号位、字符集、排序规则是否完全一致
- 是否存在标量函数、自定义函数或非确定性函数的逐行调用
- 是否写了
OR条件、时间表达式或会破坏分区裁剪的复杂条件
如果这几项里命中两到三项,执行计划变差基本就不意外了。写 JOIN 时,最稳妥的原则始终是:让索引列保持原始形态参与比较,把清洗、格式化、预处理尽量前移到入库、预计算或中间结果阶段完成。















