


数据库全文检索引擎:Elasticsearch与MySQL FULLTEXT

全文检索基础与两种方案定位
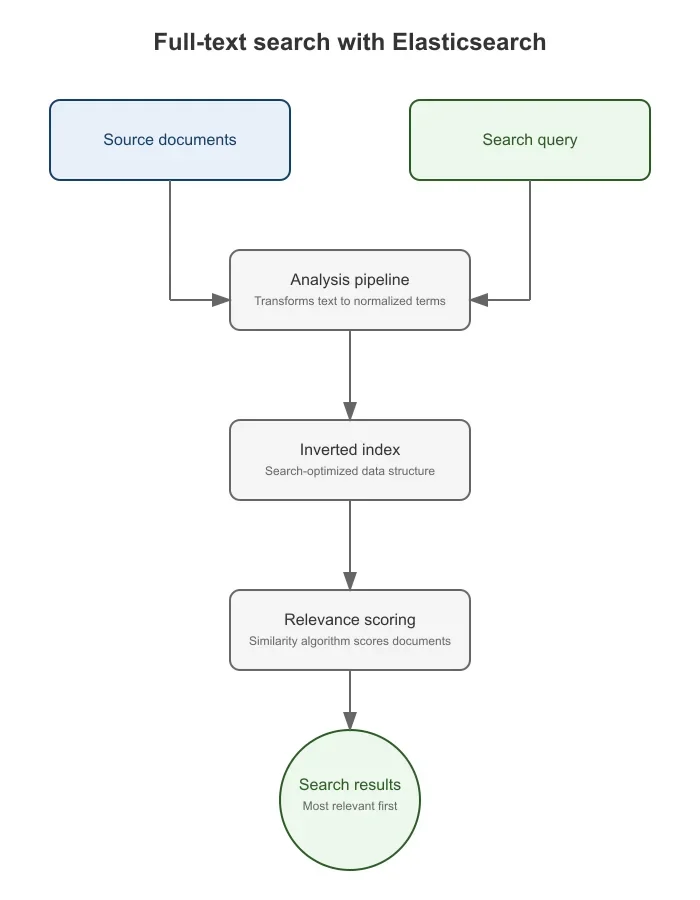
全文检索与传统 LIKE '%keyword%' 查询的本质区别在于底层数据结构与匹配逻辑。LIKE 依赖全表扫描或B+树前缀匹配,无法处理词序、相关性排序及复杂语义,性能随数据量线性下降。全文检索的核心是倒排索引(Inverted Index),它将文档内容按词元(Token)拆分,建立“词元→文档ID列表”的映射关系,查询时直接定位词元并快速合并结果,天然支持相关性打分(如TF-IDF/BM25)。Elasticsearch 基于 Lucene 构建,采用分布式架构,原生支持分片、副本、丰富的分析器与聚合能力,适合海量数据、高并发、复杂查询与实时分析场景。MySQL FULLTEXT 则是关系型数据库内置的辅助索引,依赖 InnoDB/MyISAM 存储引擎,架构轻量、与业务数据强一致,但缺乏分布式扩展能力,查询语法受限,更适合中小规模数据、对事务一致性要求高且检索逻辑简单的业务系统。两者定位清晰:ES 是专业搜索引擎,MySQL FULLTEXT 是轻量级检索插件。
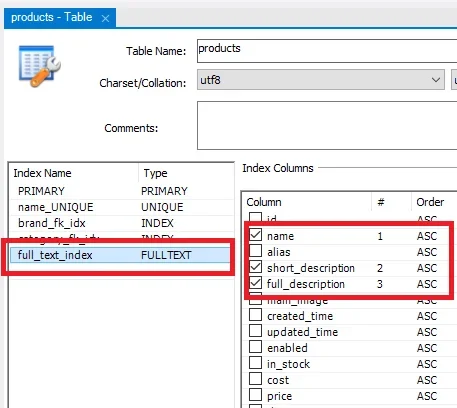
MySQL FULLTEXT:创建索引与执行检索
在 MySQL 中启用 FULLTEXT 索引需在建表或后期通过 ALTER TABLE 添加,例如 ALTER TABLE articles ADD FULLTEXT(title, content);。执行检索依赖 MATCH(column_list) AGAINST('search_terms' [search_modifier]) 语法。自然语言模式(默认)会自动过滤停用词、按相关性降序排列,适用于常规搜索;布尔模式(IN BOOLEAN MODE)支持 +(必须包含)、-(排除)、*(通配符)等运算符,适合精确控制匹配逻辑。需注意,InnoDB 默认最小词长为 3 字符(innodb_ft_min_token_size),且内置英文停用词表,中文检索需配合第三方插件或调整分词逻辑。实际应用中,若数据量在百万级以内且无需复杂过滤,FULLTEXT 可直接嵌入现有 SQL 体系,避免额外组件部署。但跨表关联检索、高并发写入下的索引重建延迟,以及缺乏原生高亮与聚合功能,是其典型瓶颈。开发者应优先评估业务是否真正需要全文语义,而非盲目替代 LIKE。
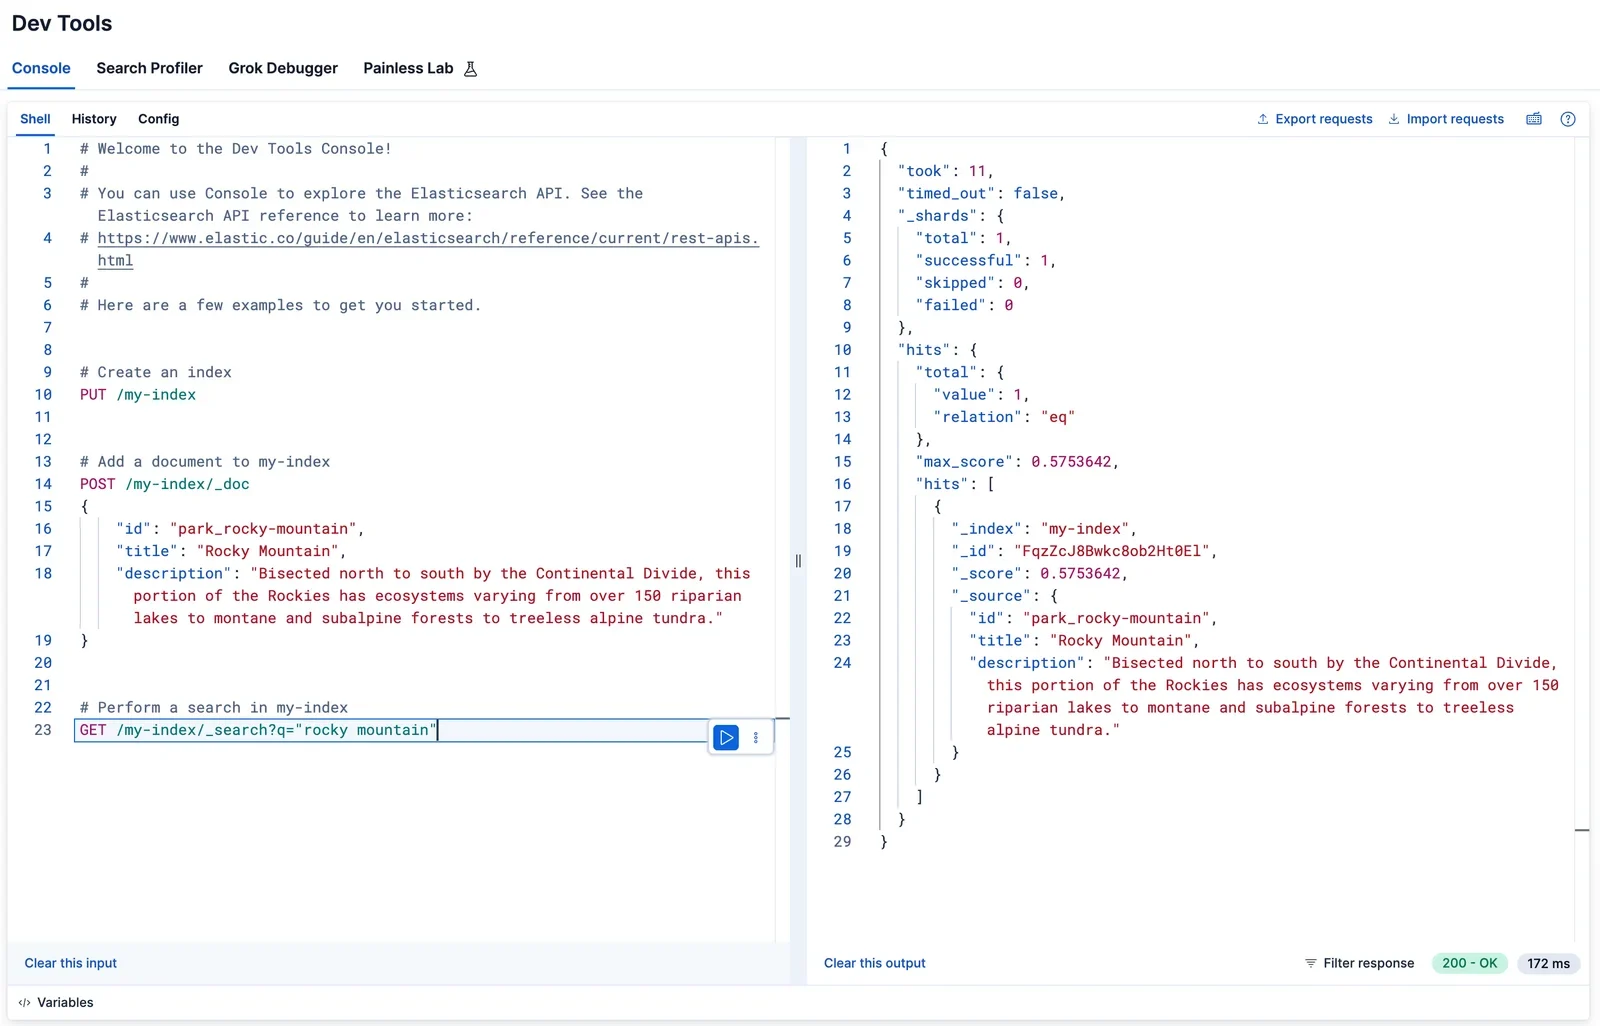
Elasticsearch:建立索引、写入数据与查询
Elasticsearch 的全文检索始于索引(Index)与映射(Mapping)的定义。通过 REST API 创建索引时可指定分析器,如 PUT /articles { "mappings": { "properties": { "title": { "type": "text", "analyzer": "ik_max_word" }, "content": { "type": "text", "analyzer": "ik_smart" } } } }。写入数据使用 POST /articles/_doc 提交 JSON 文档,ES 自动完成分词并构建倒排索引。查询阶段,match 查询是最常用的全文检索方式,例如 GET /articles/_search { "query": { "match": { "content": "数据库性能优化" } } },底层会调用分析器对查询词分词后执行布尔查询。与 MySQL FULLTEXT 相比,ES 的 Mapping 支持动态类型推断与多字段映射(multi-field),查询 DSL 提供丰富的过滤、高亮、聚合与相关性调优能力。此外,ES 采用近实时(NRT)架构,默认 refresh_interval 为 1 秒,写入后稍作延迟即可被搜索到,而 MySQL FULLTEXT 在事务提交后立即可见。ES 的分布式特性使其能水平扩展,但代价是需独立部署、维护集群状态与分片路由,架构复杂度显著高于 MySQL 内置方案。
效果验证、性能对比与方案选择
在统一测试集下验证两者表现,可清晰看出能力边界。相关性方面,ES 基于 BM25 算法,支持字段权重、同义词扩展与自定义打分脚本,召回准确率显著优于 MySQL 默认的 TF-IDF 变体;查询能力上,ES 原生支持模糊匹配、短语查询、跨字段联合检索与嵌套过滤,而 MySQL FULLTEXT 仅支持基础词元匹配与布尔逻辑,复杂条件需依赖外层 SQL 拼接。性能层面,ES 在千万级数据下通过分片并行计算保持亚秒级响应,但写入吞吐受 refresh 与段合并影响;MySQL FULLTEXT 在百万级内表现稳定,但数据量突破千万后,倒排索引膨胀会导致查询延迟陡增,且无法独立扩容。选型标准明确:若数据量低于 500GB、查询以单表关键词为主、要求强事务一致且运维资源有限,优先选用 MySQL FULLTEXT;若需处理海量非结构化文本、要求高并发低延迟、涉及复杂过滤或聚合,或需独立扩展搜索集群,则必须引入 Elasticsearch。实时性要求极高且可接受最终一致性的场景,ES 的 NRT 机制更具优势。
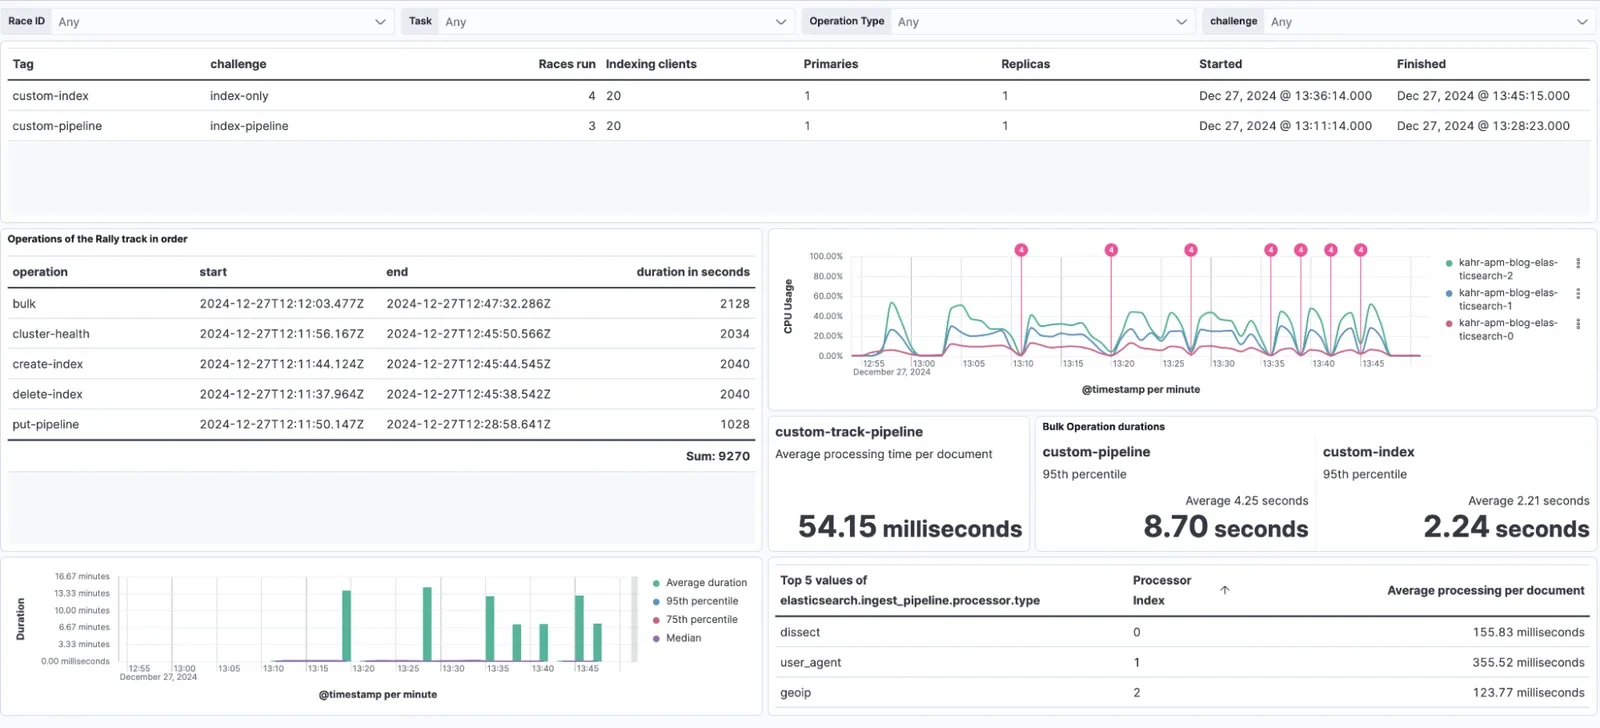
常见坑与生产环境实践
生产环境中,全文检索常因配置不当引发性能雪崩或结果异常。中文检索是首要痛点:MySQL 原生不支持中文分词,需借助 ngram 解析器或外部插件,否则会将整句视为单一词元;ES 则需安装 ik 或 jieba 插件,并在 Mapping 中显式指定,否则默认 standard 分词器会按单字切分,导致召回率极低。索引更新方面,MySQL FULLTEXT 在频繁 UPDATE/DELETE 后会产生碎片,需定期执行 OPTIMIZE TABLE;ES 的段合并(Segment Merge)虽自动进行,但高写入场景下应调大 refresh_interval 或采用批量写入(Bulk API)降低开销。Mapping 设计需警惕“字段爆炸”,动态映射易导致集群元数据过大,应提前规划静态 Mapping 并关闭不必要的 doc_values。分页与高频查询陷阱同样突出:MySQL 深度分页性能极差,ES 的 from/size 超过 10000 会触发保护机制,应改用 search_after 或游标。排查时,优先通过 EXPLAIN 或 ES _profile API 分析查询执行计划,结合慢查询日志与集群监控面板定位热点分片,避免全表扫描或过度聚合拖垮系统。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















