


Python适合开发什么类型的软件?自动化工具与管理系统的实战案例
Python 凭借其极高的交付效率、开箱即用的标准库和庞大的第三方生态,在以“数据处理、系统粘合、快速迭代”为核心目标的场景中具备天然优势。本文将直接回答 Python 在现代软件工程中最适合落地的应用领域与能力边界,并以两个典型实战场景——自动化工具与内部业务管理系统为切入点,提供完整的技术栈选型、架构流程与可运行的代码实现。
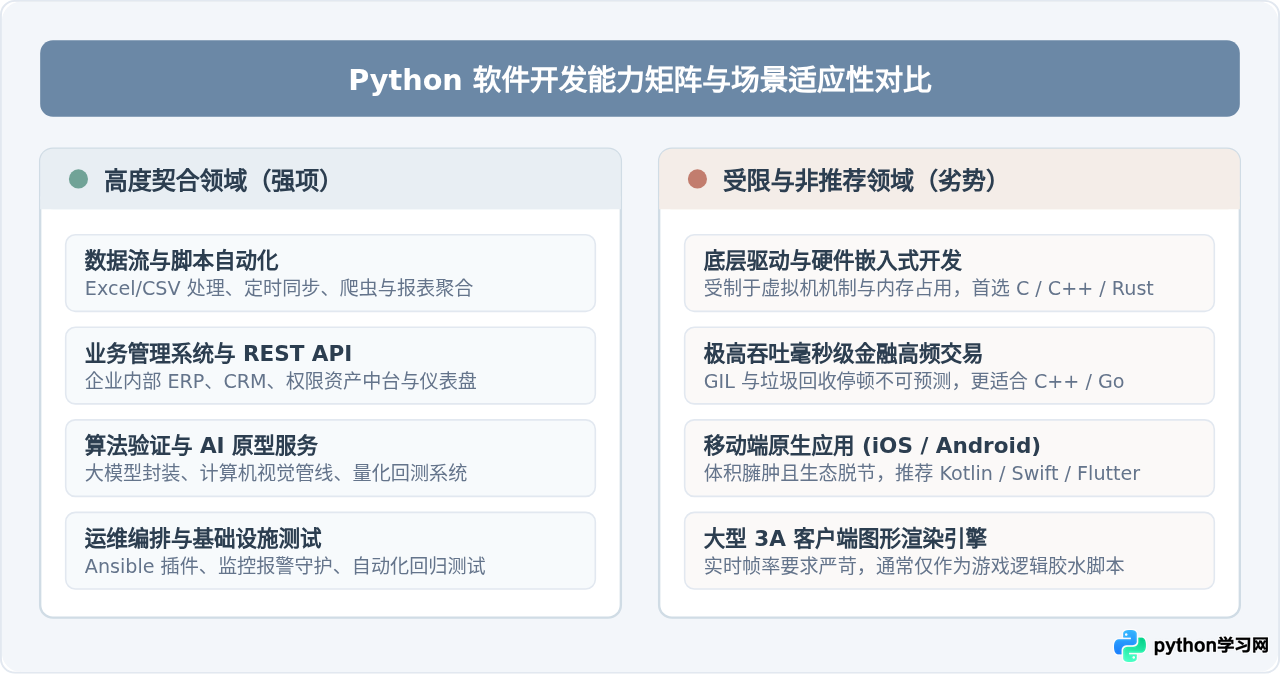 图 1:Python 适用与不适用领域能力对照全景
一、核心选型结论:Python 最适合开发什么?
在工程实际选型中,选择 Python 的首要衡量指标是“人员时间是否贵于机器计算时间”。凡是业务规则变动频繁、对研发周期要求严苛、需要集成多种异构系统(数据库、云API、Excel、硬件接口)的软件项目,Python 都是第一梯队的选择:
- 各类自动化工具与脚本管线:处理报表清洗、批量文件归档、定时数据同步、DevOps 自动化巡检、自动化爬取与告警推送。
- 企业内部业务管理系统(ERP/CRM/OA/工单中台):利用成熟的 ORM 和 Web 框架,用数十行代码即可完成完整的数据建模、权限校验、CRUD 接口与后台界面。
- 数据中台与算法原型服务:结合 Pandas、NumPy、PyTorch 将模型或分析流程快速封装为高吞吐 HTTP/gRPC 服务。
- 轻量级跨平台桌面实用程序:利用 PyQt / PySide6 或 CustomTkinter 封装内部运维工具、硬件调试器与配置管理面板。
二、实战案例一:自动化对账与告警工具
办公自动化工具的核心特征是:输入源多样(本地表格、网络接口、旧数据库)、数据处理步骤严格、输出形式直观(更新后的工作簿、告警通知)。下面展示一个自动化对账脚本的完整架构设计与实现。
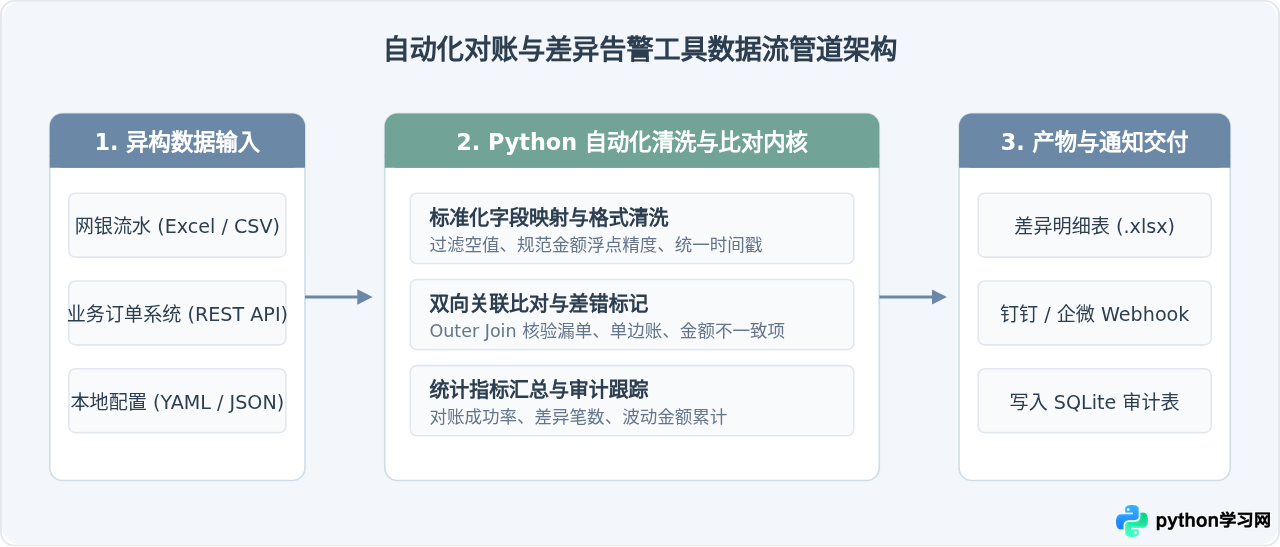 图 2:自动化对账工具的数据清洗、比对与多渠道分发架构
自动化对账脚本核心实现
以下为一个可以直接执行的自动化核对模块示例。它使用 pandas 读取两份数据表,完成键值关联、差额计算,并将异常订单通过日志和报表整理输出:
import logging
from decimal import Decimal
import pandas as pd

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

def reconcile_transactions(bank_file: str, internal_file: str, output_file: str) -> dict:
    """
    自动化对账处理逻辑:
    1. 分别加载银行明细表与内部订单表
    2. 依据商户订单号 (order_id) 进行全外连接 (Outer Join)
    3. 标记差错:漏单、单边账、金额不一致
    """
    logging.info("读取网银流水与内部订单数据...")
    df_bank = pd.read_csv(bank_file, dtype={"order_id": str})
    df_internal = pd.read_csv(internal_file, dtype={"order_id": str})

    # 标准化金额字段为统一浮点格式
    df_bank["bank_amount"] = df_bank["amount"].round(2)
    df_internal["internal_amount"] = df_internal["amount"].round(2)

    # 按订单号关联
    merged = pd.merge(
        df_bank[["order_id", "bank_amount"]],
        df_internal[["order_id", "internal_amount"]],
        on="order_id",
        how="outer"
    )

    # 标记状态
    discrepancies = []
    for row in merged.itertuples():
        if pd.isna(row.bank_amount):
            discrepancies.append((row.order_id, "内部有单但网银未记录", 0.0, row.internal_amount))
        elif pd.isna(row.internal_amount):
            discrepancies.append((row.order_id, "网银有扣款但内部漏单", row.bank_amount, 0.0))
        elif abs(row.bank_amount - row.internal_amount) > 0.001:
            discrepancies.append((row.order_id, "金额不匹配", row.bank_amount, row.internal_amount))

    df_result = pd.DataFrame(discrepancies, columns=["order_id", "issue_type", "bank_amt", "internal_amt"])

    # 输出差异报告
    df_result.to_excel(output_file, index=False)

    summary = {
        "total_checked": len(merged),
        "matched": len(merged) - len(df_result),
        "discrepancies_count": len(df_result)
    }
    logging.info("对账完成:核对总数 %d,差异笔数 %d", summary["total_checked"], summary["discrepancies_count"])
    return summary
三、实战案例二:企业资产管理系统 (FastAPI + SQLite)
内部管理系统(如固定资产台账、IT 权限审批流、物料仓储)的核心需求在于业务流程可控、API 契约清晰、权限鉴权完备以及快速支持字段调整。Python 的 Web 生态(以 FastAPI 和 Django 为代表)在这个领域具有极高性价比。
 图 3:企业级管理系统从数据建模到容器交付的全流程实战路径
轻量级资产管理 API 核心实现
基于 FastAPI 构建的轻量级资产管理系统核心模块。仅需单个文件即可同时具备入参校验、内存/持久化存储、分页筛选和 OpenAPI Swagger 交互文档:
from enum import Enum
from typing import List, Optional
from datetime import date
from fastapi import FastAPI, HTTPException, Query, status
from pydantic import BaseModel, Field

app = FastAPI(title="企业资产管理微服务", version="1.0.0")

class AssetStatus(str, Enum):
    IN_USE = "使用中"
    IDLE = "闲置"
    MAINTENANCE = "维修中"
    SCRAPPED = "报废"

class AssetCreate(BaseModel):
    asset_tag: str = Field(..., example="IT-LAPTOP-2024-001", description="资产唯一编号")
    name: str = Field(..., example="MacBook Pro 16", description="设备名称")
    assignee: Optional[str] = Field(None, example="张三", description="领用人姓名")
    status: AssetStatus = Field(default=AssetStatus.IDLE)
    purchase_date: date = Field(default_factory=date.today)

class AssetOut(AssetCreate):
    id: int

# 模拟持久化存储层
DATABASE: List[dict] = []
ID_COUNTER = 1

@app.post("/api/assets", response_model=AssetOut, status_code=status.HTTP_201_CREATED)
def create_asset(payload: AssetCreate):
    global ID_COUNTER
    # 唯一性检查
    for item in DATABASE:
        if item["asset_tag"] == payload.asset_tag:
            raise HTTPException(status_code=400, detail="资产标签已存在,禁止重复录入")

    record = payload.model_dump()
    record["id"] = ID_COUNTER
    ID_COUNTER += 1
    DATABASE.append(record)
    return record

@app.get("/api/assets", response_model=List[AssetOut])
def list_assets(
    status_filter: Optional[AssetStatus] = Query(None, alias="status"),
    keyword: Optional[str] = Query(None, min_length=1)
):
    results = DATABASE
    if status_filter:
        results = [a for a in results if a["status"] == status_filter]
    if keyword:
        kw = keyword.lower()
        results = [a for a in results if kw in a["name"].lower() or kw in a["asset_tag"].lower()]
    return results

@app.patch("/api/assets/{asset_id}/status", response_model=AssetOut)
def update_asset_status(asset_id: int, new_status: AssetStatus, assignee: Optional[str] = None):
    for item in DATABASE:
        if item["id"] == asset_id:
            item["status"] = new_status
            if new_status == AssetStatus.IN_USE and assignee:
                item["assignee"] = assignee
            elif new_status in (AssetStatus.IDLE, AssetStatus.SCRAPPED):
                item["assignee"] = None
            return item
raise HTTPException(status_code=404, detail="未找到指定资产")DATABASE 替换为 SQLAlchemy 连接池(如连接 PostgreSQL 或 MySQL),即可平滑过渡到支持万级资产与高并发访问的生产级管理系统。
四、工程化落地决策与技术选型总结
在立项评估时,技术团队应根据交付形态与并发复杂度建立清晰的技术栈映射:
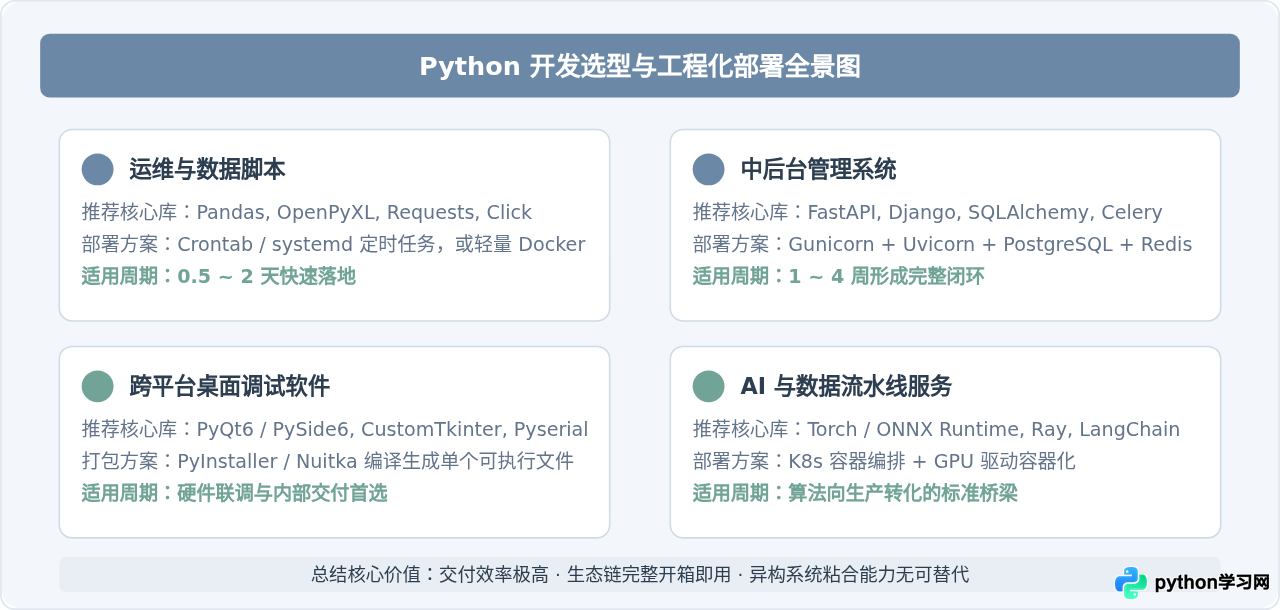 图 4:Python 各类型软件开发生态、打包路径与交付周期总结
五、常见问题与注意事项
1. Python 开发的管理系统能承受多少并发?
在以数据库 IO 为主的典型业务管理系统场景下,基于 FastAPI 或带有异步驱动(如 asyncpg)的后端架构,单节点即可轻松承载 2000~5000 QPS。由于管理系统内部用户规模通常在百人到万人之间,瓶颈往往在于数据库索引优化与慢查询,而非 Python 语言本身的执行开销。
2. 自动化脚本如何安全分发给非技术同事?
如果目标机器没有 Python 运行环境,推荐使用 PyInstaller --onefile 或 Nuitka 将脚本及其依赖虚拟环境打包为单个 .exe(Windows)或二进制执行程序。对于更复杂的自动化交互,建议使用轻量 Web 页面(如 Streamlit 或 NiceGUI)挂载在内网服务器,用户仅需通过浏览器访问即可触发执行并下载结果。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















