


Python copy报错RecursionError怎么解决
深入解析Python使用copy或deepcopy时报RecursionError: maximum recursion depth exceeded的根本原因,详细提供自定义__deepcopy__规范、__getattr__属性拦截避坑、超深结构迭代复制等四步解决方案与验证方法。
copy.deepcopy()(或特定自定义类的 copy.copy())时出现 RecursionError: maximum recursion depth exceeded,其核心原因并不是深拷贝机制本身不支持复合数据,而是当前拷贝过程陷入了未能正确利用备忘字典(memo)的死循环递归、__getattr__ 等魔术方法被递归拦截,或者数据结构的嵌套层级切实超出了 Python 默认栈深限制(通常为 1000 层)。解决该问题的关键路径在于:通过异常调用栈快速定位触发异常的类,补齐并透传 __deepcopy__ 的 memo 参数、隔离私有属性查询,或对超深链式结构采用显式迭代拷贝。
一、故障现象与报错本质剖析
Python 标准库的 copy 模块提供了浅拷贝(copy.copy())与深拷贝(copy.deepcopy())两种操作。在绝大部分业务代码中,copy.deepcopy() 都能平稳复制包含字典、列表以及普通自定义类的嵌套结构。然而,一旦代码出现异常设计,解释器便会抛出类似以下的堆栈信息:
Traceback (most recent call last):
  File "test_copy.py", line 42, in <module>
    cloned_node = copy.deepcopy(root_node)
  File "/usr/lib/python3.10/copy.py", line 172, in deepcopy
    y = _reconstructor(cls, base, state)
  ...
  File "/usr/lib/python3.10/copy.py", line 146, in deepcopy
    y = copier(x, memo)
RecursionError: maximum recursion depth exceeded while calling a Python object
Python 为了防止 C 栈溢出(Stack Overflow)导致解释器崩溃,在内部设置了一个安全调用深度上限,可通过 sys.getrecursionlimit() 查询,默认通常为 1000。当递归调用嵌套超过该数值时,解释器立即主动抛出 RecursionError。
在标准库中,copy.deepcopy(x, memo=None) 内部拥有一个核心机制——memo 字典。该字典记录了所有已经被复制过的原对象 id(obj) 与对应的新对象映射。如果数据结构中存在双向链表或自引用环(例如 node.next = node),深拷贝在二次访问同一内存对象时,会直接从 memo 查表返回副本,而不会无限递归。因此,只要 copy.deepcopy 触发了 RecursionError,必然意味着 memo 缓存机制失效,或者存在无尽调用的代码分支。
二、常见诱因的代码场景与排查方法
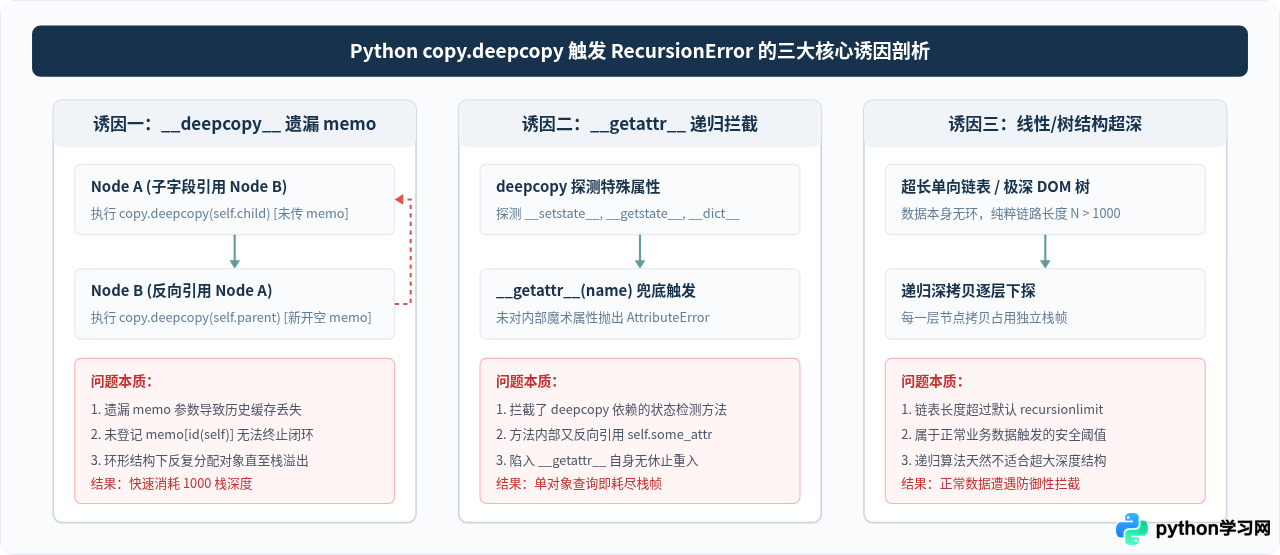
为了准确修复问题,我们需要结合代码实况与报错调用栈,逐一排查以下三种最典型的场景。
1. 重写 __deepcopy__ 时未传递 memo 参数(最常见)
许多开发者为了控制深拷贝行为(例如跳过特定大字典或连接池),会在自定义类中重写 __deepcopy__。但如果实现时忘记接收或透传 memo,就会破坏闭环保护。
import copy

class TreeNode:
    def __init__(self, value):
        self.value = value
        self.parent = None
        self.children = []

    # 错误示范:未将 memo 透传,且未在 memo 中注册自身
    def __deepcopy__(self, memo):
        new_node = TreeNode(self.value)
        # 这里的 copy.deepcopy 没有带上 memo 参数!
        new_node.children = copy.deepcopy(self.children)
        return new_node

# 构造回环
root = TreeNode("A")
child = TreeNode("B")
child.parent = root
root.children.append(child)

# 触发 RecursionError!
cloned = copy.deepcopy(root)
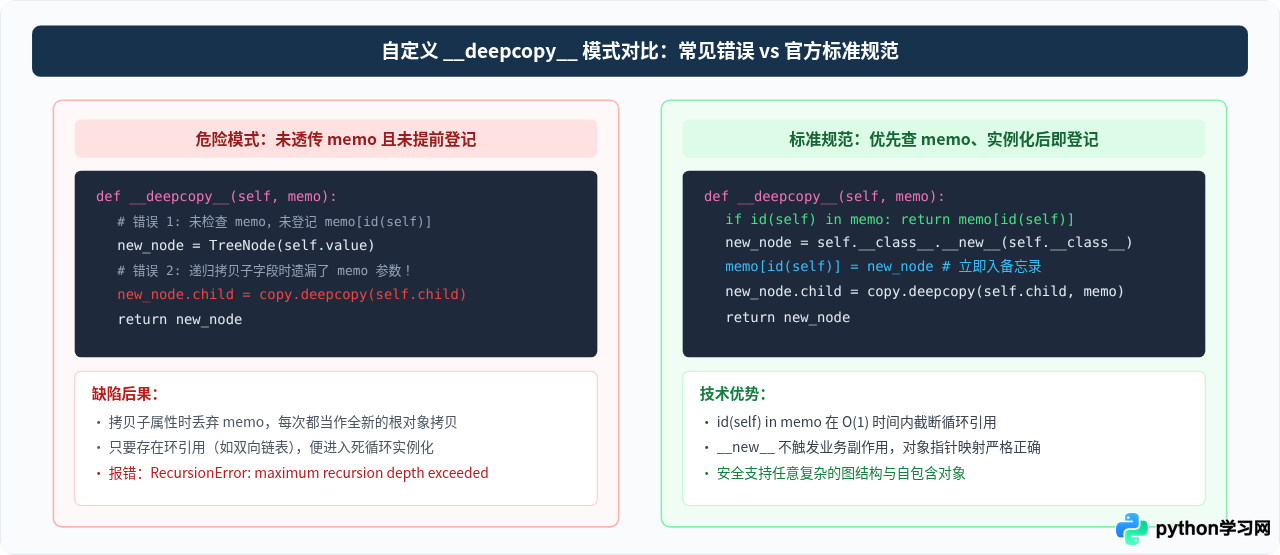
在这个错误例子中,child.parent 指向 root,而 root.children 又包含 child。当拷贝 child 时,由于没把 memo 传给 copy.deepcopy(self.children),深拷贝系统失去了所有已访问记录,只能再度深拷贝 root,直接导致两个对象无限交替实例化,直至崩溃。
2. 类的 __getattr__ 拦截了深拷贝内部私有魔术方法
copy.deepcopy 在还原一个类的实例时,通常会通过 hasattr(cls, '__setstate__') 或读取对象的 __dict__ 来提取属性。如果类重写了 __getattr__,且未对特殊方法做过滤:
class DynamicProxy:
    def __init__(self, target):
        self._target = target

    def __getattr__(self, item):
        # 错误示范:无论什么属性都转给 self._target
        # 当 deepcopy 尝试获取 __deepcopy__ 或 __setstate__ 时,
        # 如果 _target 本身不存在该属性,可能在此处反复重入
        return getattr(self._target, item)
尤其当深拷贝刚通过 __new__ 创建了实例尚未执行 __init__ 时,self._target 还未写入实例属性字典,访问 self._target 本身又会再次触发 __getattr__('_target'),瞬间陷入死循环递归。
3. 数据结构本身层级深,但无逻辑错误
有些业务数据是深层嵌套的,比如长达 1500 节的链表,或者层数很深的语法分析 AST 树。每个节点即使只有一个 next 指针,递归调用栈也会达到 1500 层,直接突破 Python 默认的 1000 层保护机制。
三、核心解决方案与标准代码范式
方案一:遵循标准规范编写自定义 __deepcopy__
编写自定义 __deepcopy__(self, memo) 时,必须严格遵守两项原则:
- 必须首先检查
memo字典:如果当前对象的id(self)已经在memo中,直接返回memo[id(self)]。 - 先登记后递归:一旦创建了新对象实例,必须立刻将其存入
memo[id(self)] = new_obj,然后再对当前对象的各个字段调用copy.deepcopy(attr, memo)。
import copy

class SafeTreeNode:
    def __init__(self, value):
        self.value = value
        self.parent = None
        self.children = []

    def __deepcopy__(self, memo):
        # 1. 检查是否已被复制过,防回环
        obj_id = id(self)
        if obj_id in memo:
            return memo[obj_id]

        # 2. 先创建空实例(避免调用重型 __init__ 产生副作用)
        cls = self.__class__
        new_obj = cls.__new__(cls)

        # 3. 关键:在递归子属性之前,先登记到 memo 字典!
        memo[obj_id] = new_obj

        # 4. 递归复制各个属性,必须带上 memo 参数
        new_obj.value = copy.deepcopy(self.value, memo)
        new_obj.parent = copy.deepcopy(self.parent, memo)
        new_obj.children = copy.deepcopy(self.children, memo)

return new_objcls.__new__(cls) 可以安全地分配内存而不立刻执行业务构造逻辑。随后立刻执行 memo[obj_id] = new_obj,此时如果子节点反向引用了 parent,其深拷贝流程会在第 1 步直接命中 memo 缓存返回刚创建的 new_obj,彻底阻断无限循环!
方案二:修复 __getattr__ / __getattribute__ 动态属性拦截
当类定义了 __getattr__ 时,必须保证对私有与内部魔术属性(尤其是以双下划线开头的属性)安全放行。如果找不到,应当抛出 AttributeError,而不是返回 None 或递归调用:
class SafeProxy:
    def __init__(self, target):
        self._target = target

    def __getattr__(self, name):
        # 1. 过滤 Python 内部魔术方法,直接引发 AttributeError
        if name.startswith("__") and name.endswith("__"):
            raise AttributeError(f"'{type(self).__name__}' object has no attribute '{name}'")

        # 2. 安全获取内部目标对象属性
        try:
            target = object.__getattribute__(self, "_target")
        except AttributeError:
            raise AttributeError(f"_target is not initialized")

        return getattr(target, name)
方案三:针对超深线性结构改用迭代拷贝算法
如果数据结构完全无环,但链表长度达到几千甚至数万,递归方式本身就会超出堆栈。此时应该放弃默认的递归深拷贝,改用显式的 while 循环或辅助栈进行迭代复制:
class ListNode:
    def __init__(self, val):
        self.val = val
        self.next = None

def iterative_copy_list(head):
    # 使用迭代循环代替递归,时间复杂度 O(N),调用栈空间 O(1)
    if not head:
        return None

    new_head = ListNode(head.val)
    curr_src = head.next
    curr_dest = new_head

    while curr_src:
        curr_dest.next = ListNode(curr_src.val)
        curr_dest = curr_dest.next
        curr_src = curr_src.next

return new_head有些文章建议直接执行
sys.setrecursionlimit(5000)。请务必注意:如果代码存在循环引用的逻辑 Bug,放大递归深度只会让崩溃稍微延后,并且可能直接导致底层 C 栈耗尽产生 Segmentation Fault(段错误)直接退出程序。仅在“明确知道数据结构没有死循环,且嵌套深度已知有限(如 1500 层)”的特殊临时场景下,才可适度调大该参数。
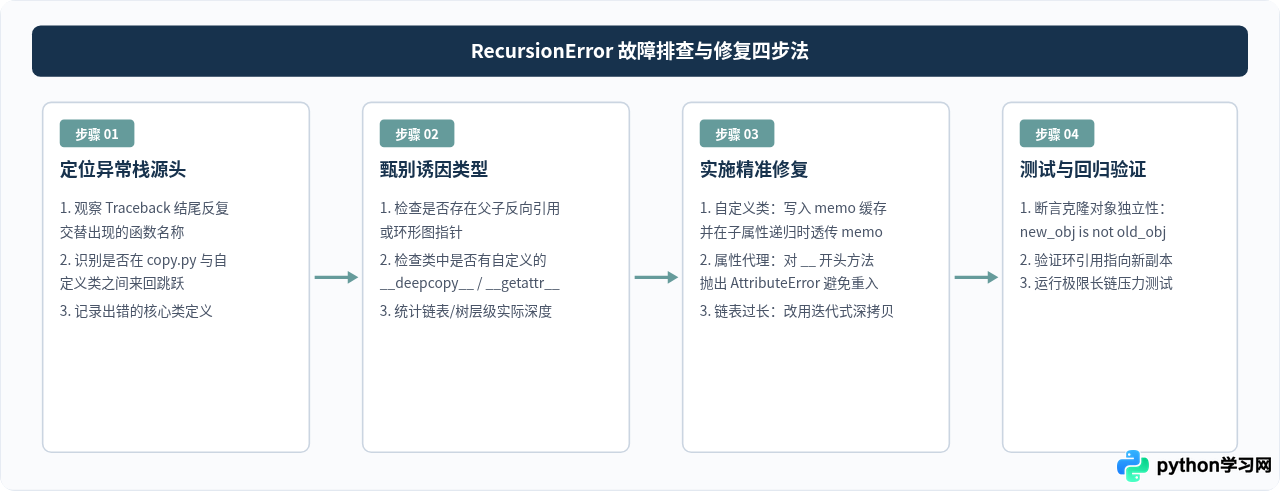
四、结果验证与防御性测试
完成代码修改后,必须通过单元测试验证以下三项指标:
- 解耦性验证:修改副本中的属性,源对象的对应属性不受影响。
- 引用拓扑一致性:源对象中指向同一地址的多个指针,在副本中仍然指向新副本的同一地址,而不是被重复实例化。
- 环形链路终结性:测试包含
self.loop = self的极端对象,确认深拷贝能在毫秒级正常返回。
import unittest
import copy

class TestDeepCopyFix(unittest.TestCase):
    def test_circular_reference(self):
        node_a = SafeTreeNode("A")
        node_b = SafeTreeNode("B")
        node_a.children.append(node_b)
        node_b.parent = node_a

        # 验证不会抛出 RecursionError
        cloned_a = copy.deepcopy(node_a)

        # 验证对象已深拷贝
        self.assertIsNot(node_a, cloned_a)
        self.assertIsNot(node_a.children[0], cloned_a.children[0])

        # 验证环形结构拓扑一致性
        self.assertIs(cloned_a.children[0].parent, cloned_a)

if __name__ == "__main__":
    unittest.main()
五、修复方案选型与技术总结
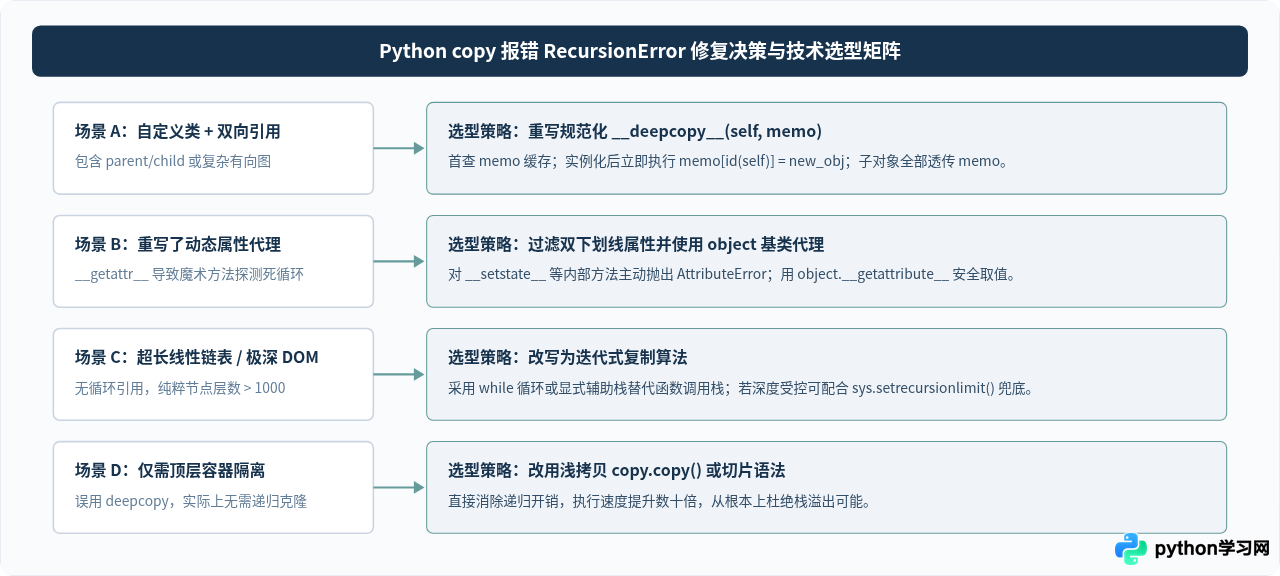
| 诱因类型 | 典型异常表现 | 核心排查特征 | 推荐解决方案 |
|---|---|---|---|
| memo 遗漏 | Traceback 在自定义 __deepcopy__ 与 copy.py 间高频交替 |
对象间存在父子指针、双向链表或图连接 | 补齐 id(self) in memo 判断,先登记再递归透传 memo |
| 属性拦截死循环 | Traceback 在 __getattr__ 内反复调用同一属性名 |
类中重写了动态代理或 __getattr__ |
过滤双下划线特殊属性并引发 AttributeError,使用 object.__getattribute__ |
| 超深非循环结构 | Traceback 每一层都是不同的节点,但层数超过 1000 | 长链表、深度语法树,无任何自引用环 | 改写为 while 迭代循环,或评估后适度增加 setrecursionlimit |
| 过度深拷贝 | 只需修改外层字典/列表,却全量复制了复杂环境上下文 | 嵌套包含只读配置、连接池或大单例 | 评估业务需求,改用浅拷贝 copy.copy() 或工厂方法重建 |
综上所述,当 Python 报出 RecursionError 时,不要盲目通过 sys.setrecursionlimit() 放大堆栈。先观察调用栈定位到具体对象类型,判断属于“缺少 memo 的循环引用”、“属性拦截死循环”还是“超深线性结构”,然后针对性地补全 memo 映射或改用迭代算法,才能从根本上保证程序的健壮性与内存安全。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















