


Python import、from...import与as别名的用法区别
全面解析 Python 中 import、from...import 与 as 别名的用法区别与底层原理。从命名空间绑定、模块加载生命周期、变量状态同步差异到循环导入与同名覆盖排查,提供完整示例与工程选型建议。
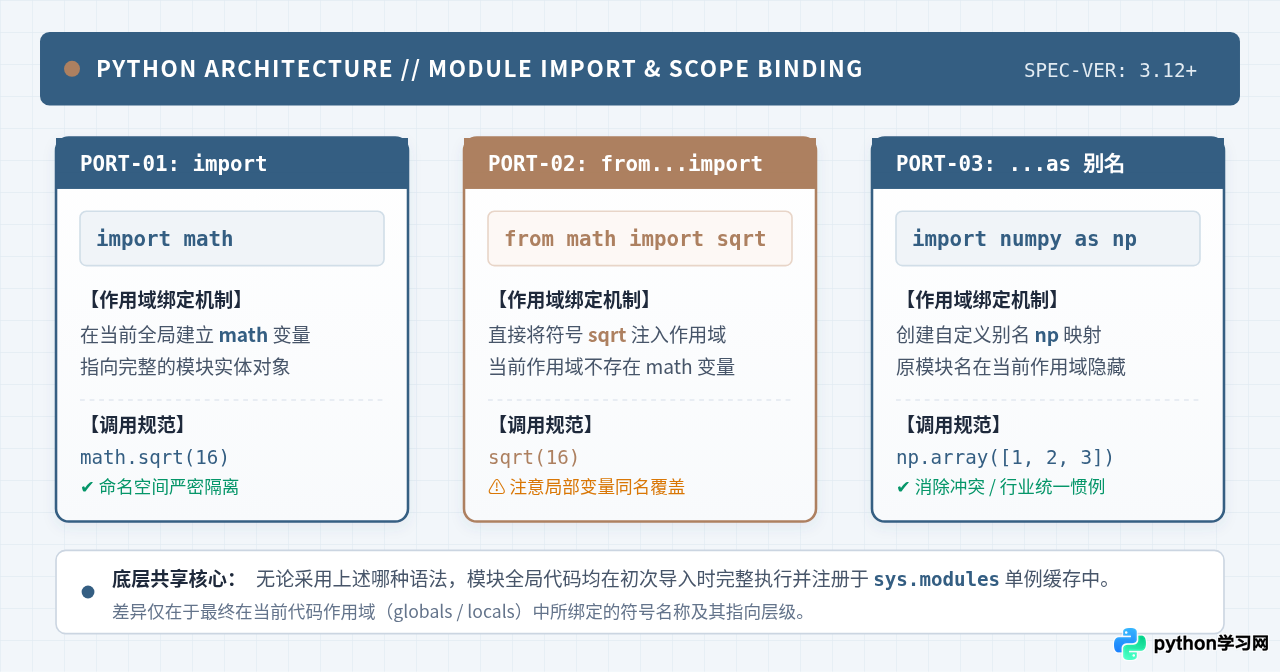
.py 文件或编译模块执行后,在当前代码环境的符号表中建立映射关系。import 模块名 会在当前命名空间创建模块对象变量,调用时必须携带模块名前缀;from 模块名 import 成员 则直接将模块内部的具体函数、变量或类直接提取并绑定到当前局部作用域;而 as 别名 则是为导入的对象显式指定一个新名称,用于避免命名冲突或简化过长标识符。理清这三者的使用区别与底层原理,能够帮助开发者写出结构清晰、无命名冲突且性能稳定的高质量 Python 代码。
一、三种导入语法的语法形式与基本用法
在 Python 中组织多文件工程或复用第三方库时,我们每天都在编写导入语句。理解它们的第一步,是看清每种语法在当前代码命名空间中究竟生成了什么变量,以及如何正确调用。
1.1 完整模块导入:import 模块名
这是 Python 中最纯粹、最推荐的标准导入形式。它通过 import 模块名 直接把整个模块引入,并使用模块本身的名称作为当前作用域内的变量名。
# 示例环境:Python 3.10+
import math

# 调用时必须通过 "模块名.属性名" 的方式访问
radius = 5.0
circumference = 2 * math.pi * radius
root_val = math.sqrt(64)

print(f"圆周长: {circumference:.2f}")
print(f"平方根: {root_val}")
print(f"当前命名空间变量: {'math' in globals()}")
print(f"当前命名空间是否存在 sqrt: {'sqrt' in globals()}")平方根: 8.0
当前命名空间变量: True
当前命名空间是否存在 sqrt: False
机制分析:此时当前文件的全局命名空间(globals())中仅新增了一个名为 math 的模块对象。函数 sqrt 和常量 pi 仍然安全地封装在 math 自身的命名空间字典(__dict__)内。这种写法的最大优点是高安全性与高可读性:任何读代码的人一眼就能看出 math.sqrt() 来自于 math 模块,绝不会与本地定义的 sqrt 函数发生冲突。
1.2 符号直接导入:from 模块名 import 成员名
当我们只需要模块中的某几个高频函数或类,且不想在每次调用时都敲击冗长的模块前缀时,可以使用 from...import 语法。
# 从 math 模块中直接提取特定属性并绑定到本地命名空间
from math import sqrt, pi

# 直接使用函数名,无需任何前缀
val = sqrt(81)
print(f"直接调用 sqrt: {val}")
print(f"直接访问 pi: {pi:.4f}")

print(f"当前命名空间是否存在 math: {'math' in globals()}")
print(f"当前命名空间是否存在 sqrt: {'sqrt' in globals()}")直接访问 pi: 3.1416
当前命名空间是否存在 math: False
当前命名空间是否存在 sqrt: True
机制分析:执行 from math import sqrt 后,Python 会在当前命名空间中直接创建变量 sqrt,并让它直接指向 math 模块内的 sqrt 函数对象。此时当前作用域中根本不存在名为 math 的变量!若在此之后直接调用 math.sin(),Python 会抛出 NameError: name 'math' is not defined。
sqrt 被直接注入到当前作用域,如果在导入前后你在本地定义了 def sqrt(): pass 或者 sqrt = 100,后执行的代码会直接无警告地覆盖先前的定义!
1.3 别名映射机制:... as 别名
as 关键字可以与 import 或 from...import 组合使用。它的作用是在当前作用域内,为导入的目标对象绑定一个自定义的新名称(Alias)。
形式一:模块整体赋予别名
# 数据分析领域的通用标准命名惯例
import numpy as np
import pandas as pd

arr = np.array([1, 2, 3, 4, 5])
df = pd.DataFrame({"col": arr})
print(f"numpy 是否在全局命名空间: {'numpy' in globals()}")
print(f"np 是否在全局命名空间: {'np' in globals()}")np 是否在全局命名空间: True
注意:此时原始名字 numpy 在当前命名空间中是不可见的,只能通过新绑定的 np 访问。
形式二:特定成员赋予别名(消解同名冲突的关键技巧)
# 场景:项目需要同时使用系统原生 json 库与高性能 orjson 库的 dumps 方法
from json import dumps as std_dumps
import orjson

data = {"name": "Alice", "role": "Engineer"}
json_str = std_dumps(data)
fast_bytes = orjson.dumps(data)

print(f"标准库序列化: {json_str}")
print(f"高性能库序列化: {fast_bytes}")
通过使用 as std_dumps,我们清晰区分了两个不同来源但同名的 dumps 函数,彻底消除了命名遮蔽(Shadowing)隐患。
二、底层运作机制:Python 导入时到底发生了什么?
很多初学者会产生一种误解:“import math 会把整个数学库加载到内存中,而 from math import sqrt 只加载 sqrt 一个函数,所以后者性能更好、更省内存。”——这种认知是完全错误的!
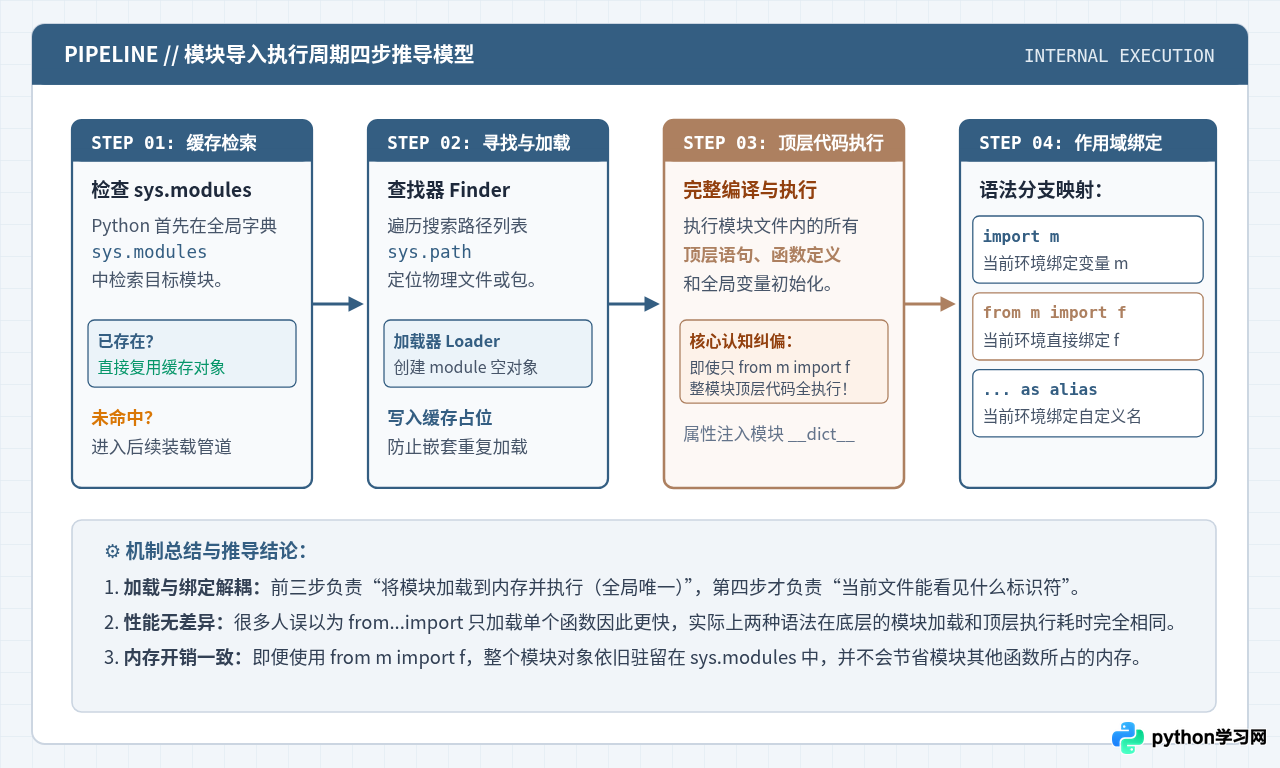
无论你使用 import、from...import 还是 as,Python 解释器底层的装载管道与执行流程都遵循完全一致的四个步骤。
2.1 模块单例与 sys.modules 缓存机制
当 Python 遇到一条导入语句时,第一步永远是去全局系统缓存字典 sys.modules 中查询目标模块是否已被加载。sys.modules 是一个普通的 Python 字典,记录了所有已经加载过的模块名称与对应的模块对象映射。
- 如果缓存命中:Python 直接从
sys.modules获取该模块对象的引用,跳过后续的磁盘定位、解析和执行环节。 - 如果缓存未命中:Python 才会启动查找器(Finders)在
sys.path中指定的路径中搜索文件,并由加载器(Loaders)创建模块对象,同时立即将其写入sys.modules占位,最后执行该模块的顶层代码。
这意味着:同一个 Python 进程中,一个模块无论被 import 了多少次,其顶层代码都只会在初次导入时执行一次。
2.2 关键认知:整模块顶层代码始终全量执行
当你执行 from my_module import calculate 时,Python 解释器绝对不可能去跳过 my_module.py 中的其他函数或变量只提取 calculate。因为 Python 是动态语言,只有自上而下顺序执行完整个 .py 文件的字节码,解释器才能知道 calculate 最终绑定的是什么对象,以及该模块是否依赖了其他全局定义。
因此,import 与 from...import 在模块载入、代码执行、内存占用上没有任何区别。它们之间唯一的区别发生在第 4 步——符号绑定(Symbol Binding)。
三、内存对象模型与命名空间映射结构
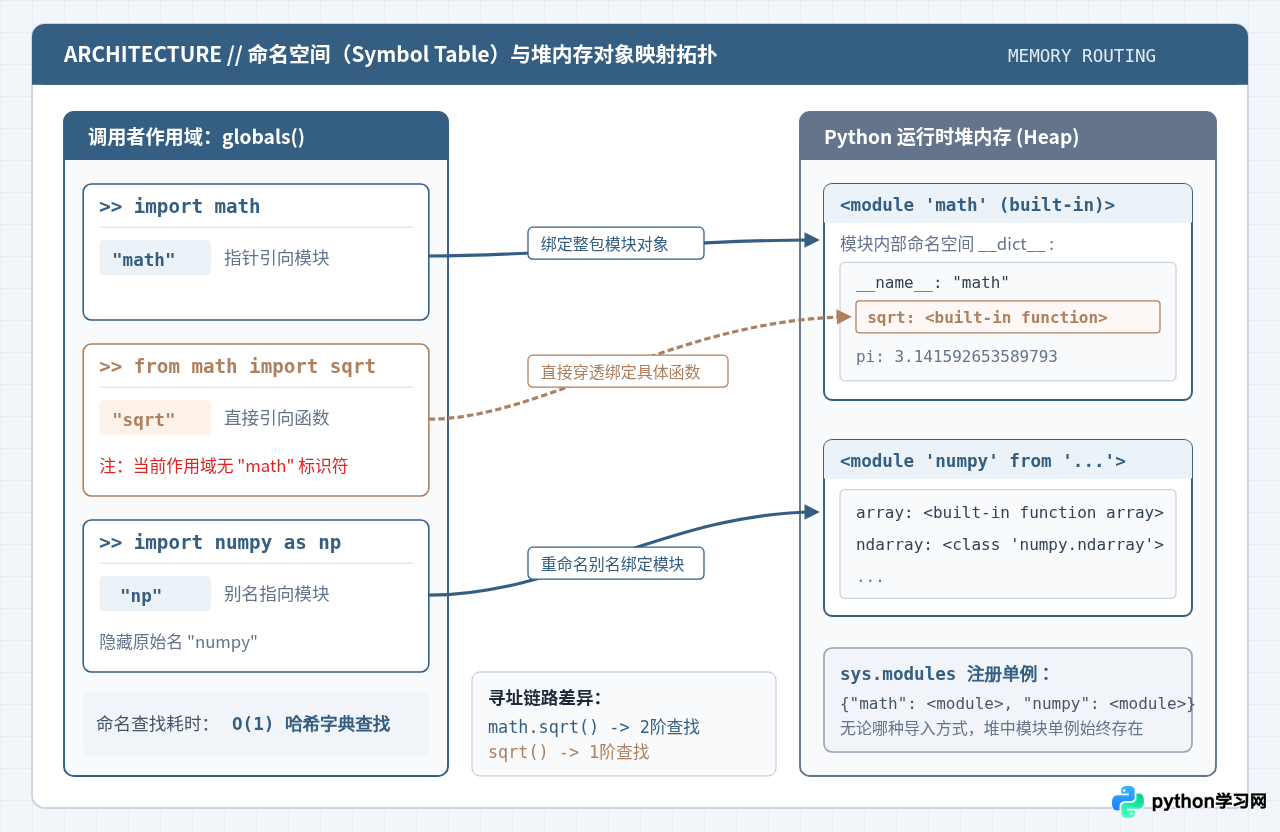
为了直观展现符号绑定的物理差异,我们可以通过 Python 运行时堆内存(Heap)与调用者符号表(Symbol Table)的映射关系图来观察三者的不同通路。
3.1 寻址链路的微观差异(属性查找 vs 局部变量)
虽然两者的模块加载成本一致,但在后续代码运行调用时,微观层面的寻址链路存在细微差别:
math.sqrt(x):首先在当前作用域的哈希表查找变量math(耗时极短的LOAD_GLOBAL或LOAD_FAST字节码),紧接着在math模块对象的属性字典中查找sqrt(触发LOAD_ATTR字节码)。属于两阶寻址。sqrt(x):直接在当前作用域的哈希表中查找符号sqrt(单个LOAD_GLOBAL或LOAD_FAST),没有后续的LOAD_ATTR开销。属于一阶寻址。
在大规模数百万次的高频循环中,直接调用 sqrt() 的属性查找开销确实会微弱低于 math.sqrt(),但在绝大多数常规业务开发中,这种毫秒级以内的差异可以忽略不计,代码的可维护性与命名清晰度永远具有更高的优先级。
3.2 不可变对象修改时的“状态不同步”陷阱
在涉及全局变量共享时,import 与 from...import 会表现出完全不同的行为,这也是中高级开发中最容易栽跟头的深水区。
假设我们有一个配置模块 config.py:
# 文件名: config.py
status_code = 200

def set_error():
    global status_code
    status_code = 500
现在我们在两个不同的测试文件中分别导入并观察:
# 测试场景 A: 使用 import config 导入
import config

print(f"初始状态: {config.status_code}")  # 输出: 200
config.set_error()
print(f"修改后状态: {config.status_code}")  # 输出: 500 (成功同步变化!)
# 测试场景 B: 使用 from config import status_code 导入
from config import status_code, set_error
print(f"初始状态: {status_code}") # 输出: 200
set_error()
print(f"修改后状态: {status_code}") # 输出依然是: 200!(状态发生严重脱节!)200 是不可变对象(Immutable)。当执行 from config import status_code 时,当前文件的本地变量 status_code 直接指向数字 200 的内存地址。当调用 set_error() 时,config.py 内部的全局变量被重新赋值指向了新的数字对象 500;然而当前文件中的 status_code 仍然顽固地指向旧的 200 对象!而使用 config.status_code 时,每次都会动态查询 config 模块属性,因此始终能读取到最新的值。
四、常见误区与工程避坑实践
导入语句书写不规范是导致 Python 项目出现“幽灵 Bug”和“循环依赖崩溃”的主要温床。以下是两类必须严密防范的高危场景。
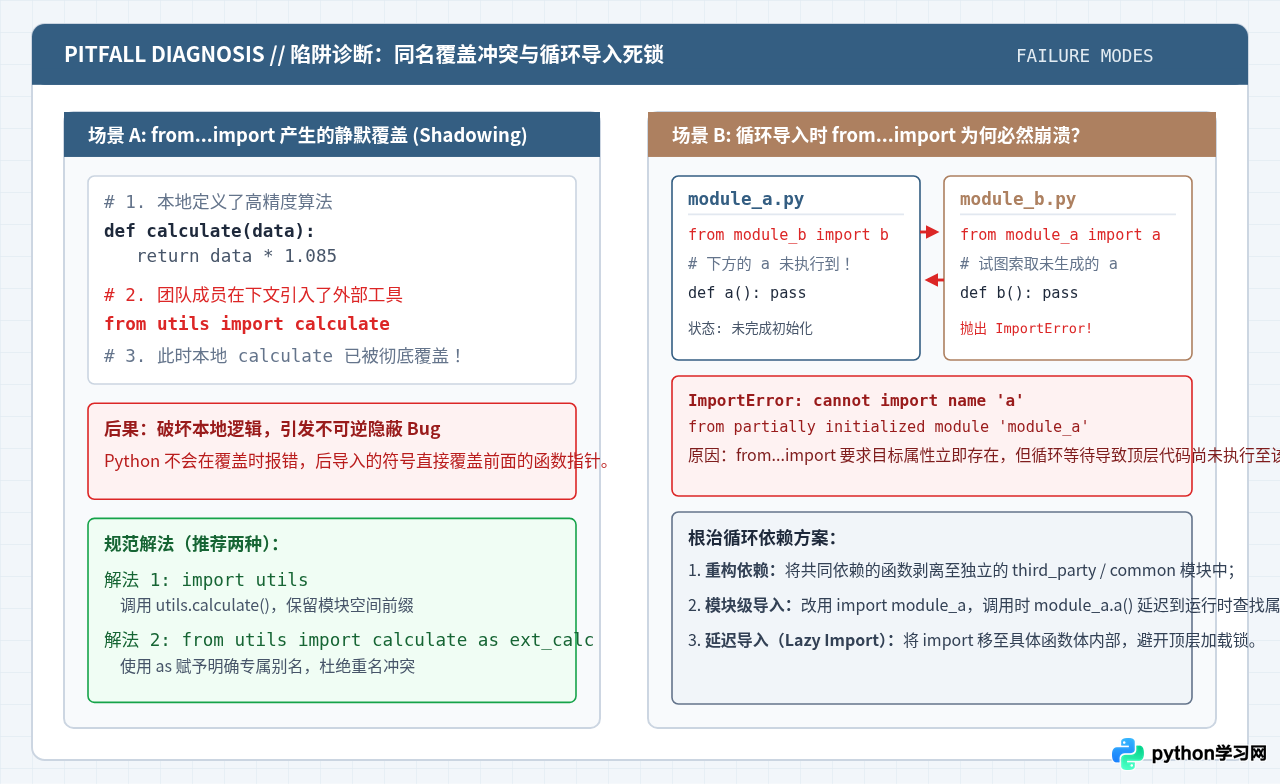
4.1 严禁在生产代码中使用通配符导入(from module import *)
Python 允许使用 from module import * 将模块内所有非下划线开头的符号一次性全部导入当前命名空间。虽然这在临时交互式命令行中看似省事,但在任何正式工程中都是绝对禁止的。
- 命名空间黑盒化:你无法直观预知对方模块究竟导出了多少个变量。如果模块未来版本新增了一个名为
open或id的函数,你本地代码原有的原生内置函数就会被静默替换。 - 静态代码分析失效:代码审查工具(如 Flake8、Pylint)和 IDE 的自动补全、重构更名功能将彻底失灵,因为静态工具无法预测通配符展开后包含了哪些成员。
- 降低代码可读性:他人阅读你的代码时,看到调用了某个
process_data(),却完全找不到它的定义和来源,必须逐个排查所有通配符导入的模块。
4.2 为什么循环导入(Circular Import)中 from...import 最易崩溃?
当模块 A 与模块 B 互相依赖时,使用 from...import 几乎百分之百会触发以下致命错误:
ImportError: cannot import name 'func_a' from partially initialized module 'module_a'其根本机制在于:当 module_a 执行第一行 from module_b import func_b 时,解释器暂停 module_a 的执行并跳转到 module_b。如果 module_b 顶层写着 from module_a import func_a,解释器去 sys.modules 中查询,虽然找到了已经挂载的 module_a 模块对象,但因为 module_a 刚执行到第一行就被中断,其内部根本还没来得及运行到 def func_a 这一行!因此提取属性失败,抛出致命异常。
工程解决范式:
- 架构分层解耦(最优解):将两个模块共同依赖的公共逻辑或基础数据模型抽离到第三个独立模块(如
common.py或types.py),切断双向循环引用链路。 - 改用模块级 import:在顶层使用
import module_a,并在函数内部调用时使用module_a.func_a()。由于此时无需在顶层立即绑定具体符号,当函数真正被调用时,模块早已经全部执行完毕。 - 延迟导入(Lazy Import):将
import语句移至具体的函数内部执行,避开模块初始化加载时的全局死锁。
五、语法特性对比与工程选型决策
为了帮助开发者在实际开发中做出清晰准确的技术选型,我们将三者的关键特征汇总于下表:
| 导入语法 | 当前命名空间生成变量 | 代码调用方式 | 命名覆盖风险 | 模块状态同步性 | 最佳适用场景 |
|---|---|---|---|---|---|
import 模块名 |
仅生成模块名变量 | 模块名.属性名() |
极低(天然空间隔离) | 实时动态同步 | 工具库、大型通用库(如 os, sys, math),模块内多函数混合使用时 |
from 模块 import 成员 |
直接生成具体成员变量 | 属性名() 无需前缀 |
较高(易覆盖同名本地变量) | 不可变对象脱节 | 专一用途的高频工具类、纯函数(如 from datetime import datetime) |
import 模块 as 别名 |
生成自定义模块别名 | 别名.属性名() |
低(受控别名) | 实时动态同步 | 数据科学领域行业标准(如 import numpy as np),或模块层级过长时 |
from 模块 import 成员 as 别名 |
生成自定义成员别名 | 别名() |
低(精准重命名) | 不可变对象脱节 | 多模块同名函数共存冲突(如同时导入 json.dumps 与 orjson.dumps) |
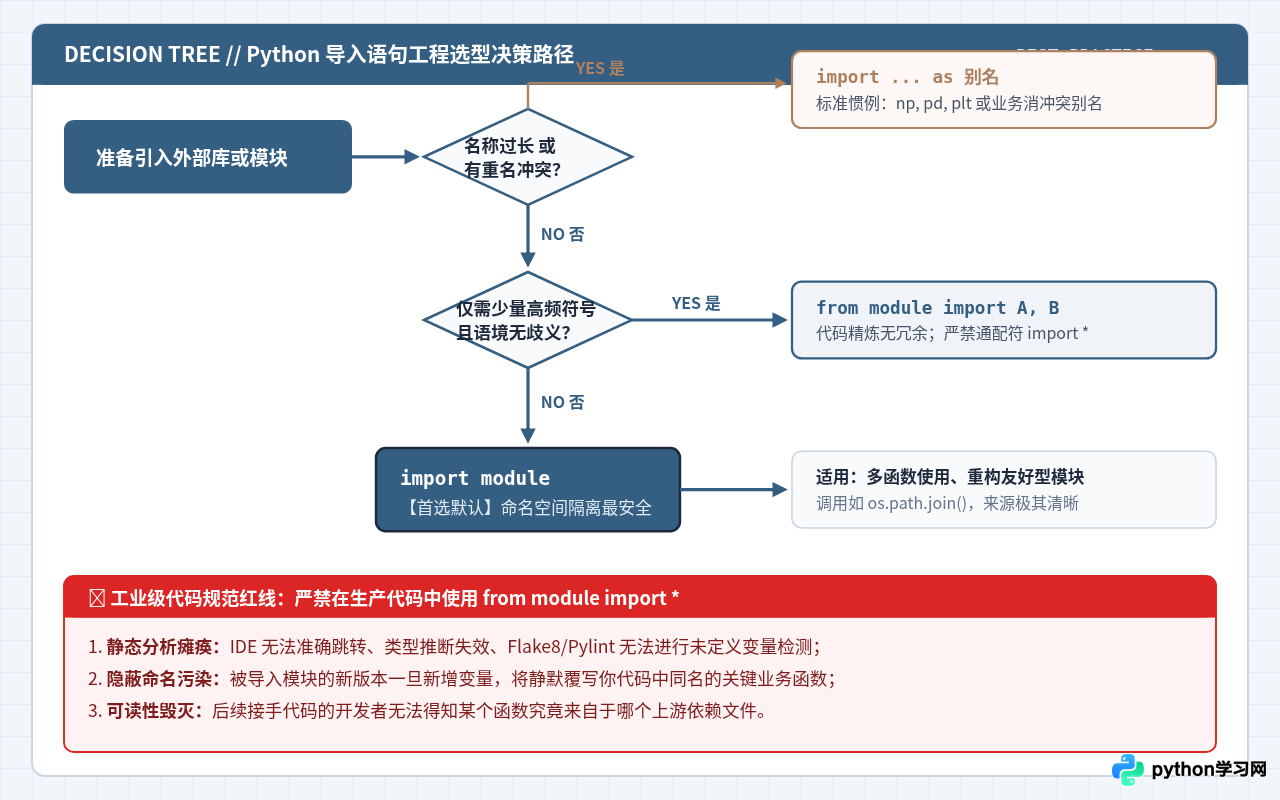
5.1 团队开发规范推荐落地准则
- 默认优先原则:优先使用
import 模块名。尽管在输入时多敲击几个字符,但保留模块名空间能极大提高代码审查(Code Review)和跨文件追溯时的可读性。 - 语义专属绑定:当且仅当所导入的类名自身具有极其明确、毫无歧义的专属性时(例如
from dataclasses import dataclass、from pydantic import BaseModel),采用from...import。 - 尊重行业通用别名:在第三方科学计算与大型工具包中,严格遵从社区约定的
as别名标准(np,pd,plt,tf),不要标新立异自创缩写(如严禁写出import numpy as my_n)。 - 防卫性重命名:如果在同一个文件中需要引入不同模块的同名实体,必须在
from...import时通过as加上清晰的命名空间前缀或业务后缀(如from api.v1 import Order as OrderV1与from api.v2 import Order as OrderV2)。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















