


Python代码生成器有哪些?主流AI工具与模板引擎对比
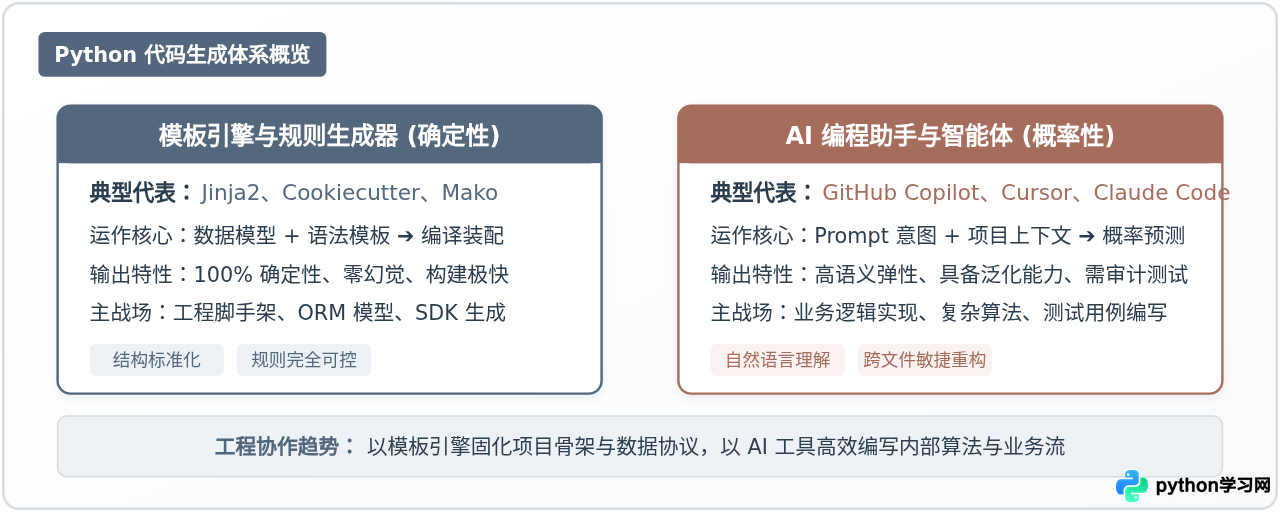
系统梳理Python生态中的主流代码生成工具,深入对比基于Jinja2、Cookiecutter的确定性模板引擎与基于GitHub Copilot、Cursor的概率性AI工具在机制、工作流与工程选型上的核心差异。
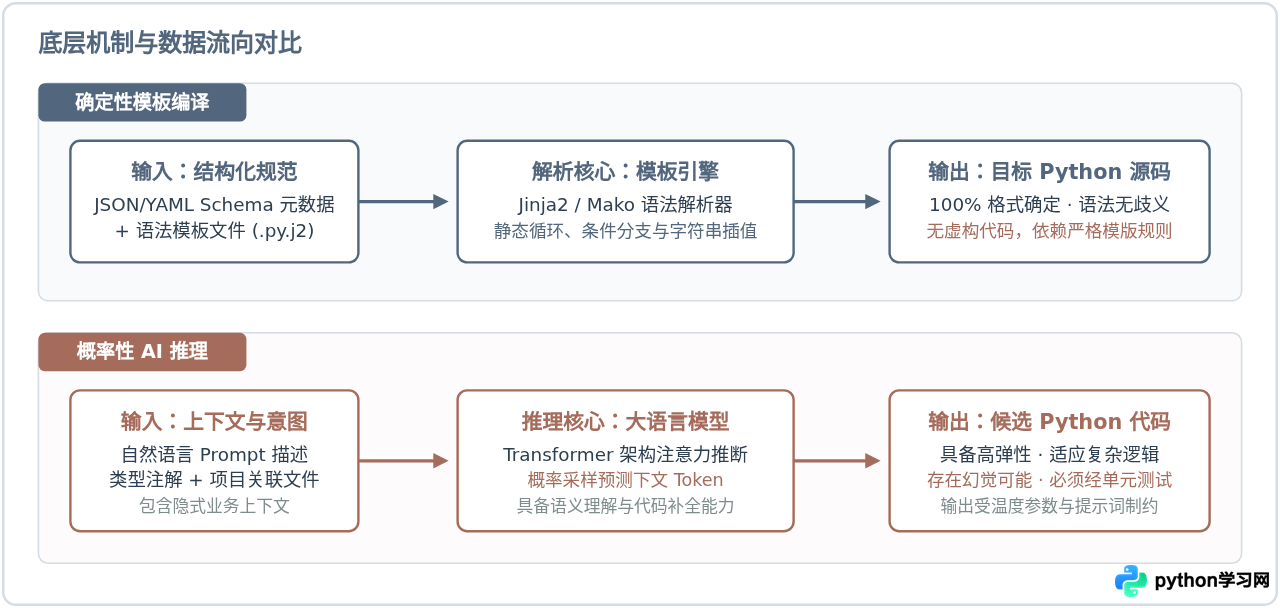
一、两类代码生成器的底层运作机制
探讨“Python 代码生成器”时,开发者往往容易将模板填充与深度学习混为一谈。从计算机执行逻辑的角度来看,两者的输入形态、处理流程以及对结果的确定性有着本质差异。
确定性模板引擎的本质是结构化数据驱动的字符串编译器。开发者首先定义严格的语法模板(例如 .j2 文件),明确预留变量插槽、循环体以及条件分支;随后将结构化元数据(如 JSON、YAML 或数据库元数据字典)传入引擎;模板引擎在 AST(抽象语法树)或词法分析阶段完成变量替换与逻辑展开,最终一次性生成目标 Python 文件。在这一流程中,只要输入的数据结构和模板不变,生成的代码就具备严格的幂等性与可复现性。
与之相反,现代 AI 代码生成工具的底层是基于上下文感知的概率预测引擎。模型(如 Claude、GPT 等)并不直接包含预设的代码模版,而是将开发者当前编写的类名、函数签名、类型提示、注释说明以及代码库中的相邻文件转化为 Token 序列。注意力机制在多维向量空间中计算概率,并逐词生成语义上最连贯的代码片段。这种机制带来了极强的语义抽象与逻辑推理能力,但同时也天然伴随着非确定性输出以及幻觉风险。
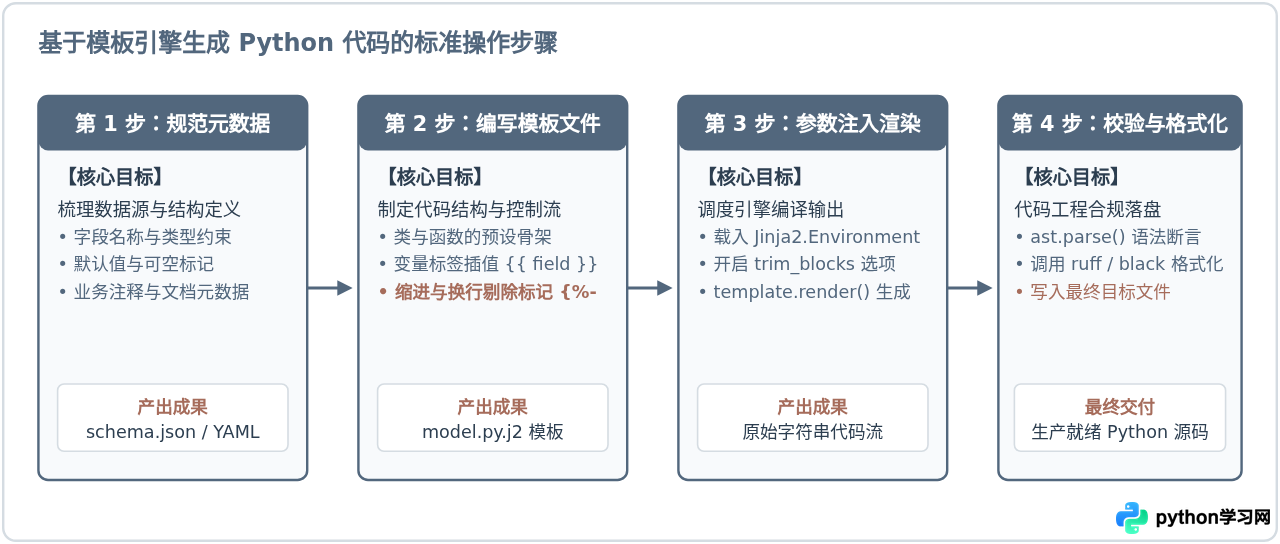
二、主流模板引擎与确定性代码生成工具详解
在工程标准化要求极高、数据契约固定的场景下,确定性代码生成工具是整个 Python 工具链的基石。以下为目前主流的工具及其适用场景:
- Jinja2:Python 生态中最具统治力的模板引擎。虽然最初为 Web 模板设计,但因其拥有完备的控制流语法(
for循环、if分支、宏定义)和强大的空白字符控制机制,被广泛用于根据 OpenAPI/Swagger 规范生成 Python SDK、根据数据库表结构生成 SQLAlchemy/Pydantic 模型,以及渲染各类自动化脚本。 - Cookiecutter 与 Copier:专注于项目级脚手架生成的工具。基于 Jinja2 模板系统,允许团队将标准的仓库布局、CI/CD 流程、Lint 配置以及基础代码抽象为模板,开发者仅需回答命令行提问即可秒级生成全新的 Python 项目。
- Mako:由 SQLAlchemy 作者开发的模板引擎,其执行效率极高。与 Jinja2 的沙箱语法不同,Mako 允许在模板内嵌入原生 Python 代码块,在大型代码生成工程(如复杂的 C/C++ 包装器生成)中应用广泛。
- Python 标准库
ast模块:更底层的语法树代码生成。通过解析与修改 Python 的抽象语法树节点,并借助ast.unparse()生成合规源码,完全避免了字符串拼接带来的缩进与语法破坏。
实战示例:使用 Jinja2 批量生成 Pydantic 数据模型
假设我们有一组外部业务系统提供的 JSON 字段定义,需要将其批量转换为规范的 Python Pydantic BaseModel 类。以下是包含环境配置、模板定义与安全渲染的完整操作代码:
import json
from jinja2 import Environment, DictLoader

# 1. 模拟输入元数据:实体字段定义
schema_data = {
    "class_name": "UserProfile",
    "description": "用户基本资料数据模型,由生成器自动创建。",
    "fields": [
        {"name": "user_id", "type": "int", "required": True, "description": "系统唯一用户标识"},
        {"name": "username", "type": "str", "required": True, "description": "登录用户名"},
        {"name": "email", "type": "str", "required": False, "default": "None", "description": "联系邮箱"},
        {"name": "is_active", "type": "bool", "required": False, "default": "True", "description": "账号激活状态"},
    ]
}

# 2. 定义代码模板(注意:通过减号与空白控制避免破坏 Python 缩进)
template_content = """# -*- coding: utf-8 -*-
# 本文件由代码生成器自动生成,请勿手动直接编辑
from typing import Optional
from pydantic import BaseModel, Field

class {{ class_name }}(BaseModel):
    \"\"\"{{ description }}\"\"\"
{% for field in fields %}
    {%- if field.required %}
    {{ field.name }}: {{ field.type }} = Field(..., description="{{ field.description }}")
    {%- else %}
    {{ field.name }}: Optional[{{ field.type }}] = Field({{ field.default }}, description="{{ field.description }}")
    {%- endif %}
{% endfor %}
"""

# 3. 配置 Jinja2 环境,启用空白修剪配置
env = Environment(
    loader=DictLoader({"model.py.j2": template_content}),
    trim_blocks=True,      # 移除控制块后第一个换行符
    lstrip_blocks=True     # 剔除控制块前的行首空白
)

# 4. 执行渲染
template = env.get_template("model.py.j2")
generated_code = template.render(**schema_data)

# 5. 输出展示
print(generated_code)
运行该程序后,生成的代码严格遵守 Python 的 PEP 8 缩进规范:
# -*- coding: utf-8 -*-
# 本文件由代码生成器自动生成,请勿手动直接编辑
from typing import Optional
from pydantic import BaseModel, Field

class UserProfile(BaseModel):
    """用户基本资料数据模型,由生成器自动创建。"""
    user_id: int = Field(..., description="系统唯一用户标识")
    username: str = Field(..., description="登录用户名")
    email: Optional[str] = Field(None, description="联系邮箱")
    is_active: Optional[bool] = Field(True, description="账号激活状态")
三、主流 AI 代码生成工具与研发协同范式
伴随大语言模型的发展,AI 代码生成器已经从单纯的“语法自动补全”跃升为“具备上下文意识的编程副驾驶”。在 Python 生态中,主流工具已经深度融入日常开发流程:
- GitHub Copilot:最为成熟的行内补全与函数级生成工具。在 VS Code、PyCharm 等编辑器中,通过分析当前文件上文、函数名称以及类型注解,实时以“幽灵文本”呈现候选代码。其特点是低延迟、与打字节奏无缝贴合。
- Cursor:专为 AI 协作打造的独立 IDE。相较于传统插件,Cursor 通过对全代码库建立向量索引与语义图谱,支持使用
Ctrl+K(行内多处重构)以及Composer(跨文件生成并直接修改多处 Python 模块),大幅降低了模块间胶水代码的编写耗时。 - Claude Code 与终端智能体:直接运行在终端命令行中的 AI 代理。能够自主检索项目文件、调用
pytest运行测试、根据报错堆栈回溯分析,并自动执行修复,适合中大型任务的自动化处理。 - 独立对话大模型(ChatGPT / DeepSeek / Claude):用于架构设计、算法原型的快速验证或复杂正则表达式的编写。开发者在 Web 界面输入详细背景,获取参考实现后再人工迁移至项目中。
需要明确的是,AI 工具极易诱发隐式语法错误与依赖幻觉。例如,模型可能在未导入模块的情况下调用某个函数,或者使用某个第三方库在旧版本中已被废弃的方法。因此,在实际工程中,不能单纯依赖肉眼审查,必须建立“提示-生成-测试-修复”的自动化闭环工作流。
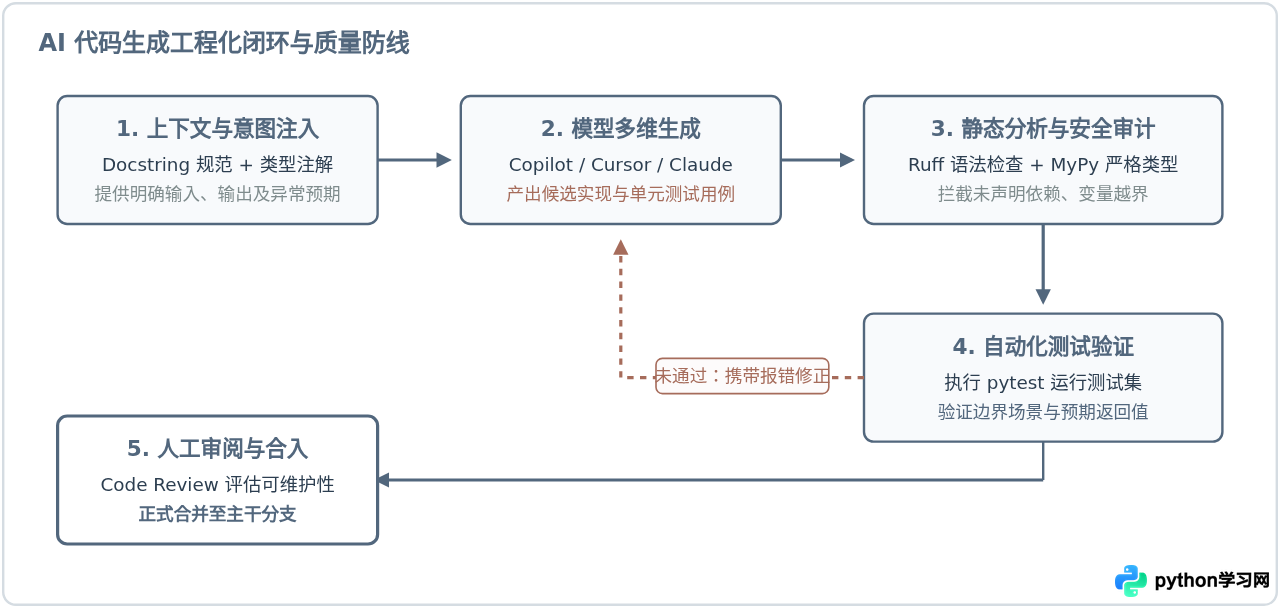
四、核心维度深度对比:模板引擎 vs AI 工具
为了帮助读者根据项目诉求进行准确的技术选型,我们将模板引擎与主流 AI 代码生成工具在 7 个关键技术维度上进行了系统对照:
| 对比维度 | 确定性模板引擎(Jinja2 / Cookiecutter) | 现代 AI 代码工具(Copilot / Cursor / Claude) |
|---|---|---|
| 输出幂等性 | 100% 确定。相同输入数据与模板必得完全一致的代码。 | 概率性输出。即便是相同 Prompt,生成代码也可能存在微小差异。 |
| 幻觉与可靠度 | 零幻觉。只生成模板中明确写出的语法结构。 | 存在幻觉风险。可能臆造不存在的模块参数或调用弃用接口。 |
| 生成灵活性 | 低。只能覆盖模板预先穷举的分支与插槽,无法举一反三。 | 极高。能够理解自然语言描述,自主推理未知业务逻辑。 |
| 上下文感知力 | 无。仅通过显式字典/对象传入参数,无法感知工程全貌。 | 强。能够对项目中同类实现风格、命名规范进行自主模仿。 |
| 初始建设成本 | 较高。必须人工手写模板文件、梳理元数据并反复调试缩进。 | 极低。开箱即用,通过自然语言对话或即时打字提示即可触发。 |
| 长期维护成本 | 极低。契约变更时仅需统一修改模板,一处变更全库刷新。 | 中等。各处生成的代码风格可能离散,需要严格的测试网兜底。 |
| 最佳适用场景 | API 客户端 SDK、数据库 ORM 模型、标准微服务脚手架。 | 业务逻辑编写、复杂算法实现、单测自动补全、代码重构。 |
五、工程最佳实践:双轨混合架构与选型决策
在现代化 Python 项目中,效率最高的团队往往不会孤立使用单一方案,而是采用“模板定骨架,AI填肌肉”的混合模式:
- 使用 Cookiecutter / Copier 建立基础工程标准:通过模板引擎生成标准的模块目录、
pyproject.toml依赖声明、Docker 镜像构建文件以及 pre-commit 钩子。这确保了整个团队所有服务结构的绝对一致性。 - 使用 Jinja2 自动化对接上游契约:当接入外部 gRPC、OpenAPI 或数据库表时,编写持续集成流水线,定时利用 Jinja2 重新生成数据传输对象(DTO)和持久化映射类,杜绝手工复制接口字段引入的笔误。
- 使用 Cursor / Copilot 填充业务算法:在模板定义好的函数签名和测试用例骨架下,借助 AI 工具根据函数注释快速编写内部的具体数据过滤、格式转换和逻辑校验流程。
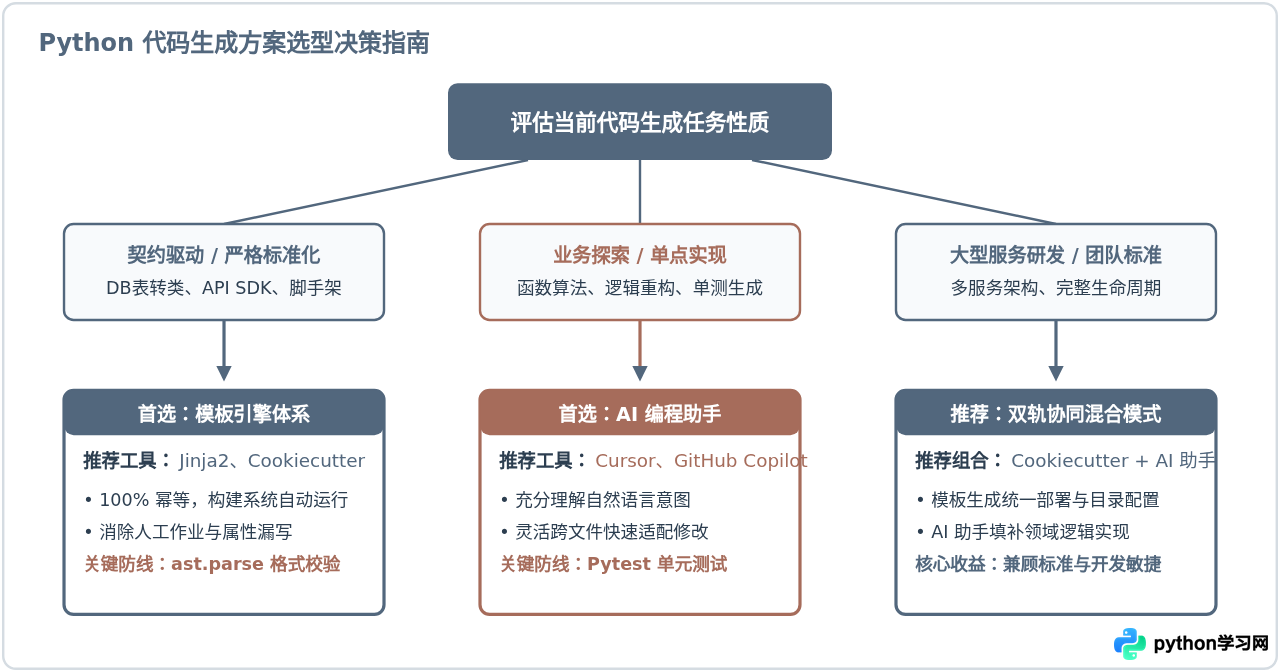
六、常见避坑指南与排错要点
无论采用何种生成方式,自动生成代码后最常遇到的问题集中在缩进语法破坏与依赖缺失两方面:
- Jinja2 缩进破坏与空白残留(IndentationError):Python 语言使用缩进表达代码块,模板中的
{% for %}和{% if %}标签若直接换行,默认会在渲染后的代码中留下空行或错位的空格。解决办法:初始化Environment时务必显式声明trim_blocks=True和lstrip_blocks=True,同时在模板标签中使用减号修剪符号(如{%- if %}),并在文件生成完成后调用ruff format进行标准化格式重整。 - AI 工具生成的“隐式过时 API”:大语言模型根据历史语料训练,在处理快速迭代的 Python 库(如 Pydantic v1 到 v2 迁移、LangChain 接口变更)时,极易生成已废弃的方法(例如在 Pydantic v2 中仍然生成
class Config而非model_config)。解决办法:在 Prompt 中直接指明目标库的具体版本号(如“请基于 Pydantic 2.6+ 语法编写”),并在本地环境配合mypy --strict进行强制类型审查。 - 代码写入安全与语法断言:在将生成的字符串写入磁盘成为实际
.py文件前,强烈建议调用 Python 标准库的ast.parse(code_str)进行一次轻量级语法校验。如果模板拼接或 AI 生成出现不匹配的括号或语法错误,能够在落盘前及时抛出异常,避免损坏已有工程代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















