


Python字符串截取常见错误:IndexError越界与类型问题排查
深入解析Python字符串截取中高频出现的IndexError索引越界与TypeError类型错误成因,涵盖单字符索引与切片容错机制对比、浮点索引踩坑排查及防御性编程最佳实践。
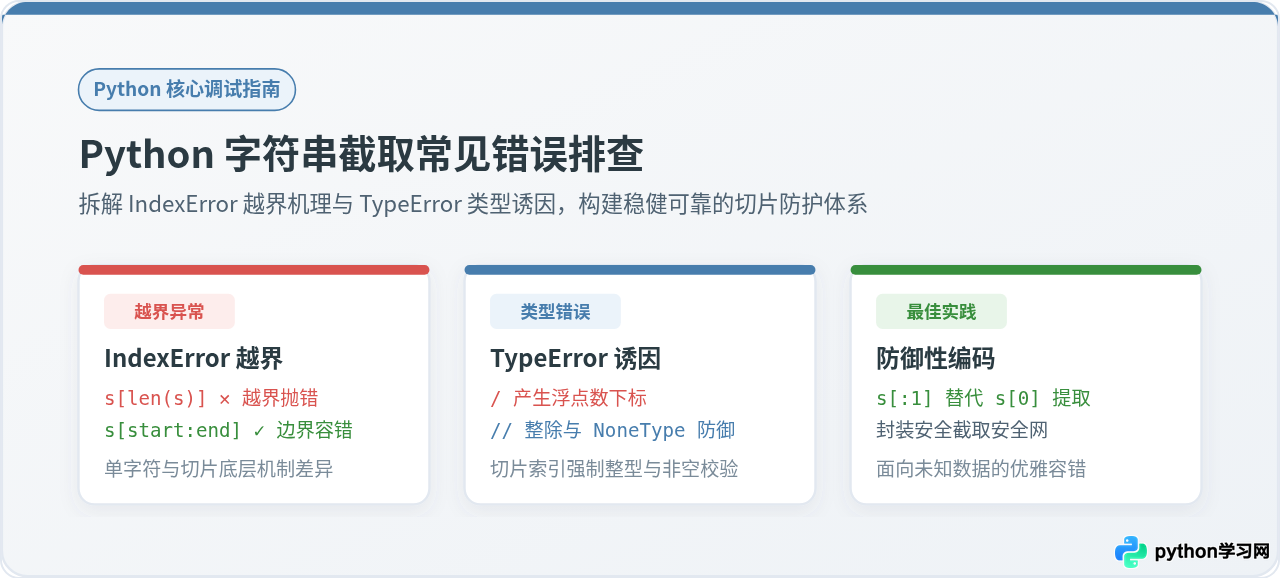
在 Python 开发中,截取字符串或按位置提取子串属于高频的基础操作。初学者在编写索引与切片逻辑时,常常遭遇 IndexError: string index out of range 与 TypeError: string indices must be integers(或 'NoneType' object is not subscriptable)两类阻断性报错。这两类错误通常潜藏在动态数据接入、空值传递、字符串长度估算偏差以及浮点除法运算中。本文将深入剖析索引越界与类型异常的底层生成机理,结合实际代码复现典型触发场景,并给出标准的三步定位排查步骤与防御性编码方案。
一、IndexError 越界报错的产生机理与高频场景
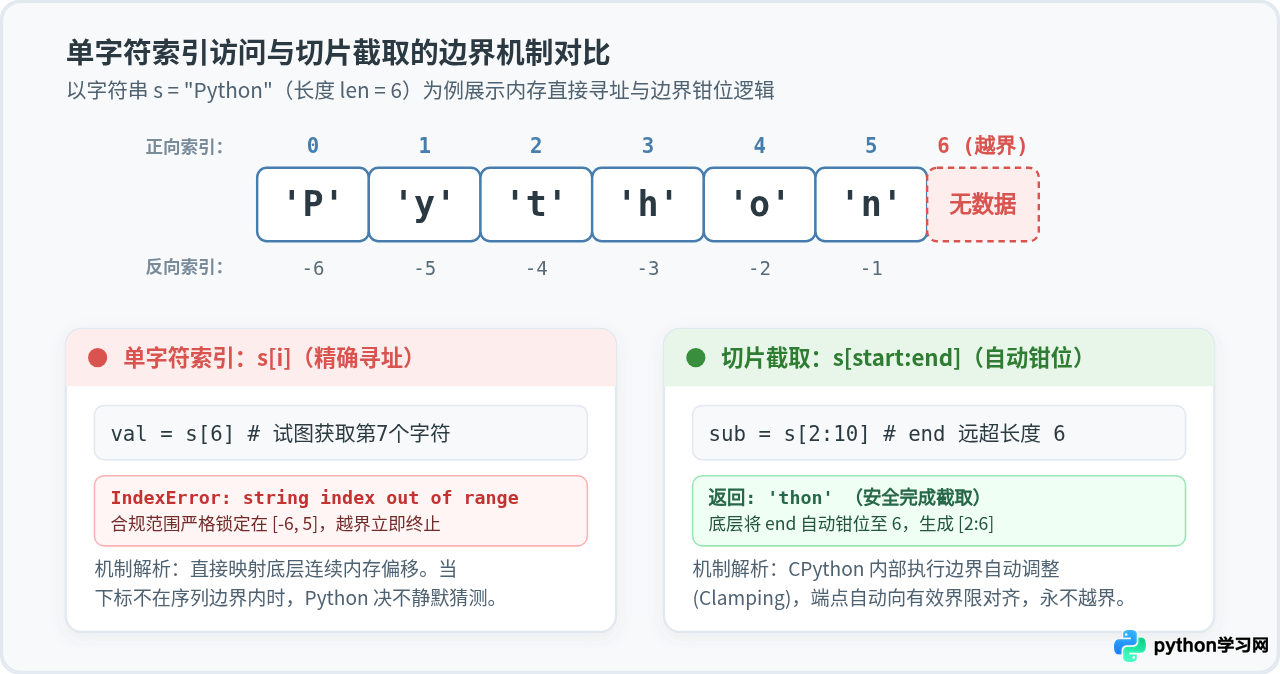
Python 的字符串(str)是定长的不可变有序字符序列。每个字符都在内存中按连续的偏移量编排,支持从左向右(正向索引,以 0 起始)和从右向左(反向索引,以 -1 起始)的双向寻址。理解 IndexError 的关键,在于分清单字符直接索引访问与切片截取的底层策略差异。
1. 单字符访问与切片容错机制的区别
当开发者使用单索引语法 s[i] 取值时,Python 解释器执行的是严格的边界检查。若字符串长度为 L,则合法索引范围仅为 [-L, L - 1]。一旦给定的 i >= L 或 i < -L,解释器判定该寻址无对应内存元素,立即抛出 IndexError: string index out of range。
与单字符索引不同,切片语法 s[start:end:step] 在底层实现(CPython 的 PySlice_GetIndicesEx 函数)中具备内置的边界钳位(Clamping)容错机制:
- 若
start或end超过了字符串的实际长度L,Python 会自动将其截断并限制在有效边界[0, L]内; - 若
start >= end(正步长下),切片不会报错,而是直接返回空字符串""; - 因此,纯粹使用标准切片语法
s[start:end]时,即使端点传入9999,也永远不会触发IndexError。
2. 四大典型 IndexError 越界场景分析
场景 1:差一错误(Off-by-one Error)误用长度值
由于字符串的索引是从 0 到 len(s) - 1,初学者容易顺拐地将 len(s) 直接作为最后一个字符的下标传给单索引:
# 示例环境:Python 3.9+ 控制台交互环境
text = "Antigravity"
# 错误做法:试图读取最后一个字符
last_char = text[len(text)]
排查与纠正:获取末尾字符应使用负索引 text[-1],或者 text[len(text) - 1]。
场景 2:未前置校验的空字符串直接访问
当数据来源于用户输入、文件逐行解析或网络接口时,容易遇到空字符串 ""。此时字符串的长度为 0,合法正负索引区间均为空集,执行任何 s[0] 或 s[-1] 都会瞬间崩溃:
def get_user_initial(name_str):
    # 错误写法:未判空直接取首字母
    return name_str[0].upper()

# 当输入为空字符串时:
initial = get_user_initial("")场景 3:反向索引绝对值超出序列界限
很多开发者熟悉用 s[-3:] 取后三个字符,但在写单字符取倒数第三个字符 s[-3] 时,若传入字符串长度不足 3(例如 "ok"),就会因为 |-3| > 2 导致越界抛错。
场景 4:把单索引误当成区间截取
在代码重构或笔误中,原意是截取前 5 个字符(应写为 s[:5]),结果漏写了冒号变为 s[5]。在短字符串输入时便会偶发性爆出越界异常。
二、TypeError 类型相关错误的触发根因与场景透视
除了越界,在做字符串截取时引发的另一大类故障是 TypeError。这类错误通常与 Python 动态类型特性、除法运算符在 Python 3 的语义变动,以及对非字符串对象的数据结构误判有关。
1. 浮点数下标:除法运算符 / 产生的隐蔽陷阱
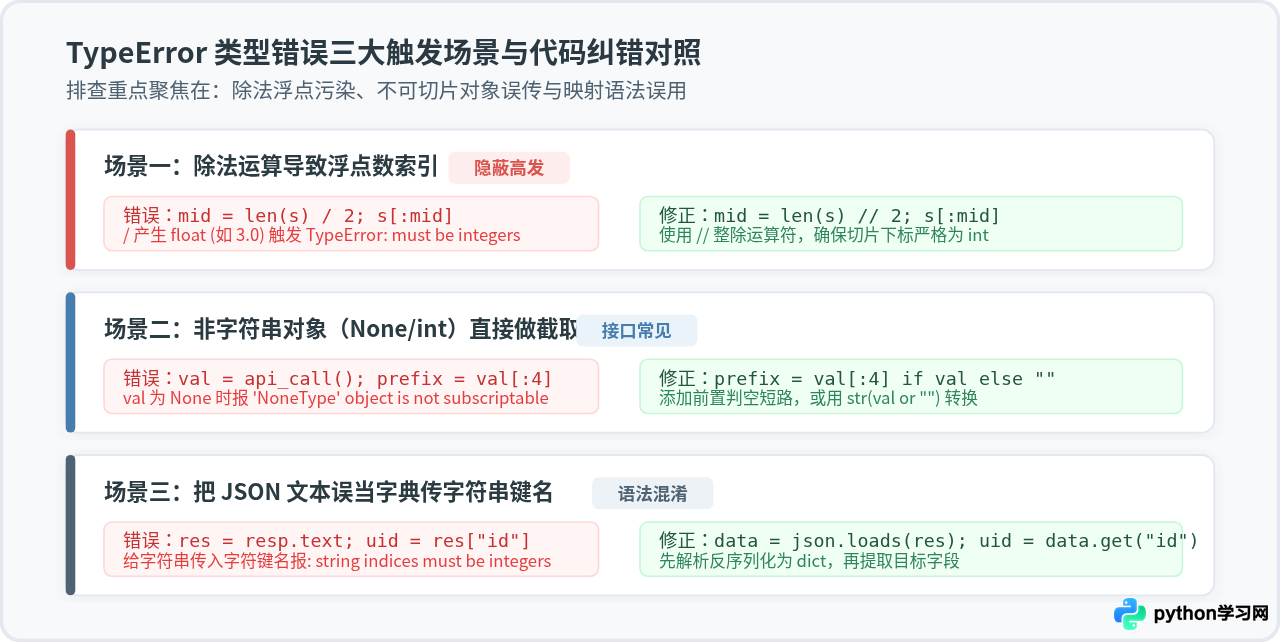
在 Python 3 中,标准除法运算符 / 即使能够整除,返回的结果也始终是浮点数(float)。例如 len("python") / 2 的计算结果是 3.0 而不是 3。而 Python 明确规定切片的起止索引必须为整数(或 None,或实现了 __index__ 方法的类型)。
# 场景:将字符串从中间平分为两半
s = "abcdef"
mid = len(s) / 2  # 得到 float 类型的 3.0

# 触发报错:
left_part = s[:mid]
排查与纠正:在计算切片索引值时,必须使用双斜杠整除运算符 //,或者显式包裹 int() 转换:mid = len(s) // 2。
2. 不可下标访问对象:NoneType 与数值对象的非预期透传
在实际生产中,从数据库查询、第三方 HTTP 接口或正则匹配获取数据时,如果匹配失败或字段缺失,上游变量通常会被赋值为 None。如果开发者假设其一定为字符串并直接执行切片:
import re

def extract_domain_prefix(url):
    match = re.search(r"https?://([^/]+)", url)
    # 若匹配失败,match 为 None,match.group(1) 将报错;
    # 假设某一分支函数返回了 None
    domain = None
    return domain[:4]  # 对 NoneType 切片

extract_domain_prefix("invalid-url")
同理,当读取 Excel 或 JSON 中的订单号、手机号时,数字如果被自动解析为了 int 类型,直接执行 order_id[:4] 会报出 TypeError: 'int' object is not subscriptable。
3. 语法混淆:把未反序列化的字符串当作字典
在调用 Web 接口获取响应内容时,如果误把原始响应体字符串 response.text 当作已经解析好的 Python 字典对象,并尝试使用键名访问:
raw_json = '{"status": "ok", "code": 200}'
# 错误做法:直接在字符串上使用字典取值方式
status = raw_json["status"]
排查与纠正:必须先通过 json.loads(raw_json) 完成反序列化,再对字典对象按键取值。
三、故障排查指南:从 Traceback 到根因定位四步法
面对线上环境或本地测试中抛出的字符串截取错误,应当遵循一套条理清晰的定位排查流程,避免盲目猜测或随意修改。
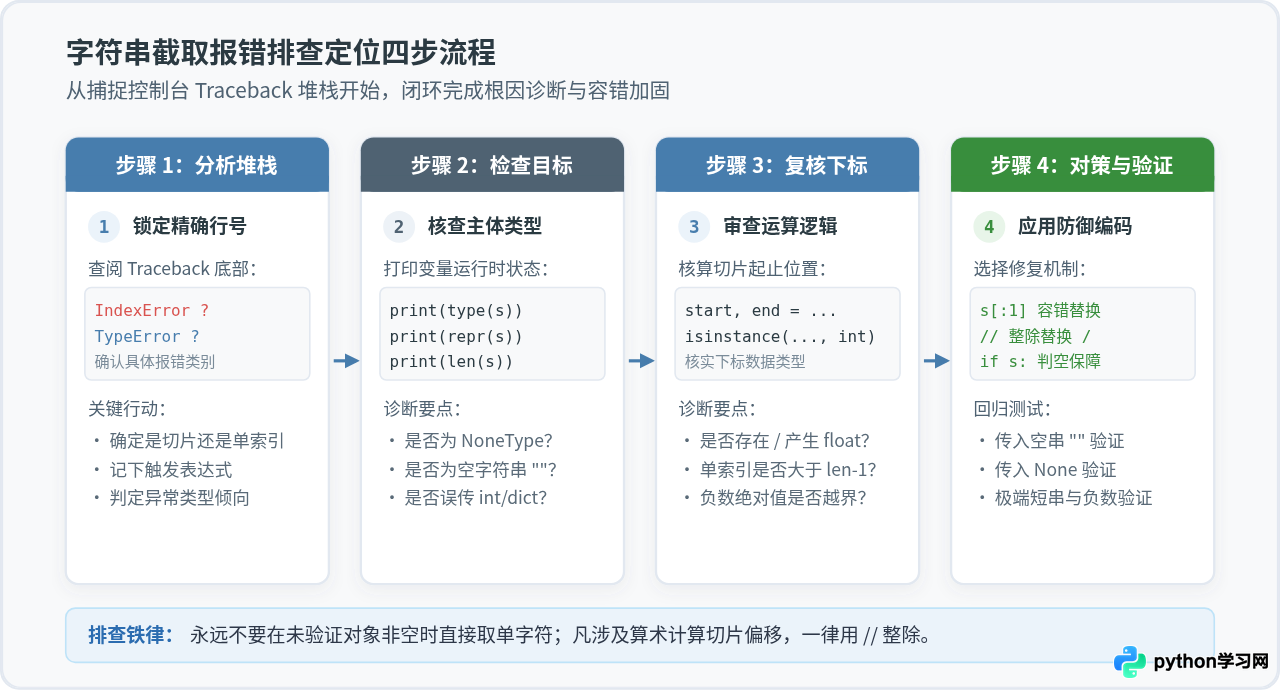
步骤 1:精确解析 Traceback 异常信息
当程序抛错退出时,查看终端输出的最底部。重点看两点:
- 锁定具体文件与行号:注意报错栈最下一级的
File "...", line XX; - 区分确切异常名称:
IndexError: string index out of range说明是索引数值超限,且一定是单字符访问[],不可能是标准切片;TypeError: string indices must be integers...说明目标变量确实是字符串,但方括号内的下标数据类型有误(例如传入了 float 或 str);TypeError: '...' object is not subscriptable说明目标变量本身不是字符串(通常是 NoneType 或 int),它根本不支持方括号下标操作。
步骤 2:现场打印或断点审查目标变量(Target)
在报错代码行的上一行插入调试打印语句,或者使用 pdb.set_trace() 进行断点检查:
# 排查调试段
print(f"目标值: {repr(target)}, 类型: {type(target)}, 长度: {len(target) if hasattr(target, '__len__') else 'N/A'}")
此步骤能瞬间查明变量是否意外变成了 None,或者是否为空字符串 "",以及长度是否符合预期。
步骤 3:复核下标运算公式与表达式(Index)
如果目标变量类型正常,紧接着打印切片起止位置的计算结果:
# 审查下标计算
start_pos = calculate_start()
end_pos = calculate_end()
print(f"start: {repr(start_pos)} ({type(start_pos)}), end: {repr(end_pos)} ({type(end_pos)})")
核实其中是否存在浮点数运算(如除法 / 计算未做整除转换),或者计算逻辑在特殊分支下输出了负数或超大数字。
步骤 4:选用稳健方案修复并执行回归验证
根据定位到的根因实施对策:是补充前置判空、切换为整除 //,还是使用具有容错特性的切片写法代替单索引。修复后,构造包含空串 ""、单个字符 "a"、超长文本以及 None 边界输入单元测试用例,确认无二次报错。
四、安全截取防御性编程实践
为了避免在业务代码中反复踩中 IndexError 与 TypeError,在日常开发中推荐采用以下防御性编码范式。
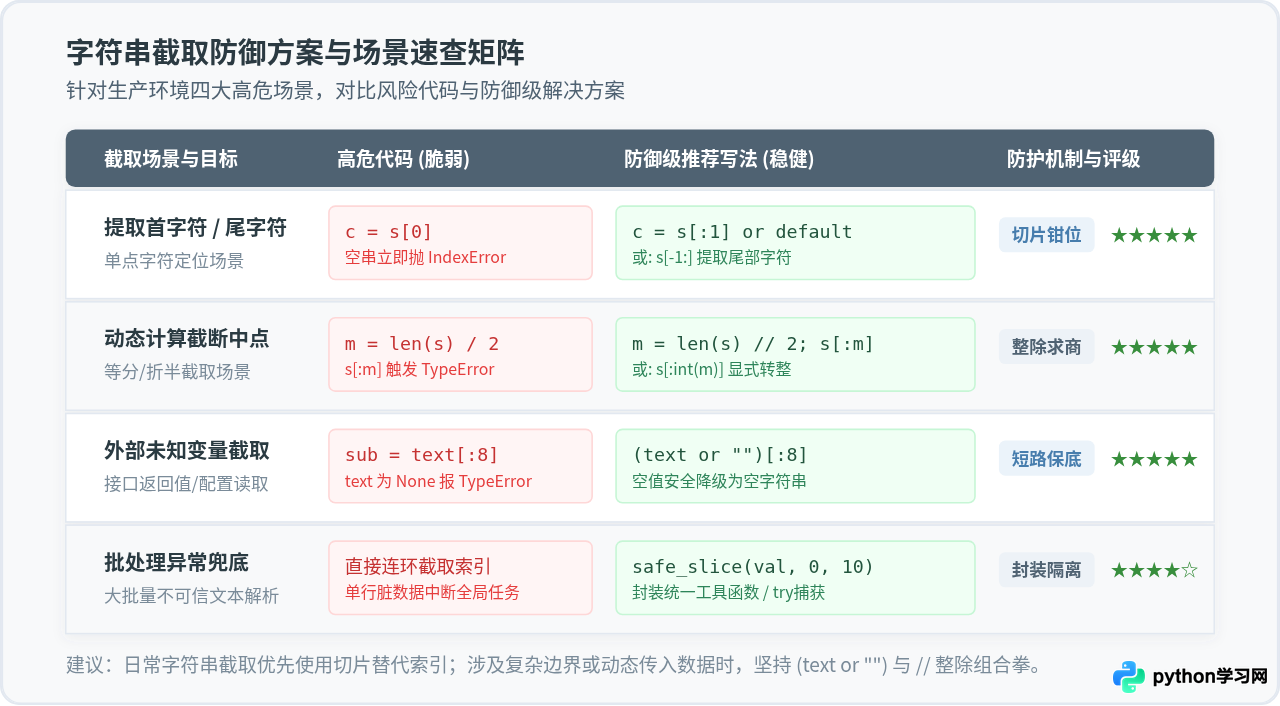
1. 巧妙使用“切片替代单字符索引”
在需要提取字符串第一个字符或末尾字符时,初学者习惯写 s[0] 或 s[-1],这在遇到空字符串时会立刻崩溃。利用切片自带的边界钳位容错机制,可以用切片替代单字符索引:
# 传统脆弱写法:
first = s[0]   # s 为 "" 时直接 IndexError 崩溃

# 防御性稳健写法:
first = s[:1]  # s 为 "" 时安全返回 "",绝不抛错
last = s[-1:]  # 提取最后一个字符,空串同样安全返回 ""

# 若需要提取后提供默认值:
initial = (s[:1] or "N/A").upper()
2. 基于 LBYL 风格的前置短路与类型保底
在处理多来源、不可信的外部变量时,采用“检查后再做(Look Before You Leap)”模式,前置规避 None 与非字符串类型:
# 确保目标一定为非 None 字符串
safe_str = text if isinstance(text, str) else ""

# 进一步安全截取前 10 个字符
prefix = safe_str[:10]
3. 通用安全截取函数封装
在处理大批量文本清洗、爬虫解析或日志分析时,可以提炼通用的安全截取辅助函数,统一管理异常与默认值:
def safe_substr(val, start=0, length=None, default=""):
    """
    防御式安全字符串截取工具函数
    :param val: 任意待截取的输入对象
    :param start: 起始位置(支持 int,浮点数自动转整)
    :param length: 截取长度(None 表示截取至末尾)
    :param default: 当输入为 None 或无法解析时的兜底返回
    :return: 截取后的子字符串
    """
    if val is None:
        return default

    # 强制将非字符串安全转为字符串
    if not isinstance(val, str):
        val = str(val)

    try:
        # 下标类型强转校验,防御 float 等非法类型
        int_start = int(start)
        if length is not None:
            int_end = int_start + max(0, int(length))
            return val[int_start:int_end]
        return val[int_start:]
    except (ValueError, TypeError):
        return default

# 验证效果:
print(repr(safe_substr("Antigravity", 0, 4)))      # 输出: 'Anti'
print(repr(safe_substr("", 0, 2)))                 # 输出: '' (不崩溃)
print(repr(safe_substr(None, 0, 2, default="--"))) # 输出: '--' (优雅兜底)
print(repr(safe_substr(1234567, 2, 3)))            # 输出: '345' (自动类型兼容)
print(repr(safe_substr("Python", 2.8, 2)))         # 输出: 'th' (浮点平滑转整)
4. 异常捕获机制(EAFP 风格)作为最后防线
对于复杂的结构化数据解析流程,若无法逐一穷举边界分支,可以使用 try-except 明确捕获 (IndexError, TypeError),并记录日志或提供默认降级方案:
def parse_order_code(raw_data):
    try:
        # 复杂业务链式截取逻辑
        code = raw_data["info"]["serial_number"]
        return code[:8].upper()
    except (KeyError, IndexError, TypeError) as exc:
        # 精准捕获相关异常,避免粗暴的 except Exception 掩盖系统级致命错误
        print(f"数据解析异常,启用默认占位编码。原因: {exc}")
        return "UNKNOWN_CODE"
五、总结
排查与避免 Python 字符串截取错误,核心在于掌握以下三条原则:
- 分清单字符索引与切片的本质区别:单字符索引
s[i]属于严格边界检查,越界必报IndexError;切片s[start:end]具备自动钳位特性,不会发生越界报错。提取单字符推荐优先使用s[:1]替代s[0]; - 警惕除法运算符的类型污染:在动态计算切片索引值时,牢记 Python 3 的
/返回浮点数,必须使用//整除运算符确保下标为整数; - 严守输入类型边界:处理外部接口与动态参数时,先做好非空检查与类型保护,善用
(text or "")[:N]惯用法,彻底阻断TypeError的产生。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















