


Python可变与不可变数据类型详解:list、dict与tuple的本质区别
深入剖析Python中可变与不可变数据类型的底层机制。结合CPython内存模型与指针实现,系统解析list、dict与tuple的本质区别、原地修改与重新绑定的底层差异、元组的薛定谔不可变性以及工程开发中的避坑准则。
在 Python 中,“一切皆对象”不仅是一句编程格言,更是理解语言运行机制的基石。很多初学者在编写代码时,常会遇到列表元素莫名被篡改、函数默认参数在多次调用间相互污染、或者向字典插入元组键时偶发报错等反直觉现象。这些问题的根源,均在于未能彻底厘清“变量赋值”、“对象引用”以及“可变与不可变类型”在内存底层所遵循的绝对物理法则。本文将彻底拆解 list、dict 与 tuple 的本质区别,帮助你建立清晰的底层运行图景。
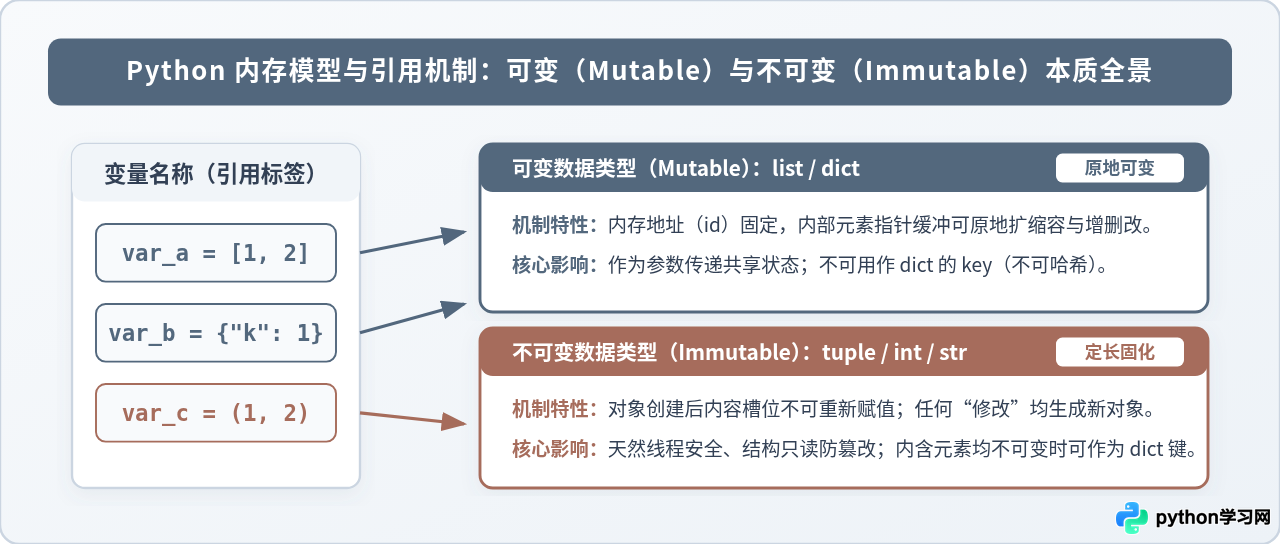
一、变量不是盒子,而是贴在对象上的“便利贴”
要透彻理解可变性,必须先破除 C/C++ 等低级语言带来的思维定势。在传统编译型语言中,声明一个整型变量 int a = 1; 相当于在栈内存中开辟了一块固定大小的物理盒子,把数值 1 存入盒中;当执行 a = 2; 时,是将盒子里的内容覆写为 2,变量 a 的内存地址自始至终未曾改变。
但在 Python 中,变量名本质上只是指向堆内存中具体对象的指针(引用标签)。每一个 Python 对象在 CPython 底层都被封装为一个 PyObject 或其派生结构体,其内存实体至少包含三个固定头部字段:
- 引用计数(ob_refcnt):记录当前有多少个变量名或容器引用了该对象,归零时触发垃圾回收(GC)。
- 类型指针(ob_type):指向描述该对象类型的 Type 对象(如
&PyList_Type、&PyTuple_Type)。 - 数值/数据缓冲区(ob_size 及数据项):存放对象实际负载的内容或下级对象的二级指针。
通过内置函数 id(),我们可以获取对象在内存中的虚拟地址(在 CPython 中就是该 PyObject 结构体的首地址指针)。使用 is 运算符,比较的正是两端操作数的 id 是否完全一致。
# 实验 1:不可变对象 int 的“重新绑定”
x = 1000
print(id(x))   # 示例输出:4392018256

x = x + 1
print(id(x))   # 示例输出:4392018320 (内存地址已彻底变更!)
上述代码中,x = x + 1 并非把原来地址里的 1000 改成了 1001,而是计算表达式后,在内存中重新开辟了一个容纳 1001 的全新整数对象,并将变量名 x 重新贴(Re-bind)到了新对象上。原有的 1000 对象若无其他引用,其 ob_refcnt 便会递减。
二、图解底层机制:原地修改(In-Place)与重新绑定(Re-binding)
明白了解析变量与对象的标签关系后,可变(Mutable)与不可变(Immutable)的本质定义便水落石出:
- 不可变数据类型(Immutable):对象一经在内存中初始化完成,其内部状态和槽位就绝对只读,禁止原地改写。任何对它的“修改”语法(如元组拼接、字符串切片拼接),在底层都必定是“开辟新内存空间 ➔ 构建新对象 ➔ 将变量名重新绑定至新地址”。常见类型包括:
int,float,str,tuple,frozenset,bytes。 - 可变数据类型(Mutable):对象在内存中的首地址(
id)保持恒定,但其内部所维护的数据指针缓冲区允许在原地进行动态扩缩容、追加、覆写或删除元素。常见类型包括:list,dict,set,bytearray。
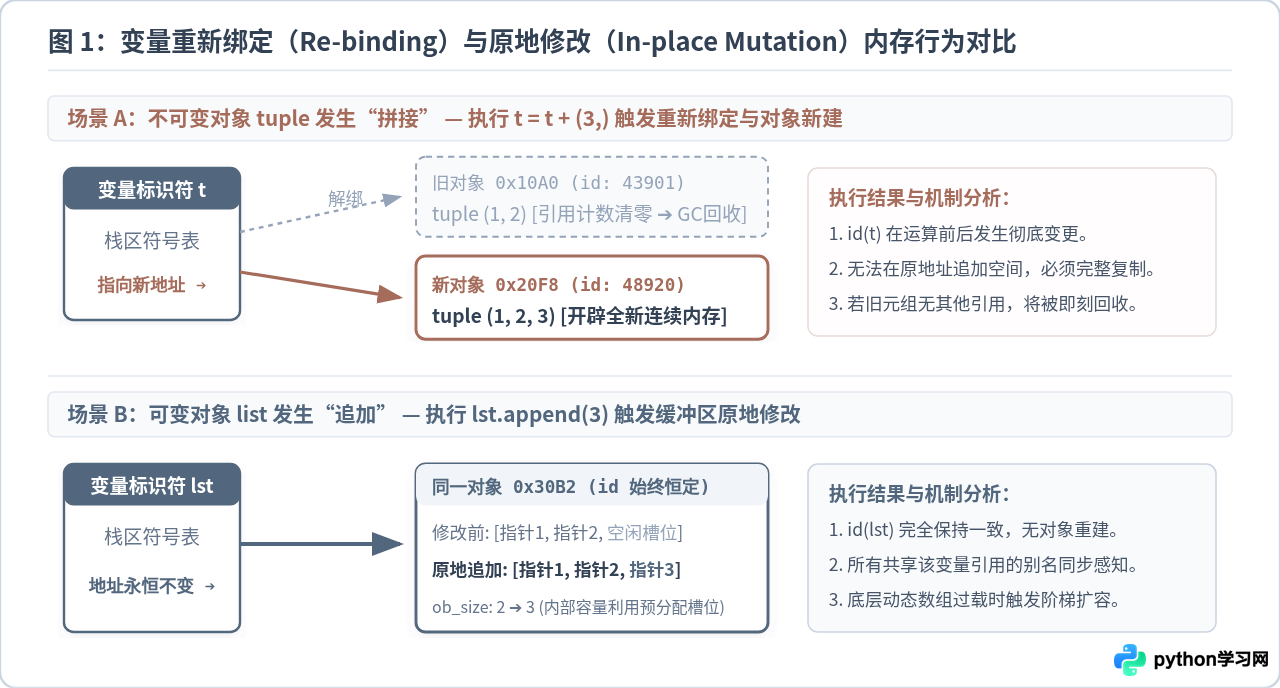
请观察上方图 1 中两组对照操作在物理层面引发的连锁反应:
# 验证不可变元组 tuple:触发重新绑定
t1 = (1, 2)
orig_id_t = id(t1)
t1 += (3,)
print(id(t1) == orig_id_t)  # 输出:False!创建了新元组

# 验证可变列表 list:原地增删改
lst1 = [1, 2]
orig_id_l = id(lst1)
lst1.append(3)
print(id(lst1) == orig_id_l) # 输出:True!地址完全保持原样
这一本质差异直接决定了程序在多变量共享引用时的表现。当执行 lst2 = lst1 时,两个变量名同时贴在同一个内存对象上;随后通过 lst2.append(99) 进行原地修改,通过 lst1 观察会发现它同样发生了改变。因为它们访问的是同一块物理内存。而对 t2 = t1; t2 += (99,) 而言,t2 只是改签到了新元组,t1 依旧岿然不动。
三、list、dict 与 tuple 的物理构造与源码剖析
为什么这三种容器会展现出迥异的特性?我们必须深入 CPython 解释器的 C 语言源码结构体,一探其物理构造。
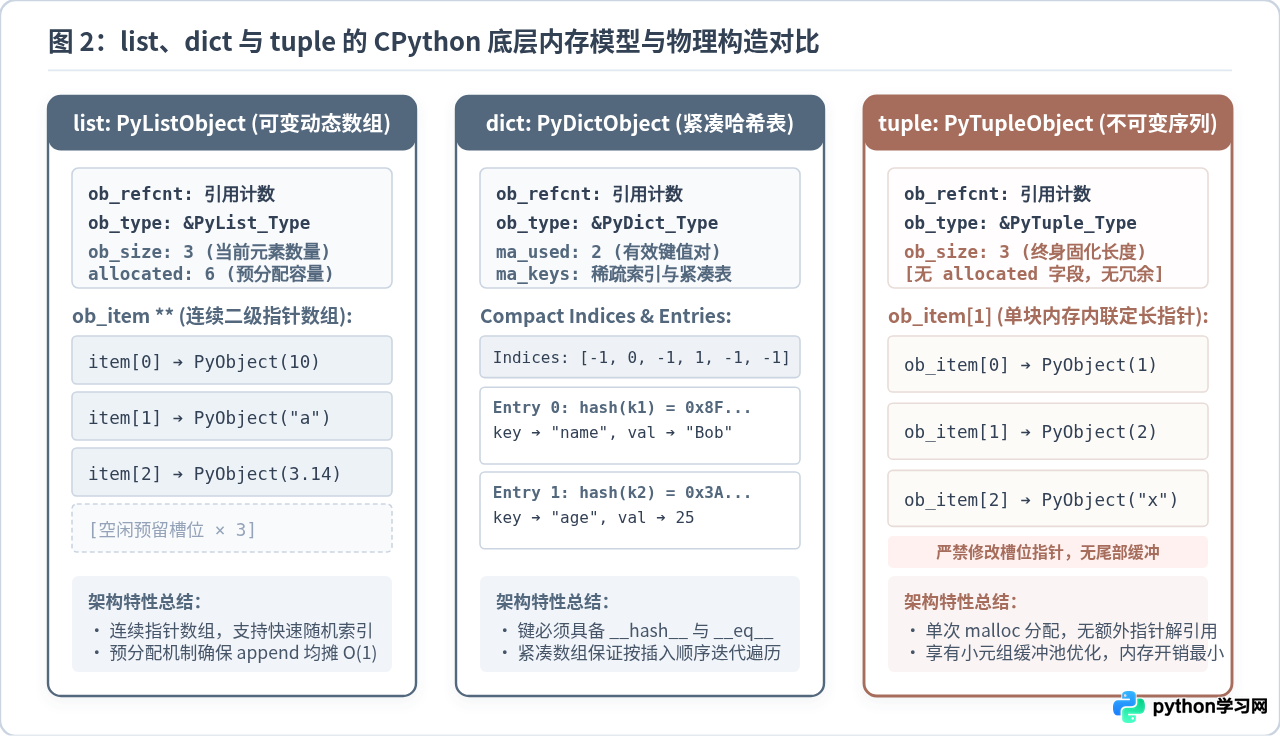
1. 列表 list(PyListObject):连续指针的动态缓冲数组
在 CPython 源码中,list 对应 PyListObject。它并不是链表,而是一个二级指针动态数组。结构体中包含 ob_size(当前包含的元素个数)、allocated(当前向系统实际申请分配的槽位容量),以及核心的 PyObject **ob_item 指针数组。
为了避免每次执行 append() 时都向操作系统请求 malloc 重新分配内存,Python 采用了一种过度分配(Over-allocation)策略。公式如下:
/* CPython 源码中 list_resize 的分配策略 */
new_allocated = ((size_t)newsize + (newsize >> 3) + 6) & ~(size_t)3;
这意味着当列表元素增长超过当前容量时,Python 会提前预留数个甚至数十个空闲槽位。此时向尾部添加元素仅需执行槽位写入和 ob_size++,其均摊时间复杂度为优雅的 \(O(1)\)。但如果在列表中间插入或弹出头部(如 insert(0, val)、pop(0)),则必须将受影响索引后的所有指针物理平移,时间复杂度骤降为 \(O(n)\)。
2. 字典 dict(PyDictObject):紧凑高效的散列表
在 Python 3.6 之前,字典是一个稀疏的大散列表,每个槽位同时存放哈希值、Key 指针和 Value 指针,造成大量内存空洞。自 Python 3.6(并在 3.7 正式写入语言规范)引入了 PyPy 风格的紧凑字典(Compact Dict):
- 稀疏索引表(Indices Array):一个紧凑的小整数数组(根据大小选用
int8、int16等类型),下标对应 Key 的哈希探测位置,值存储条目表的真实行号。 - 紧凑条目表(Entries Array):按元素插入顺序紧密排列的结构体数组,每个元素包含
(me_hash, me_key, me_value)。
当查询 d[key] 时,解释器先计算 hash(key),通过位运算定位到稀疏表的对应索引,取得行号,再直接跳转到条目表读取键值并进行 __eq__ 二次比对。这种架构不仅将字典的内存占用削减了近 30%,更带来了**字典天然保留键值对插入顺序(Insertion-ordered)**的语言特性。
3. 元组 tuple(PyTupleObject):极致精简的单一内存块
与 list 相比,tuple 对应的 PyTupleObject 极其纯粹。它没有 allocated 扩容字段,其结构体尾部直接内联了定长的 PyObject *ob_item[1] 变长数组指针。
因为元组的生命周期内绝不增删槽位,CPython 在实例化元组时只需执行一次单块内存分配(Single malloc),将元组头与所有元素指针一次性打包载入内存。此外,CPython 为长度不超过 20 的小元组实现了 free_list(空闲释放池),当小元组销毁时,其结构体内存不会真正交还操作系统,而是挂入空闲链表供下一次快速复用,极大地减轻了频繁分配释放的性能损耗。
四、元组的“薛定谔不可变性”:嵌套容器的陷阱
很多开发者曾困惑于这样一个事实:元组既然是不可变对象,为什么有时却能被“篡改”?
请记住这条铁律:元组的不可变性,仅且仅限制元组自身物理持有的指针地址(引用)不可变更,而绝不约束这些指针所指向的目标对象是否可变。
# 实验 2:向元组内的列表追加元素
t = (1, [2, 3])
print(id(t[1]))       # 记录列表的内存地址

t[1].append(99)       # 执行成功!
print(t)               # 输出:(1, [2, 3, 99])
print(id(t[1]))       # 列表的内存地址完全没变
在上面的代码中,t[1] 所存储的仅仅是指向那个列表对象的 64 位指针地址。当执行 t[1].append(99) 时,修改的是那个列表对象内部的缓冲区,而 t[1] 中存放的指针物理值自始至终未发生任何变化,因此完全没有违反元组的不可变契约。
如果对上面的元组执行 t[1] += [100],会发生极其诡异的现象:程序抛出了 TypeError: 'tuple' object does not support item assignment 异常,但打印 t 却发现 100 竟然被成功添加进去了!
底层原因拆解:Python 字节码在执行 += 操作时,第一步调用 list.__iadd__,这属于原地修改,列表成功追加了元素并返回自身;第二步,字节码试图将返回的列表指针写回 t[1](触发 STORE_SUBSCR 指令)。然而元组的槽位是只读的,写回操作直接触发 TypeError 抛出。但此时第一步的原地修改早已生效!因此,切勿在元组中的可变元素上使用增量赋值运算符。
可哈希性(Hashability)与字典键资格
在 Python 中,一个对象要想作为字典的 Key 或者存入集合 set,必须满足可哈希(Hashable)的要求:
- 该对象必须实现
__hash__()方法,且在整个生命周期内哈希值绝对恒定。 - 该对象必须实现
__eq__()方法,用于解决哈希碰撞时的相等性检验。 - 若两个对象相等(
a == b为真),则它们的哈希值必须完全相同(hash(a) == hash(b))。
如果允许一个可变对象(如 list)作为字典的 Key,当该列表在外部被 append() 修改后,若其哈希值改变,字典就再也无法通过初始哈希值定位到原槽位,整张散列表的完整性将瞬间崩溃。因此,CPython 明确将 list、dict、set 的 __hash__ 设为 None,一旦调用直接抛出 TypeError: unhashable type。
而元组 tuple 默认实现了 __hash__()。但如果元组内部嵌套了任何不可哈希的可变对象(例如 (1, [2])),计算其哈希值时同样会因内部元素无法计算哈希而抛出异常。只有当元组内的所有元素均具备可哈希性时,该元组才真正具备作为字典 Key 的资格。
五、工程实践中的选型路径与避坑决策
在真实系统的架构与编码中,如何准确选择容器类型并规避可变性带来的副作用?请参照图 3 中的标准决策流。
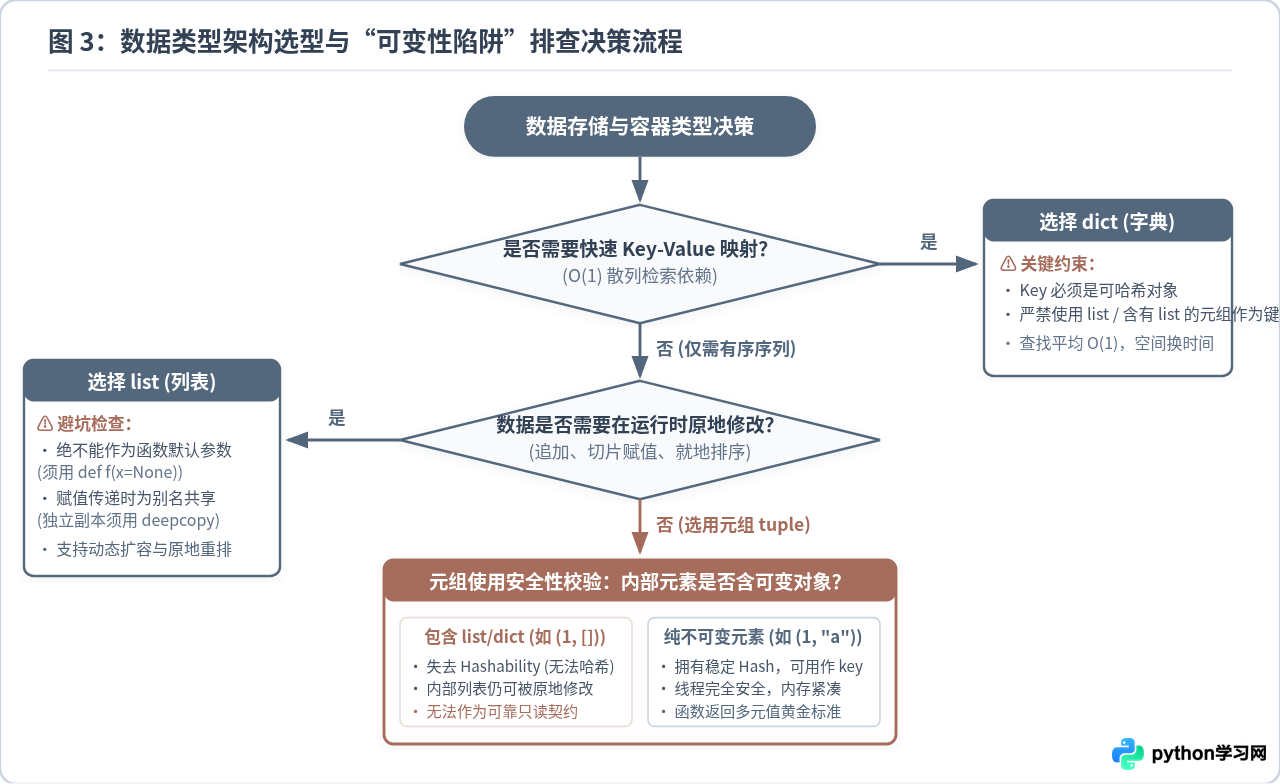
避坑 1:绝对禁止使用可变对象作为函数默认参数
这是 Python 开发者最常遭遇的高危陷阱之一。请看如下反模式:
# 错误示范:使用可变列表作为默认值
def add_user(user_id, user_list=[]):
    user_list.append(user_id)
    return user_list

print(add_user("Alice"))  # 输出:['Alice']
print(add_user("Bob"))    # 惊天陷阱:输出 ['Alice', 'Bob']!
为什么会这样?因为在 Python 中,函数也是一级对象(PyFunctionObject)。def 语句是在模块加载时执行的,函数的默认参数表达式只会在函数定义时被求值一次,并被永久保存在该函数对象的 __defaults__ 属性元组中。
每次调用 add_user 且未显式传参时,形式参数 user_list 绑定的均是同一个驻留在 __defaults__ 中的列表对象!对其执行 append(),该函数的所有后续调用都会看到历史累积的数据污染。
工程标准规范解法:使用不可变的单例对象 None 作为哨兵值。
# 标准规范:None 哨兵写法
def add_user(user_id, user_list=None):
    if user_list is None:
        user_list = []  # 每次调用独立创建新列表
    user_list.append(user_id)
    return user_list
避坑 2:浅拷贝(Shallow Copy)与深拷贝(Deep Copy)的界限
对可变容器执行 lst[:]、lst.copy() 或 dict.copy(),仅仅是浅拷贝。浅拷贝会创建一个新的外层容器,但其内部所有的子元素仅仅是复制了原有的指针引用。
import copy

matrix = [[1, 2], [3, 4]]
shallow_m = matrix.copy()
deep_m = copy.deepcopy(matrix)

matrix[0][0] = 999
print(shallow_m[0][0])  # 输出:999 (受到连带修改!)
print(deep_m[0][0])     # 输出:1 (完全隔离安全)
当数据结构存在多层嵌套时,若需要实现真正独立的数据副本,必须显式调用 copy.deepcopy() 进行递归对象复制。
六、全景速查矩阵与总结
为了帮助你在实际架构开发与代码审查中快速作出精确判断,下表与全景图完整归纳了 list、dict 与 tuple 在核心维度的技术指标:
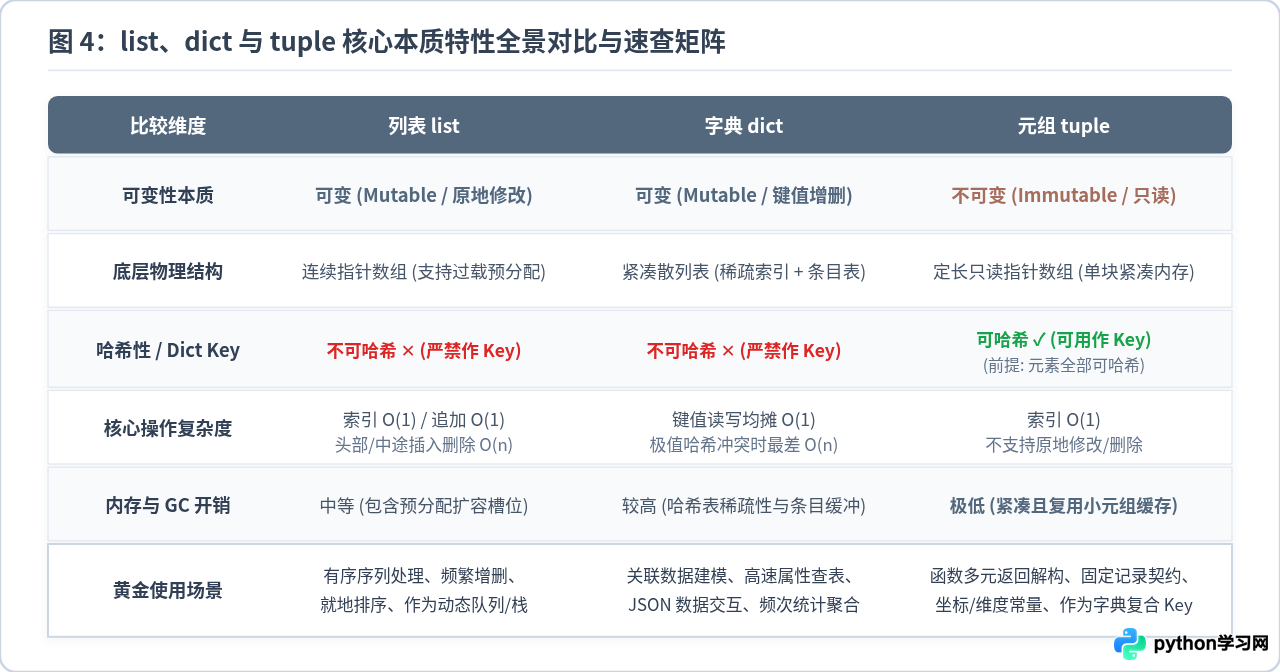
| 特性指标 | 列表 (list) | 字典 (dict) | 元组 (tuple) |
|---|---|---|---|
| 可变性本质 | 可变 (Mutable) | 可变 (Mutable) | 不可变 (Immutable) |
| 底层数据结构 | 动态连续指针数组 (PyListObject) | 紧凑散列表 (Indices + Entries) | 定长只读指针数组 (PyTupleObject) |
| 内存开销 | 中等 (预留 Over-allocation 扩容空间) | 较高 (需维护哈希稀疏表与条目元数据) | 极低 (单次分配,享有小元组缓存池) |
| 哈希性与 Key 资格 | 不可哈希 (禁止作字典键或集合元素) | 不可哈希 (禁止作字典键或集合元素) | 可哈希 (前提是内部所有元素均可哈希) |
| 按键/索引查找 | 索引 \(O(1)\),按值查找 \(O(n)\) | 均摊 \(O(1)\) (散列寻址计算) | 索引 \(O(1)\),按值查找 \(O(n)\) |
| 线程安全属性 | 原地操作非线程安全 (多线程写需加锁) | 原地增删非线程安全 (并发需加锁) | 结构只读,具备天然的读并发安全性 |
| 最佳应用场景 | 动态序列集合、队列/栈、频繁数据追加排序 | 结构化对象建模、属性映射、高速查表、缓存 | 函数多返回值打包、不可变配置契约、复合键 |
- 传递确定性契约优先选
tuple:如果一组数据在生命周期内无需改动(例如经纬度坐标、数据库连接参数、函数返回的多个解构值),果断使用元组。它不仅内存开销更小、加载速度更快,而且向调用方明确传递了“只读防篡改”的语义契约。 - 动态收集操作优先选
list:当数据处于持续收集、流式过滤、原地翻转或追加的生命周期阶段,使用动态数组list,但切记不要将其暴露为默认参数或非受控全局状态。 - 高速映射与属性关联选
dict:涉及快速定位与关系映射时使用字典,并始终牢记只有具备稳定生命周期哈希特征的不可变类型(str、int、纯不可变tuple),才有资格充当哈希键。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















