


Python中字符与字节的区别:字符串编码本质解析
深入解析Python中字符(str)与字节(bytes)的核心区别与底层逻辑,通过内存模型、编解码转换、I/O实战与Unicode三明治模型,帮助开发者彻底理清字符与字节的转化边界。
在 Python 3 中,文本处理的核心建立在一分为二的类型体系之上:str(字符串)表示人类可读的抽象文本字符,而 bytes(字节串)表示计算机底层存储与传输的二进制原始字节。两者的桥梁是编码(encode())与解码(decode())。理解这一区别不仅能消除常见的乱码报错,更能帮助开发者建立清晰的数据边界意识。
一、类型本质对比:抽象符号与物理字节
在计算机世界中,“文字符号”本身是一种高级语义抽象,底层硬件无法直接存储诸如“中”或“Python”这样的图形符号。为了让程序能够高效且严谨地处理信息,Python 3 对字符与字节作出了严格的类型切分:
str(字符串):内存中存储的是 Unicode 码点序列(Code Points)。每一个字符对应一个独立的符号单位,长度计算基于字符数量,使用者无需关心底层到底用了多少个比特位来存放该字符。bytes(字节串):内存中存储的是连续的 8 位二进制字节(范围为 0 到 255 的整数序列)。它反映了数据在磁盘文件、网络报文中的真实物理存储状态。
通过对比二者的基本操作,可以非常直观地看出其语义区别:
# 示例环境:Python 3.10+
text = "中国"
raw_bytes = text.encode("utf-8")

print(type(text), text)
# 输出:<class 'str'> 中国

print(type(raw_bytes), raw_bytes)
# 输出:<class 'bytes'> b'\xe4\xb8\xad\xe5\x9b\xbd'

# 1. 长度度量的差异
print("字符长度:", len(text))       # 字符长度: 2
print("字节长度:", len(raw_bytes)) # 字节长度: 6(UTF-8下每个常用汉字占3字节)

# 2. 索引取值的差异
print("str 索引 [0]:", text[0])          # 输出字符: '中'
print("bytes 索引 [0]:", raw_bytes[0])    # 输出整数数值: 228 (十六进制 0xE4)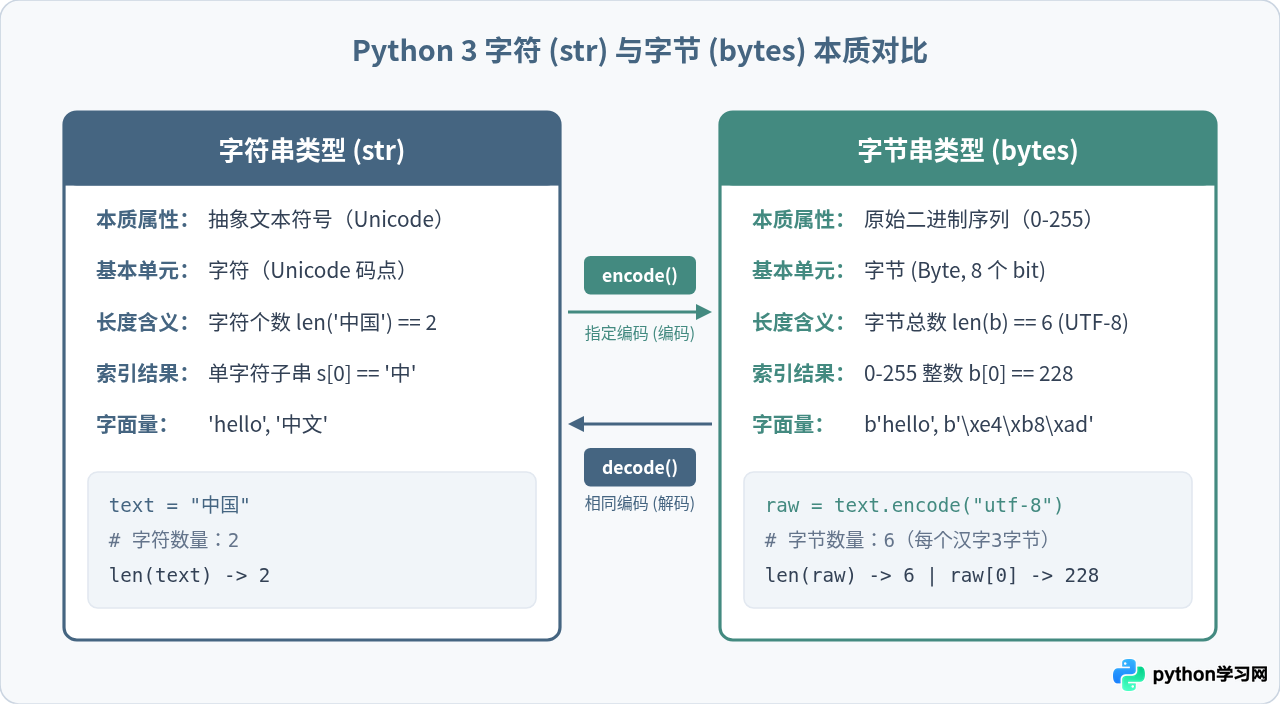
二、编解码管道机制:从抽象字符到物理存储
计算机在不同系统间交换数据时,必须建立一套统一的符号到数字的映射规则。这涉及到两个经常容易被混淆的概念:字符集(Charset)与编码方式(Encoding)。
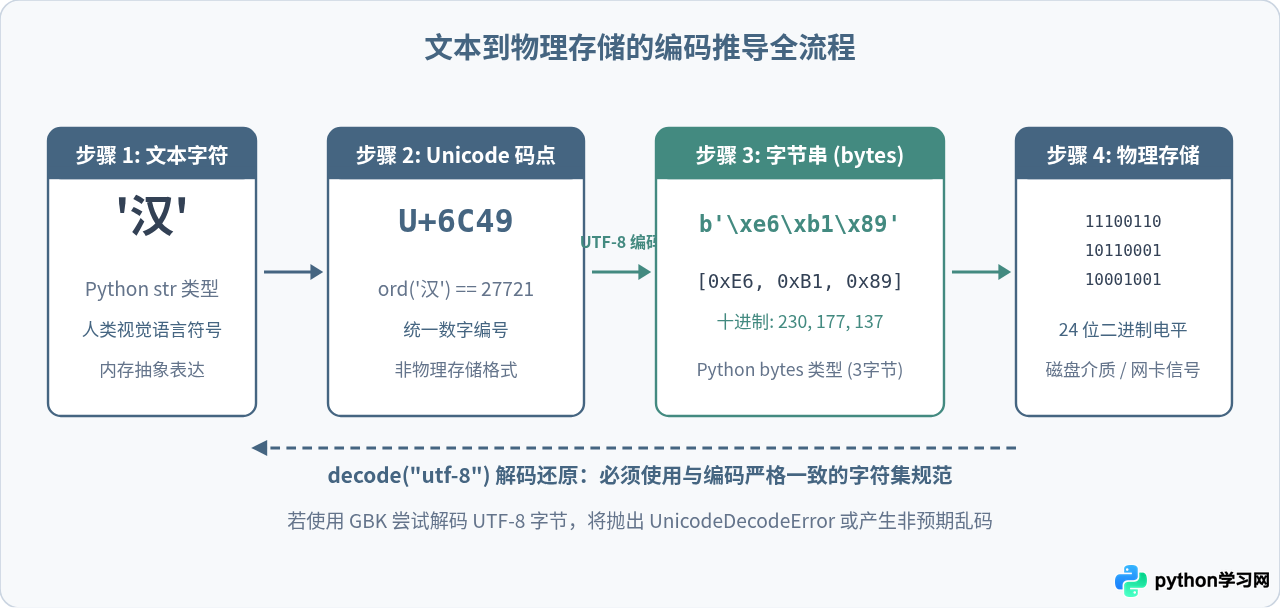
Unicode 实际上是一个“字典”或“码表”,它为世界上所有的书写符号分配了一个唯一的编号,称为码点(Code Point),通常表示为 U+XXXX。例如汉字“汉”在 Unicode 中的码点是 U+6C49(十进制 27721)。
然而,Unicode 本身并没有规定在计算机内存或磁盘中具体用几个字节来存放这个数字。直接存储原始码点会造成巨大的空间浪费(例如纯英文字符也占用 4 字节)。这就催生了 UTF-8 这一变长编码格式:
- 单字节字符(如 ASCII 范围
0-127)只需 1 个字节,完全向后兼容 ASCII; - 常用的汉字字符采用 3 个字节进行编码;
- 较少见的表情符号(Emoji)或生僻字采用 4 个字节编码。
# 查看字符的 Unicode 码点与 UTF-8 字节对应关系
char = '汉'

# 1. 获取 Unicode 码点数值
code_point = ord(char)
print(f"字符 '{char}' 的十进制码点: {code_point}")
print(f"字符 '{char}' 的十六进制码点: U+{code_point:04X}")

# 2. 编码为 UTF-8 字节串
utf8_bytes = char.encode('utf-8')
print("UTF-8 字节表示:", utf8_bytes)
print("每个字节的十六进制:", [hex(b) for b in utf8_bytes])
print("每个字节的二进制:", [bin(b) for b in utf8_bytes])
推导过程清晰展现了数据形态的流转链条:从人类眼中的字形,映射到 Unicode 码点,再根据指定的字符集算法计算出连续的字节序列,最后存入存储介质中。
三、I/O 边界与实战场景:文件与网络中的类型转换
在纯内存运算中,开发者通常只需与 str 打交道。但在跨越“程序内部”与“外部世界”的边界时,必须时刻保持类型敏感。
1. 文件操作的文本模式与二进制模式
调用 open() 函数时,模式参数决定了流的类型:
- 文本模式(
'r'/'w'):Python 的 I/O 层会自动执行编解码工作。read()直接返回str,write()要求传入str。如果不显式指定encoding,Python 会依赖操作系统的默认环境(如 Windows 简体中文版下默认为cp936/gbk),这正是跨平台运行时乱码的最主要诱因。 - 二进制模式(
'rb'/'wb'):跳过所有编解码层,直接读取和写入bytes。图片、音频、压缩包以及协议数据必须使用二进制模式。
# 正确的做法:在文本读写时始终显式声明 encoding
with open("example.txt", "w", encoding="utf-8") as f:
    f.write("数据科学与自动化")

# 以二进制模式直接读取底层真实字节
with open("example.txt", "rb") as f:
    content_bytes = f.read()
    print("二进制读取:", content_bytes)
    # 输出:b'\xe6\x95\xb0\xe6\x8d\xae\xe7\xa7\x91\xe5\xad\xa6\xe4\xb8\x8e\xe8\x87\xaa\xe5\x8a\xa8\xe5\x8c\x96'
2. 网络通讯传输
网络协议栈(如 TCP/IP、HTTP)在物理电平上传输的只有比特流。因此底层的 Socket 接口只接受 bytes。
import socket

# Socket 发送必须是 bytes,直接发送 str 将抛出 TypeError
s = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
message = "PING"
# 错误:s.sendall(message) -> TypeError: a bytes-like object is required, not 'str'
# 正确做法:
s.sendall(message.encode("utf-8"))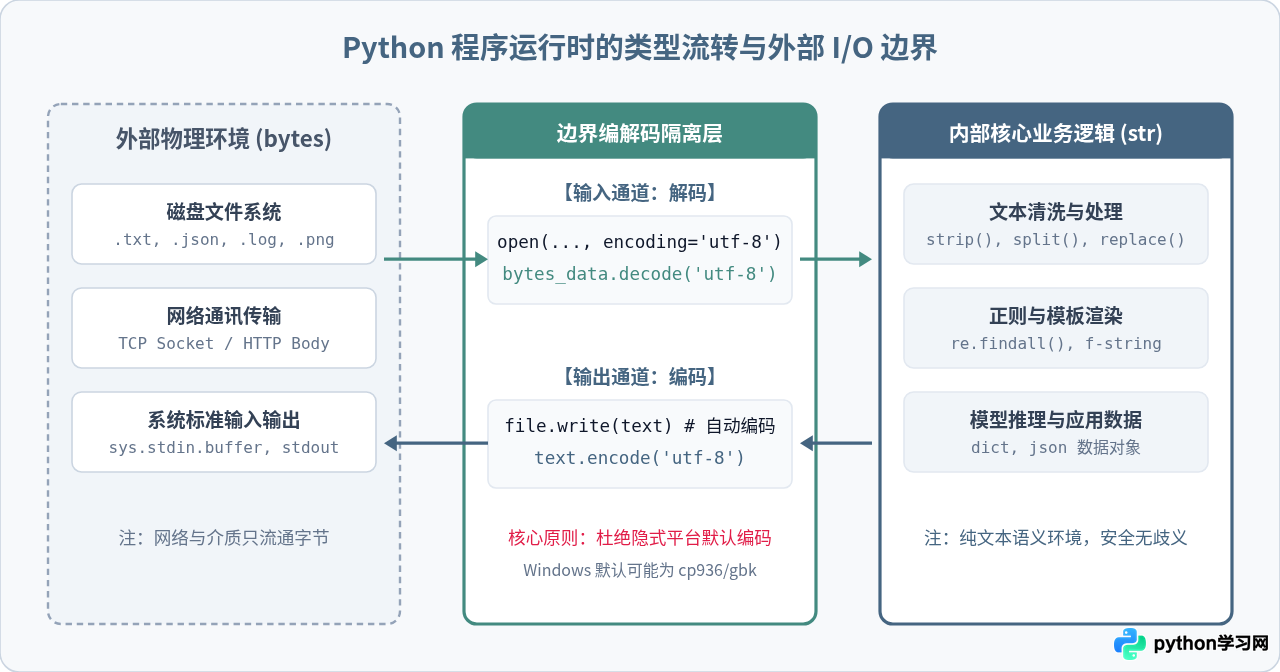
3. 常见异常与容错策略
当编码与解码方案不匹配时,Python 解释器会触发两类主要异常:
UnicodeDecodeError:解码时遇到不符合该编码规则的字节。例如用 UTF-8 解码包含 GBK 汉字的字节序列。UnicodeEncodeError:编码时目标字符集无法表示某个字符。例如尝试将汉字或 Emoji 编码为 ASCII 字节。
在处理可能损坏或不可控的数据源时,可以通过 errors 参数控制容错行为:
corrupted_bytes = b"Hello \xff\xfe World"

# 1. 默认行为:严格模式抛出异常
# corrupted_bytes.decode('utf-8') -> 抛出 UnicodeDecodeError

# 2. 忽略非法字节
print(corrupted_bytes.decode('utf-8', errors='ignore'))
# 输出:Hello  World

# 3. 替换为占位字符(Unicode 替换字符 \ufffd 也就是 '')
print(corrupted_bytes.decode('utf-8', errors='replace'))
# 输出:Hello  World
四、核心思维模型:Unicode 三明治架构
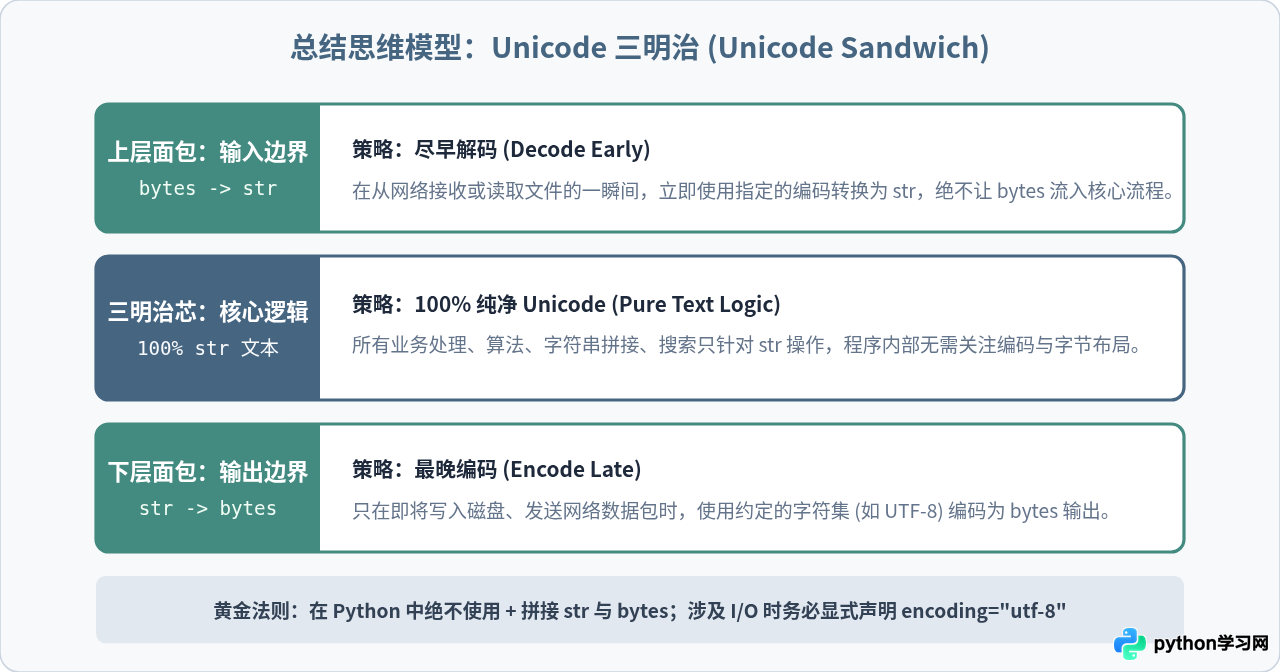
为了彻底规避类型混淆与编码错误,Python 社区总结出了著名的“Unicode 三明治”(Unicode Sandwich)设计法则。
在 Python 2 中,由于 str 实际上是字节串,字符串与字节可以隐式相互拼接,导致了无数隐蔽的 Bug。而在 Python 3 中,"text" + b"bytes" 会直接触发 TypeError。这一严格限制正是“Unicode 三明治”得以贯彻的基石:
- 尽早解码(Decode Early):在数据刚进入程序边界(从磁盘读取、从网络接收、从数据库查询)的一瞬间,立刻按照约定字符集解码为
str。 - 核心纯净(Pure str Logic):在应用程序的内部核心、算法模型和业务逻辑中,100% 只使用
str操作文本。内部逻辑对编码一无所知,不需要也不应该包含编解码代码。 - 最晚编码(Encode Late):仅在数据即将离开程序、需要持久化到磁盘或通过网络发出的那一刻,将其编码为
bytes输出。
1. 文件 I/O 检查:文本读写是否全部显式声明了
encoding='utf-8'?
2. 接口传输检查:跨进程调用、网络通信发送端是否完成
encode(),接收端是否完成 decode()?
3. 长度逻辑检查:涉及限长判断时,当前需求限制的是字符数量(
len(str))还是存储字节数(len(bytes))?
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















