


Python数据分析主要做什么:从清洗到可视化的全流程解析
深入解析Python数据分析主要做什么,从数据读取、清洗整理、探索性数据分析(EDA)到最终可视化的全流程工作逻辑,提供完整代码示例与核心步骤剖析。
许多初学者拿到包含数十万条记录的数据表时,第一反应往往是直接调用可视化库画几张色彩绚烂的图表。然而在实际项目中,这样得出的图表往往错漏百出:成交金额的平均值被负数退单严重拉低、同一用户的重复点击被多次累计、日期字段因为被当成普通文本而无法按时间线正确排序。Python数据分析的核心任务,并不是孤立地绘制图表,而是构建一套确定性的数据转化流水线,将原始、混乱、残缺的业务记录,逐步提炼成真实反映业务状态的量化指标与决策依据。本文将从底层输入排查切入,完整拆解从数据载入、清洗规整、探索性分析(EDA)到最终可视化的全流程实践。
一、Python数据分析的端到端骨架与价值定位
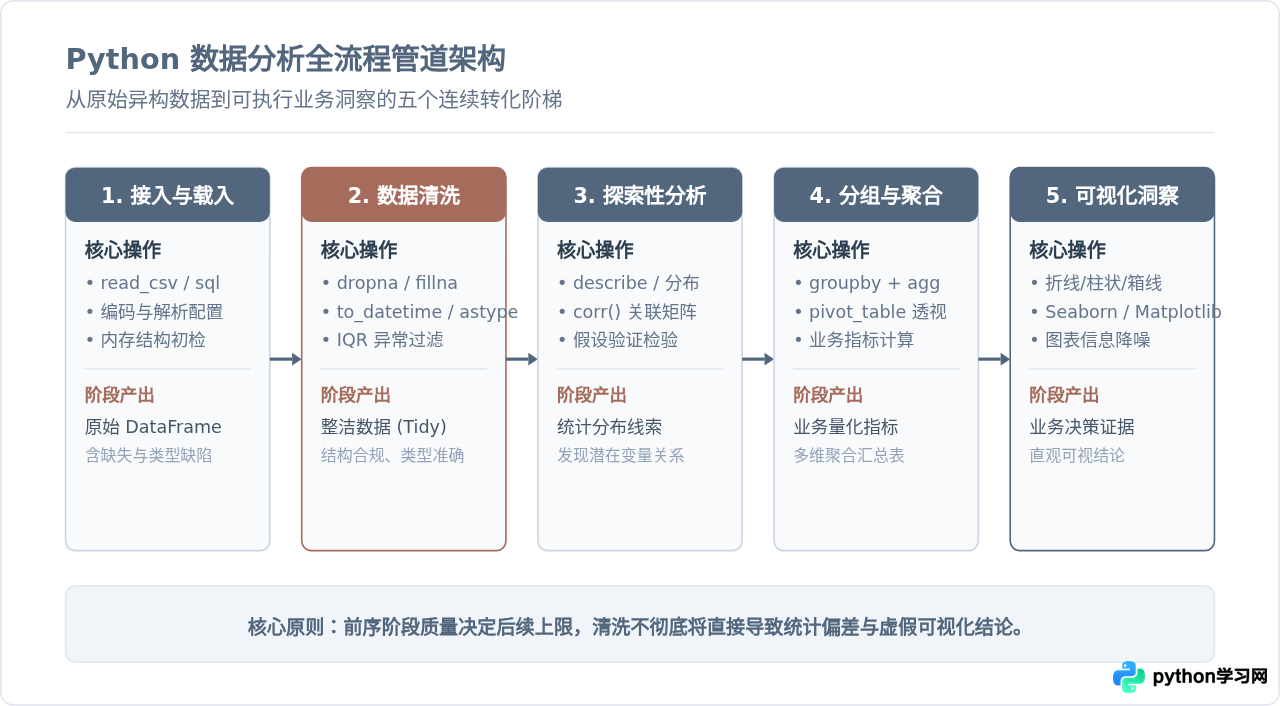
在工程视角下,Python数据分析解决的本质问题是“信息保真与维度提炼”。现实世界产生的数据大多存在缺失、噪声、格式歧义和异常值。如果直接基于原始数据进行统计算法拟合或出图展示,只会产生误导性的虚假结论。整个数据分析过程必须经历结构规约、质量净化、特征关联探查以及直观呈现四个核心环节。
Python凭借以Pandas为核心的数据操作生态、NumPy的向量化数值计算底座,以及Matplotlib与Seaborn构成的可视化层,提供了这一全流程的完整实现标准。分析人员通过编写代码形成脚本化管道,不仅能处理单次离线分析,还能确保后续新数据批次到达时,整个处理规则可以严格复现并自动化执行。
二、第一步:数据读取与结构质量诊断
分析工作的物理起点是读取文件或连接数据库。以最常见的CSV文件为例,单纯使用 pd.read_csv('orders.csv') 往往会遗漏底层隐患。例如,如果文件包含中文字符,默认UTF-8可能报错,需要明确指定 encoding='utf-8' 或 encoding='gbk';时间字段默认被识别为纯字符串(object类型),无法直接执行按月聚合或时间差计算,需要在读取阶段传入 parse_dates 参数或后续显式转换。
载入数据后,应当立刻通过三项基本方法快速摸清数据底细:df.shape 检查行数与列数;df.info() 查看各字段数据类型及非空值数量;df.head() 审视前几行的实际样貌。以下代码演示了读取包含缺失与错误格式的电商流水样本,并完成初步审计的过程:
import pandas as pd
import numpy as np

# 构造模拟的原始业务订单数据
raw_data = {
    'order_id': ['ORD-101', 'ORD-102', 'ORD-103', 'ORD-103', 'ORD-104', 'ORD-105', 'ORD-106'],
    'order_date': ['2026-03-01', '2026-03-01', '2026-03-02', '2026-03-02', '2026-03-03', 'invalid_date', '2026-03-04'],
    'customer_id': ['C-01', 'C-02', 'C-03', 'C-03', np.nan, 'C-05', 'C-06'],
    'category': ['电子产品', '日化美妆', '服饰鞋帽', '服饰鞋帽', '电子产品', '电子产品', '图书文具'],
    'amount': [2599.0, 189.5, -50.0, -50.0, 99999.0, 320.0, 88.0],
    'status': ['已完成', '已完成', '已退款', '已退款', '已完成', '已完成', '已完成']
}

df = pd.DataFrame(raw_data)
print("=== 原始数据集信息概览 ===")
df.info()
通过审计结果可以迅速发现隐患:order_date 依然是字符串而非日期时间类型;customer_id 存在缺失值(只有6个非空);同时在金额字段中,存在负数金额 -50.0(可能属于退单但会拉低销售总额)以及极端数值 99999.0(可能属于刷单或录入错误)。这就引出了整个分析过程中耗时最长但最关键的环节——数据清洗。
二、第二步:数据清洗与规整的四个核心动作
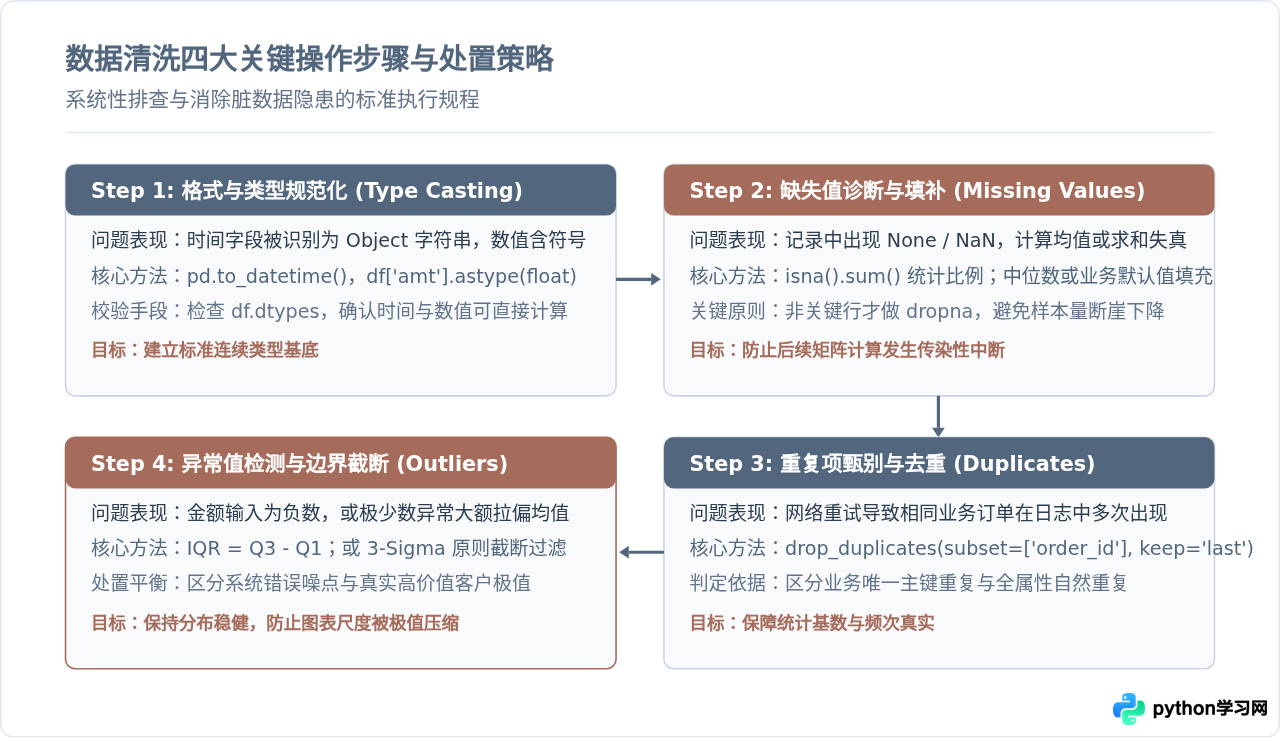
数据清洗不是盲目删减数据,而是通过规范化动作确保数据逻辑自洽。根据业务统计规范,清洗通常包括四大确定性步骤:类型转换、缺失值处置、重复项剔除以及异常值过滤。
1. 类型转换与解析容错
在清洗代码中,应使用 pd.to_datetime(df['order_date'], errors='coerce'),其中 errors='coerce' 的作用是在遇到像 'invalid_date' 这类无法解析的脏数据时,自动将其转换为 NaT(时间类型的空值),而不是直接抛出异常中断整个程序执行。
2. 缺失值排查与业务处置
缺失值的处置必须遵守业务逻辑。对于关键主键或客户归属字段缺失的情况,如果无法追溯真实来源,通常选择删除对应记录;而对于数值型指标(如用户评分),则常常使用中位数(中位数对极值不敏感)或常量值填补。
3. 重复值剔除
在分布式系统或前端提交时,用户重试会导致重复日志。通过 drop_duplicates(subset=['order_id'], keep='first') 可以依据唯一业务主键保留第一条合法记录,去除冗余条目。
4. 异常值诊断与清洗落地
对于金额小于等于零或者远超正常业务上限的数据,可以结合业务阈值或四分位距(IQR)进行过滤。下面的代码展示了一个完整的清洗流水线:
# 1. 类型转换与非法时间容错
df['order_date'] = pd.to_datetime(df['order_date'], errors='coerce')

# 2. 去除订单主键重复记录
df = df.drop_duplicates(subset=['order_id'], keep='first').copy()

# 3. 剔除无法补齐客户ID与非法日期的记录
df = df.dropna(subset=['customer_id', 'order_date']).copy()

# 4. 业务边界异常值过滤:金额必须为正,且剔除明显录入错误的超限大额(如单笔大于50000)
df = df[(df['amount'] > 0) & (df['amount'] <= 50000)].copy()

print("=== 清洗后规整数据 ===")
print(df[['order_id', 'order_date', 'customer_id', 'category', 'amount']])
通过清洗流水线的处理,脏数据中的主键重复(ORD-103)、客户缺失与异常高额(ORD-104)、时间解析失败(ORD-105)全部被净化过滤,输出的 DataFrame 具备了严格的结构一致性,为后续统计探索奠定了可靠基础。
三、第三步:探索性数据分析(EDA)与多维特征挖掘
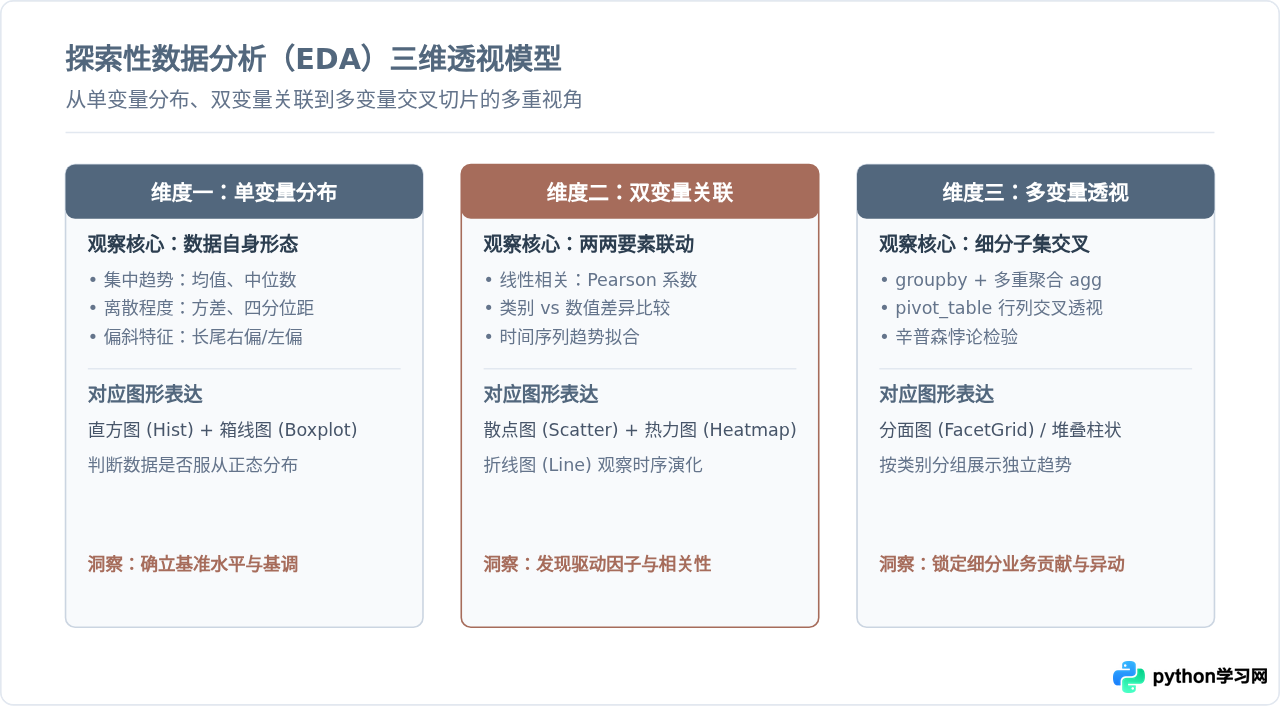
探索性数据分析(Exploratory Data Analysis,简称 EDA)的核心目的,是通过汇总统计和交叉切片,发现数据背后的形态分布、波动范围以及潜在变量关联。在实际业务中,EDA 通常围绕三个维度展开:单变量形态分布、双变量关联分析以及多变量交叉透视。
1. 统计描述与分布形态检验
在Pandas中,describe() 可以一次性输出计数、均值、标准差、最小值、四分位数以及最大值。通过对比“均值(Mean)”和“中位数(50%分位数)”,分析师能够快速识别数据的偏态。例如,当均值远大于中位数时,通常说明存在少数超大数值将整体分布向右侧拖拽(右偏分布),在制定运营指标时,中位数往往比平均数更具参考价值。
2. 分组聚合(Groupby 与 Agg)
数据分析的关键产出之一是将微观的明细行按业务维度进行聚合。例如,不同商品分类(category)的客单价与总销售额是多少?不同月份的复购趋势如何?借助 groupby 与 agg 函数,可以用简洁的代码表达多重汇总计算:
# 构建规范的电商销售扩充样本
sales_sample = pd.DataFrame({
    'category': ['电子产品', '电子产品', '日化美妆', '日化美妆', '服饰鞋帽', '服饰鞋帽', '电子产品', '日化美妆'],
    'region': ['华东', '华北', '华东', '华南', '华东', '华北', '华南', '华东'],
    'amount': [2599.0, 1899.0, 240.0, 180.0, 560.0, 420.0, 3100.0, 320.0],
    'discount': [0.95, 0.90, 0.85, 0.80, 0.90, 0.85, 0.98, 0.90]
})

# 按品类统计订单量、销售总额、平均单价
category_stats = sales_sample.groupby('category').agg(
    order_count=('amount', 'count'),
    total_sales=('amount', 'sum'),
    mean_price=('amount', 'mean'),
    median_price=('amount', 'median')
).reset_index()

print("=== 分类聚合指标分析 ===")
print(category_stats)
3. 多维交叉透视表(Pivot Table)
当需要同时观察“品类”与“区域”两个离散维度的交叉影响时,pd.pivot_table 是最有效的方法。通过设置行索引、列维度以及汇总函数,可以快速透视区域品类渗透率,防范由于单一汇总掩盖的局部业务下滑风险。
四、第四步:数据可视化与洞察表达
可视化的核心目标是“降低信息接收者的认知成本”,绝非为了炫技而堆叠复杂图表。在Python中,Matplotlib负责底层图形对象的精准控制(如轴刻度、标签位置、图例样式),而Seaborn则建立在Matplotlib之上,专注于统计图表的高级封装。
选择图表类型时,必须根据数据关系严格对齐:
- 时间趋势演变:优先选用折线图(Line Plot),横轴为时间序列,展示走势与季节性波动;
- 类别大小对比:选用柱状图(Bar Plot),类别过多时建议横向排列(条形图),避免标签倾斜重叠;
- 连续变量分布与异常点:选用箱线图(Box Plot)或直方图(Histogram),清晰呈现四分位距与离群样本;
- 双变量相关性探索:选用散点图(Scatter Plot),观察变量之间是否存在线性关联或聚集簇。
以下代码演示了如何使用标准的 Python 数据科学工具链完成多维度统计图表的绘制流程:
import matplotlib.pyplot as plt

# 设置图表基础样式与画布
fig, axes = plt.subplots(1, 2, figsize=(12, 5))

# 图1:品类销售总额对比柱状图
categories = category_stats['category']
totals = category_stats['total_sales']
axes[0].bar(categories, totals, color='#52677D', width=0.55)
axes[0].set_title('各品类销售总额对比', fontsize=13, fontweight='bold', pad=10)
axes[0].set_ylabel('销售总额 (元)', fontsize=11)
axes[0].grid(axis='y', linestyle='--', alpha=0.4)

# 图2:品类客单价中位数对比
medians = category_stats['median_price']
axes[1].bar(categories, medians, color='#A66C5B', width=0.55)
axes[1].set_title('各品类客单价中位数对比', fontsize=13, fontweight='bold', pad=10)
axes[1].set_ylabel('中位数金额 (元)', fontsize=11)
axes[1].grid(axis='y', linestyle='--', alpha=0.4)

plt.tight_layout()
# plt.savefig('category_performance.png', dpi=300)
# plt.show()
在上述可视化代码中,我们为销售总额与客单价中位数分配了不同的视觉焦点色(主色蓝灰 #52677D 与强调色赭红 #A66C5B),配合 tight_layout() 自动计算子图边距,能够确保生成的图表兼具学术图表的克制感与工业报表的严谨度。
五、从清洗到可视化的决策闭环总结
回顾整个Python数据分析流程,清洗、探索与可视化是一个环环相扣的闭环系统,而非孤立的代码步骤:
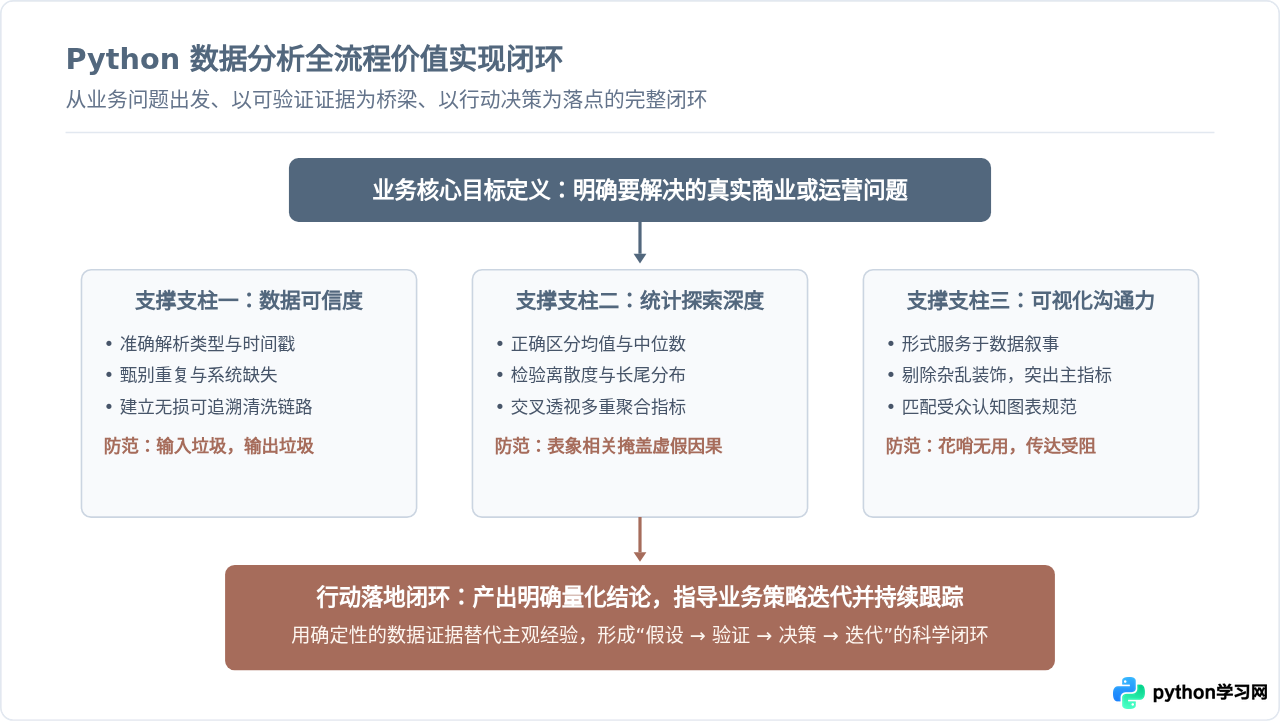
避免三大常见分析误区:一是“跳过清洗直接看图”,图表虽美但基础数据错误,导致南辕北辙;二是“过度依赖平均数”,忽视了极端异常值对平均水平的拉偏效应,未能结合中位数和分位数交叉核查;三是“图表形式大于信息实质”,图表元素过多、图例冗余,削弱了核心业务结论的传达力。
通过遵循“读取与结构审计 → 四步清洗规整 → 三维EDA挖掘 → 针对性图表表达”的完整方法论,分析人员能够将零散脆弱的数据资产,转化为经得起工程推敲和业务检验的坚实结论,这正是Python数据分析在现代数字化业务实践中最核心的工作内容与长久价值所在。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















