


多机多卡分布式训练:TensorFlow与PyTorch哪个配置更简单
深度对比 TensorFlow 与 PyTorch 在多机多卡分布式训练中的配置流程、启动方式、代码侵入性与排障成本,提供两者的完整配置示例与选型建议。
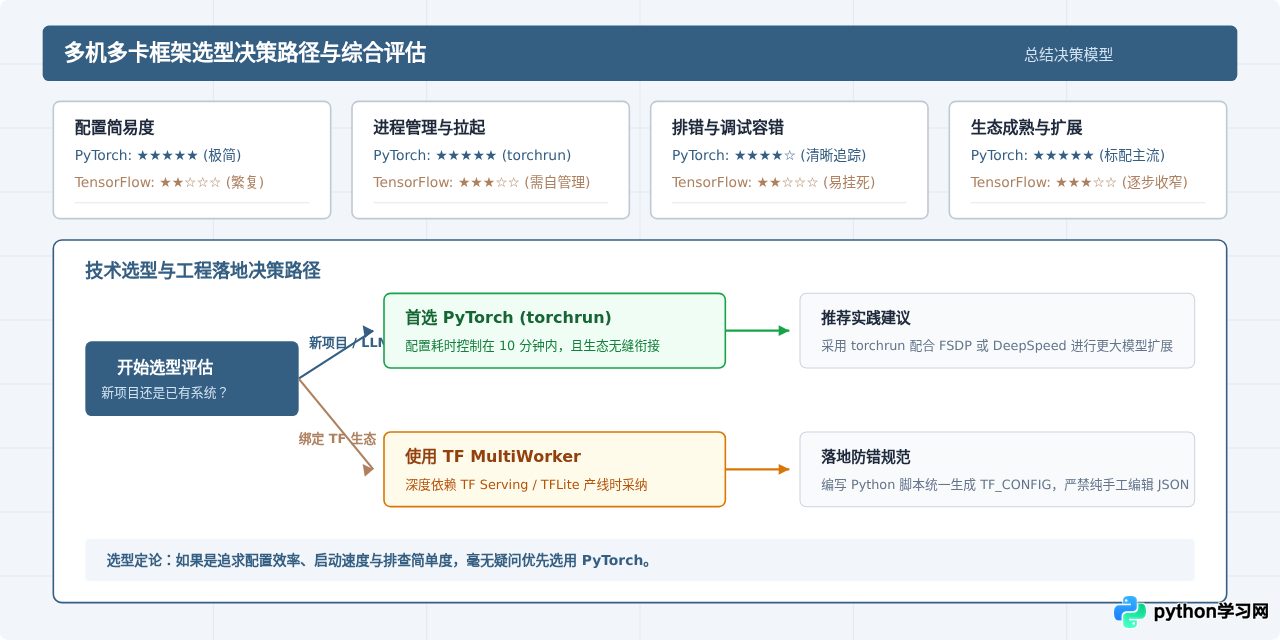
直接给出核心结论:在当前主流框架生态下,PyTorch 的多机多卡配置比 TensorFlow 明显更简单、更直观。PyTorch 依靠官方的 torchrun 命令行工具配合原生分布式模块(DDP),仅需在各节点传入少量集群地址和节点编号即可启动;而 TensorFlow 基于 tf.distribute.MultiWorkerMirroredStrategy 方案,要求每个节点精确注入结构严苛的 TF_CONFIG JSON 环境变量,无论是配置编写、代码侵入度还是分布式排障,门槛都明显更高。
一、分布式通信架构与网络前提
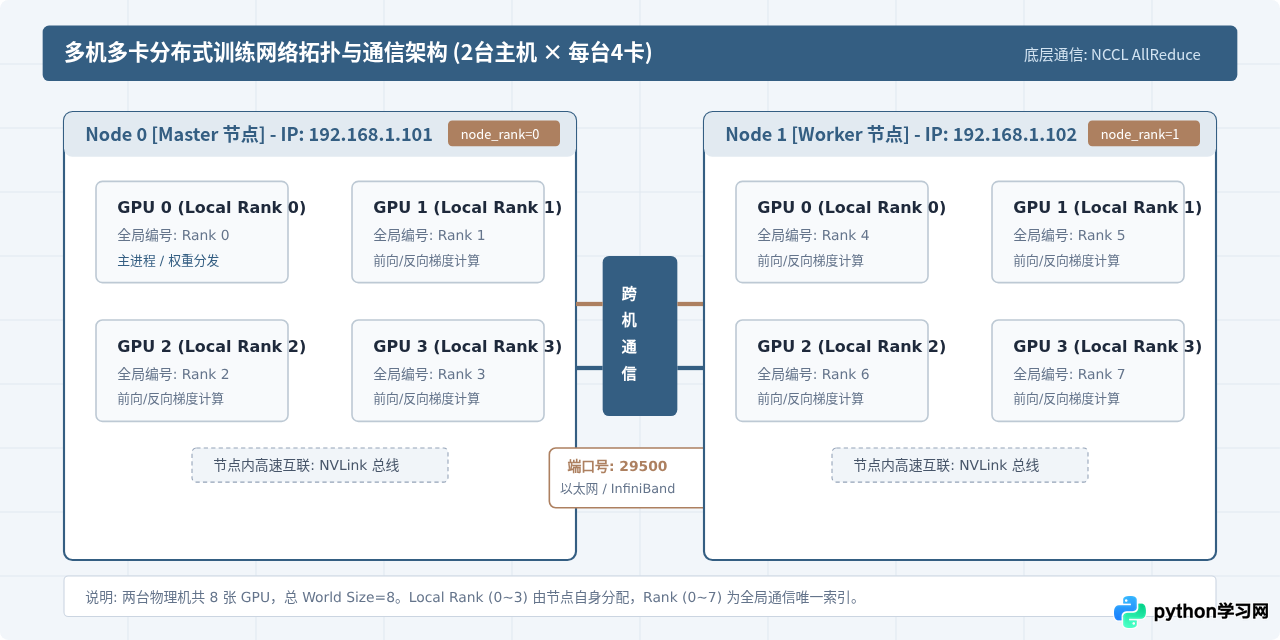
多机多卡训练本质上是将模型计算分布到多台物理主机的多个 GPU 芯片上,节点内部的 GPU 借助高速互联总线(如 NVLink)交换参数,而跨节点通信则依赖高速网络设备(如 InfiniBand 或 100GbE RoCE 网络)。无论是使用 TensorFlow 还是 PyTorch,底层通常都依赖 NVIDIA NCCL(NVIDIA Collective Communications Library)进行梯度的 Ring AllReduce 同步。
在讨论具体框架的配置繁简之前,两套系统都需要满足相同的物理和网络互通条件:
- IP 与端口可达:所有参与训练的工作节点必须处于同一个局域网,各节点间主通信端口(如默认的 29500 端口)互相打通,防火墙未拦截。
- SSH 免密通信:便于批量分发任务与监控,虽然非框架强制,但在实际集群部署中是常规操作。
- 依赖环境与版本统一:各节点上的操作系统驱动版本、CUDA/cuDNN 版本以及深度学习框架版本必须严格一致,避免通信协议或算子差异导致死锁。
二、PyTorch 多机多卡配置方式与实操
PyTorch 自 1.9 引入并成熟化 torchrun 工具后,多机多卡的启动流程被高度标准化。开发者无需在代码中硬编码任何主机列表,整个流程分为代码适配与命令行启动两个简洁步骤。
1. 训练脚本适配
在 Python 代码中,仅需调用 torch.distributed.init_process_group(backend="nccl")。该函数会自动从环境变量中读取当前进程的 LOCAL_RANK、RANK 和 WORLD_SIZE。随后使用 DistributedSampler 分割数据集,并将模型包装进 DistributedDataParallel (DDP) 即可:
import os
import torch
import torch.distributed as dist
from torch.nn.parallel import DistributedDataParallel as DDP
from torch.utils.data import DataLoader, DistributedSampler

def main():
    # 1. 初始化进程组(环境变量由 torchrun 自动注入)
    dist.init_process_group(backend="nccl")
    local_rank = int(os.environ["LOCAL_RANK"])
    torch.cuda.set_device(local_rank)

    # 2. 模型绑定到本地对应 GPU 并用 DDP 包装
    model = MyNeuralNet().to(local_rank)
    model = DDP(model, device_ids=[local_rank])

    # 3. 使用分布式采样器,确保各卡分配不重叠的数据子集
    dataset = MyDataset()
    sampler = DistributedSampler(dataset, shuffle=True)
    loader = DataLoader(dataset, batch_size=32, sampler=sampler)

    # 4. 标准训练循环(每个 epoch 开始前需设置 epoch 种子)
    for epoch in range(10):
        sampler.set_epoch(epoch)
        for data, targets in loader:
            data, targets = data.to(local_rank), targets.to(local_rank)
            loss = model(data, targets)
            loss.backward()
            optimizer.step()
            optimizer.zero_grad()

    dist.destroy_process_group()

if __name__ == "__main__":
    main()
2. 命令行启动
在两台机器上分别执行启动命令。两台机器的参数几乎完全相同,唯一不同的参数是 --node_rank:
# 【在 Node 0 (192.168.1.101) 上执行】:
torchrun \
  --nproc_per_node=4 \
  --nnodes=2 \
  --node_rank=0 \
  --master_addr="192.168.1.101" \
  --master_port=29500 \
  train.py

# 【在 Node 1 (192.168.1.102) 上执行】:
torchrun \
  --nproc_per_node=4 \
  --nnodes=2 \
  --node_rank=1 \
  --master_addr="192.168.1.101" \
  --master_port=29500 \
  train.py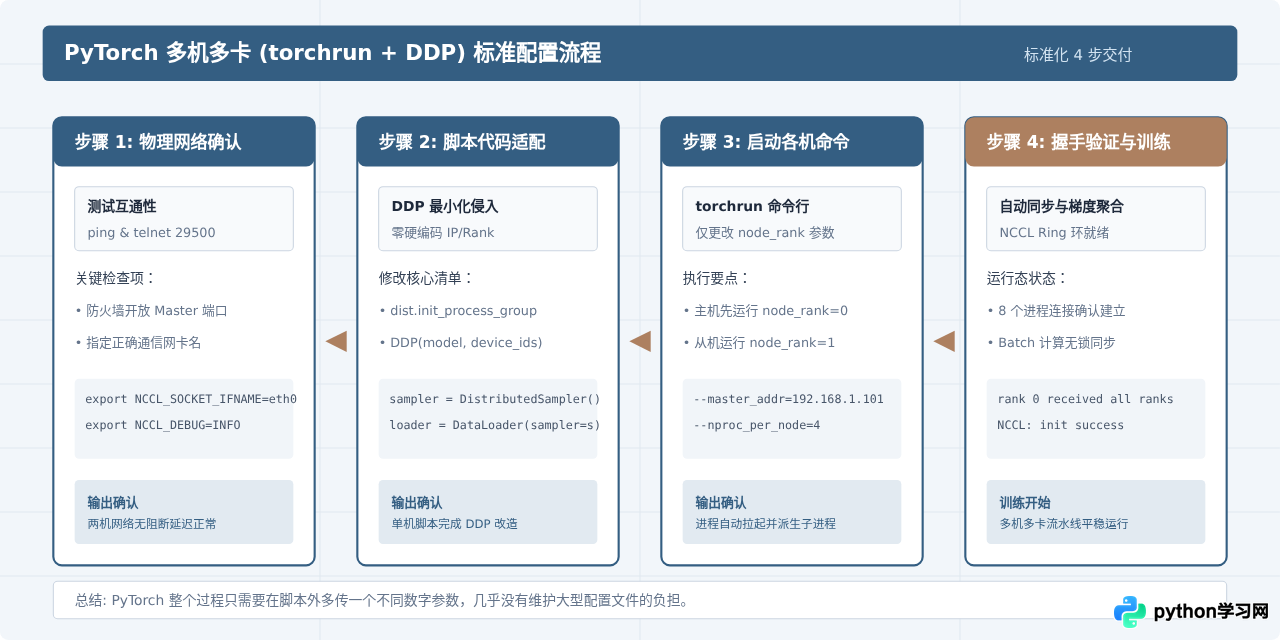
三、TensorFlow 多机多卡配置方式与实操
TensorFlow 在 2.x 版本中主要使用 tf.distribute.MultiWorkerMirroredStrategy 实现多机同步训练。虽然代码中使用 Strategy API 比较规范,但在环境配置与进程拉起环节,要求每一个参与训练的节点都必须在启动 Python 前设置好 TF_CONFIG 环境变量。
1. TF_CONFIG 结构与注入
TF_CONFIG 必须是一个合法的 JSON 格式字符串,包含了整个集群的所有节点地址列表(cluster),以及当前机器在集群中的角色与下标(task)。
# 【在 Node 0 (192.168.1.101) 上的环境变量注入】:
export TF_CONFIG='{
    "cluster": {
        "worker": ["192.168.1.101:12345", "192.168.1.102:12345"]
    },
    "task": {
        "type": "worker",
        "index": 0
    }
}'

# 【在 Node 1 (192.168.1.102) 上的环境变量注入】:
export TF_CONFIG='{
    "cluster": {
        "worker": ["192.168.1.101:12345", "192.168.1.102:12345"]
    },
    "task": {
        "type": "worker",
        "index": 1
    }
}'1. cluster 字段中的节点列表在所有主机上必须完全相同且顺序严格一致。只要有一个节点写错一个 IP 字符、调换了顺序或写错了端口,整个集群在初始化阶段就会陷入永久等待(Hang 死),且控制台通常没有直观的错误抛出。
2. task.index 必须与当前节点在 cluster.worker 数组中的真实下标完全对齐,不能出现冲突或越界。
3. 在 TensorFlow 中,没有像 torchrun 那样开箱即用且深度绑定的多机进程管理命令行工具,多机上的多卡调度通常需要借助第三方框架(如 Horovod)或自行编写 Shell 循环在单机内拉起多个 Worker 进程并动态拼接 task.index。
2. TensorFlow 训练脚本代码
import os
import json
import tensorflow as tf

def main():
    # 1. 实例化多机镜像策略
    strategy = tf.distribute.MultiWorkerMirroredStrategy(
        communication_options=tf.distribute.experimental.CommunicationOptions(
            implementation=tf.distribute.experimental.CommunicationImplementation.NCCL
        )
    )

    # 2. 必须由总 batch_size 扩展为全局 batch_size
    per_replica_batch_size = 32
    global_batch_size = per_replica_batch_size * strategy.num_replicas_in_sync

    # 3. 数据集自动按 worker 数量进行 shard 分片
    dataset = get_dataset().batch(global_batch_size)

    # 4. 在 strategy.scope() 下构建模型与优化器
    with strategy.scope():
        model = create_model()
        optimizer = tf.keras.optimizers.Adam(learning_rate=1e-3)
        loss_fn = tf.keras.losses.SparseCategoricalCrossentropy(from_logits=True)

    # 5. 模型编译与训练
    model.compile(loss=loss_fn, optimizer=optimizer, metrics=["accuracy"])

    # 注意: 模型保存/Checkpoint 写入必须特殊判断,只有 task.index==0 才能写入共享目录,否则并发覆写损坏文件
    callbacks = []
    tf_config = json.loads(os.environ.get("TF_CONFIG", "{}"))
    if tf_config.get("task", {}).get("index", 0) == 0:
        callbacks.append(tf.keras.callbacks.ModelCheckpoint("/shared/ckpt/model.h5"))

    model.fit(dataset, epochs=10, callbacks=callbacks)

if __name__ == "__main__":
    main()
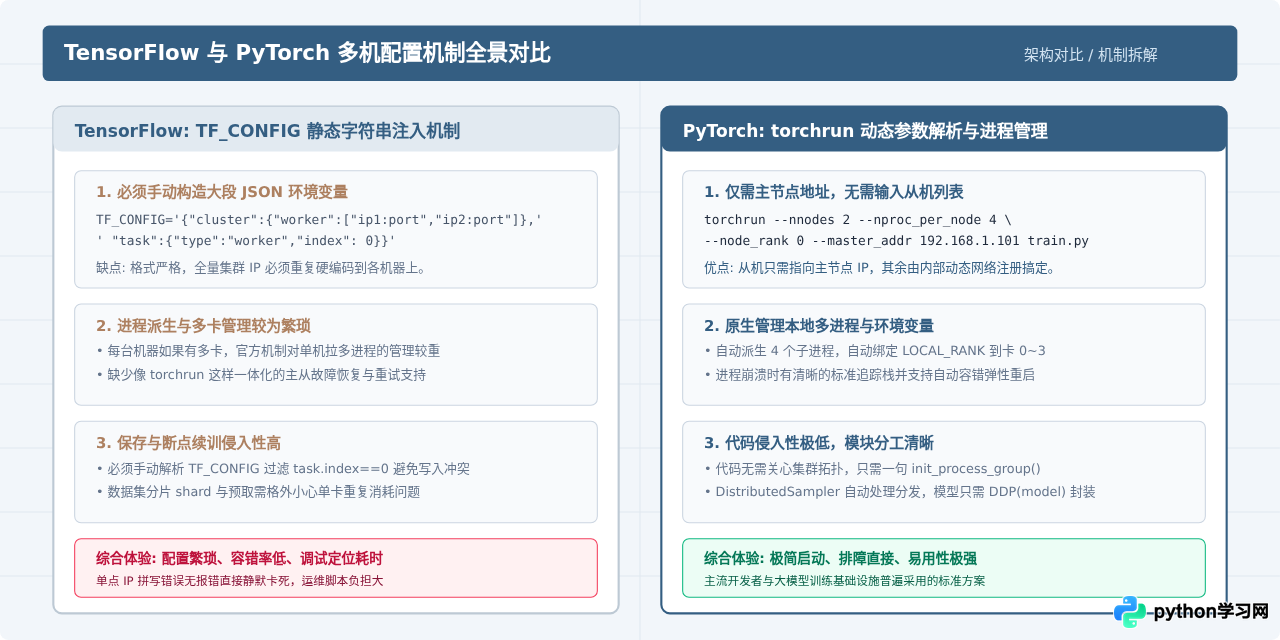
四、机制对比:TF_CONFIG 注入 vs torchrun 命令行
为了直观展现两者在工程实现上的难度差距,我们将两者的集群配置与进程拉起机制进行左右结构化对比:
五、核心配置复杂度详细对照表
为了全面衡量两个框架在工程实践中的上手与维护成本,我们将配置维度拆解为 6 项具体指标:
| 对比维度 | PyTorch (torchrun + DDP) | TensorFlow (MultiWorkerMirroredStrategy) |
|---|---|---|
| 集群拓扑声明 | 仅需指定 Master 主机 IP 与端口,从机无需关心其他从机地址。 | 必须在所有主机上声明全量成员的 IP 和端口列表(JSON 数组)。 |
| 配置传入介质 | 统一由 torchrun 命令行参数传递,干净规范。 |
依赖大段 TF_CONFIG 环境变量,需 Shell 或外部运维系统注入。 |
| 单机多卡进程拉起 | torchrun 会自动根据 --nproc_per_node 派生对应数量进程并管理生命周期。 |
原生需要用户自己拉起进程或编写外层脚本管理多个 Worker 的启动。 |
| 代码侵入程度 | 极低。仅需初始化进程组、添加 Sampler 并用 DDP(model) 包裹。 |
中等。需要在 strategy.scope() 下声明、手动处理多机 Checkpoint 覆盖问题。 |
| 报错与超时调试 | 开启 NCCL_DEBUG=INFO 后,通信日志清晰,超时抛出明确的 Timeout 异常。 |
配置微小不一致时极易直接卡死在初始化阶段,日志晦涩,排查耗时。 |
| 大模型生态扩展 | 无缝兼容 DeepSpeed、Megatron-LM、FSDP 等业界主流分布式扩展库。 | 第三方大模型训练扩展较少,生态活跃度与更新节奏落后于 PyTorch。 |
六、常见配置避坑与调试建议
无论是使用哪种框架,初次搭建多机多卡训练环境时,最容易出现的问题集中在网络互通与进程管理上。掌握以下排查规则,可以节省大量排障时间:
1. 端口与网络接口错位(常见于多网卡服务器)
企业级服务器通常配备有多张网卡(如千兆管理网卡 eth0 与万兆/InfiniBand 高速训练网卡 ib0)。如果 NCCL 默认绑定到了速度极慢或互不相通的管理网卡上,往往会导致训练极慢或握手卡死。
- 解决方法:在启动命令前显式导出网卡名称:
export NCCL_SOCKET_IFNAME=ib0
export GLOO_SOCKET_IFNAME=ib0
2. 防火墙导致端口连接挂起
如果在执行启动命令后,两台机器都在打印初始化日志,但迟迟不进入第一个 Batch 的前向计算,几乎 90% 的概率是通信端口被云服务器安全组或操作系统防火墙拦截。
- 解决方法:在主节点开放指定的
master_port(例如 29500),并在从机使用nc -zv 192.168.1.101 29500验证 TCP 连通性。
3. 权重与断点保存并发冲突
在多机多卡训练中,共有 $N \times M$ 个并发进程(例如 2 机 4 卡共 8 个进程)。如果每个进程都在每个 Epoch 结束时向同一个共享挂载路径保存检查点,会导致文件被多个进程同时写入而损坏。
- 解决方法:无论在 PyTorch 还是 TensorFlow 中,都必须显式限定仅由全局 Rank 0 负责保存模型文件:
# PyTorch 示例
if dist.get_rank() == 0:
    torch.save(model.module.state_dict(), "checkpoint.pt")
七、总结
综合比较来看,PyTorch 在多机多卡分布式训练的配置难度上全面优于 TensorFlow。这种优势并非体现在单机单卡的训练效率上,而是源于框架在多机协同设计理念上的演进:
- PyTorch 将多机协同的复杂度封装在成熟的命令行工具
torchrun中,节点间仅需单向对齐 Master 地址,极大地降低了人工运维和配置脚本的维护成本。 - TensorFlow 依然沿用早期的中心化静态配置思路,对
TF_CONFIG的严苛要求增加了环境部署的不确定性,在没有完备运维平台的场景下极易因配置错误耗费大量排错时间。
因此,对于绝大多数希望快速跑通多机多卡分布式训练任务的工程师与研究人员,PyTorch 是配置更简单、落地更高效的确定性选择。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















