


Python结构体怎么嵌套?dataclass中包含列表和子结构体示例
详解Python中如何使用dataclass实现结构体嵌套,包括单对象子结构体嵌套、列表集合嵌套、field(default_factory=list)的正确用法以及嵌套字典反序列化示例与避坑指南。
在Python中实现类似C或Go语言中的结构体嵌套,标准且高效的方案是使用标准库内置的 dataclasses 模块。嵌套的核心逻辑是将已定义的子 @dataclass 类直接作为父类的字段类型注解;当字段为列表集合时,则结合泛型类型(如 list[Child])与 field(default_factory=list) 进行定义。通过这种方式,既能获得清晰的类型提示与自动生成的构造函数,又能避免共享默认列表引用的经典缺陷。
一、数据模型拆解与嵌套结构设计
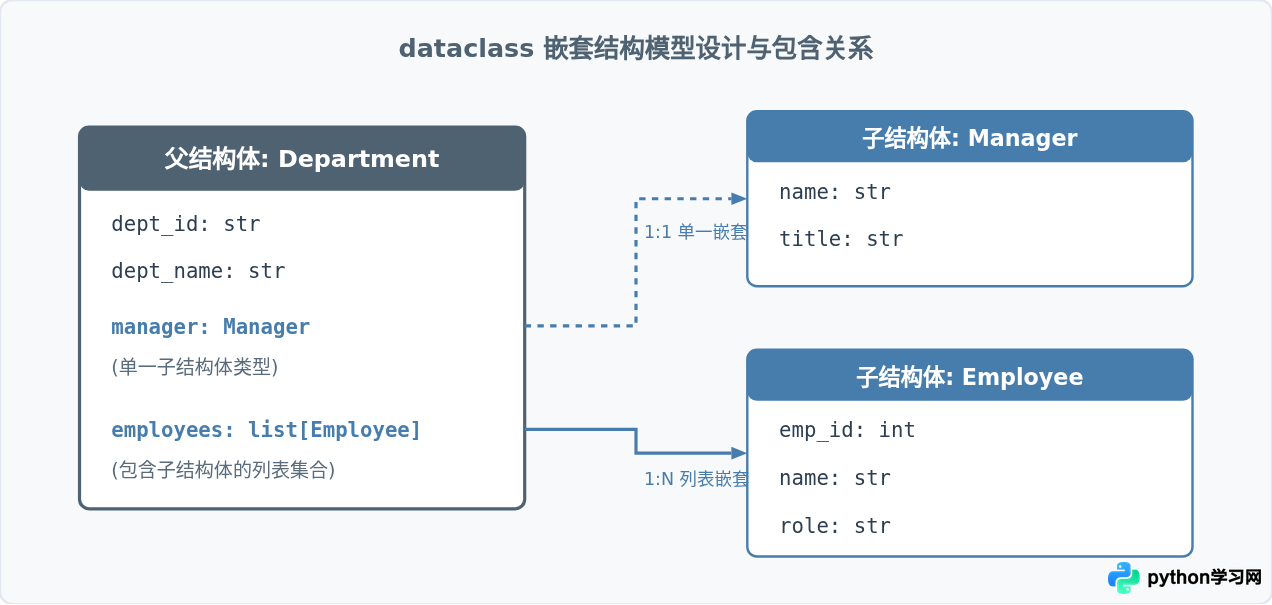
当业务数据存在树形层级或关联关系时,扁平的数据类难以维护。例如一个企业部门系统(Department),其内部不仅包含一位主管(Manager,属于单一子结构体),还包含一个员工列表(employees,属于子结构体集合)。
在设计嵌套结构时,Python解析类定义的顺序是从上到下的,因此作为从属的子结构体必须在父结构体之前声明,或者使用延迟注解字符串。以下架构关系图展示了父类与子类之间的引用关系与数据流动:
二、嵌套结构体定义的标准步骤
为了让嵌套的数据类稳定运行且易于维护,需要遵循固定的声明流程。从依赖最底层的叶子节点开始定义,逐步向上组合为复合节点。
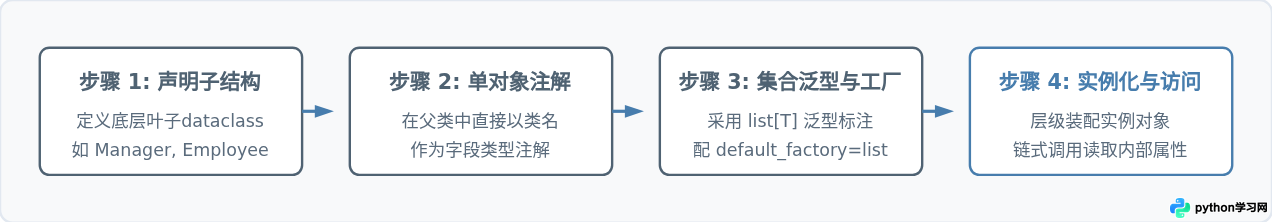
1. 完整代码示例:子结构体与列表嵌套
在 Python 3.9 及以上版本中,可以直接使用内置的 list[Employee] 语法;如果在 Python 3.7 或 3.8 环境中,需通过 from typing import List 并使用 List[Employee]。
from dataclasses import dataclass, field

# 步骤 1:定义子结构体 (Employee 和 Manager)
@dataclass
class Employee:
    emp_id: int
    name: str
    role: str

@dataclass
class Manager:
    name: str
    title: str

# 步骤 2 & 3:定义父结构体,包含单对象与列表结构体
@dataclass
class Department:
    dept_id: str
    dept_name: str
    manager: Manager  # 包含单子结构体
    employees: list[Employee] = field(default_factory=list)  # 包含子结构体列表

# 步骤 4:实例化
mgr = Manager(name="张伟", title="技术总监")
emp1 = Employee(emp_id=101, name="李明", role="后端开发")
emp2 = Employee(emp_id=102, name="王芳", role="前端开发")

# 装配到父结构体中
dept = Department(
    dept_id="D01",
    dept_name="研发部",
    manager=mgr,
    employees=[emp1, emp2]
)

# 属性访问与展示
print(f"部门: {dept.dept_name}")
print(f"主管: {dept.manager.name} ({dept.manager.title})")
print("团队成员:")
for emp in dept.employees:
    print(f" - [{emp.emp_id}] {emp.name}: {emp.role}")
代码说明:当打印 dept.manager.name 时,Python会先从 dept 取出 manager 对象,再获取其 name 属性。整个过程具备完整的 IDE 类型自动推导与代码补全支持。
三、核心机制:为什么列表字段必须用 field(default_factory=list)?
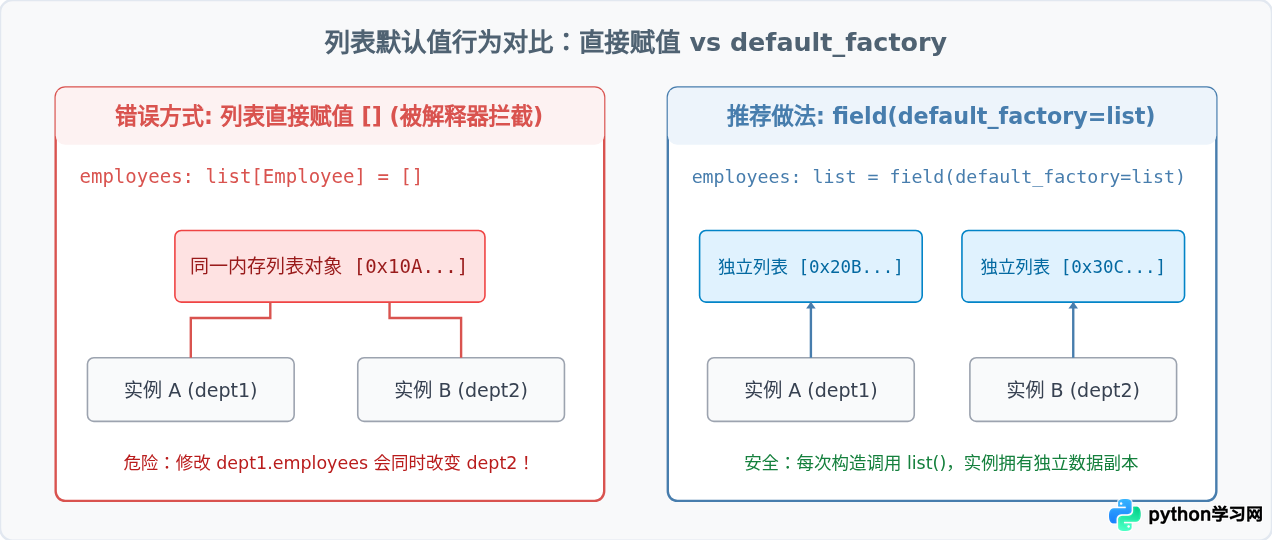
初学者容易写出类似 employees: list[Employee] = [] 的代码,这在 dataclass 中会直接抛出 ValueError: mutable default <class 'list'> for field employees is not allowed: use default_factory 异常。
这是因为 Python 的类属性在类加载时仅被求值一次。如果允许直接使用 [] 作为默认值,该类创建出的所有实例将共享同一个空列表的内存地址。修改其中一个实例的列表,其他实例的数据也会被意外篡改。通过 field(default_factory=list),dataclass 会在每次实例化时调用一次 list() 函数,为每个实例生成独立的新列表。
四、实际应用:嵌套字典反序列化为数据类
在日常开发(如调用REST API或解析JSON配置文件)中,数据通常以嵌套字典的形式提供。标准库的 asdict() 函数可以方便地将嵌套 dataclass 转为字典,但反向转换(即由嵌套 dict 生成嵌套 dataclass)如果仅用 Department(**raw_data),内部的子字段仍会是原始的字典或列表,无法还原为对应的子数据类对象。
可以使用轻量级递归解析函数完成深层反序列化:
from dataclasses import dataclass, field, is_dataclass
from typing import get_type_hints, get_origin, get_args

def from_dict(data_class, data):
    """递归将嵌套字典转换为目标 dataclass 实例"""
    if not is_dataclass(data_class) or not isinstance(data, dict):
        return data

    type_hints = get_type_hints(data_class)
    init_args = {}

    for field_name, field_type in type_hints.items():
        if field_name not in data:
            continue

        value = data[field_name]
        origin = get_origin(field_type)

        # 处理 list[Child] 场景
        if origin is list and isinstance(value, list):
            item_type = get_args(field_type)[0]
            init_args[field_name] = [from_dict(item_type, item) for item in value]
        # 处理单一子 dataclass 场景
        elif is_dataclass(field_type) and isinstance(value, dict):
            init_args[field_name] = from_dict(field_type, value)
        else:
            init_args[field_name] = value

    return data_class(**init_args)

# 示例数据源(模拟从 JSON 解析得到的原生 dict)
raw_payload = {
    "dept_id": "D02",
    "dept_name": "基础架构组",
    "manager": {"name": "刘洋", "title": "资深架构师"},
    "employees": [
        {"emp_id": 201, "name": "陈露", "role": "DevOps工程师"},
        {"emp_id": 202, "name": "赵强", "role": "SRE运维"}
    ]
}

# 转换生成完整嵌套结构体
parsed_dept = from_dict(Department, raw_payload)

# 验证子对象类型
print(type(parsed_dept.manager))           # 输出: <class '__main__.Manager'>
print(type(parsed_dept.employees[0]))     # 输出: <class '__main__.Employee'>
print(parsed_dept.employees[0].name)      # 正常访问对象属性: 陈露
五、常见问题与注意事项
| 常见问题 | 现象或原因 | 解决方案 |
|---|---|---|
| 默认值顺序错误 | SyntaxError: non-default argument follows default argument |
在定义类属性时,拥有默认值的字段必须排在没有默认值的字段之后。 |
| 类尚未声明时互相引用 | NameError: name 'Child' is not defined |
在文件开头添加 from __future__ import annotations,或者使用字符串形式 'Child' 作为注解。 |
| 深拷贝与浅拷贝修改 | 修改嵌套列表中的子元素影响其他引用 | 若需要完整克隆嵌套对象,应使用 copy.deepcopy(instance) 而不是常规赋值。 |
| JSON 序列化失败 | TypeError: Object of type Manager is not JSON serializable |
使用 dataclasses.asdict(instance) 先转换为标准 dict,再传入 json.dumps()。 |
六、实践总结
通过本文的示例,可以系统梳理在 Python 中使用 dataclass 实现结构体嵌套的知识体系:
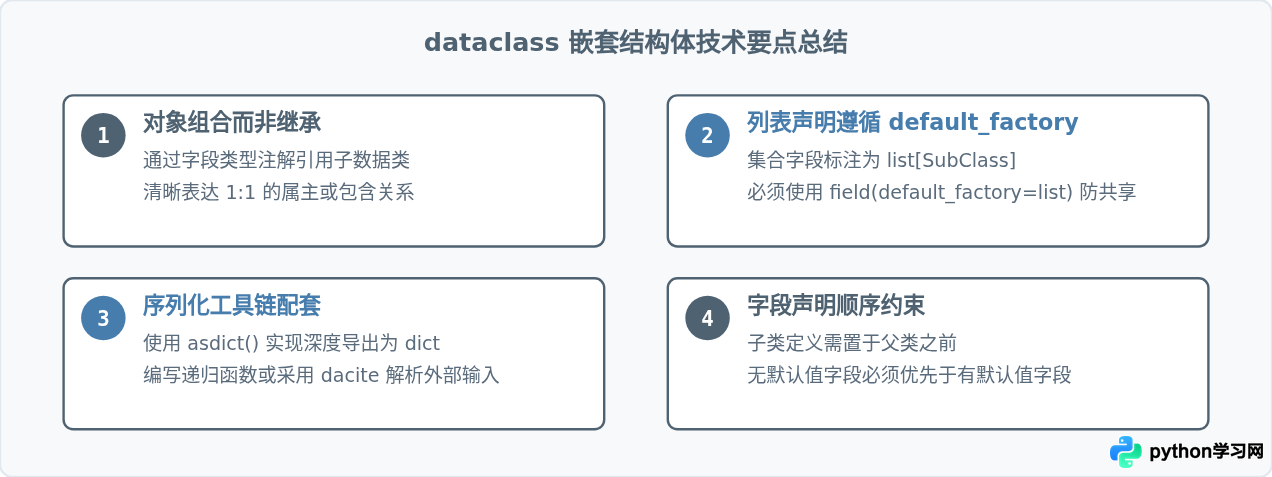
掌握这套嵌套设计模式后,无论是构建多层业务实体、解析复杂的微服务接口数据,还是组织配置结构,都可以保证代码结构强壮、类型安全且易于维护。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















