


怎么解释pandas3.0和NumPy2.5之间的版本依赖关系?
深入解析 pandas 3.0 与 NumPy 2.5 之间的版本依赖机制,从单向依赖、C-API/ABI 兼容性演进、实操排查四步法到生产环境工程锁定决策,提供清晰实用的技术指导。
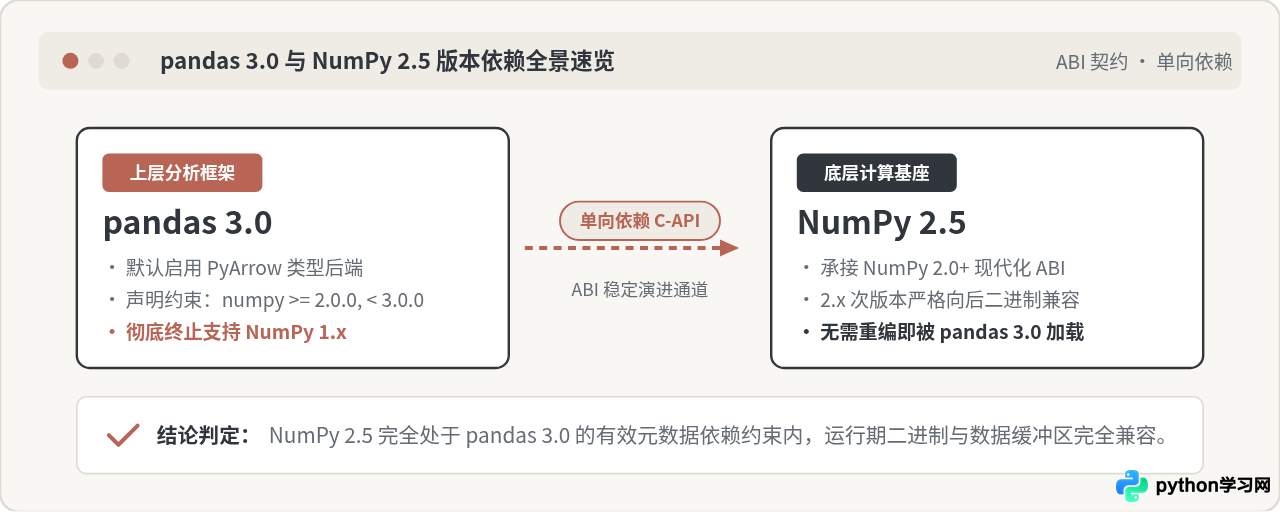
解释 pandas 3.0 与 NumPy 2.5 之间的依赖关系,核心在于两项基本机制:单向工程依赖与主版本内的次版本二进制接口(C-API/ABI)向后兼容性。在架构上,始终是 pandas 依赖 NumPy,而不是相反;pandas 3.0 的包元数据中明确声明了其支持的 NumPy 版本区间(通常为 numpy >= 2.0.0, < 3.0.0),而 NumPy 2.5 作为 2.x 系列生命周期中向后演进的次版本,严格遵循 Python 科学计算栈的语义化版本规范,保持了与 2.0 基准一致的二进制内存契约。因此,NumPy 2.5 天然处于 pandas 3.0 的有效依赖区间内。本文将通过底层机制拆解、ABI 演进矩阵、四步实操排查法以及生产锁定规范,完整讲清二者的协同原理与实践落地方式。
一、单向工程依赖与版本区间声明
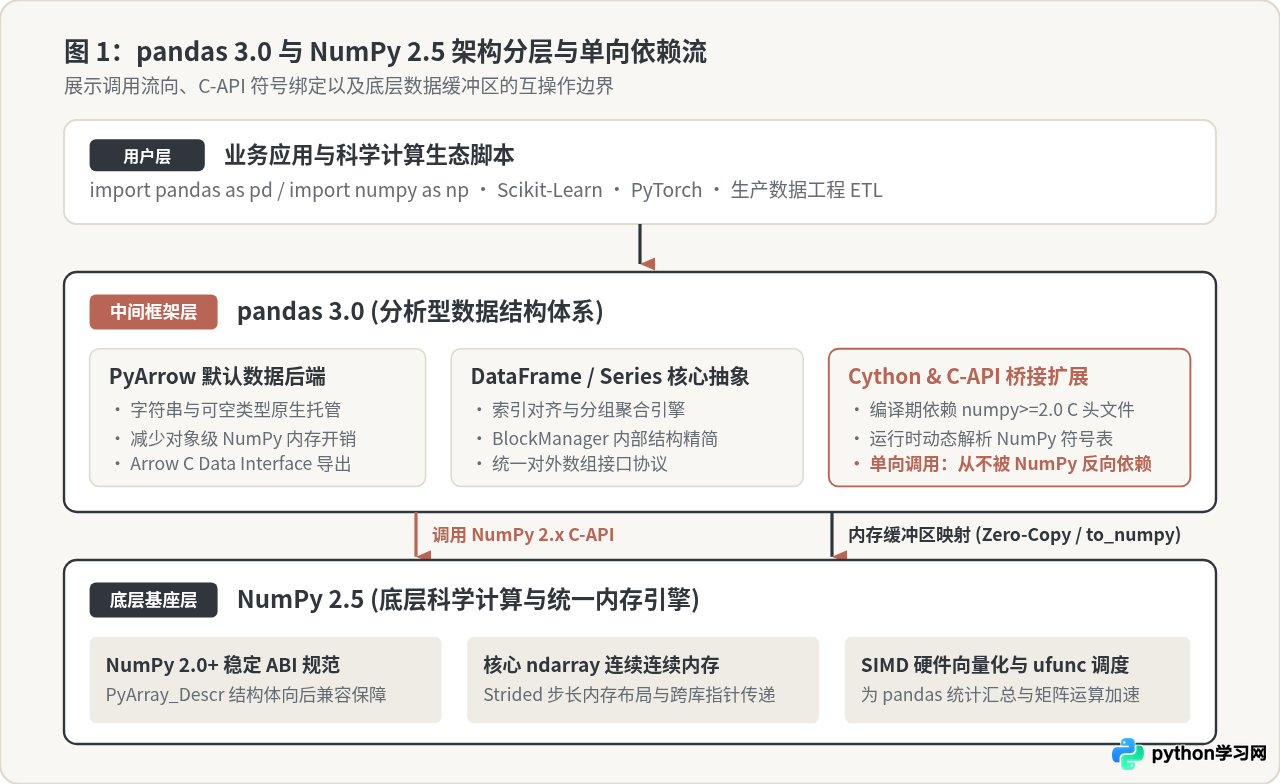
在 Python 科学计算生态中,软件包之间的依赖关系具有严格的单向性。NumPy 作为整个科学计算生态的通用底层底座,本身不引用任何高层数据分析库;而 pandas 作为一个构建在数组运算之上的数据分析框架,从诞生之初就深度绑定了 NumPy 的 C 语言底层结构体和核心对象协议。
当检查 pandas 3.0 的构建配置和分发元数据(例如 pyproject.toml 或 wheel 包内部的 METADATA 文件)时,会发现其对 NumPy 的声明形式如下:
# pyproject.toml 中的运行时依赖声明示例
[project]
name = "pandas"
version = "3.0.0"
dependencies = [
    "numpy>=2.0.0, <3.0.0",
    "python-dateutil>=2.8.2",
    "pytz>=2020.1",
    "tzdata>=2022.7"
]
从上述声明中可以清晰看到两个关键边界:
- 硬性下限(
>=2.0.0):pandas 3.0 彻底终结了对 NumPy 1.x 遗留版本的兼容,不再为旧版本保留复杂的编译期补丁或条件分支,这标志着 1.x 时代的彻底告别。 - 防御性上限(
<3.0.0):限制在主版本 3.0 之前,这是为了防御未来可能发生的破坏性 ABI 重构。由于 NumPy 2.5 的主版本号仍然是2,其完全满足<3.0.0的区间约束,包管理器(如 pip、uv 或 conda)在进行依赖求解时,会直接判定 NumPy 2.5 与 pandas 3.0 兼容并成功安装。
二、构建期 C-API 绑定与运行时 ABI 兼容机制
仅仅从版本号文本上匹配是包管理器的静态工作,而在实际 Python 进程运行期间,pandas 3.0 能否正常驱动 NumPy 2.5,取决于 C 语言层面的应用程序二进制接口(ABI,Application Binary Interface)。这是理解该依赖关系最关键、也最容易产生困惑的技术环节。
在 Python 生态中,编译型扩展库(如 pandas 的 Cython 模块)对底层库(如 NumPy)的依赖分为两个阶段:
- 构建期(Build-time):pandas 官方在编译各平台的二进制 Wheel 包(
.whl)时,引入了numpy的 C 头文件(numpy/ndarraytypes.h等),根据 C 结构体在内存中的偏移量生成机器码。为了让编译出来的 Wheel 能在尽可能多的用户机器上运行,官方构建通常锚定在支持的最低次版本(即numpy 2.0.0的 C-API 规范)。 - 运行时(Runtime):用户使用
pip install pandas安装了预编译 Wheel,并在自己的虚拟环境中安装了numpy==2.5.0。当执行import pandas时,动态链接器将已编译的pandas._libs.*.so映射到当前环境中已经载入的 NumPy 共享库。
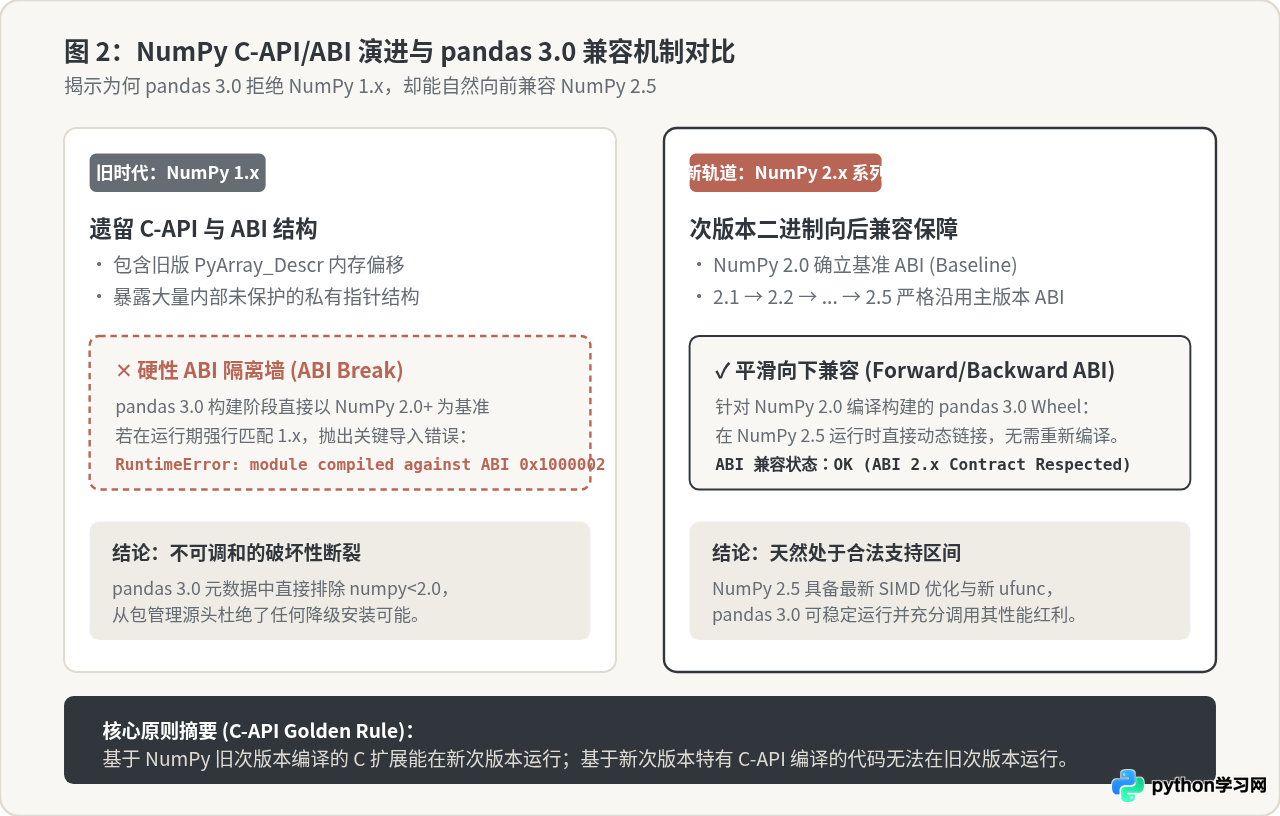
正如上图所示,这里涉及 NumPy 官方长期遵循的 C-API 向后二进制兼容黄金法则(Backward ABI Compatibility):
NumPy 2.0 是十年来改动最大的一次重构,重新设计了核心结构体(如 PyArray_Descr)的内存布局,切断了与 1.x 的 ABI 连续性。因此,为 1.x 编译的库在 2.x 上会崩溃,反之亦然。但在进入 2.x 系列后,从 2.0 到 2.5 的演进完全在稳定规范内进行:结构体偏移未被破坏,既有导出符号保持完整。由于 pandas 3.0 预编译模块以 2.0 ABI 为基准生成,面对 NumPy 2.5 的运行时环境时,符号解析畅通无阻,既不会触发 RuntimeError: module compiled against ABI mismatch,也不会引发段错误。
三、实操检验:验证兼容性的四步排查法
在实际工程开发与排错中,不能仅凭理论推导,而需要一套可执行的验证步骤,确认本地环境中 pandas 3.0 与 NumPy 2.5 的协同状态。建议按照以下顺序进行验证:
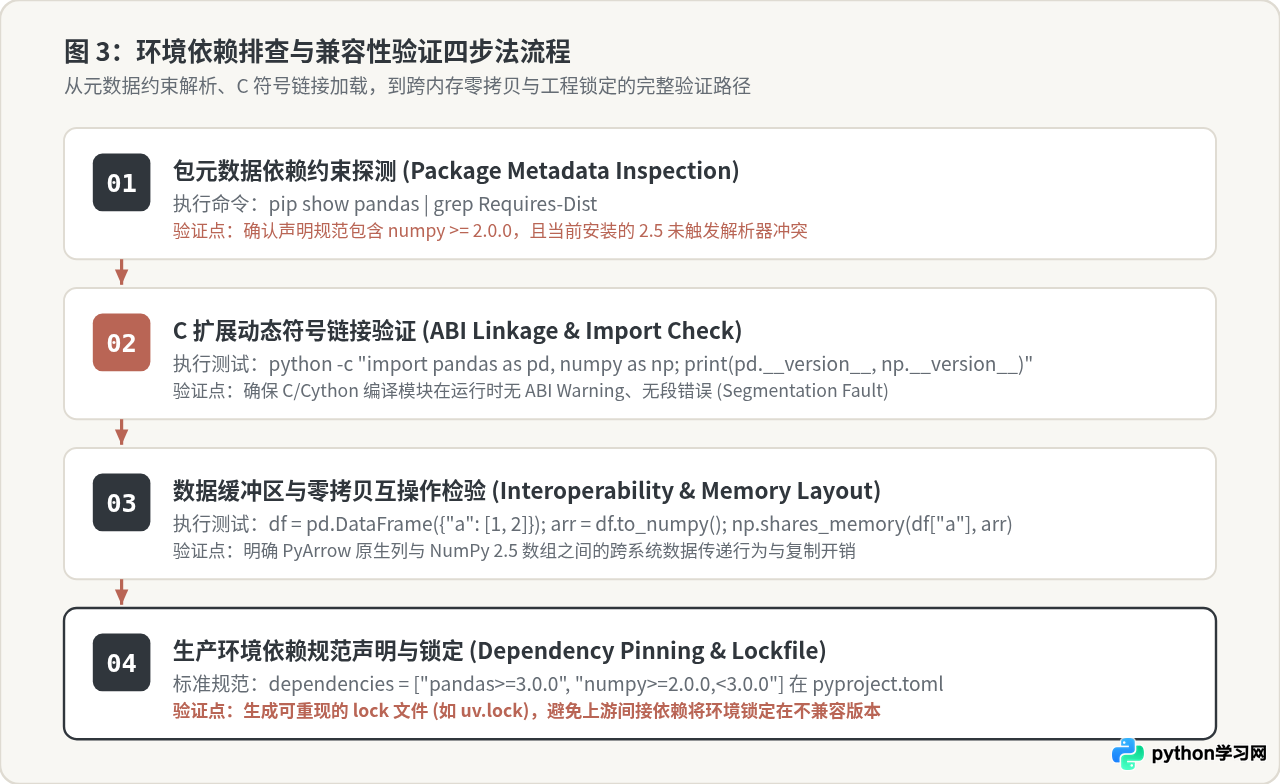
步骤一:检查已安装版本与包元数据依赖约束
在终端中查看当前 Python 环境内两个包的具体安装信息,重点确认版本号与依赖声明:
# 在终端执行包信息检查命令
$ python -m pip show pandas numpy
查看输出中的依赖项部分:
# 示例终端输出(明确标为示例)
Name: pandas
Version: 3.0.0
Summary: Powerful data structures for data analysis, time series, and statistics
Requires-Dist: numpy>=2.0.0, <3.0.0, python-dateutil>=2.8.2, pytz>=2020.1
---
Name: numpy
Version: 2.5.0
Summary: Fundamental package for array computing in Python判定标准:numpy 版本号 2.5.0 明确落在 pandas 声明的 >=2.0.0, <3.0.0 闭合区间内,包管理器未发生版本降级或回溯。
步骤二:在 Python 进程中验证 C 扩展加载与 ABI 状态
通过命令行单行脚本导入两个库,观察动态链接器是否抛出任何底层警告或错误:
# 执行底层导入与模块检查
$ python -c "import pandas as pd, numpy as np; print('pandas:', pd.__version__); print('numpy:', np.__version__)"
若环境正常,应当直接输出干净的版本字符串:
# 正常情况输出示例
pandas: 3.0.0
numpy: 2.5.0异常提醒:如果控制台打印出类似于 UserWarning: A NumPy version >=... is required... 或 ImportError: numpy.core.multiarray failed to import,通常说明环境中存在混杂的旧版残余 .so 文件,或者使用了错误针对 NumPy 1.x 编译的遗留扩展,需彻底清理虚拟环境后重装。
步骤三:验证数据类型转换与内存共享特性
pandas 3.0 的重大特征是全面以 PyArrow 作为默认后端(尤其是字符串和缺失值管理),但这并不妨碍其与 NumPy 2.5 之间的数值数组互操作。执行如下代码验证核心数据互通:
# 验证数据互操作脚本
import pandas as pd
import numpy as np

# 1. 构造基准数据
df = pd.DataFrame({
    "id": [101, 102, 103],
    "val": [12.5, 34.0, 56.5],
    "tag": ["alpha", "beta", "gamma"]
})

# 2. 导出为 NumPy 2.5 ndarray
num_arr = df[["id", "val"]].to_numpy()

# 3. 检查返回类型与计算调度
print("Array dtype:", num_arr.dtype)
print("Array shape:", num_arr.shape)
print("Mean via NumPy 2.5 ufunc:", np.mean(num_arr, axis=0))
输出示例:
# 示例运行结果
Array dtype: float64
Array shape: (3, 2)
Mean via NumPy 2.5 ufunc: [102.    34.33333333]
通过 to_numpy(),pandas 3.0 成功将内部连续列按预期导出为 NumPy 2.5 纳管的 ndarray 实例,底层通用的 ufunc 计算执行正常,表明数据契约与调用链完全连通。
步骤四:在工程配置文件中固化生产依赖规范
在团队协作或自动化构建管道中,依赖声明必须清晰规范。对于通用基础库项目,应采用开放但受控的语义区间;对于最终部署的生产应用,应采用锁文件(Lockfile)固化具体安装版本。
# pyproject.toml 规范示例(适用于应用服务)
[project]
name = "data-analysis-service"
version = "1.0.0"
dependencies = [
    "pandas>=3.0.0,<3.1.0",
    "numpy>=2.5.0,<2.6.0",
    "pyarrow>=15.0.0"
]
随后使用诸如 uv pip compile 或 poetry lock 生成精确到单次发布哈希的锁定文件,以杜绝 CI/CD 机器上可能由于第三方传递依赖解析不同而产生的分歧。
四、容易混淆的边界与反例分析
在理解 pandas 3.0 与 NumPy 2.5 的依赖关系时,有几个常见的误区与边缘场景需要特别辨析:
1. PyArrow 成为默认后端并不等于与 NumPy “解绑”
许多开发者在阅读 pandas 3.0 的更新简报时,注意到“PyArrow 成为默认存储后端”,从而误以为 pandas 已经不再依赖 NumPy。这是一种不准确的推测。实际上:
- PyArrow 主要解决了字符串存储高内存开销、跨语言数据零拷贝传输(Arrow C Data Interface)以及原生统一的空值语义(Null Handling)。
- 在面对密集型数值计算、时间序列滚动窗口、复杂线性代数运算以及与
scikit-learn/SciPy/PyTorch的模型对接时,NumPy 依然是不可替代的底层协议核心。pandas 3.0 内部大量的算子实现仍然依赖针对 NumPy C-API 编译的代码,因此对 NumPy 的依赖依然是前置强依赖。
2. 为什么 pandas 官方没有将依赖下限直接写成 numpy>=2.5?
如果 NumPy 2.5 表现优异,为什么 pandas 3.0 在发布时只要求 numpy>=2.0.0 呢?这是为了遵循最大可达兼容性原则。如果 pandas 强行将下限提升到 2.5,会导致所有生产环境中受制于其他组件只能运行在 2.0、2.1 或 2.2 的系统无法安装 pandas 3.0。由于 pandas 3.0 没有使用仅在 2.5 中新增且破坏老版本的专用 C 函数,将下限设为 2.0.0 既保证了向下覆盖,又允许用户在环境中安装最新的 2.5。
3. 链式“钻石依赖”导致的解析阻塞反例
在现实项目中,尽管 pandas 3.0 与 NumPy 2.5 互相完全兼容,但用户执行 pip install pandas==3.0.0 numpy==2.5.0 时仍可能遭遇安装失败。这通常不是二者本身的问题,而是由第三方遗留包引起的“钻石依赖冲突”。
legacy-gis==1.2。该旧库在打包时声明了硬性上限 numpy<2.0.0。此时 pip 在求解依赖树时会发现:
• pandas 3.0 强制要求
numpy>=2.0.0
• legacy-gis 1.2 强制要求
numpy<2.0.0
求解器将直接报错:
ResolutionImpossible。初学者常误以为是 pandas 3.0 无法与新版 NumPy 共存,实则是依赖树中存在未完成 2.x 升级的外部过时组件阻断了整体推进。
五、工程决策总结与选型建议
为帮助工程团队在升级或架构设计中做出合理决策,下表总结了 pandas 与 NumPy 在不同主版本交错时的兼容表现与建议:
| 组件组合 | 依赖解析状态 | 运行期 ABI 表现 | 工程建议 |
|---|---|---|---|
| pandas 3.0 + NumPy 2.5 | 完全支持 | 二进制向后兼容,稳定调用最新 SIMD 优化 | 当前主流推荐:性能与现代化特性平衡的最佳选择 |
| pandas 3.0 + NumPy 2.0 | 基准支持 | 完全兼容(构建基准) | 适合追求绝对谨慎、优先采用早期 LTS 修复包的系统 |
| pandas 3.0 + NumPy 1.26 | 解析拒绝 | 硬性 ABI 阻断,导入必崩(RuntimeError) | 严禁混用:必须升级 NumPy 或退回使用 pandas 2.2 |
| pandas 2.2 + NumPy 2.x | 条件支持 | pandas 2.2.2+ 包含过渡兼容垫片,但非原生默认 | 适合作为从 1.x 迁移到 3.0 过程中的中间过渡阶段 |
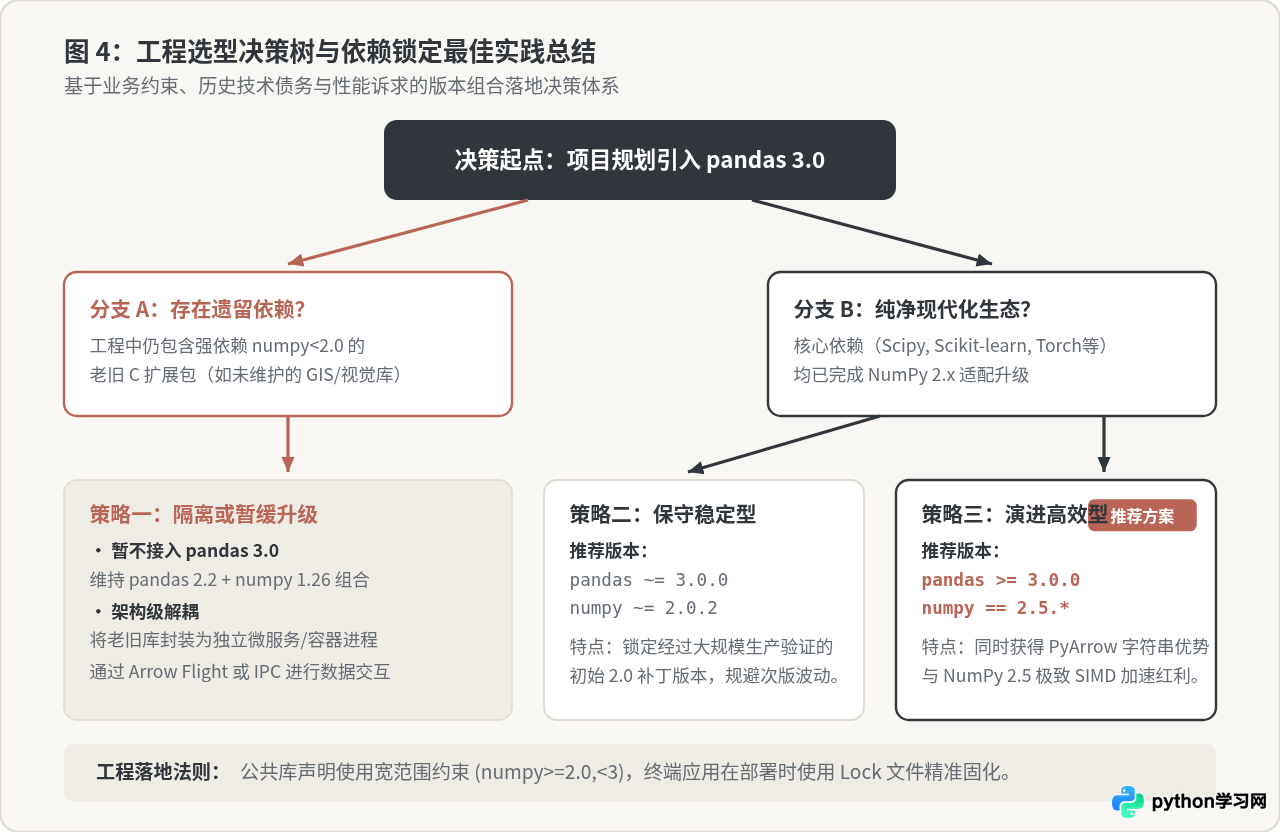
总结而言,解释 pandas 3.0 与 NumPy 2.5 的依赖关系,只需把握三个核心逻辑:第一,在依赖链路上是 pandas 单向调用 NumPy 的底层基础设施;第二,在版本约束上,NumPy 2.5 严格落在 pandas 3.0 声明的 >=2.0.0, <3.0.0 规范空间内;第三,在底层二进制通信上,NumPy 2.x 系列遵循的 C-API 向后兼容保证,使得基于 2.0 基准编译的 pandas 3.0 能够无缝运行在 NumPy 2.5 之上。只要确保项目生态中排除了陈旧的 numpy<2.0 依赖项,二者的组合就是稳定、高效且具备完整现代性能特性的理想技术栈选择。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















