


Python爬虫遭遇403或IP被封怎么办?合规反爬应对策略
深入剖析Python爬虫遭遇403 Forbidden与IP封禁的核心成因,从特征指纹缺失、高频访问风控到IP信誉评级,提供合规协议遵从、请求头拟真、自适应退避降频及高匿代理轮换等完整解决方案。
Python 爬虫在采集公开数据时遭遇 403 Forbidden 或 IP 被封,核心原因在于请求的协议特征或访问频次击中了目标站点的安全防护阈值(如 Web 应用防火墙 WAF、反爬网关或速率限制策略)。常见根源包括未配置仿真请求头暴露了脚本身份、短时间内发起过于密集的并发请求、以及缺乏对错误响应的自适应退避处理。最行之有效且长效的解决路径是建立梯级治理策略:先核对并严格遵守目标网站的 robots.txt 规范,补齐完整的浏览器仿真请求头与会话维持机制,接着引入带有随机抖动的指数退避降频算法,并在合规许可与必要场景下引入高匿代理池实现网络出口隔离。
一、403 Forbidden 与 IP 封禁的特征差异与触发根因
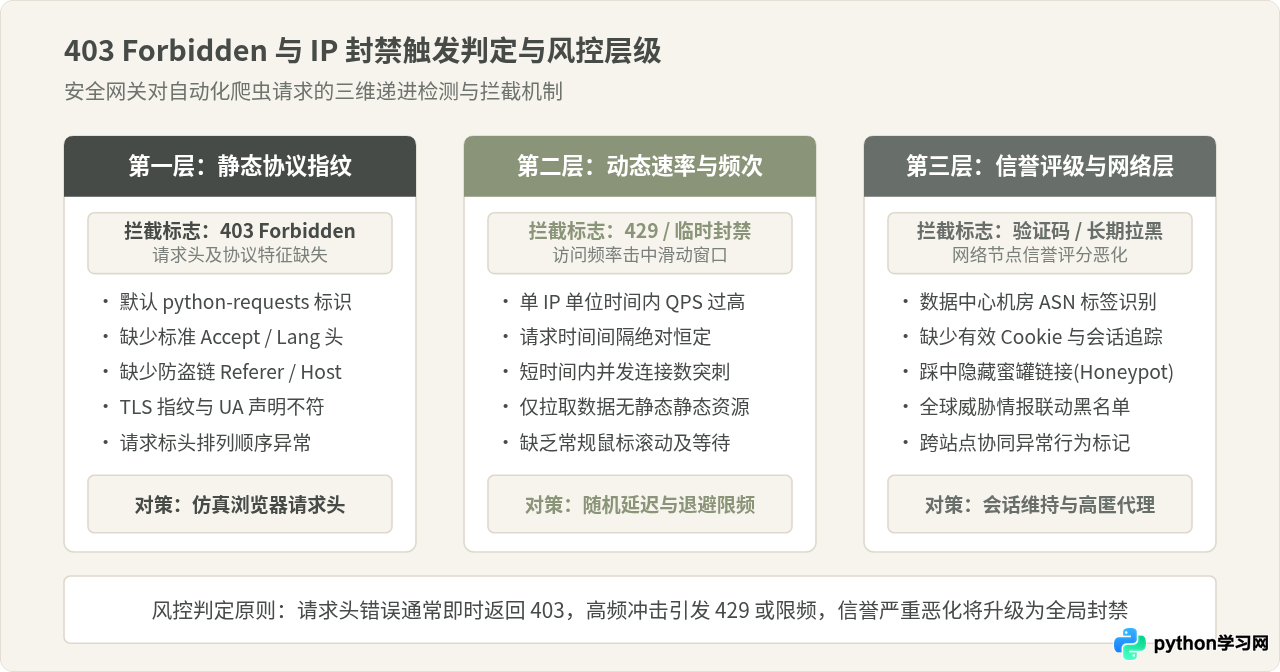
在编写爬虫脚本时,很多开发者容易将 403 错误与 IP 封禁混为一谈。实际上,二者在网络协议层、风控逻辑以及拦截表现上具有显著差异:
- 403 Forbidden(HTTP 应用层阻断):表示服务器已成功收到 HTTP 请求,但基于安全规则拒绝提供资源。这种拦截绝大多数发生在应用层,通常是因为请求头中缺少浏览器必备字段(如 User-Agent、Accept、Referer)、携带了被识别为自动化工具的默认指纹(例如 Python Requests 默认标识),或者请求参数未能通过前置鉴权。在此时,客户端的 IP 地址往往并未被加入底层黑名单,更换请求头后通常能立刻恢复通信。
- 429 Too Many Requests 与 IP 封禁(网络层/网关层风控):当爬虫在单位时间内的请求频率过高,触发了服务端的滑动窗口限频规则时,网关会先返回 429 状态码。若爬虫程序未作降频处理继续发起高频冲击,反爬系统便会将该源 IP 加入临时或长期封禁列表。此时的特征表现为随后的所有请求均被阻断,不仅爬虫报错,连在同一网络环境下使用正常浏览器打开网页也会弹出人机验证码(CAPTCHA)、Cloudflare 拦截盾,或直接触发 TCP 连接重置与超时。
二、遭遇 403 与 IP 封禁的排查与阶梯修复步骤
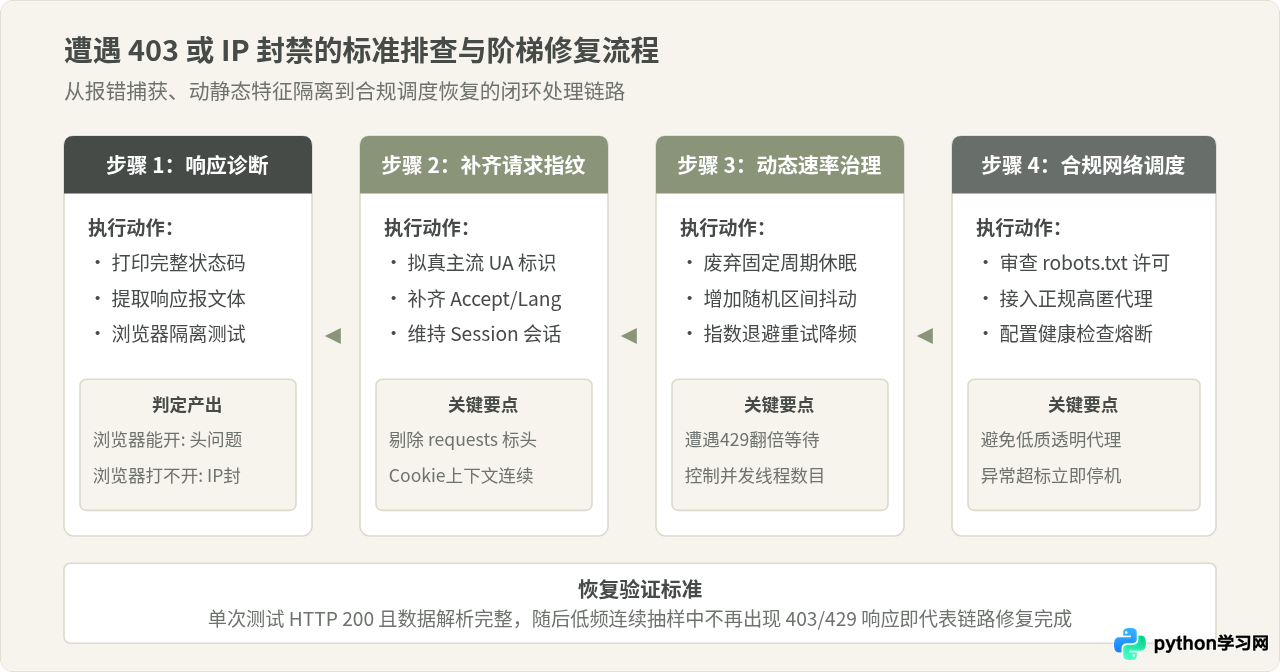
当爬虫程序抛出 403 或无法建立连接时,不应盲目胡乱尝试,而应按照由浅入深的步骤逐步隔离问题根源:
- 步骤一:响应隔离诊断与特征对比。在出现 403 时,首先使用同一台机器上的原生浏览器打开目标页面。如果浏览器可以正常浏览,说明当前 IP 并没有被封锁,问题百分之百出在爬虫发送的请求特征上;如果浏览器同样被拦截或要求输入验证码,说明出口 IP 已经进入目标站点的风控名单。
- 步骤二:标准化补齐请求头与指纹仿冒。将自动化客户端的标头伪装为现代主流浏览器。必须替换默认的
User-Agent,同时按需补全Accept、Accept-Language、Accept-Encoding以及必要的Referer和Host,确保请求头符合真实用户访问网页时的网络特征。 - 步骤三:使用 Session 维持会话与连接上下文。现代网站通常依赖 Cookie 来跟踪访问上下文。使用独立的
requests.Session()对象可以自动维持 Cookie,同时复用底层的 TCP 长连接,既能减少握手开销,又符合正常浏览器的资源加载行为。 - 步骤四:构建自适应速率控制与退避机制。彻底废除高并发盲目循环抓取。为爬虫请求引入随机区间的延迟等待,并且在捕获到 429 或 403 响应时,执行指数退避(Exponential Backoff),主动让爬虫休眠降频,避免触发更加严厉的封锁。
- 步骤五:合规调度高匿代理池与网络出口隔离。如果目标网站针对单个 IP 设置了极低的访问上限,且抓取行为严格符合站点声明与版权范围,可配置高匿(Elite/High Anonymous)代理池轮换出口 IP,并建立代理节点的健康检查与自动熔断剔除机制。
三、常见防封误区的认知辨析与条件边界
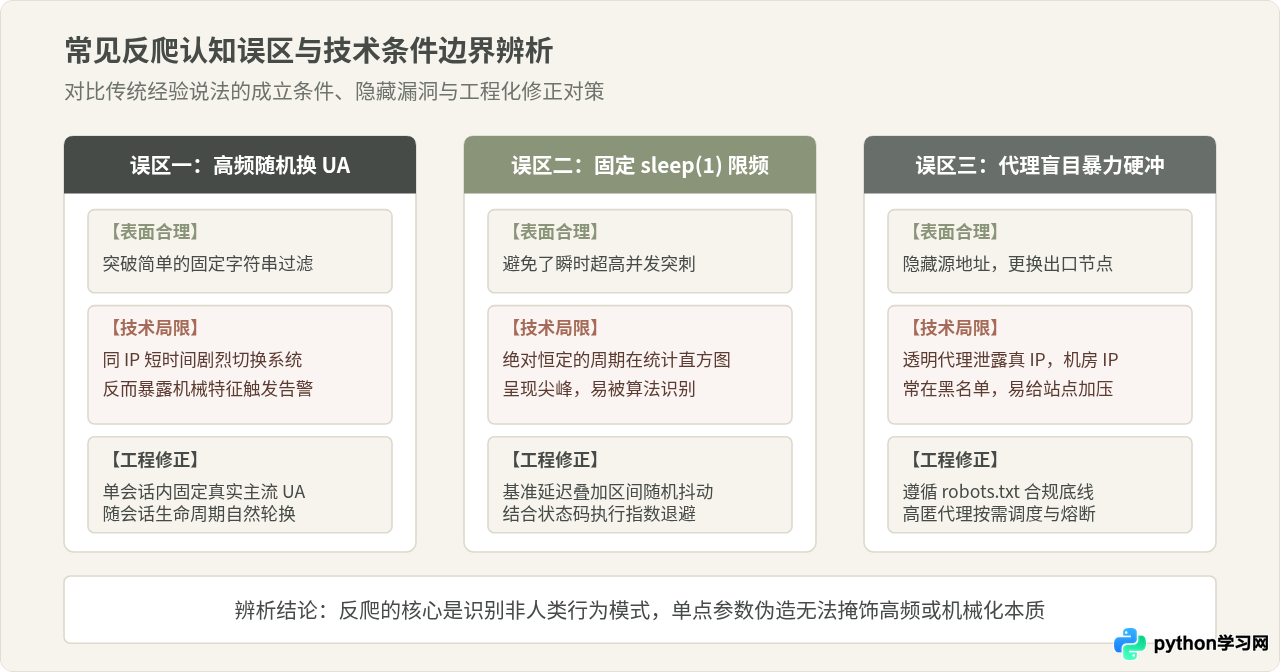
在应对爬虫反爬时,网络上流传着一些看似合理但实际存在明显技术漏洞的“经验法则”。必须清晰理解它们在什么条件下生效,在什么条件下会导致风控进一步升级:
1. 误区一:“只要每次请求随机更换 User-Agent 就不会被拦”
看似合理的原因:很多基础防爬规则确实只检查 User-Agent 字符串。如果使用默认的 python-requests/2.31.0,会被直接拒之门外,而换上浏览器的 User-Agent 即可恢复访问。
适用边界与潜在缺陷:这一策略仅适用于静态小网站。现代 WAF 会将出口 IP 与请求指纹建立关联。如果在同一个 IP 下,1 秒钟之内发出了 10 次请求,分别声称自己来自 Windows 上的 Chrome、macOS 上的 Safari、Android 上的 UC 浏览器以及 Linux 上的 Firefox,这种剧烈的指纹抖动反而构成了极为明显的异常机器特征,直接触发高级风控报警。
工程修正方案:在同一个爬虫会话(Session)生命周期内,固定使用同一个主流浏览器的真实 User-Agent,并在会话重建或代理轮换时再进行同步更新,保持会话行为的真实一致性。
2. 误区二:“在循环里加一个固定 sleep(1) 就安全了”
看似合理的原因:通过硬编码等待 1 秒钟,确实避免了瞬时毫秒级的并发突刺,降低了瞬时吞吐量。
适用边界与潜在缺陷:人类的访问行为具有天然的不确定性,阅读、滚动、点击的间隔时间符合统计学上的长尾分布。如果在服务器端抓包并绘制请求到达间隔的统计直方图,固定 time.sleep(1.0) 会在 1.000 秒处呈现出一个极其陡峭的尖峰。WAF 的滑动窗口与统计学模型能够轻而易举地将这种机械节奏标记为脚本行为。
工程修正方案:采用“基准延迟 + 随机抖动(Jitter)”策略,例如设置 1.5 + random.uniform(0.5, 2.0) 秒的浮动等待区间;同时结合服务器返回的响应状态码实施自适应调整。
3. 误区三:“IP 被封了只要买代理池暴力硬怼就行”
看似合理的原因:代理服务器能够替换出口 IP,让目标服务器看到的是代理节点的公网地址。
适用边界与潜在缺陷:首先,许多廉价代理属于透明代理或普匿代理,会通过 X-Forwarded-For 报文头直接泄露爬虫的真实源 IP;其次,公开代理池的 IP 往往已被大量滥用,早已进入各大云安全厂商的恶意 IP 信誉库,一经使用同样会被秒封;更重要的是,如果不控制请求速率,单靠暴力换 IP 硬冲不仅会迅速烧光代理资源,还极易对目标站点服务器造成过载压力,引发严重的合规与法律风险。
工程修正方案:将代理池定位为“分散合规请求、降低单点依赖”的网络层保障,而非暴力突破反爬的工具。严格把控总体抓取并发,选用高匿名度出口,并配备自动化健康探针。
四、合规爬虫工程实现与核心代码示例
为了将上述策略落地到实际开发中,下面给出一个包含会话维护、请求头封装、随机抖动延迟以及指数退避重试的完整 Python 代码实现:
import time
import random
import logging
import urllib.robotparser
from urllib.parse import urlparse
import requests

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

# 1. 检查 robots.txt 规范
def can_fetch_url(target_url, custom_ua="*"):
    parsed = urlparse(target_url)
    robots_url = f"{parsed.scheme}://{parsed.netloc}/robots.txt"
    rp = urllib.robotparser.RobotFileParser()
    rp.set_url(robots_url)
    try:
        rp.read()
        allowed = rp.can_fetch(custom_ua, target_url)
        logging.info(f"Robots 规则校验: {target_url} 抓取许可={allowed}")
        return allowed
    except Exception as exc:
        logging.warning(f"读取 robots.txt 失败: {exc},默认采取低频谨慎策略")
        return True

# 2. 构建真实浏览器仿真请求头与会话
def create_robust_session():
    session = requests.Session()
    headers = {
        "User-Agent": (
            "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) "
            "AppleWebKit/537.36 (KHTML, like Gecko) "
            "Chrome/128.0.0.0 Safari/537.36"
        ),
        "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,*/*;q=0.8",
        "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
        "Accept-Encoding": "gzip, deflate, br",
        "Connection": "keep-alive",
        "Sec-Fetch-Dest": "document",
        "Sec-Fetch-Mode": "navigate",
        "Sec-Fetch-Site": "none",
        "Sec-Fetch-User": "?1",
        "Upgrade-Insecure-Requests": "1"
    }
    session.headers.update(headers)
    return session

# 3. 具备随机抖动与自适应指数退避的抓取函数
def safe_fetch(url, session, max_retries=4, base_delay=1.5):
    if not can_fetch_url(url):
        logging.error(f"目标 URL {url} 被 robots.txt 明确拒绝抓取,终止操作")
        return None

    for attempt in range(max_retries):
        # 基础延时叠加随机浮动,打碎固定周期规律
        sleep_duration = base_delay + random.uniform(0.5, 1.8)
        time.sleep(sleep_duration)

        try:
            response = session.get(url, timeout=12)

            if response.status_code == 200:
                logging.info(f"抓取成功 [{response.status_code}]: {url}")
                return response

            elif response.status_code in (403, 429):
                # 遭遇风控,执行指数退避:2^attempt 加上随机抖动
                backoff = (2 ** attempt) * 2.0 + random.uniform(1.0, 3.0)
                logging.warning(
                    f"遭遇风控状态码 [{response.status_code}],第 {attempt + 1} 次尝试,"
                    f"降频退避 {backoff:.2f} 秒..."
                )
                time.sleep(backoff)
            else:
                logging.warning(f"服务器返回非成功状态码 [{response.status_code}]")
                break

        except requests.exceptions.RequestException as error:
            backoff = (2 ** attempt) + random.uniform(0.5, 1.5)
            logging.error(f"网络连接异常: {error},等待 {backoff:.2f} 秒后重试")
            time.sleep(backoff)

    logging.error(f"多次重试后仍无法获取内容: {url}")
    return None

if __name__ == "__main__":
    target = "https://httpbin.org/get"
    client = create_robust_session()
    result = safe_fetch(target, client)
    if result and result.status_code == 200:
logging.info(f"响应内容长度: {len(result.text)} 字节")代码实现要点提示:在上述示例中,time.sleep() 的等待时间始终包含 random.uniform() 生成的随机抖动量(Jitter),能够有效抹平机械规律;而在捕获到 403 或 429 状态码时,通过 (2 ** attempt) 形成阶梯式倍增的休眠时间,主动给服务器安全网关预留冷却窗口,避免连续发起无效重试导致 IP 被彻底封杀。
五、合规反爬工程治理长效保障机制
应对反爬虫机制不应是一场无休止的技术对抗,建立符合行业规范的长效工程体系才是保障数据采集业务稳定运行的根本之道:
- 确立合法合规基准红线:严格遵守《中华人民共和国网络安全法》及《民法典》相关规定,明确采集范围仅限于公开授权数据。绝对不越界采集用户个人隐私数据、商业机密、需付费授权的数据或需要绕过密码鉴权的内容。
- 严格尊重并解析 Robots 协议:在任务启动前,程序应自动拉取目标域名的
robots.txt文件并进行规则匹配。对于声明了Disallow的目录路径,应坚决予以排除,不强行发起探测。 - 错峰采集与友好的并发度控制:根据目标站点的业务特征,将大规模抓取任务安排在凌晨等服务器流量低谷期执行。严格限制单机或集群的并发请求数,避免对目标站点的正常业务用户造成性能干扰。
- 全自动健康探测与紧急熔断(Circuit Breaker):在爬虫架构中建立服务健康度感知模块。一旦检测到目标站点的错误响应率(如连续出现 500、502、503 或大面积 429)超过设定阈值(例如连续失败达到 5 次),程序必须自动触发熔断暂停运行,并向运维人员发送告警,防止自动化程序成为拖垮服务器的“拒绝服务攻击者”。
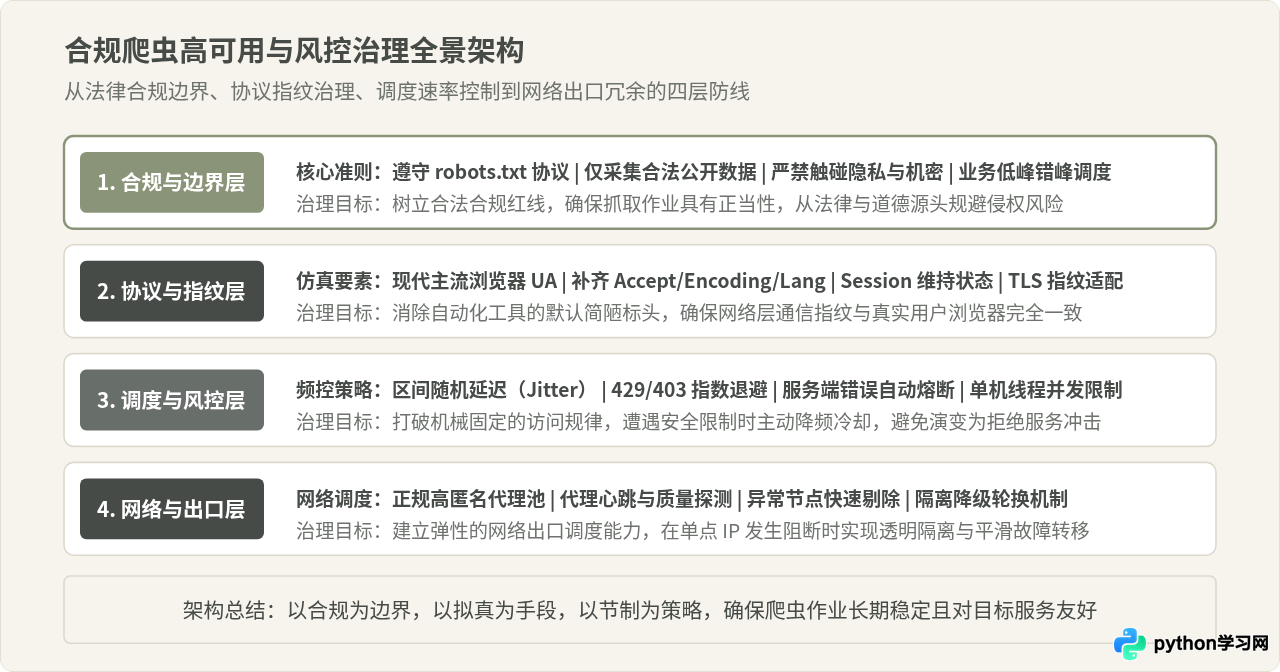
合规底线警示:网络爬虫技术本身属于中立工具,但技术的使用必须受制于法律法规。切勿通过破坏技术防护措施去强行抓取敏感资产,也不得以超出目标服务器承载能力的高并发去实施爬取。遇到 403 与 IP 封禁时,首先应当反思自身抓取频次与范围是否合理,坚持“礼貌、克制、合规”的原则,才是数据工程长期持续发展的基石。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















