


Python基础语法速查表:常用数据类型与控制流一行代码示例
本篇Python基础语法速查表全面梳理了数字、字符串、列表、元组、字典、集合等核心数据类型以及三元表达式、循环推导与逻辑短路等控制流的高频单行代码示例,深入解析内存特性、执行原理与工程可读性边界。
在Python日常开发、数据探索与自动化脚本编写中,熟练掌握内置数据类型与控制流的紧凑表达方式,不仅能够有效减少样板代码,还能显著提升交互式环境下的调试效率。本文系统整理Python常用数据类型(数值、字符串、列表、元组、字典、集合)与常见控制流(三元条件、推导式、短路评估)的高频一行代码实用写法,结合内存机制与执行流程进行清晰拆解,为开发者提供一份兼顾实用性与可读性权衡的速查参考。
一、核心数据类型一行代码速查
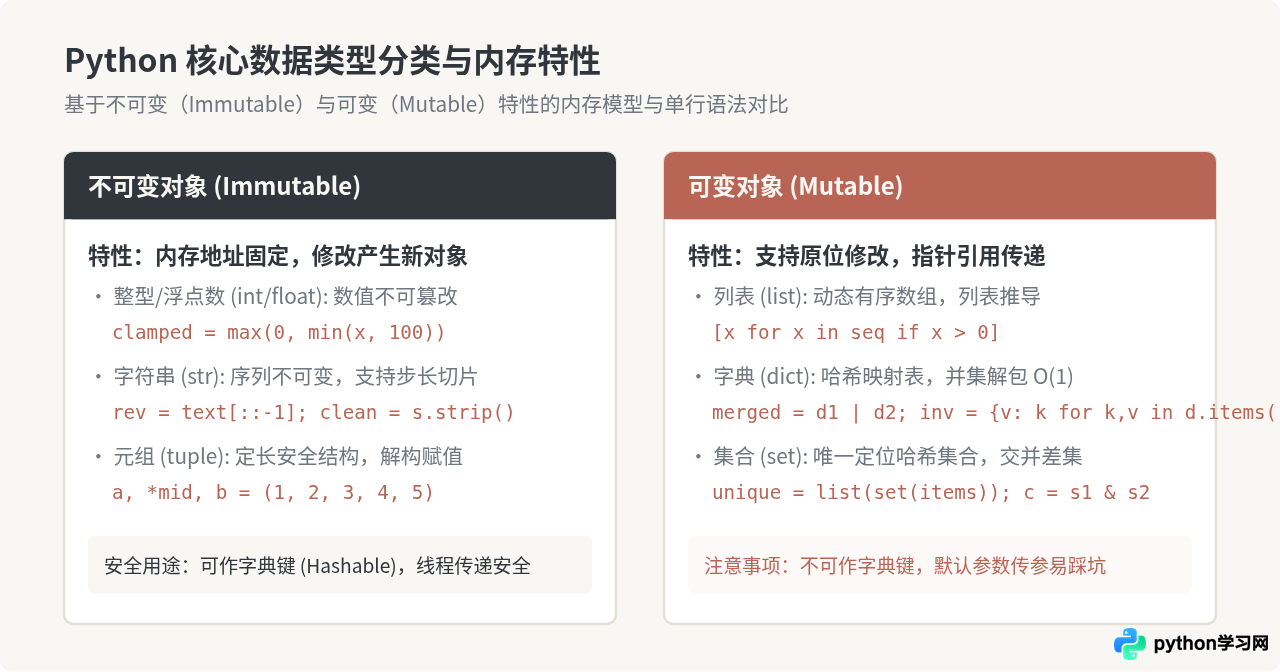
Python数据类型在底层设计上清晰地区分为不可变对象(Immutable)与可变对象(Mutable)。不可变对象的哈希值稳定,在单行操作中通常通过返回全新对象完成计算;而可变对象则支持原位修改与就地更新。理解这一本质差异是一行代码写得准确、安全的前提。
1. 数字与布尔型(Numeric & Boolean)
数值类型包括 int、float 与 bool。在进行范围限制或极值运算时,利用内置函数嵌套可以省去繁琐的 if-else 判定。
# 1. 范围截断(将x约束在[0, 100]区间内)
clamped = max(0, min(x, 100))

# 2. 绝对值转换与整数解析
val = abs(int("-42"))

# 3. 浮点数四舍五入并保留两位小数
rounded = round(3.1415926, 2)

# 4. 数值符号指示器(正数返回1,负数返回-1,零返回0)
sign = (x > 0) - (x < 0)
2. 字符串(String)
字符串是不可变的字符序列,利用切片语法 [start:stop:step] 与常用内置方法可以轻松实现倒序、修剪与格式化。
# 1. 字符串切片极速反转
reversed_text = text[::-1]

# 2. 头尾多余字符修剪(空格、换行、特定标点)
cleaned_text = text.strip(" \t\n,.")

# 3. 列表元素以指定分隔符合并为单字符串
joined_str = ", ".join(["苹果", "香蕉", "橙子"])

# 4. 字符串分割并自动剔除多余空字符
words = [w for w in text.split(" ") if w]

# 5. f-string快速格式化(数字补零与小数位控制)
formatted = f"编号: {user_id:04d} | 评分: {score:.1f}"
3. 列表与元组(List & Tuple)
列表是动态连续数组,支持推导式(List Comprehension)进行原位映射与过滤;元组则是固定长度的保护容器,是函数多返回值与解构赋值的标准载体。
# 1. 条件列表推导(过滤偶数并计算平方)
even_squares = [x**2 for x in nums if x % 2 == 0]

# 2. 二维矩阵平铺为一维列表
flat_list = [item for row in matrix for item in row]

# 3. 原生变量交换(无需临时第三方变量)
a, b = b, a

# 4. 星号扩展解构(提取头部、尾部与中间剩余所有项)
first, *middle, last = [10, 20, 30, 40, 50]

# 5. 基于元素内部属性的单行稳定排序
sorted_records = sorted(users, key=lambda u: u["age"], reverse=True)
4. 字典与集合(Dict & Set)
字典与集合均基于哈希表实现,具备均摊 $O(1)$ 的查找与插入效率。通过字典推导式与运算符重载,可以优雅实现映射合并与去重。
# 1. 字典合并(Python 3.9+ 推荐合并运算符 |;旧版本可用解包 {**d1, **d2})
merged_dict = dict_a | dict_b

# 2. 字典键值反转推导(反向构建索引)
inverted_dict = {value: key for key, value in original_dict.items()}

# 3. 字典提取与默认兜底(避免KeyError)
target_val = record.get("status", "pending")

# 4. 列表单行去重(无序场景下效率最高)
unique_items = list(set(raw_list))

# 5. 集合差集与交集运算
difference = set_a - set_b
intersection = set_a & set_b
二、控制流的一行化表达与执行逻辑
控制流语句(条件分支与循环迭代)在Python中通常以块级缩进呈现。但在逻辑单一、紧凑表达的场景下,Python提供了三元条件表达式(Conditional Expression)与基于生成器的短路评估内置函数(any、all、next)。
1. 三元条件表达式
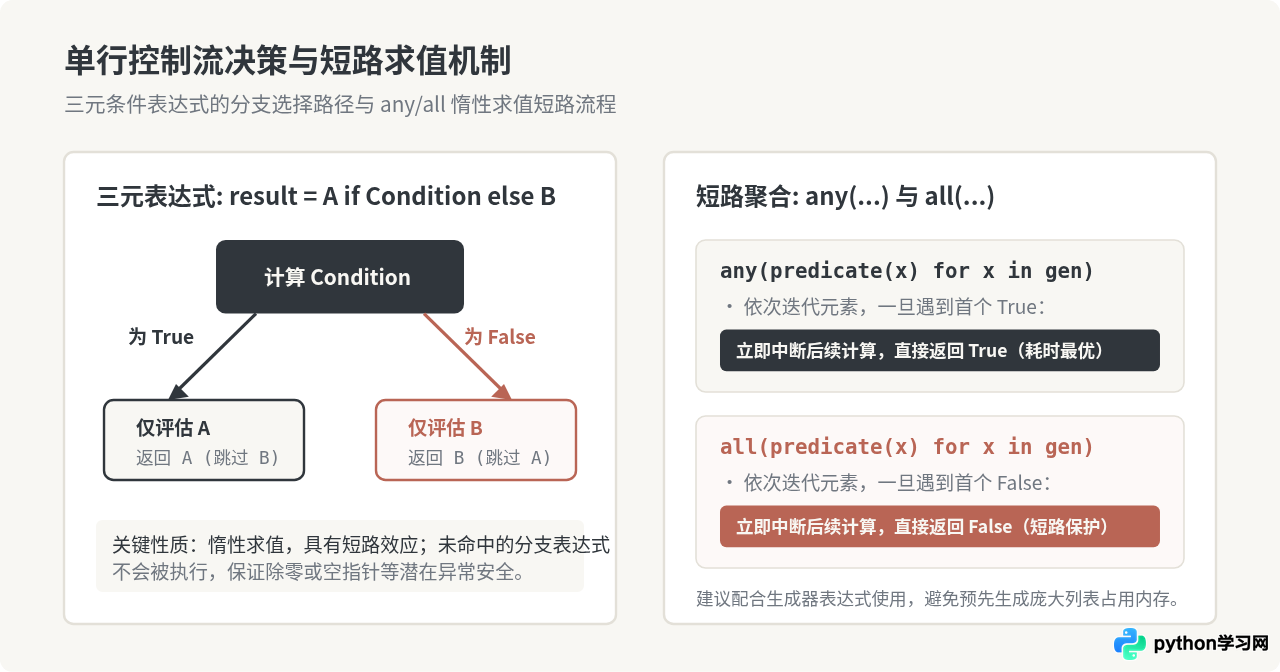
标准三元语法为 A if condition else B。其核心特征是短路求值:若条件为真,则只对表达式 A 进行求值;若条件为假,则跳过 A 仅求值 B。
# 1. 基础单行分支赋默认值
status = "通过" if score >= 60 else "未通过"

# 2. 避免除零错误的安全保护(分母为0时返回0,否则计算商)
ratio = numerator / denominator if denominator != 0 else 0.0

# 3. 逻辑运算符短路回退(利用 or 的真值测试)
display_name = user_input or "匿名访客"
2. 集合判断与惰性短路(any / all)
利用生成器表达式配合内置聚合函数,能够在满足终止条件的第一时间跳出循环,无需遍历全部数据。
# 1. 判定序列中是否存在至少一个负数(遇首个负数立即中断)
has_negative = any(x < 0 for x in dataset)

# 2. 判定序列是否全部符合规范(遇首个非法项立即返回False)
is_all_valid = all(len(token) > 0 for token in tokens)

# 3. 从序列中抓取首个匹配项并提供默认值
first_target = next((item for item in items if item["active"]), None)next() 传入生成器表达式时,务必提供第二个参数作为默认值(例如 None)。若省略默认值且未匹配到任何项,Python将直接抛出 StopIteration 异常。
三、实战推导:复合数据处理单行流水线
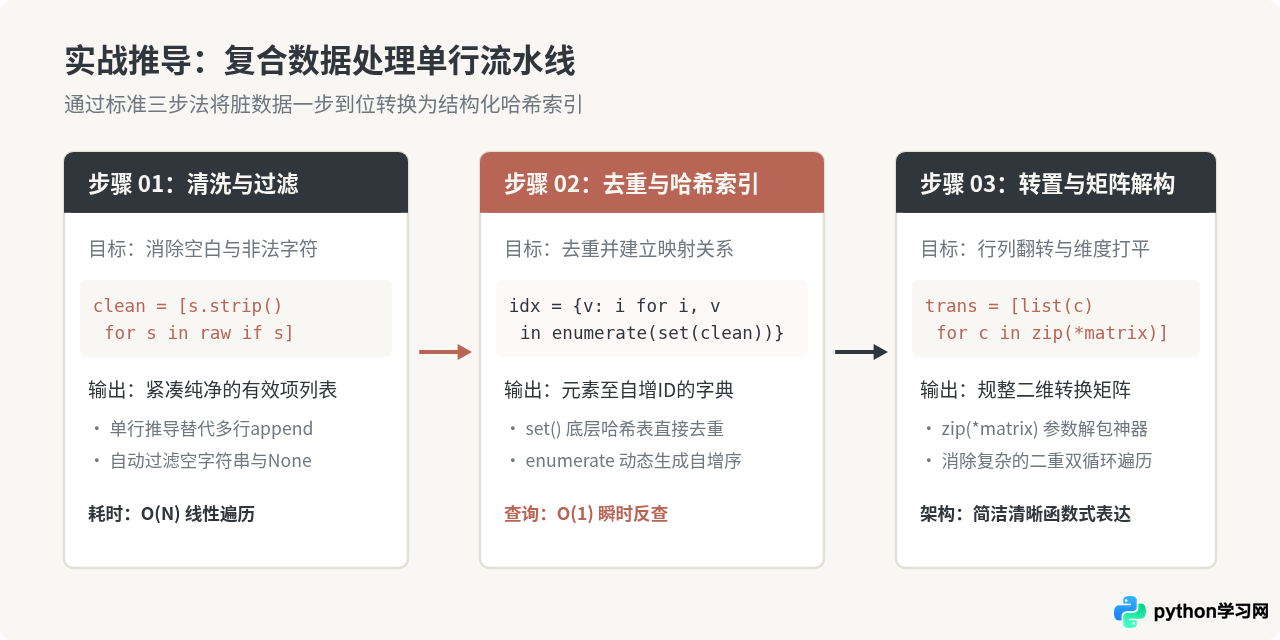
在真实任务中,单行代码常用于衔接上游脏数据与下游结构化模型。通过将列表清洗、去重与多维转置串联成标准流水线,开发者可以用精炼的代码完成原本需要数十行循环才能实现的功能。
步骤一:数据清洗与空值截断
从外部文件或API获取的原始列表往往夹杂前后空白符与空字符串。通过单行推导直接完成去空格与非空校验:
raw_records = ["  admin ", "", "  guest\n", None, "tester  "]
# 清洗前后空白并剔除所有假值项
cleaned = [s.strip() for s in raw_records if s and s.strip()]
# 结果示例: ['admin', 'guest', 'tester']
步骤二:去重并建立反向自增索引
利用 set() 的去重能力与 enumerate() 的索引自增机制,单行生成反向查询字典:
# 字典推导:将去重后的元素映射到自增ID
id_map = {item: idx for idx, item in enumerate(sorted(set(cleaned)))}
# 结果示例: {'admin': 0, 'guest': 1, 'tester': 2}
步骤三:二维数据转置(行列互换)
对于规整的二维数据矩阵,借助 zip(*matrix) 的参数解包特性即可完成优雅转置:
matrix = [[1, 2, 3], [4, 5, 6], [7, 8, 9]]
# 一行实现矩阵行列转置
transposed = [list(col) for col in zip(*matrix)]
# 结果示例: [[1, 4, 7], [2, 5, 8], [3, 6, 9]]
四、一行代码的边界、可读性权衡与反模式
虽然单行代码在语法层面上展示了Python极强的表达力,但在商业工程项目中,代码的可读性、可维护性与异常排查成本永远优先于物理行数的压缩。盲目追求单行容易产生“编写容易阅读困难”的反模式。
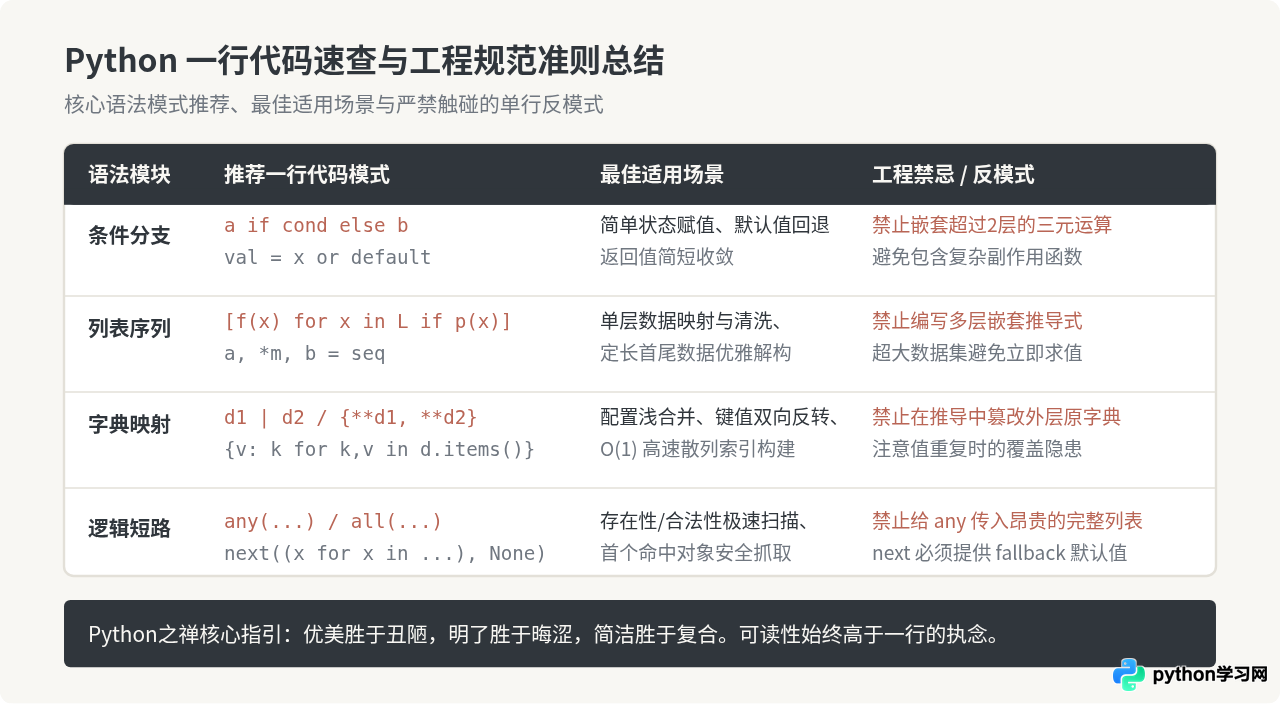
1. 典型反模式警示
- 深层嵌套三元表达式:形如
a if c1 else (b if c2 else (c if c3 else d))的多层嵌套严重破坏视觉扫描流,必须重构为清晰的if-elif-else结构或查表字典。 - 在推导式中产生非预期副作用:推导式的目的应当是创建新容器,严禁在推导式内部执行外部变量赋值、向全局列表追加项或发起网络IO。
- 列表推导式与生成器表达式混淆:在面对海量数据(如数百万条记录)进行求和或存在性检查时,若书写为
sum([x for x in big_data])会将百万个对象一次性载入内存,而改用括号sum(x for x in big_data)即可按需惰性迭代,内存占用降至常量级别。
2. 编写建议与选用原则
遵循《Python之禅》(The Zen of Python)的核心思想:扁平胜于嵌套,明了胜于晦涩。当一段单行代码的字符长度超过80~100字符,或者包含两层以上的条件/循环嵌套时,拆分成标准的具名函数或多行语句是更加稳妥的工程决策。将单行模式保留在数据清洗、快速映射与状态收敛等高频、单一职责的场景下,才能让代码既高效又优雅。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















