


Python使用with语句安全打开文件的最佳实践
全面讲解Python中使用with语句安全操作文件的机制、标准编码规范、多文件处理与流式读取的最佳实践。
在Python中处理文件时,最稳健的做法是始终通过 with 上下文管理器配合显式编码规范来操作。它能够保证无论代码块是正常执行完毕还是因抛出异常而意外中断,文件描述符都会被操作系统确定性地即时关闭,从根本上杜绝系统资源泄漏与数据截断。
一、为什么直接使用 open() 会带来资源隐患
文件作为受操作系统内核统一调配的有限系统资源,每次调用 open() 都会占用一个专用的文件描述符(File Descriptor)。在操作系统层面上,单个进程能够持有的最大打开文件数量存在严格配额(例如类Unix系统中的 ulimit -n 限制)。
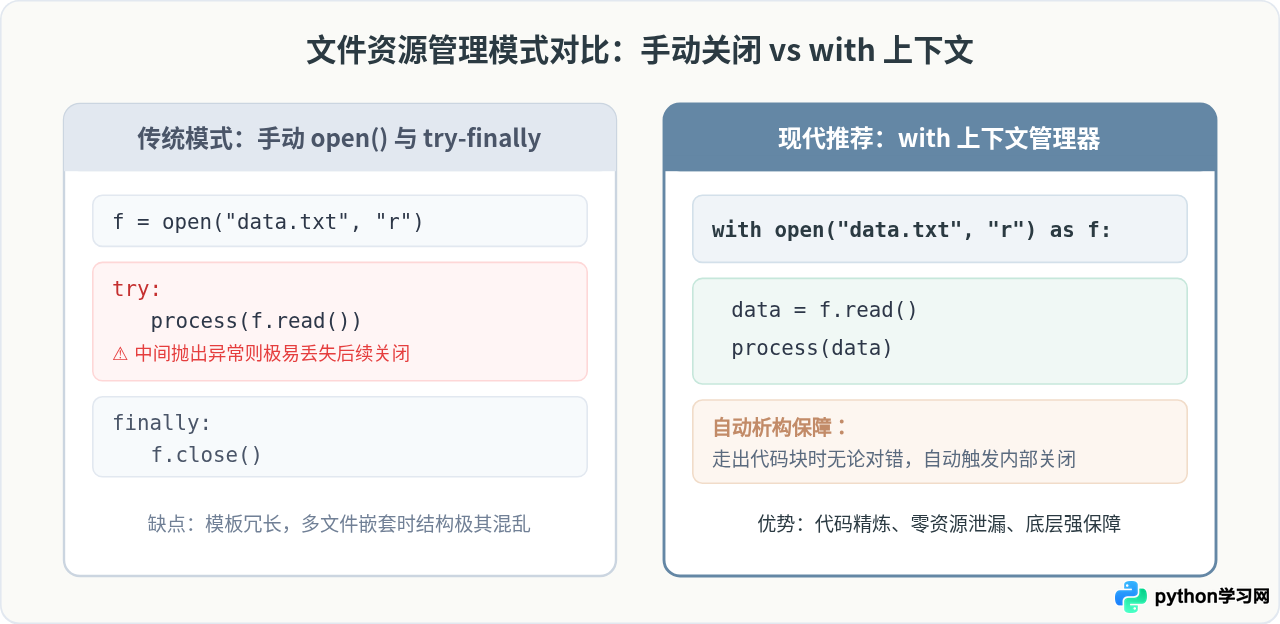
传统的写法往往依赖开发者手动调用 f.close()。然而在实际生产环境中,open() 之后的代码段充满不确定性:数据解析错误、网络中断、内存溢出甚至语法转换异常,都会导致执行流直接跳转至外层异常捕获处,使得处于后续位置的 close() 语句被直接跳过。尽管 Python 的垃圾回收机制(GC)会在对象引用计数归零时尝试关闭文件,但这属于延迟清理,不仅不可控,而且在循环、高并发或常驻服务中极易短时间内堆积未关闭的句柄,最终触发 OSError: [Errno 24] Too many open files 崩溃。
二、with 语句的底层运行协议解析
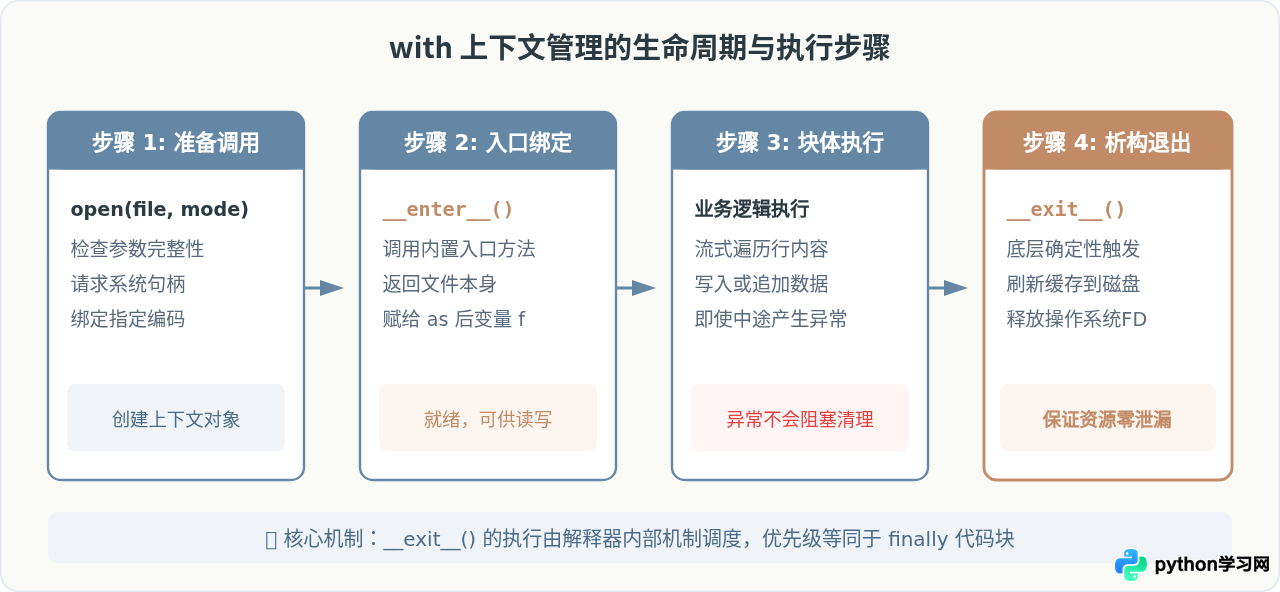
with 之所以安全,是因为它依托了 Python 语言核心的上下文管理协议(Context Management Protocol)。任何实现了 __enter__() 和 __exit__() 双下划线魔术方法的对象,均可作为上下文管理器配合 with 运行:
- 进入上下文:调用表达式
open(...)生成文件流包装对象,并触发其__enter__()方法。该方法返回文件句柄本身,并赋值给as后的变量。 - 执行代码体:执行缩进代码块中的读写业务操作。
- 离开上下文:当代码块正常结束、遇到
return、或者抛出任意未捕获异常时,解释器均会拦截该动作并无条件执行文件对象的__exit__(exc_type, exc_val, exc_tb)方法。 - 资源回收与异常传播:文件对象的
__exit__内部立即调用close()释放系统文件描述符。如果代码块发生异常,相关信息会传入__exit__;文件对象默认返回False,确保异常在释放完资源后继续向外传递,既不掩盖问题,又保证了文件被可靠关闭。
三、安全操作文件的四项核心实践规范
1. 永远显式指明字符编码 (encoding="utf-8")
在打开文本文件时,如果省略 encoding 参数,Python 将调用底层的 locale.getpreferredencoding(False) 来确定默认编码。这会导致典型的跨平台灾难:在 Linux 和 macOS 环境下默认通常为 UTF-8,但在中文 Windows 环境下往往默认为 GBK / CP936。代码在开发机运行正常,上线部署后却频频触发 UnicodeDecodeError。
# ❌ 错误示范:隐式依赖系统编码,跨环境极不稳定
with open("user_data.txt", "r") as f:
    content = f.read()

# ✅ 正确实践:始终显式声明编码(文本推荐 utf-8)
with open("user_data.txt", "r", encoding="utf-8") as f:
    content = f.read()
2. 严格限制 with 块作用域,及早释放句柄
很多开发者容易把数据处理、清洗甚至网络请求全部塞入 with 内部。这虽然不会报错,但会导致文件在执行耗时计算的整个过程中持续处于被占用状态,延迟了操作系统的垃圾回收与其他进程的访问。最佳实践是:with 只负责将数据读入或写入,计算逻辑移至外部。
# ❌ 不推荐:在 with 块内进行耗时重计算或网络调用
with open("raw_metrics.log", "r", encoding="utf-8") as f:
    raw_lines = f.readlines()
    time.sleep(10)  # 耗时操作期间文件句柄一直处于锁定占用状态
    result = complex_data_analytics(raw_lines)

# ✅ 推荐:取完数据即离开上下文,释放系统描述符
with open("raw_metrics.log", "r", encoding="utf-8") as f:
    raw_lines = f.readlines()

# 纯内存计算移至 with 代码块外部
result = complex_data_analytics(raw_lines)
3. 大文件坚持流式按行迭代,避免内存爆仓
使用 f.read() 或 f.readlines() 会将整个文件内容一次性读入物理内存。如果文件体积达到数 GB,将直接引发内存耗尽崩溃(OOM)。在 Python 中,文件句柄对象本身就是一个天然的生成器与迭代器,直接使用 for line in f 可以实现流式逐行解算,内存占用恒定维持在单个缓冲区级别。
# ✅ 处理大文件最佳范式:内存恒定且安全的惰性迭代
with open("large_server.log", "r", encoding="utf-8") as f:
    for line in f:
        if "ERROR" in line:
            save_error_record(line)
4. 复合多文件上下文与 Pathlib 现代写法
如果需要同时读取源文件并写入目标文件,不要编写多层令人困惑的嵌套 with,可直接在单行 with 语句中通过逗号分隔管理多个上下文。此外,面向对象的文件操作库 pathlib.Path 也原生支持通过 .open() 返回上下文管理器。
# ✅ 规范:单行优雅管理多文件输入输出
with open("source.csv", "r", encoding="utf-8") as f_in, \
     open("target.csv", "w", encoding="utf-8") as f_out:
    for line in f_in:
        f_out.write(line.upper())

# ✅ 规范:使用 pathlib 标准库
from pathlib import Path

data_path = Path("reports") / "summary.json"
with data_path.open("r", encoding="utf-8") as f:
    config = json.load(f)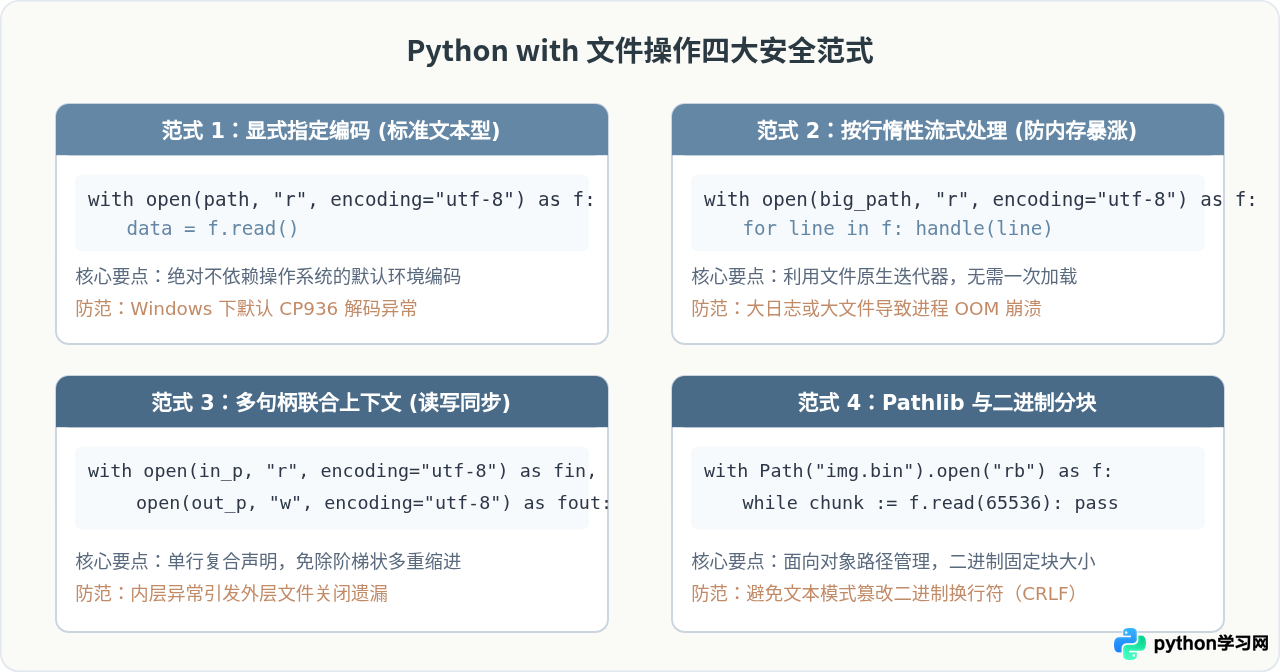
四、异常处理与健壮性保障
需要明确的是,with 语句保证的是“离开时必定关闭文件”,但并不负责捕获和吞没文件打开阶段的异常。例如,当目标路径不存在时,在执行 open() 的瞬间就会触发 FileNotFoundError,此时尚未成功进入上下文代码块,因此 with 不会阻断这个异常。
在编写工业级代码时,应当将 with 与精准的 try...except 结合使用:
import logging
from pathlib import Path

def safe_process_dataset(file_path: str) -> bool:
    target = Path(file_path)

    try:
        # with 确保只要成功打开,文件就必然被关闭
        with target.open("r", encoding="utf-8") as f:
            for line_no, line in enumerate(f, start=1):
                clean_record = line.strip()
                if not clean_record:
                    continue
                # 执行具体解析与持久化
                process_record(clean_record)
        return True

    except FileNotFoundError:
        logging.error("目标文件不存在: %s", file_path)
    except PermissionError:
        logging.error("无权限读取该文件: %s", file_path)
    except UnicodeDecodeError as err:
        logging.error("文件非 UTF-8 编码或数据损坏: %s, 详情: %s", file_path, err)
    except OSError as err:
        logging.error("遭遇底层 I/O 故障: %s", err)

return FalsePython 中
with 并不创建局部变量作用域。在 with 块结束后,变量名 f 仍然存在于当前函数或全局作用域中,但此时 f.closed 已经变为 True。千万不要在 with 块外部再次尝试调用 f.read(),否则会抛出 ValueError: I/O operation on closed file。
五、总结与最佳实践检查表
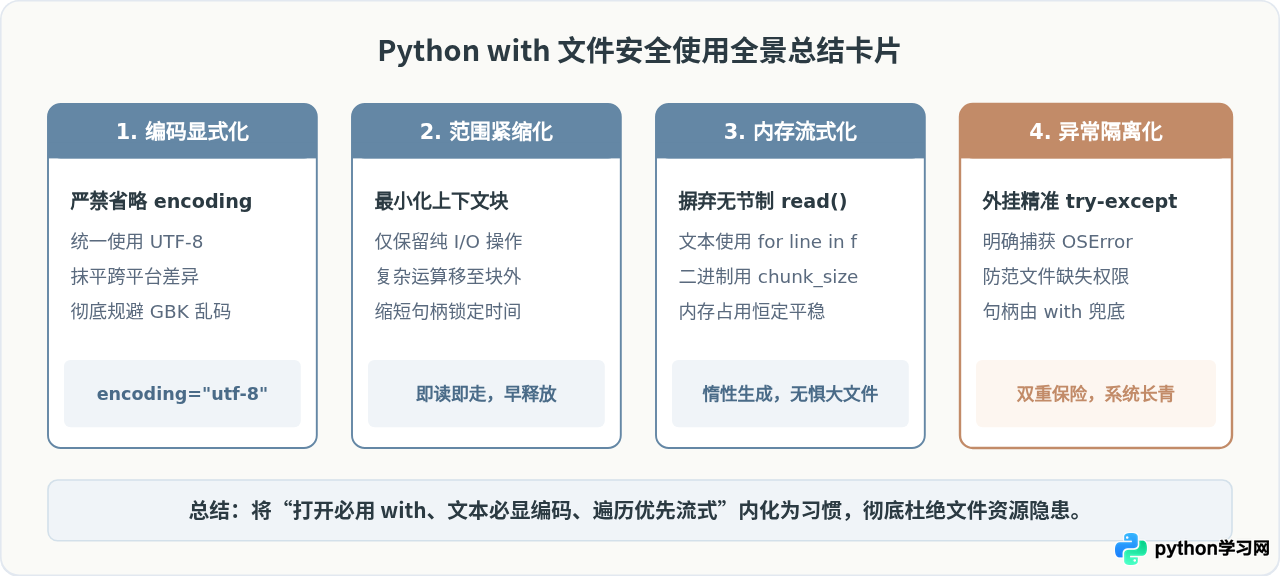
使用 with 语句管理文件是 Python 风格(Pythonic)代码的基本功,也是保障高可用常驻程序稳定性的核心手段。在日常编码与代码审查中,可以对照以下要点进行核验。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















