


面试题:Python3.14新增的zstd压缩模块对数据分析有何用?
深入解析Python 3.14通过PEP 784新增的内置compression.zstd压缩模块对数据分析的重大价值:对比传统Gzip与Snappy,详解非对称高解压吞吐率、零第三方C扩展依赖、海量数据流式处理与内存检查点最佳实践。
一、面试核心答题框架与核心结论
如果在技术面试中被问到这道题目,面试官考察的绝不仅是“Python 3.14 加了一个新包”这么简单,而是要观察你是否理解现代大数据与数据科学工作流的核心瓶颈,以及算法底层特性对工程架构的深远影响。
面对这个问题,可以用一句话给出直击本质的结论:
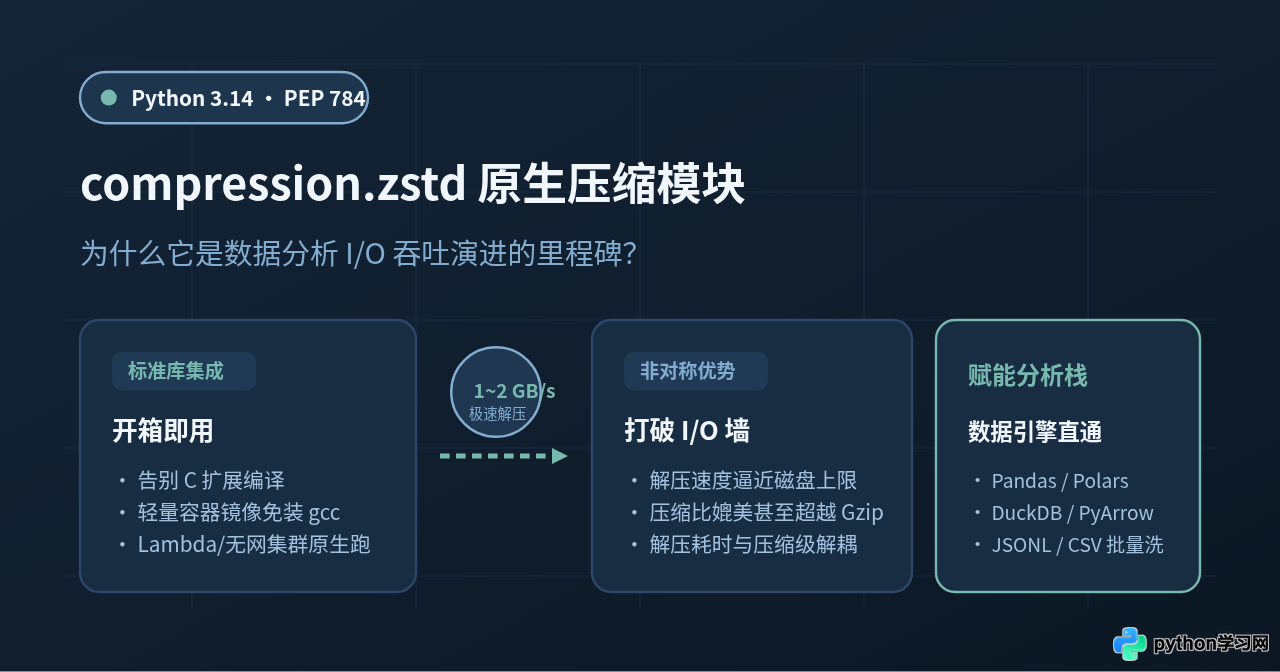
Python 3.14 通过 PEP 784 将 Meta 的 Zstandard 算法以标准库 compression.zstd 形式原生内置。对数据分析而言,它最根本的用处在于:在维持与 Gzip 相当的高压缩比前提下,提供了高达 1~2 GB/s 的极致解压缩吞吐,且无需编译安装任何第三方 C 扩展。这彻底打破了海量数据在读取和加载阶段的“CPU 解压瓶颈”,同时终结了轻量容器与无网计算集群中依赖构建繁重的痛点。
回答时,可将分析价值归纳为三项硬核支柱:
- 解压速度非对称飞跃:单核 1~2 GB/s 的解压缩速率,让批量处理 CSV、JSONL、中间分块及持久化数据时能够跑满 NVMe 固态硬盘与 10Gbps 网卡,不再受限于单核 CPU。
- 无外部编译依赖(Batteries-Included):彻底免除
pip install zstandard在 Alpine、Distroless 等极简 Docker 镜像或受限生产内网集群中需安装 GCC/Rust 工具链的摩擦。 - 与 Python 核心及分析生态深层联动:标准库
tarfile、zipfile、shutil现已原生支持 Zstd;配合 Pandas、Polars、PyArrow 和 DuckDB,构建端到端零多余依赖的数据传输闭环。
二、传统数据分析的痛点与架构演进
要讲清楚“有何用”,先要还原没有内置 zstd 时数据团队所面临的现实困境。假设你的数据平台每天需要处理上百吉字节(GB)的日志流或业务明细,为了节省昂贵的对象存储(S3/OSS)费用和网络带宽,压缩是必选操作。
在 Python 3.14 之前,数据团队通常面临“两难抉择”:
- 采用标准库自带的 Gzip / Bzip2:空间虽然省下来了,但解压极慢(Gzip 单核通常仅 200~300 MB/s)。往往整个 Pandas 批处理任务中,有超过 60% 的 CPU 时钟周期白白消耗在
gzip.decompress上,导致多核并行读取时的严重资源空耗。 - 采用第三方 Zstd 扩展(如
zstandard或pyzstd):性能虽然卓越,但作为 C 扩展库,在云原生无服务器(AWS Lambda / Google Cloud Run)、离线内网集群或异构架构(ARM64/x86_64)中构建时,频繁遭遇编译缺失、glibc 版本不匹配或镜像体积膨胀数十兆的问题。
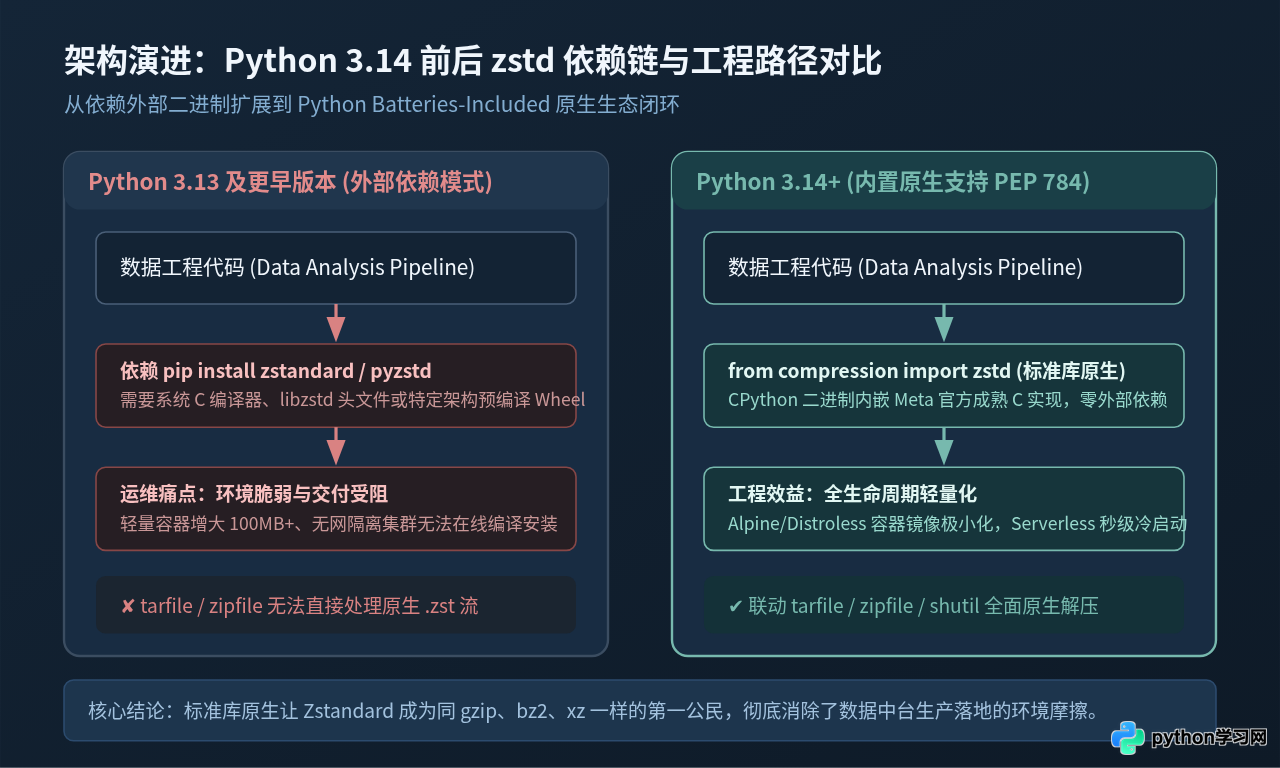
Python 3.14 规范了压缩生态,引入了全新的 compression 命名空间,下设 compression.zstd,并重新梳理了 compression.gzip、compression.bz2 等模块。这意味着无需额外引入第三方依赖,便能直接享受到高性能压缩的基础设施红利。
三、算法特性对比:为什么 Zstd 是数据分析的“帕累托最优”?
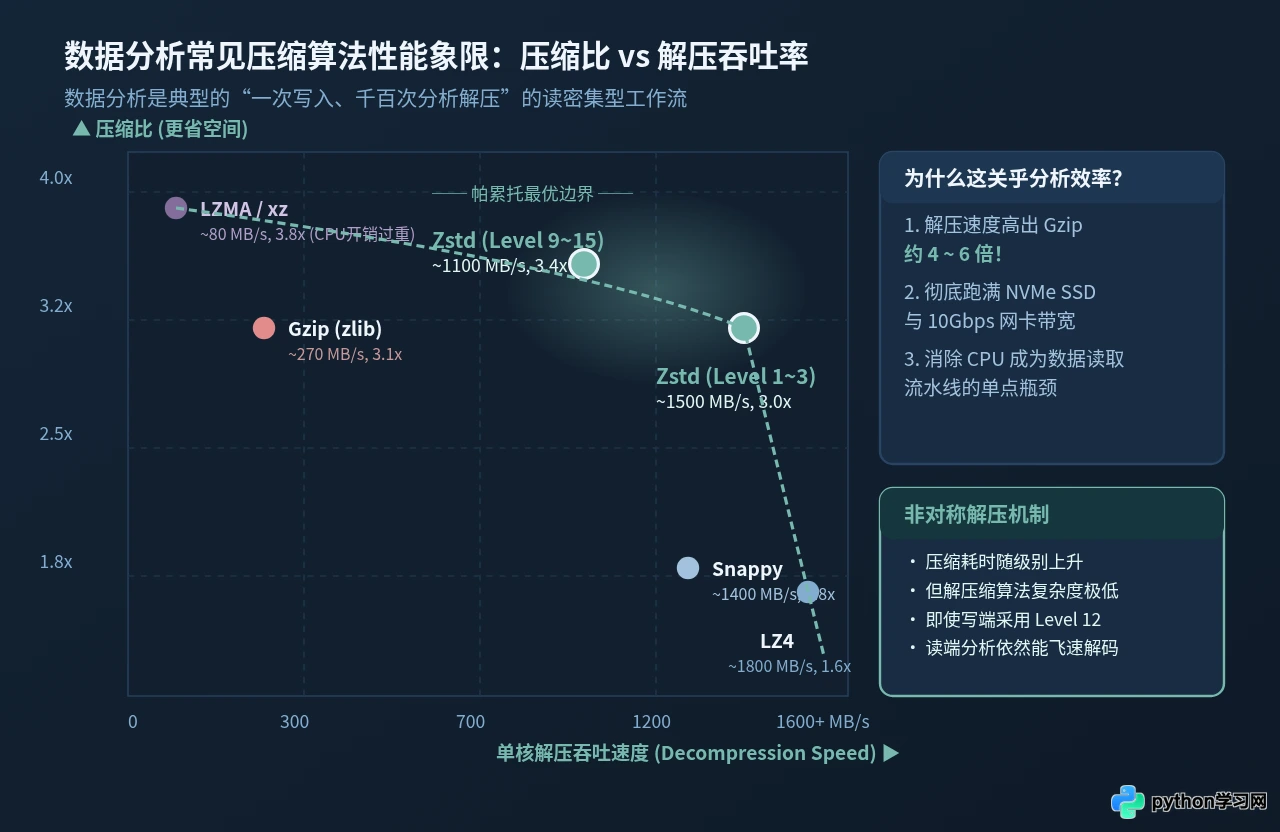
在计算机存储与传输中,压缩算法一直在寻找“压缩比”与“计算吞吐量”的平衡点。数据分析工作流有着极其显著的业务特征:数据往往在离线或批处理时只被写入压缩一次,但在后续的探索性分析(EDA)、特征工程、模型训练中会被反复解压读取成百上千次。
Zstandard 专为现代硬件设计,具备颠覆性的非对称解压特性:
| 算法 | 标准库支持情况 | 解压吞吐率 (单核) | 压缩比 (典型文本/日志) | 在数据分析中的定位与局限 |
|---|---|---|---|---|
| Zstandard (zstd) | Python 3.14 原生内置 | 1100 ~ 1600+ MB/s | 3.0x ~ 3.4x | 生产黄金标准:解压极快,存储占用小,彻底消除 I/O 墙。 |
| Gzip (zlib) | 传统标准库内置 | 200 ~ 300 MB/s | 2.8x ~ 3.1x | 历史包袱:生态兼容性极强,但解压严重消耗 CPU,吞吐低。 |
| Snappy | 需三方库 (python-snappy) | 1200 ~ 1500 MB/s | 1.7x ~ 2.0x | 吞吐优先:解压极快但压缩比较差,网络和存储开销偏大。 |
| LZMA / xz | 标准库内置 | 50 ~ 100 MB/s | 3.5x ~ 3.9x | 极度冷存:极限压缩,但解压算力开销过大,不适合在线分析。 |
从上表可见,Zstd 构成了性能的帕累托前沿(Pareto Frontier)。即使写端为了兼顾磁盘成本选用了较高的压缩级别(例如 Level 9),读端在进行数据消费时的解码算法复杂度依然极低,解码速率几乎不发生明显劣化。这就是对数据分析吞吐的最关键赋能。
四、实战代码:在数据管道中应用内置 zstd
Python 3.14 的 compression.zstd 遵循了标准库 open() 协议与流式缓冲区规范。以下列出数据工程师最关心的三个落地场景。
场景 1:海量半结构化数据 (JSONL/CSV) 的流式读写
在清洗千万级日志或特征文件时,内存无法一次性载入未压缩的大文件。利用 zstd.open 可以像操作普通文本文件一样实现行级生成器读取与流式分块写入:
# 环境要求:Python 3.14+
from compression import zstd
import json

# 1. 流式压缩写入(无需一次性加载,内存占用恒定)
output_path = "analytics_events.jsonl.zst"
with zstd.open(output_path, mode="wt", encoding="utf-8", level=3) as f:
    for event_id in range(1_000_000):
        record = {"id": event_id, "status": "active", "metric": event_id * 0.15}
        f.write(json.dumps(record) + "\n")

# 2. 流式高速解压读取
with zstd.open(output_path, mode="rt", encoding="utf-8") as f:
    for line in f:
        data = json.loads(line)
        if data["id"] >= 5:
            break
print("流式读写验证完成,内存消耗维持在几MB内。")
场景 2:内存中间检查点 (Checkpoints) 快速序列化
在复杂的数据探索或多步转换中,我们常需要把中间计算得到的庞大 Python 字典、NumPy 数组或中间特征保存到缓存。使用 zstd.compress() 配合 pickle 能在毫秒级内完成压缩与解压:
import pickle
from compression import zstd

# 假设存在大体量中间计算结果
large_feature_dict = {f"feat_{i}": [i * 1.1] * 200 for i in range(50_000)}

# 序列化并使用 zstd 原生高速压缩 (level=1 保证极致吞吐)
raw_bytes = pickle.dumps(large_feature_dict)
compressed_bytes = zstd.compress(raw_bytes, level=1)

print(f"原始字节: {len(raw_bytes) / 1024 / 1024:.2f} MB")
print(f"压缩后字节: {len(compressed_bytes) / 1024 / 1024:.2f} MB")

# 反序列化还原
restored_dict = pickle.loads(zstd.decompress(compressed_bytes))
assert len(restored_dict) == 50_000
场景 3:与 Pandas / Polars 等分析引擎无缝对接
由于 compression.zstd.open 返回兼容 Python io.BufferedIOBase 的流对象,下游分析库可以直接通过文件流载入:
import pandas as pd
from compression import zstd

# 直接将压缩流传给 Pandas,享受标准库原生的稳定吞吐
with zstd.open("analytics_events.jsonl.zst", mode="rt", encoding="utf-8") as stream:
    df = pd.read_json(stream, lines=True)

print(f"成功载入 DataFrame,数据形态: {df.shape}")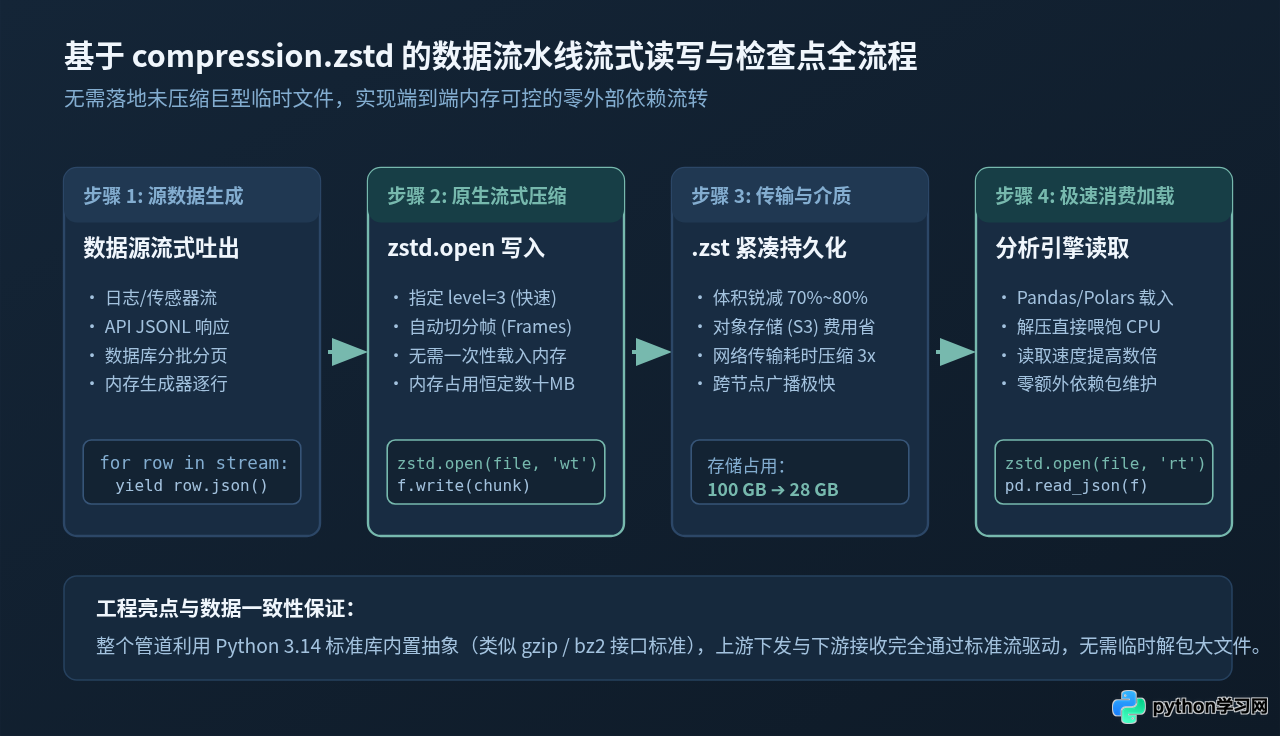
五、工程落地的边界条件与注意事项
在面试或架构评审中,给出完美的赞美往往只能拿及格分,指出边界、局限与踩坑点才能展现真正的资深工程素养:
- 压缩级别选择陷阱:Zstd 支持从 1 到 22 的压缩级别。在实时或准实时数据分析流中,切忌盲目设置 level > 9。Level 1~3 即可获得超过 70% 的体积削减,且拥有数倍于 Gzip 的压缩速度;若设置超过 19,压缩时间将呈指数级飙升,极易导致写入端线程阻塞。
- 内存与窗口缓冲区:高级别压缩需要较大的滑动窗口(Window Log),在资源极其受限的微型容器(例如内存上限 256MB 的 Worker)中如果盲目开启极高压缩级,可能会因为内存缓冲区分配过大引发 OOM(Out Of Memory)。
- 列式存储(Parquet / ORC)与 Zstd 的分工:对于结构化表格数据,Parquet 本身是列式存储,并广泛内置了针对各列 Page 的 Zstd 压缩。此时通常由 Parquet 引擎(如 Arrow / DuckDB)内部执行,Python 3.14 的内置模块主要解决外部文本数据源(CSV/JSONL)、日志归档流、网络中间件及跨进程通信传输的原生接入。
- 平滑跨版本兼容方案:如果项目处于从 Python 3.11/3.12 向 3.14 迁移的过渡期,建议在工具层编写自适应回退代码:
# 跨版本平滑适配代码示例
try:
    from compression import zstd  # Python 3.14+ 原生标准库
except ImportError:
    try:
        import zstandard as zstd  # 历史版本回退第三方库
    except ImportError:
        import pyzstd as zstd
六、选型决策指南与面试高分回答总结
为了在面试结束前给出清晰明了的架构总结,可以通过下方决策树梳理技术选型逻辑:
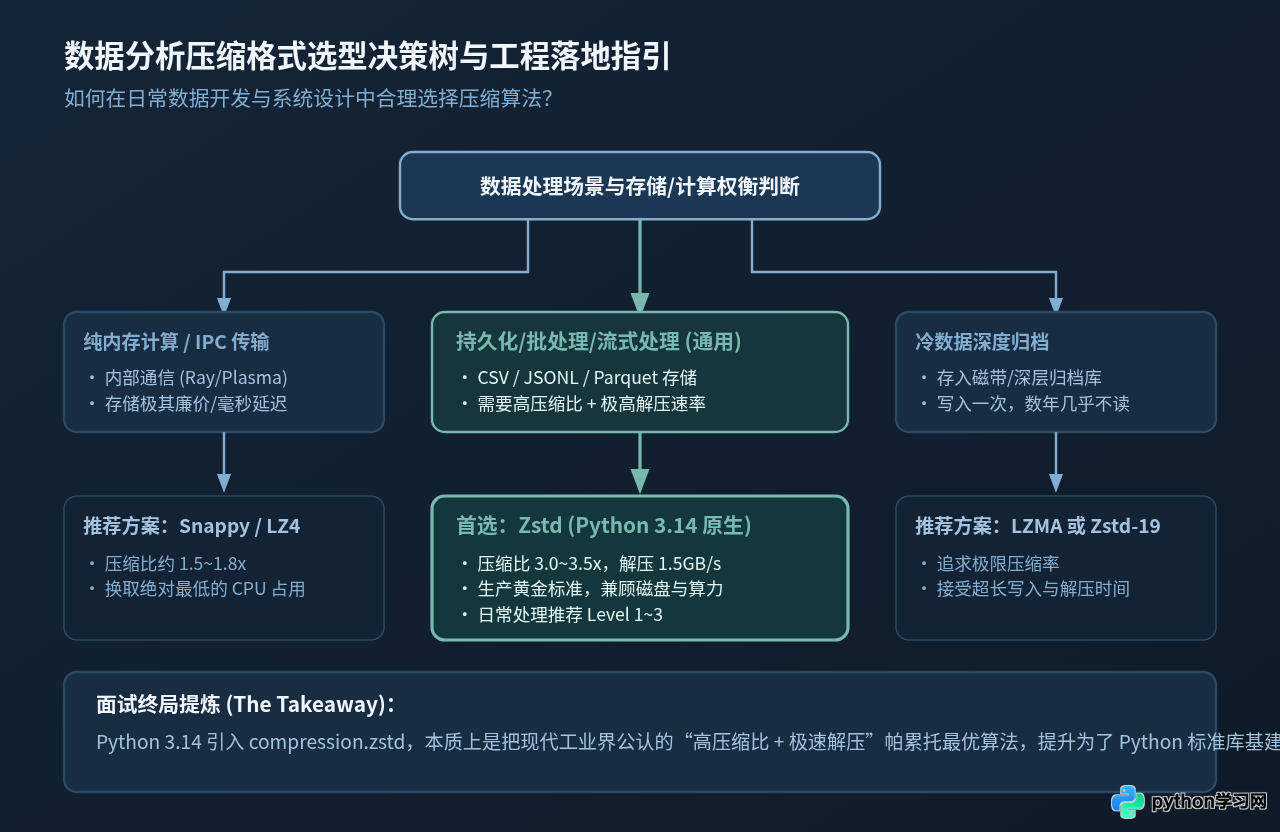
当被问及“Python 3.14 新增的 zstd 压缩模块对数据分析有何用”时,可以这样总结收尾:
“Zstd 是目前工业界最具实用价值的通用压缩算法。Python 3.14 将其作为标准库 compression.zstd 内置,最大收益是消除了数据工程中高吞吐解压与零环境依赖之间的矛盾。在数据清洗、中间检查点落盘和海量半结构化文本分析中,它凭借 1~2 GB/s 的单核解压速度彻底打破了 Gzip 造成的 CPU 瓶颈;同时在容器化与无服务器部署中摆脱了第三方 C 编译的桎梏,让高性能数据管道真正做到了开箱即用。”
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















