


Python爬虫数据分析课程设计报告:数据清洗与可视化结果描述写法
详细讲解Python爬虫与数据分析课程设计报告中数据清洗过程记录与可视化图表结果描述的标准写作结构、规范表述逻辑与实用模板。
撰写Python爬虫与数据分析课程设计报告时,许多学生的代码能够顺利运行并生成精美的图表,但在撰写正文中的“数据清洗”和“可视化结果分析”两个章节时常常失分严重。最常见的硬伤是:数据清洗部分仅机械张贴几行代码而不说明清洗依据与前后对比;可视化部分仅做简单的数字复述,缺乏深度的数据特征提取与业务洞察。本文提供一套符合课程设计答辩与评审标准的写作规范、推导逻辑、模板句式及前后对比范例,帮助读者规范组织报告内容。
一、数据清洗章节的标准结构与撰写规范
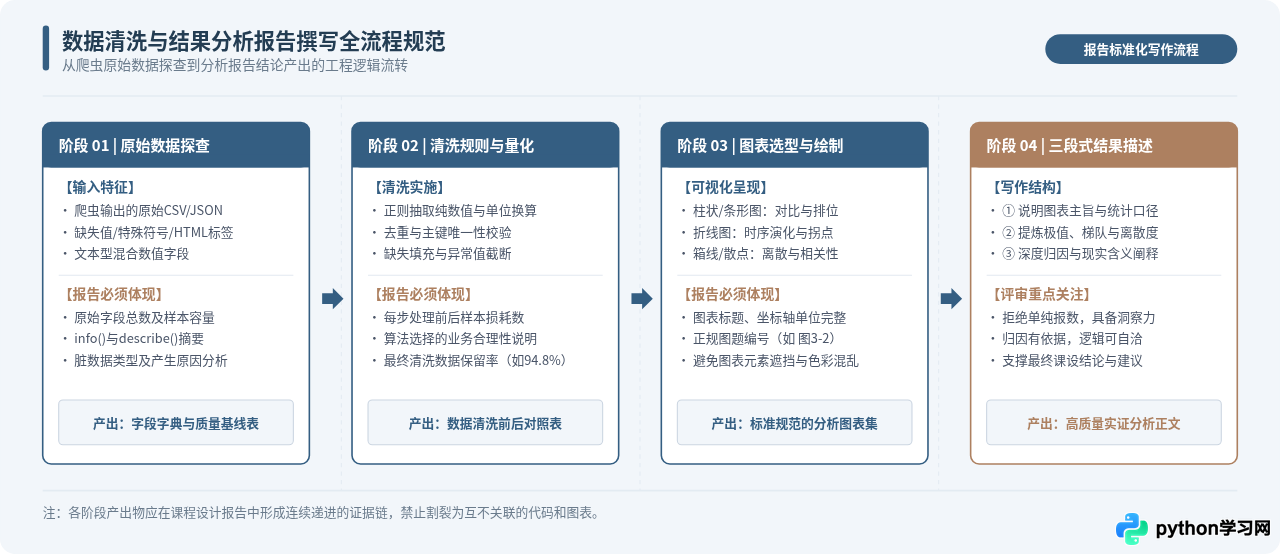
数据清洗是展现工程严谨性的核心章节。很多学生在此章节仅仅粘贴 df.dropna() 和 df.drop_duplicates() 代码,导致评审老师无法判断原始数据存在哪些缺陷、处理方案是否合理。一个完整的清洗小节必须回答四个核心问题:发现了什么脏数据、采用了什么规则、为什么采用该规则,以及处理前后数据的量化对比。
1. 脏数据类型与清洗依据描述
在描述数据清洗时,需要先对爬虫采集到的数据概貌进行客观陈述。说明爬取的初始条数、字段数量,并针对关键字段存在的格式问题、缺失情况进行分类汇报:
- 文本中的非数值污染:爬取薪资、价格、销量等字段时,页面通常包含“元/月”、“万”、“k”、“已售1000+”等单位或汉字。报告中应阐明如何通过正则表达式提取纯数值,并说明数值单位归一化的基准(例如统一折算为“千元/月”或“元”)。
- 缺失值(Missing Values)的处理依据:不能一概删除。若核心主键(如商品ID、招聘职位名)缺失,属于无效爬取,予以直接删除;若辅助字段(如评价数、公司规模)缺失,需根据缺失比例选择填充方式(如数值型用中位数/均值填充,类别型标记为“未透露”),并在报告中明确说明“由于该字段缺失率小于5%,采用中位数填充以保留整体样本容量”。
- 重复数据的判重逻辑:指出使用哪些字段作为联合唯一键进行去重。例如招聘数据不能仅依靠“岗位名称”去重,而应依靠“公司名称 + 岗位名称 + 发布城市 + 发布日期”构建联合索引。
- 物理异常值(Outliers)的界定与处理:明确说明采用什么数学准则或业务准则判定异常。例如采用四分位距法(IQR法),将超过
Q3 + 1.5 * IQR或低于Q1 - 1.5 * IQR的极端值识别为异常,并解释是直接截断、作为独立分组还是剔除。
2. 清洗前后量化统计表的标准写法
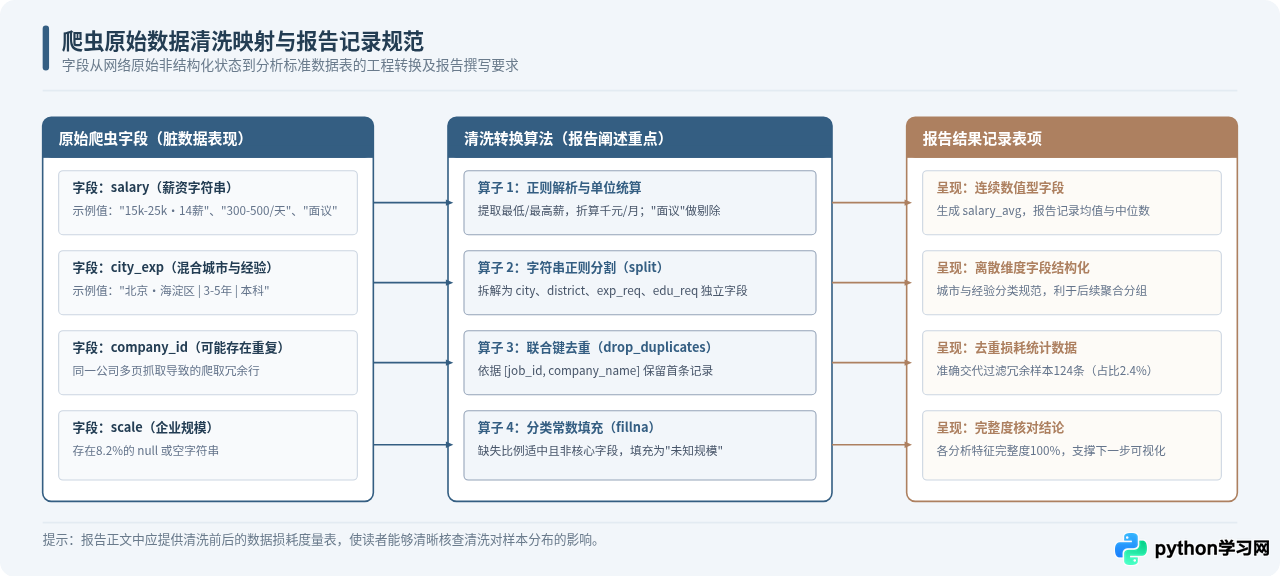
为了让读者一目了然地看到数据清洗的效果,报告正文中必须包含一张“数据清洗前后统计对比表”。该表能够客观展示每个步骤对样本规模的影响:
| 处理阶段 | 操作描述与处理规则 | 处理后剩余记录数 | 损耗数量 / 占比 | 数据留存率 |
|---|---|---|---|---|
| 原始爬取数据集 | 完成全部页面爬取,保存原始CSV文件 | 5,200 | - | 100.00% |
| 去重处理(去冗余) | 基于 [job_id, company_name] 联合主键判重 | 5,076 | -124 (2.38%) | 97.62% |
| 无效与缺失值过滤 | 剔除薪资标注为“面议”及核心字段为空的记录 | 4,912 | -164 (3.15%) | 94.46% |
| 正则清洗与单位折算 | 解析“k/月”、“元/天”,统一换算为千元/月 | 4,912 | 0 (0.00%) | 94.46% |
| IQR异常值截断过滤 | 剔除月薪高于80k或低于2k的极端离群点 | 4,865 | -47 (0.90%) | 93.56% |
| 最终分析就绪数据集 | 各特征无缺失,格式统一,样本准备就绪 | 4,865 | 累计剔除 335 条 | 93.56% |
配合上述表格,在正文中应加入总结性段落:
报告范例段落:“本次课程设计原始采集样本共计 5,200 条。经基于联合主键的去重处理,过滤爬虫重复抓取数据 124 条;随后针对核心指标字段进行有效性检查,剔除薪资标注为‘面议’等无法量化的记录 164 条;利用箱线图IQR准则识别出极端录入偏差样本 47 条。最终用于后续统计建模与可视化分析的有效样本为 4,865 条,有效样本留存率为 93.56%,样本整体代表性良好,符合实证分析要求。”
二、可视化结果描述的“三段式”递进写法
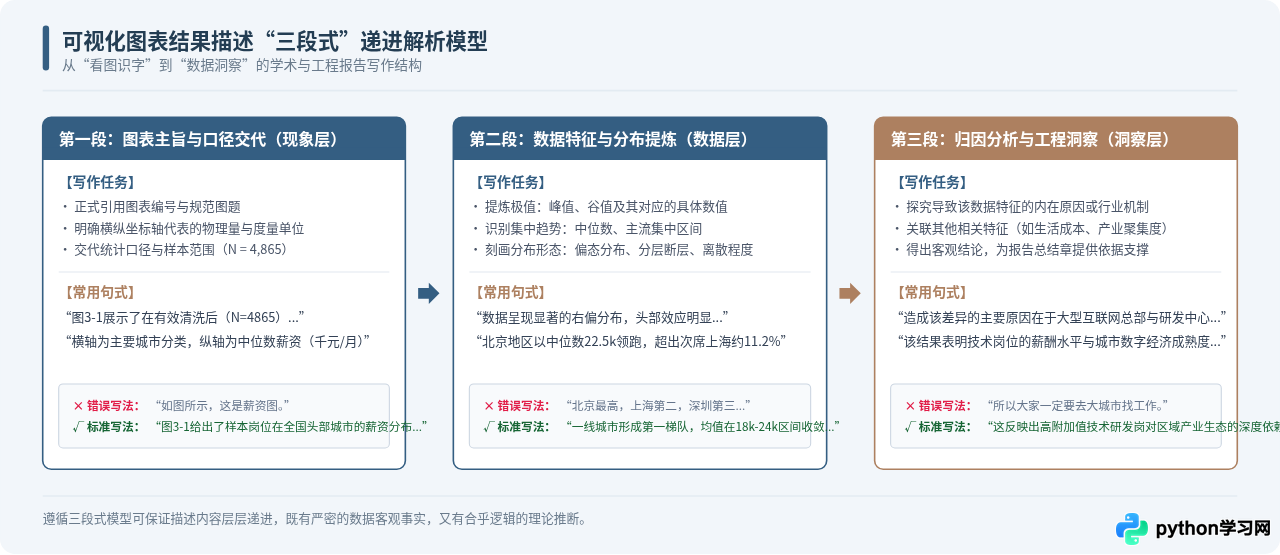
许多学生在撰写可视化章节时,面对画好的图表,往往只写一两句话:“如图3-1所示,北京的岗位最多,上海第二,西藏最少。”这种描述仅停留在识图层面,没有任何专业价值。学术与工程课程设计报告要求可视化描述具备“现象描述 → 特征提取 → 归因洞察”三段式递进结构。
1. 常见图表类型的针对性描述模板
不同类型的统计图表承担着不同的信息表达任务,描述时的侧重点也截然不同:
(1)柱状图 / 条形图(强调分类对比与梯队划分)
核心侧重:排序位置、梯队断层、极差倍数以及占比累计。
参考模板:“图X展示了各类别在[核心指标]上的分布对比情况。从数据分布来看,[类别A]以[具体数值]位居榜首,较第二名[类别B]([数值])高出约[百分比]%,前三名累计贡献了全样本[百分比]%的体量,头部集中效应显著。相比之下,后五名类别平均仅为[数值],反映出该领域内部存在明显的资源分化与梯队壁垒。”
(2)折线图(强调时间序列演化与转折点)
核心侧重:长期趋势、周期性波动、关键拐点(跳跃/骤降)及波动幅度。
参考模板:“图X刻画了[时间跨度]期间[指标名]的动态演变轨迹。整体走势呈现出[平稳增长/震荡下行/先增后减]的形态。在[特定时间节点]出现明显拐点,指标值由[数值A]迅速跳升至[数值B],月环比增幅达到[百分比]%。这一结构性突变主要受[政策出台/特定促销/业务上线]的阶段性外生冲击所驱动;随后进入平稳过渡期,回归至均值基线附近。”
(3)箱线图(强调分布离散度与偏态特征)
核心侧重:中位数(而非均值)、四分位距(IQR)、分布对称性及离群点。
参考模板:“图X采用箱线图对比了不同[分组维度]下的[数值指标]离散特征。各组中位数分别为[数值1]、[数值2];其中[组别A]的箱体高度(IQR)显著窄于[组别B],说明该组内部离散程度较低,数据一致性更高。此外,[组别C]的上方存在多处明显的上离群点,最大值达到[数值],拉动了整体算术均值,因此在衡量该群体典型水平时,中位数较均值更具稳健性。”
(4)散点图 / 气泡图(强调相关性与聚类模式)
核心侧重:相关方向(正相关/负相关)、相关强度、离群簇及聚集模式。
参考模板:“图X给出了[变量X]与[变量Y]之间的二维散点分布情况。散点整体呈现出沿[右上/右下]方向倾斜的带状分布,皮尔逊相关系数为 r = [数值](p < 0.01),表明两变量之间存在统计学意义上的显著[正/负]相关关系。大部分样本聚集在[X区间, Y区间]的核心簇内;右上角的少数离群高值样本则属于兼具[高X与高Y]特征的特异主体。”
三、报告写作注意事项与自查规范
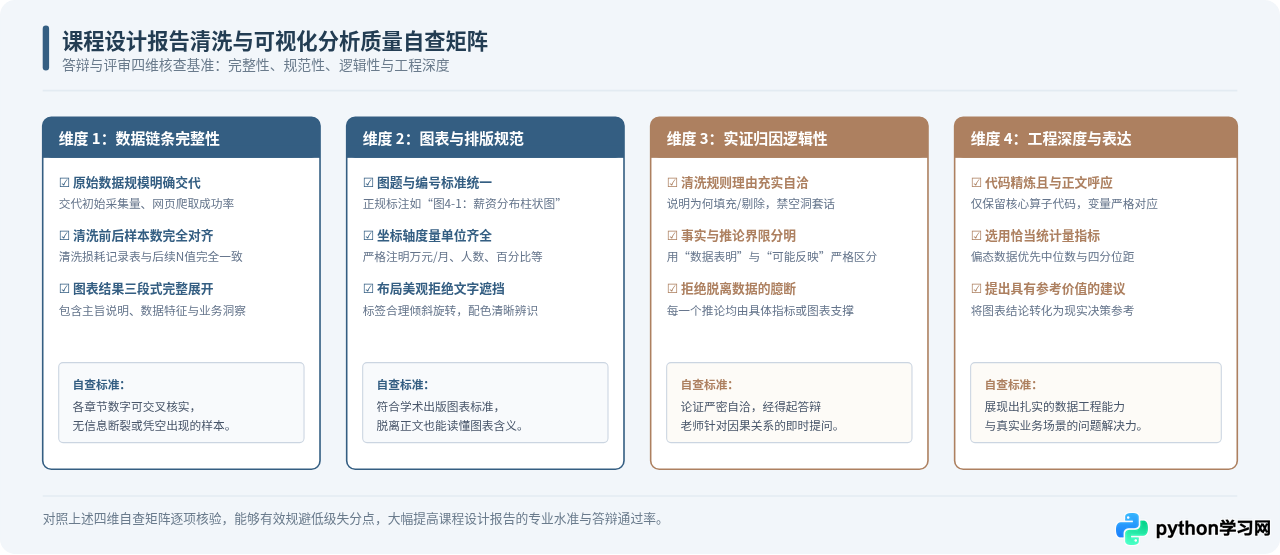
完成正文编写后,需要对全文进行一致性核对与质量排查。以下四项是最容易在答辩中被指导老师指出的典型问题:
- 样本总量前后矛盾:必须保证清洗后的最终样本数与后续所有可视化图表中的样本数(N)完全吻合。若在清洗小节声称清洗后剩余 4,865 条数据,而后续某个条形图分组求和得出的样本总数却是 5,200 或 4,600,会被直接判定为数据造假或前后脱节。
- 坐标轴与单位缺失:所有嵌入报告的图表必须包含完整的图题、坐标轴名称、物理单位(如 元、人、百分比)及图例说明。图表内文字必须清晰可辨,避免缩略过小或遮挡。
- 主观猜测冒充实证结论:在进行第三段“归因分析”时,必须严格区分“数据明确呈现的事实”与“基于常识的合理推测”。对推测性内容应使用“可能源于”、“一定程度上反映出”等严谨词汇,禁止在缺乏外生数据支撑的情况下做出绝对化的因果断言。
- 代码与正文脱节:正文中贴出的代码段应只保留关键清洗与处理逻辑(5至15行核心代码),禁止全文粘贴上百行原始爬虫脚本。代码变量名、函数名应与文字描述中的字段名严格一致。
四、总结
在Python爬虫与数据分析课程设计报告中,数据清洗与可视化结果描述是串联“数据获取”与“最终结论”的桥梁。掌握“清洗问题分析-处理算法说明-损耗量化对照”的清洗编写流程,配合“图表主旨口径-数据特征提炼-业务洞察归因”的三段式图表描述方法,能够让整篇报告逻辑严密、证据扎实、主次分明,从而在课程考核与答辩中获得理想的成绩。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















