


Python列表按值删除元素:remove用法及ValueError处理

详细讲解Python列表中使用remove方法按值删除元素的操作机制、只删除首个匹配项的特点、触发ValueError的原因以及通过try-except与条件判断进行安全防护的实用方案。
假设你正在维护一个在线考试系统的提交队列,用户完成答卷后需要从等待列表中移除其学号。你直接调用了 wait_list.remove(student_id),在前几十次测试中一切顺利,却在某次用户重复点击提交时,后台进程突然崩溃并抛出了 ValueError: list.remove(x): x not in list。在 Python 编程中,按具体内容(值)而非索引位置删除列表项是一项极常见的操作,内置的 list.remove() 正是为此而生;然而,它不仅具有“仅移除首个匹配项”的原地修改特性,更会在目标不存在时抛出运行时异常。本文将具体剖析 remove() 的底层行为、演示防御 ValueError 的两种工程方案,并讲解批量删除重复值的正确做法。
一、remove 方法的基本用法与内部执行机制
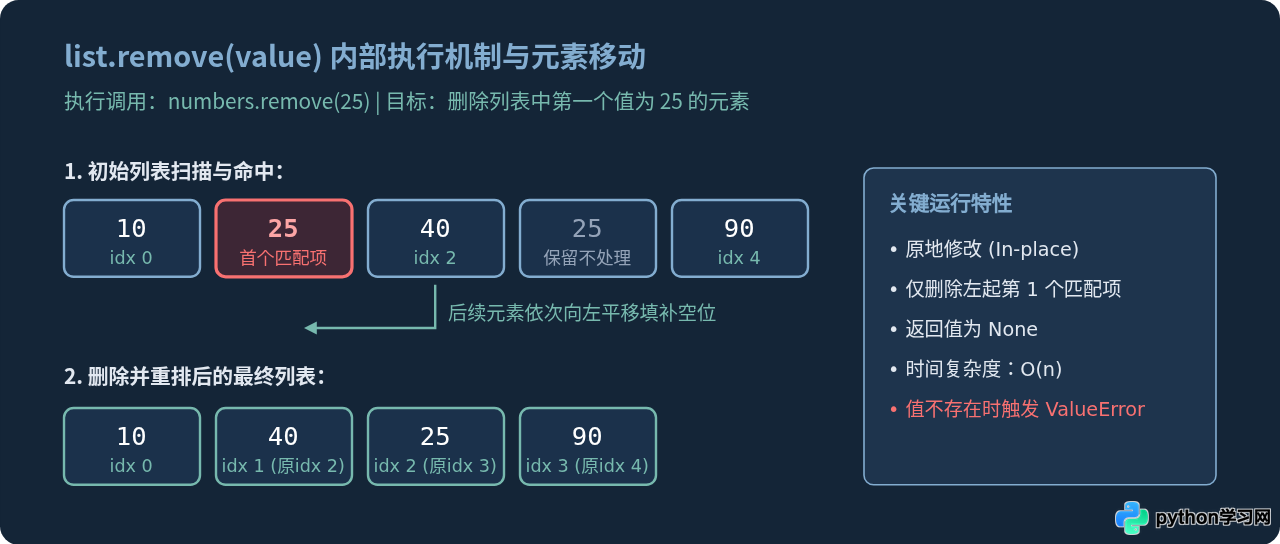
Python 列表对象的 remove() 方法接受一个参数,用于在列表中搜索与该参数值相等的第一个元素,并直接在原列表上将其删除。该方法属于“就地修改(In-Place)”,其返回值为 None。
# 基础用法示例
fruits = ["apple", "banana", "cherry", "banana", "date"]
result = fruits.remove("banana")

print("删除后的列表:", fruits)
print("remove返回值:", result)remove返回值: None
从输出结果中可以观察到两个核心细节:
- 仅删除首个匹配项:列表中包含两个
"banana",但remove("banana")只删除了索引为 1 的首个香蕉,索引为 3 的香蕉仍然保留在列表中。 - 没有直接返回被删项:
result的值为None。如果你需要获取被删除的具体对象,应考虑使用pop()。
在底层实现中,Python 列表是基于动态连续数组构建的。当调用 remove(value) 时,解释器会从索引 0 开始向后线性扫描,直到找到第一个与 value 相等的元素。删除该元素后,为了保持连续数组的紧凑性,其右侧的所有元素都必须逐一向前移动一位。这意味着 remove() 操作的最坏时间复杂度为 \(O(n)\)。
二、理解 ValueError 的触发根源
当我们要删除的值根本不存在于列表中时,Python 不会静默忽略,也不会返回布尔值 False,而是立即中断当前执行流程并抛出 ValueError 异常:
languages = ["Python", "Go", "Rust"]
languages.remove("Java") # 列表中不存在 "Java"File "demo.py", line 2, in <module>
languages.remove("Java")
ValueError: list.remove(x): x not in list
这一设计遵循了 Python 的哲学原则——“错误不应悄无声息地被传递”(Errors should never pass silently)。向列表发出“移除某元素”的指令本质上是一种断言预期;如果该元素不存在,说明调用方的状态认知可能已经失真。因此,在不加防御的代码中直接调用 remove() 是潜在的服务崩溃隐患。
三、处理 ValueError 的两种工程方案
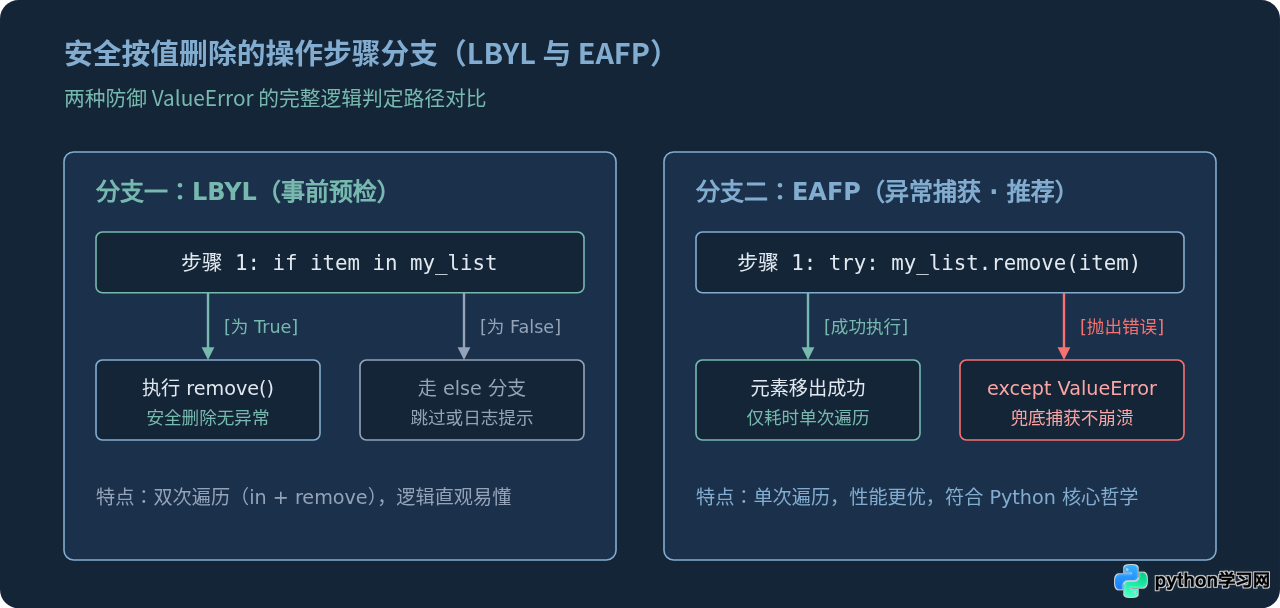
在实际工程中,根据编程范式与具体业务场景的不同,主要有两种处理 ValueError 的稳健方式:LBYL(事先检查) 与 EAFP(事后捕获)。
方案 1:事前检查元素是否存在(LBYL 风格)
LBYL 即“三思而后行”(Look Before You Leap)。在执行 remove() 之前,先使用成员运算符 in 确认目标值是否在列表中。
user_tags = ["developer", "subscriber", "vip"]
target_tag = "moderator"

if target_tag in user_tags:
    user_tags.remove(target_tag)
    print(f"已成功移除标签: {target_tag}")
else:
    print(f"未找到标签 {target_tag},跳过删除操作")
适用场景与利弊分析:
- 优点:逻辑直观、易读,非常适合初学者,控制流分支一目了然。
- 局限性:执行
target_tag in user_tags时需要遍历列表(\(O(n)\)),如果存在,随后的user_tags.remove(target_tag)又需要从头扫描并平移元素(\(O(n)\))。这意味着进行了两次完整遍历。另外,如果列表在多线程环境下被共享修改,in检查为真后可能瞬间被其他线程移除,依然可能导致竞争异常。
方案 2:使用 try-except 异常处理(EAFP 风格)
EAFP 即“求原谅比求许可容易”(Easier to Ask for Forgiveness than Permission),这是 Python 官方强烈推崇的核心设计哲学。直接尝试执行删除,若发生 ValueError 则在 except 代码块中妥善兜底。
user_tags = ["developer", "subscriber", "vip"]
target_tag = "moderator"

try:
    user_tags.remove(target_tag)
    print(f"已成功移除标签: {target_tag}")
except ValueError:
    # 捕获并处理异常,保证程序稳定向下运行
    print(f"捕获异常:标签 {target_tag} 不在列表中,已安全跳过")
适用场景与利弊分析:
- 优点:性能更高。在绝大多数情况下目标元素都存在时,只进行一次线性扫描即可完成删除,避免了
in带来的二次开销。此外,代码原子性更好,能够天然抵御轻微的竞态条件。 - 使用建议:如果“元素大概率存在,缺失属于边缘小概率情况”,优先采用
try-except;如果“元素大概率不存在,删除属于可选动作”,两者均可,但try-except依然是地道的 Pythonic 写法。
四、进阶场景:如何删除列表中所有相同的元素
前文强调过,remove() 一次仅删除一个元素。如果列表中存在多个相同的值,该如何彻底清除?初学者经常会陷入以下陷阱:
1. 常见陷阱:边用 for 循环遍历边执行 remove
切勿在直接遍历列表的同时调用 remove(),这会导致迭代器内部游标与列表索引错位,漏删紧邻的元素:
# 错误示例:漏删现象
scores = [10, 0, 0, 20, 30]
for s in scores:
    if s == 0:
        scores.remove(s)

print("错误遍历后的结果:", scores) # 仍然残留一个 0!原因在于:当第一个 0 被删除后,第二个 0 的索引立刻从 2 变成了 1,而 for 循环下一步直接访问索引 2(此时已经是 20),导致第二个 0 被直接跳过。
2. 循环结合 remove 的写法(及其性能瓶颈)
一种直接的修正方案是配合 while 循环:
scores = [10, 0, 0, 20, 30]
while 0 in scores:
    scores.remove(0)

print("while循环删除后:", scores)0 in scores 耗时 \(O(n)\),紧接着 scores.remove(0) 又耗时 \(O(n)\),综合时间复杂度高达 \(O(k \times n)\)。当列表数据量达到数万级且重复值较多时,该方法运行速度会急剧下降。
3. 高效且地道的替代方案:列表推导式或切片赋值
删除所有特定值的最佳实践是反向思考——“过滤保留所有不等于该值的元素”。列表推导式只需单次扫描(\(O(n)\)),底层由 C 语言循环优化,执行效率显著超越多次 remove():
scores = [10, 0, 0, 20, 30]

# 方案 A:创建新列表(推荐)
cleaned_scores = [x for x in scores if x != 0]

# 方案 B:如果必须原地修改原列表对象(保持引用不变),使用切片赋值
scores[:] = [x for x in scores if x != 0]

print("高效清洗后的列表:", scores)
五、对比辨析:remove、del 与 pop 的区别
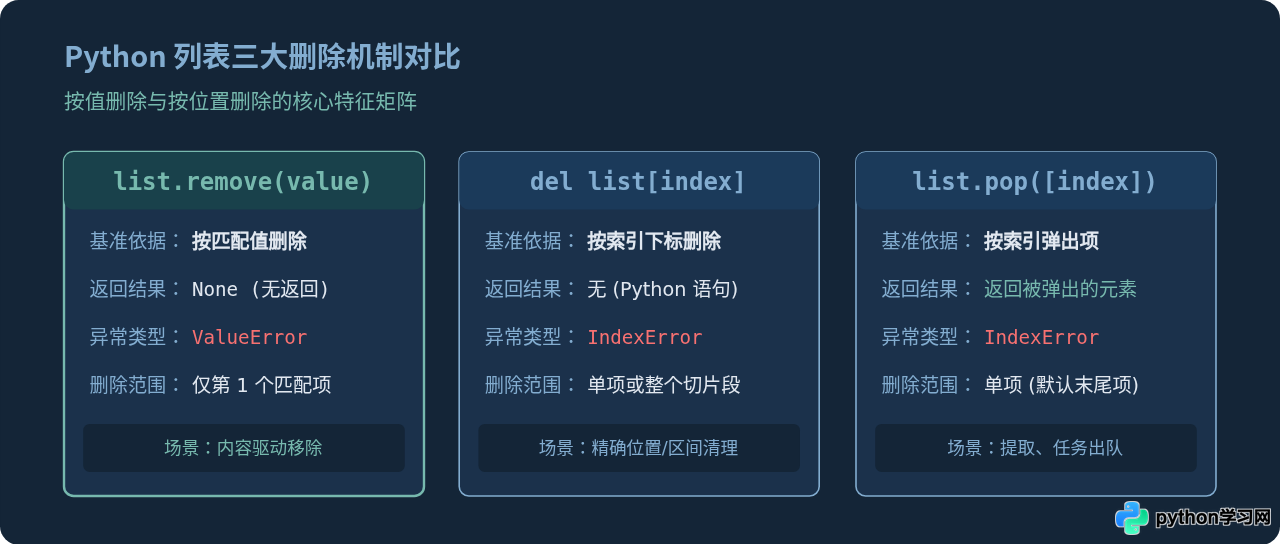
Python 提供了多种从列表中移除元素的方式,各自适用的维度和行为截然不同:
| 操作方式 | 删除依据 | 返回值 | 未找到时的异常 | 主要用途 |
|---|---|---|---|---|
list.remove(x) |
具体值 (Value) | None |
ValueError |
只知道内容,不知道具体位置,且仅删首个 |
del list[i] |
索引位置 (Index) | 无(语句) | IndexError |
已知具体下标或使用切片批量删除一段元素 |
list.pop([i]) |
索引位置 (Index) | 返回被删元素 | IndexError |
弹出并取出元素;默认操作末尾项 (栈结构) |
六、实践总结与决策导图
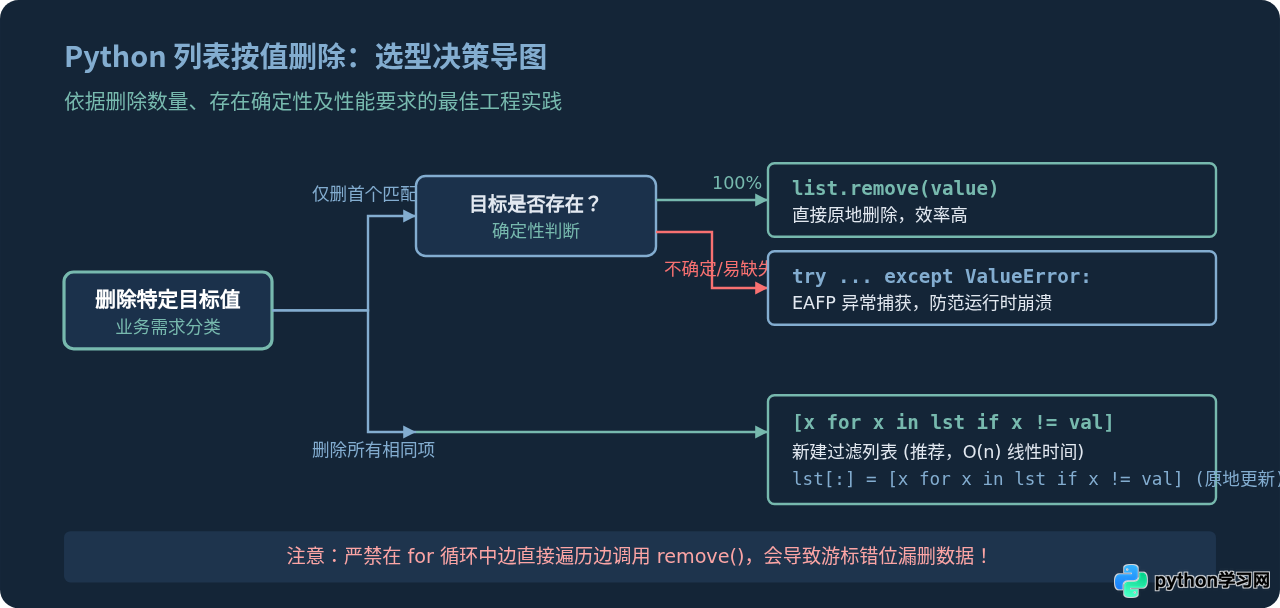
在面对“从 Python 列表中删除数据”的需求时,清晰的技术选型能够帮助编写出兼具鲁棒性与高性能的代码:
- 仅删除首个匹配项且确定元素存在:直接调用
list.remove(value)。 - 仅删除首个匹配项但不确定是否存在:采用
try...except ValueError: pass进行保护,优雅且开销小。 - 需要彻底删除所有匹配的元素:优先使用列表推导式
[x for x in list if x != target];若需就地保留原有对象引用,使用切片赋值list[:] = [...]。 - 已知位置或需要消费元素:根据需要选用
del list[index]或list.pop(index)。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















