


Polars表达式API和pandas链式操作区别是什么?
深入对比Polars表达式API与pandas链式操作的底层本质差异,涵盖执行模型、内存生命周期、多核并行机制、语法表达力及选型迁移建议。
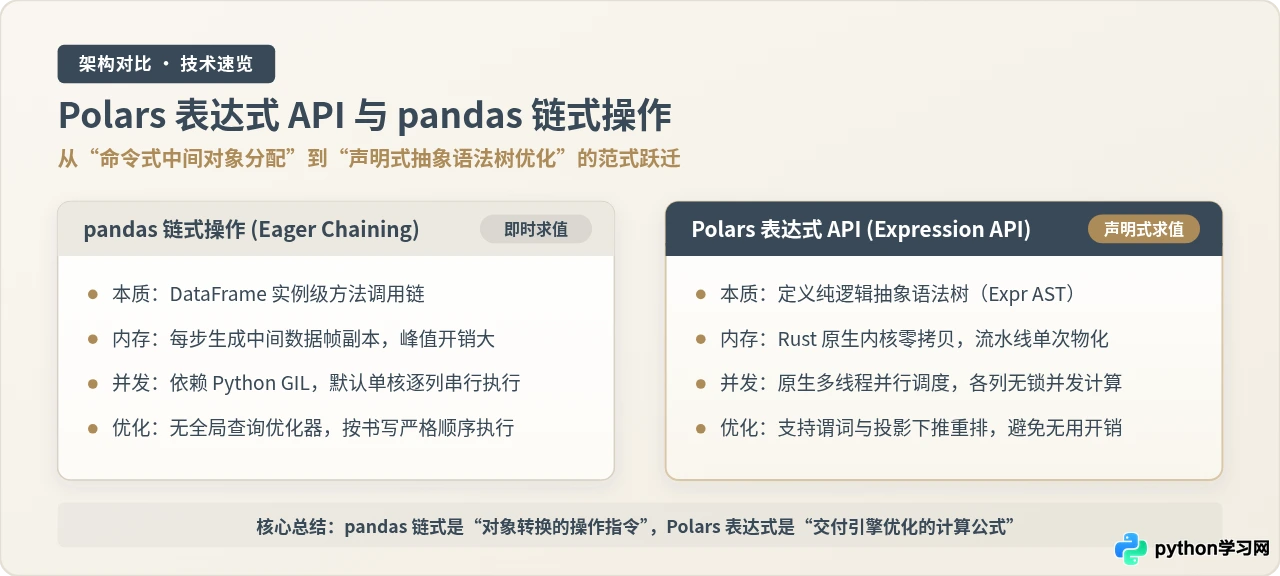
Polars 表达式 API 与 pandas 链式操作虽然表面上都呈现出方法点号(.)连接的链式调用外观,但两者的底层本质完全不同:pandas 链式操作是“即时执行的数据帧级方法链”,每一步调用都会在内存中立即实例化一个新的中间 DataFrame,计算受限于 Python 全局解释器锁(GIL),在单核上逐列推进;而 Polars 表达式 API 是“声明式的抽象语法树(AST)构建体系”,表达式本身是独立于具体数据帧的纯逻辑公式,在传入 select、with_columns 或 group_by 等上下文后,由底层 Rust 查询优化器进行谓词下推与投影下推重排,并自动通过工作窃取多线程池对多个表达式并行求值,最终一次性完成流水线物化。
一、执行机制:即时内存物化 VS 声明式表达式树
理解两者的首要分水岭在于何时求值以及中间计算结果如何驻留内存。在日常数据清洗中,开发者经常需要连续执行“筛选、新增计算列、重排序”等操作,两种框架在这一过程中的内存开销和硬件调度有着质的区别。
1. pandas 的即时执行机制(Eager Chaining)
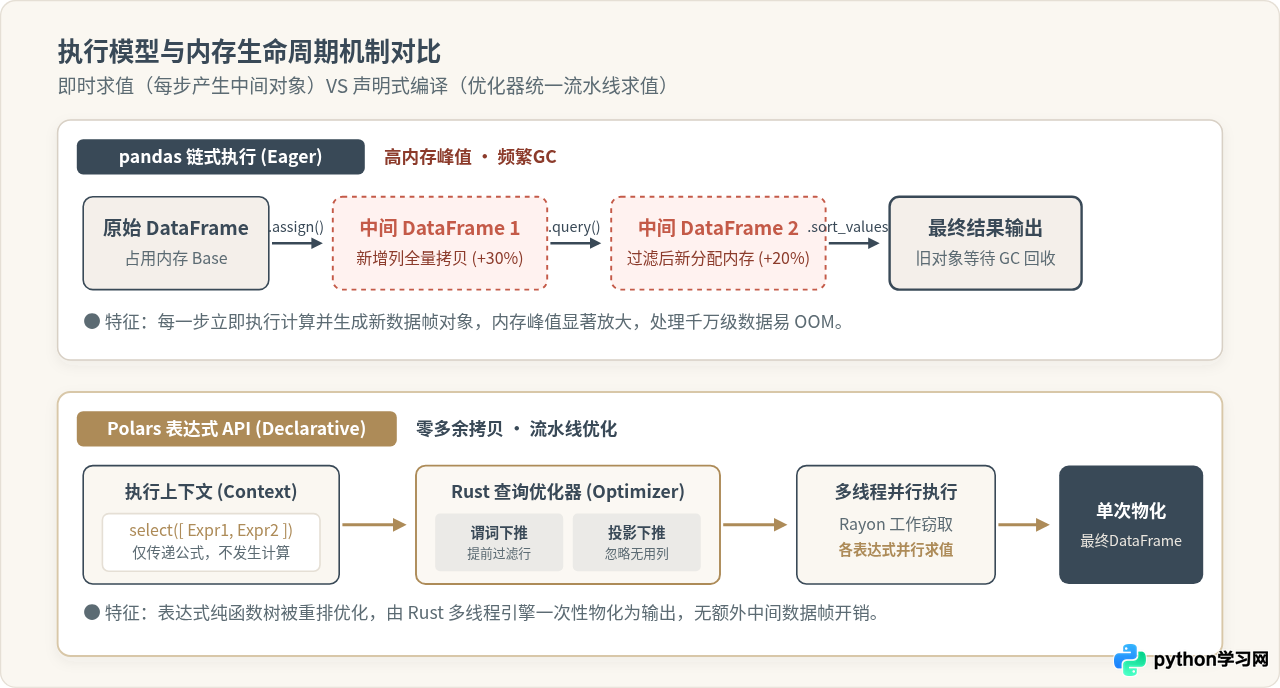
pandas 采用命令式(Imperative)设计。当使用 df.assign(...).query(...).sort_values(...) 时,Python 解释器会严格按顺序从左到右执行:
assign()触发时,pandas 会分配一块新的连续内存,将原数据帧的各列及新生成的列浅拷贝或深拷贝组装成一个全新的中间 DataFrame 实例。- 紧随其后的
query()又会在该中间 DataFrame 基础上再过滤切片,生成第二个全新的中间 DataFrame。 - 这一过程不仅伴随着多次昂贵的动态内存分配与垃圾回收(GC),而且如果前序过滤条件原本能剔除 90% 的无效行,但写在
assign()之后,pandas 依然会盲目地对全量数据完成耗时的列衍生计算。
2. Polars 的表达式语法树(Declarative Expression Tree)
Polars 则采用了现代数据库引擎的设计思想,将“定义计算逻辑”与“执行物理计算”彻底解耦。
在 Polars 中,pl.col("sales") * 1.1 返回的并不是带有具体数值的列或数组,而是一个类型为 polars.Expr 的轻量级纯声明对象。它仅仅是一颗记录了计算规则的抽象语法树(AST)。
无论你通过链式方法为这个表达式追加多少层数学运算、字符串处理或逻辑判断,在最终将该表达式传递给特定执行上下文(Context)之前,没有任何实际数据被读取,也没有任何内存被分配。当执行触发时,Polars 内部的 Rust 物理引擎统一调度,直接把多个表达式的结果流式灌入目标列,全程仅经历一次物化。
二、语法范式与书写思维的转变
从 pandas 迁移到 Polars,核心并不在于死记函数名差异,而在于从“以数据帧为中心”转向“以上下文加表达式为中心”的思维模式。
1. 上下文与表达式的正交设计
Polars 核心规范定义了三种最核心的执行上下文(Context),表达式在这些上下文中拥有完全一致的语法行为:
- 选择与转换上下文(Selection):
df.select([...]),仅输出列表达式计算后的目标列。 - 追加扩展上下文(Appending):
df.with_columns([...]),保留原表结构,并行追加或覆盖计算列。 - 聚合分析上下文(Aggregation):
df.group_by(...).agg([...]),在分组切片内直接对各列执行嵌套表达式。
2. 典型实战场景对比:多列并行衍生与条件筛选
假设我们有一张包含订单数据的表格,需要计算折扣金额、扣税后实付总额,并筛选最终金额大于 100 的有效记录。
# pandas 依赖 assign 与 lambda 引用正在构建中的中间对象
clean_pd = (
    raw_df
    .assign(
        # 新增列 1:折扣后单价
        discount_price=lambda d: d["price"] * (1 - d["discount_rate"]),
        # 新增列 2:含税总价(依赖前一步的新增列,只能通过嵌套 lambda 链式读取)
        total_amount=lambda d: d["discount_price"] * d["quantity"] * 1.06
    )
    .query("total_amount > 100")
    .sort_values(by="total_amount", ascending=False)
)import polars as pl
# Polars 在 with_columns 中以列表传递多个独立表达式,天然并发
clean_pl = (
raw_pl
.with_columns(
# 表达式直接声明业务公式,逻辑清晰且支持多核并发执行
discount_price = pl.col("price") * (1 - pl.col("discount_rate")),
total_amount = (pl.col("price") * (1 - pl.col("discount_rate"))) * pl.col("quantity") * 1.06
)
.filter(pl.col("total_amount") > 100)
.sort(by="total_amount", descending=True)
)
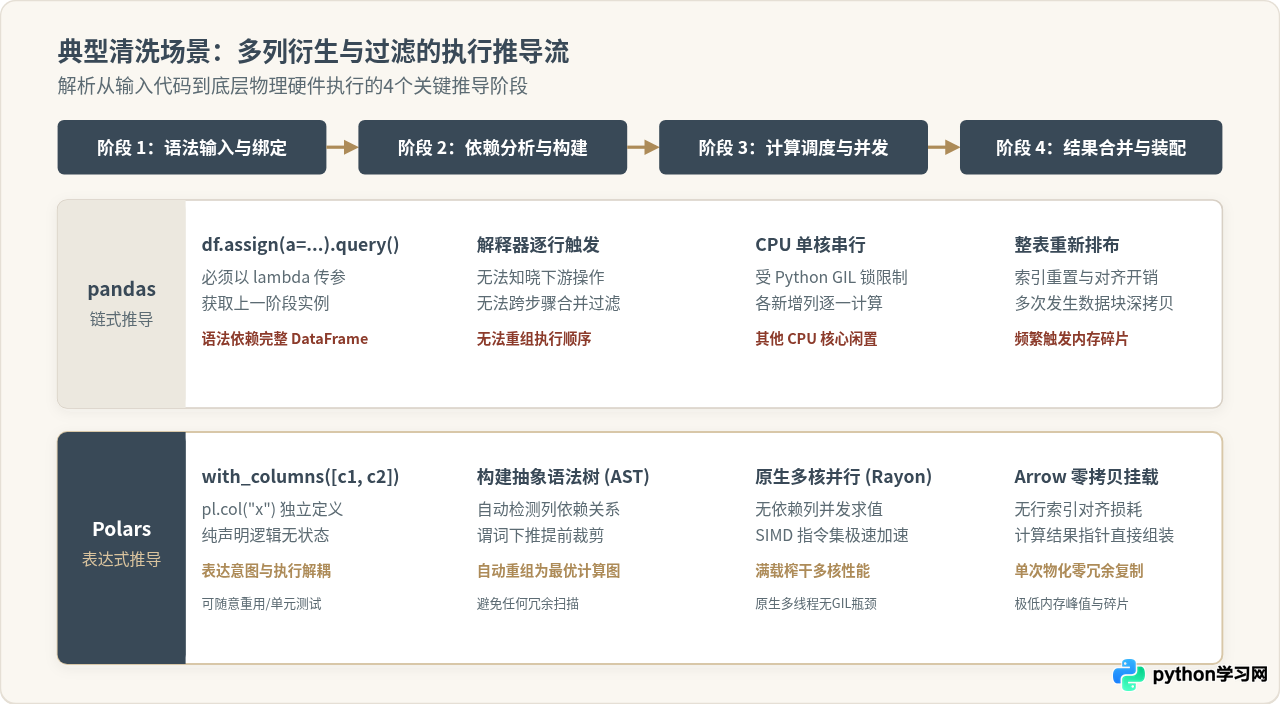
在上面的代码中,pandas 的第二列计算必须借助 lambda d: ... 捕获动态实例,且这两列必须由 Python 解释器串行计算。而在 Polars 中,传递给 with_columns 的每个表达式都是平等的,Rust 底层会自动调度 CPU 核心同时推进计算。
3. 复杂聚合场景的表达力跃升
在分组聚合中,pandas 传统的 groupby().agg() 往往只能接受简单的列映射字典。如果需要在聚合内部对数据做进一步的条件过滤、特定排序或切片截取,pandas 通常被迫退化使用低效的 groupby().apply(custom_func),引发极度缓慢的 Python 逐行循环。
而 Polars 的表达式在聚合上下文中是完全可组合嵌套的。你可以在聚合内部直接完成过滤与排序:
# 在分组内同时计算:总体平均分、仅限 VIP 用户的平均分、以及前 3 笔最大订单之和
summary = df.group_by("department").agg(
    # 普通聚合
    pl.col("sales").mean().alias("avg_sales"),

    # 条件嵌套聚合:直接在列上链式使用 filter,无需外部循环
    pl.col("sales").filter(pl.col("is_vip") == True).mean().alias("vip_avg_sales"),

    # 排序与切片嵌套聚合:组内排序并截取前三项求和
    pl.col("sales").sort(descending=True).head(3).sum().alias("top3_sum")
)
三、性能引擎:多核并行调度与优化器重排
为什么 Polars 的表达式 API 能带来数倍至数十倍的吞吐提升?除了 Rust 带来的内存安全性与 Arrow 列式内存对齐外,最深层的架构驱动力来自列级并行与物理查询优化器(Query Optimizer)。
1. 列级原生多线程并行(Rayon 线程池)
pandas 所有的核心操作均运行在 Python 单线程上(即使底层部分 NumPy 运算调用了 BLAS 多核,列与列之间的派生也是逐一完成的)。
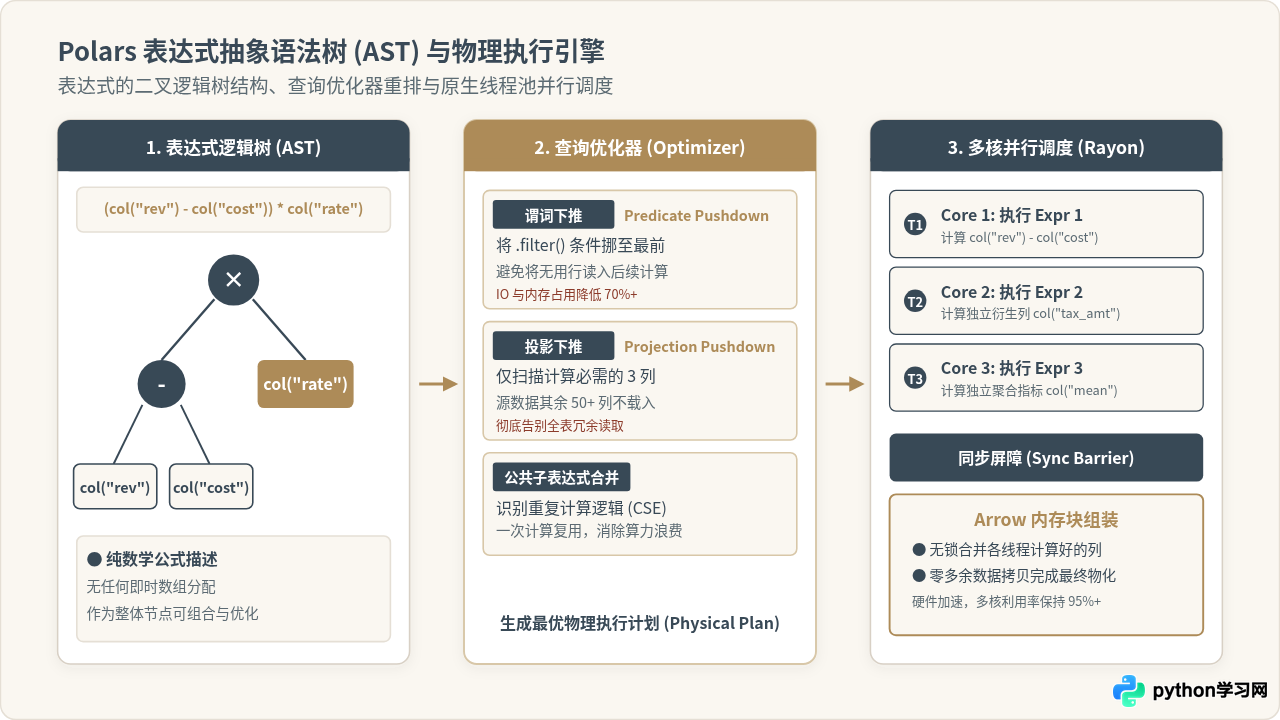
Polars 在执行 df.select([expr1, expr2, expr3]) 时,会首先对各个表达式进行独立性检测。由于 expr1 与 expr2 是纯函数,不存在共享状态冲突,Polars 自动通过高性能工作窃取(Work-stealing)线程池将各个表达式派发到不同的 CPU 核心上并行运算,并在最后的同步屏障(Sync Barrier)将各列指针组装成最终的数据表,多核利用率常年接近 100%。
2. 惰性执行与全图优化(LazyFrame)
虽然 Polars 在默认的急切模式(Eager DataFrame)下已经十分高效,但表达式 API 的真正威力是在配合 df.lazy()(即 LazyFrame)时彻底释放的。在惰性模式下,用户链式调用的每一步都会追加到逻辑执行计划中,在最终调用 .collect() 时,查询优化器会执行以下三重优化:
- 谓词下推(Predicate Pushdown):将所有
.filter()条件尽可能推移到数据流的最上游。例如在从 Parquet 文件读取时,直接跳过不符合行组(Row Groups),避免将无用数据加载到内存中。 - 投影下推(Projection Pushdown):扫描整个表达式树,识别出后续计算真正引用的列,未使用的数十列在扫描磁盘阶段就被直接丢弃,彻底消除宽表读取开销。
- 公共子表达式合并(Common Subexpression Elimination):如果多个新增列都依赖
(pl.col("a") + pl.col("b")),优化器会确保该加法只执行一次并共享结果,消除重复算力消耗。
四、常见迁移误区与避坑指南
许多从 pandas 转向 Polars 的工程师容易带着旧有习惯编写代码,导致不仅无法享受性能红利,甚至出现意料之外的错误。以下是需要特别注意的几个典型误区:
习惯了 pandas .apply(lambda x: ...) 的开发者往往会在 Polars 中调用 pl.col("x").map_elements(lambda v: ...)。这种做法会迫使 Rust 引擎在每一行数据上穿透 FFI 边界去获取 Python GIL 锁,彻底摧毁向量化执行与多线程优势,速度往往比原生表达式慢上百倍。
正确做法:优先使用 Polars 表达式自带的内置方法,例如条件分支使用 pl.when().then().otherwise(),字符串操作使用 pl.col("str_col").str.*。
在处理大于内存的超大规模数据集时,如果在中间不慎调用了 .to_pandas() 或没有使用 pl.scan_csv() / scan_parquet(),引擎就会被迫提前急切物化整个数据集,导致内存溢出。
正确做法:针对百万级以上任务,统一从 scan_* 开始构建 LazyFrame,用纯表达式串联全部清洗逻辑,仅在最后通过 .collect() 或 .sink_parquet() 落地结果。
五、选型指南与决策路径
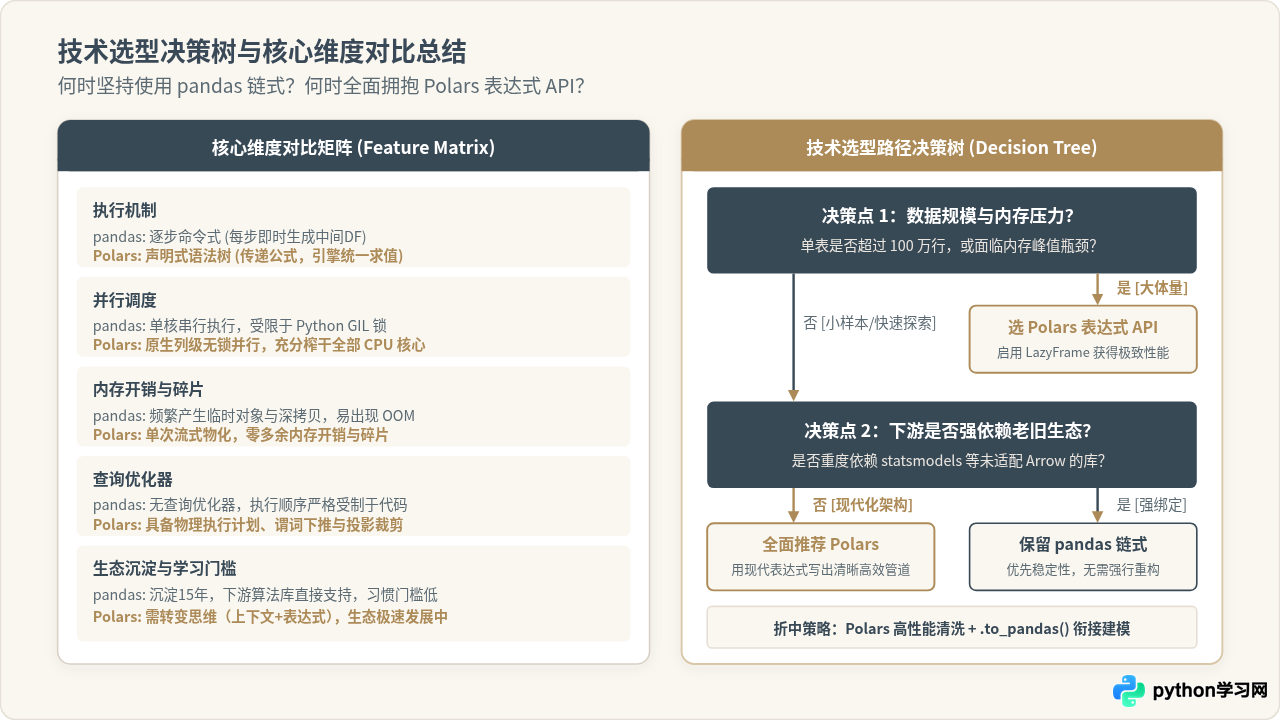
Polars 表达式 API 展现了现代计算引擎的巨大优越性,但在工程选型中并不意味着必须完全推翻已有项目。读者可以根据以下量化维度与决策树进行合理评估:
| 对比维度 | pandas 链式操作 | Polars 表达式 API |
|---|---|---|
| 核心范式 | 命令式(Imperative),以 DataFrame 对象为中心 | 声明式(Declarative),以纯表达式与上下文为中心 |
| 执行时机 | 即时求值(Eager),每步生成新中间对象 | 延迟规划(Lazy/Eager),优化后单次物化输出 |
| 并行能力 | 单核串行,受 Python GIL 全局锁约束 | Rust 原生列级无锁并行,充分调动所有 CPU 核心 |
| 内存管理 | 多次深/浅拷贝,中间对象导致高内存波动与碎片 | Arrow 列式内存对齐,零拷贝切割,内存平稳可预测 |
| 查询优化器 | 无。严格按代码书写顺序执行每一行 | 有。支持谓词下推、投影裁剪与公共表达式合并 |
| 生态兼容性 | 极高,与 scikit-learn、statsmodels 等无缝衔接 | 高速扩展中,支持 .to_pandas() / .to_numpy() 快速互转 |
选型落地结论:
- 选择保留 pandas 链式的场景:数据量在几十万行以内的小型探索分析、强依赖仅支持 pandas 结构的传统统计学包(如某些特化计量经济学库),或者代码逻辑中包含无法向量化的复杂第三方 Python 对象交互。
- 坚决选择 Polars 表达式 API 的场景:单表数据超过百万行、需要高吞吐实时或批量 ETL 管道、内存资源受限的云函数/容器环境,以及涉及复杂分组嵌套指标计算的金融与日志分析系统。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















