


学数据分析应该下载官方Python还是Anaconda

针对初学者学习数据分析时的Python选型难题,全面对比官方Python与Anaconda的核心差异、适用场景、安装配置步骤与常见避坑指南,助你快速建立高效稳定的数据分析开发环境。
一、解构本质:官方 Python 与 Anaconda 的核心差异
初学者容易产生一个认知误区,认为 Anaconda 是 Python 的某种“第三方衍生方言”。事实上,两者在 Python 语法层面没有任何差别,真正的区别在于软件的打包形态、依赖管理机制以及开箱预装工具链的完备程度。
官方 Python(发布自 python.org 的标准分发版)是一个极致精简的运行时。它只包含 Python 解释器和官方标准库,安装包体积通常在 30MB 到 50MB 之间。安装后,用户若要进行数据计算,必须依赖其自带的包管理器 pip 逐个下载安装所需的第三方轮子(wheels)。这种设计保障了系统的纯净与透明,但面对复杂的科学计算底层二进制依赖时,安装过程偶尔会受制于编译环境。
Anaconda 则是一个专门为数据科学和机器学习设计的集成开发套件。它以 Python 为基础内核,同时搭载了专门的包与环境管理系统 conda。除了核心运行时,Anaconda 在安装包中一次性预置了超过 250 个业界通用的科学计算与分析库(如 Pandas、NumPy、SciPy、Matplotlib、Scikit-learn 等),并附带了 Jupyter Notebook、JupyterLab 以及图形管理面板 Anaconda Navigator。
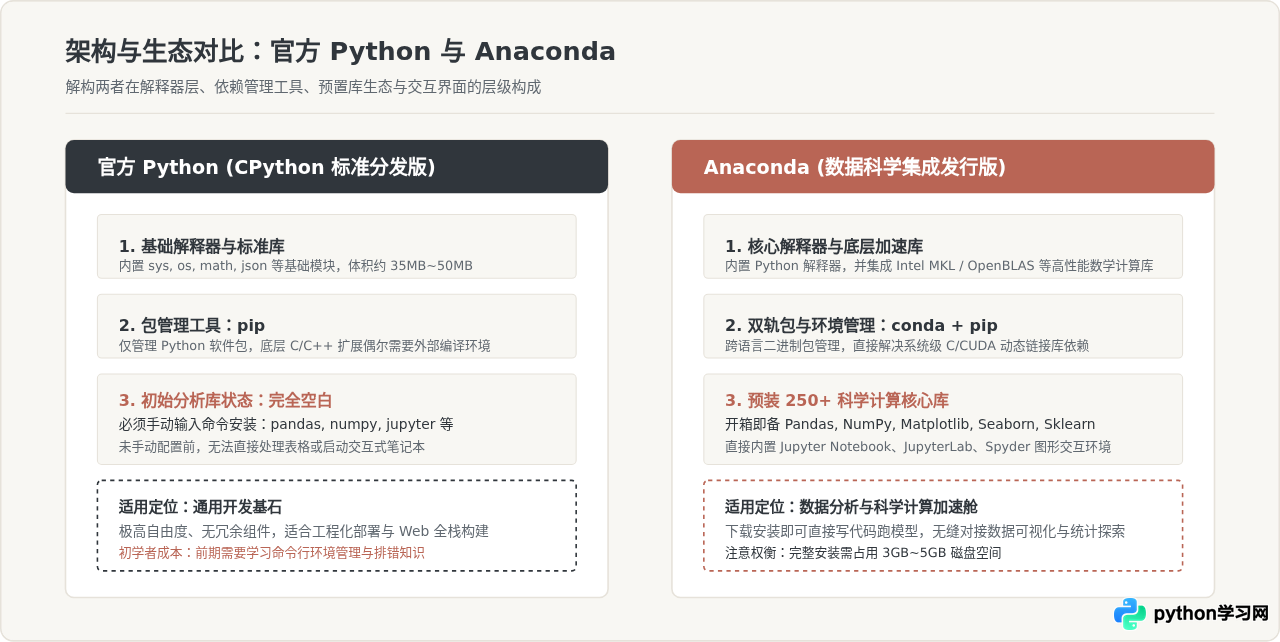
两者另一个不可忽视的技术差别在于底层数学库的优化。Anaconda 默认整合了 Intel MKL(Math Kernel Library)或硬件加速线性代数库,在涉及大型矩阵乘法、奇异值分解等数值运算时,往往比通过默认通用 pip 轮子安装的库表现出更好的单机执行效率。
二、按需决策:四种典型场景下的选型路线
选择哪一种工具,不应凭主观好恶,而应结合你当前的学习重心、电脑硬件条件以及未来规划进行权衡。以下四种情况涵盖了绝大多数学习者的现实处境:
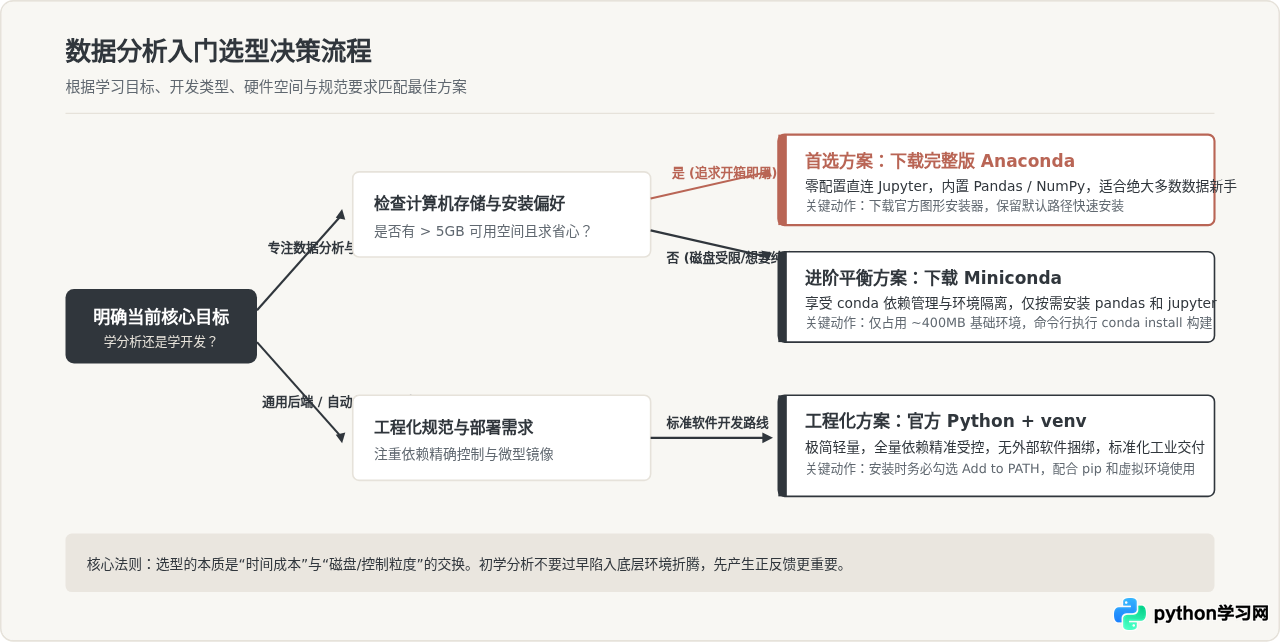
1. 零基础、专注业务分析与数据挖掘(推荐:Anaconda)
如果你的主要身份是经管类学生、运营、财务、产品经理或转行人员,学习 Python 的首要目标是替代 Excel 处理海量数据、做可视化图表或建立回归预测模型,那么 Anaconda 是最佳起点。你无需在开学前夕经历命令行语法错误、镜像源报错或环境路径未配置的挫败,直接启动 Jupyter Notebook 即可进入数据清洗实操。
2. 电脑磁盘紧张,但依然需要 conda 的环境管理(推荐:Miniconda)
如果你希望拥有 Anaconda 强大的依赖管理与虚拟环境隔离能力,但电脑固态硬盘所剩无几(例如剩余空间低于 10GB),不愿安装 250 多个平时用不到的预装包,可以选择 Miniconda。Miniconda 仅包含 Python 与 conda 本身,安装包不足 100MB,后续只需一行命令按需安装所需工具包即可。
3. 学习通用软件工程、Web 后端或自动化运维(推荐:官方 Python)
如果你的规划是成为后端开发工程师,未来需要编写 Django/FastAPI 接口、编写自动化测试脚本,并将代码封装为轻量级 Docker 镜像部署到云服务器上,官方 Python 搭配 venv 是行业标准规范。工程开发高度强调轻量与可复现,冗余包反而会增加镜像构建体积与安全审计负担。
4. 商业机构内部开发环境(注意许可证合规)
需要特别提醒的是,Anaconda 在超过 200 人的商业组织内使用默认仓库有商业授权条款约束。如果你是在大型企业内部或受限网络环境中使用,官方 Python 或基于开源社区规范维护的 Miniforge(使用 conda-forge 社区源)是更稳健且无合规风险的技术方案。
三、实战操作:两种路径的环境搭建与验证步骤
为了让读者对两种方案有具象的操作认知,以下分别梳理从下载安装到成功启动首个分析环境的具体步骤与执行验证命令。
路径 A:Anaconda 安装与分析环境初始化(推荐新手)
- 下载安装包:前往 Anaconda 官网(anaconda.com),下载适配当前系统(Windows / macOS Apple Silicon 或 Intel / Linux)的最新图形安装包(.exe 或 .pkg)。
- 关键选项设置:安装过程中,Windows 用户建议不要勾选“Add Anaconda to my PATH environment variable”(避免与系统自带工具发生命名冲突),勾选默认的“Register Anaconda as my default Python”即可。所有环境管理建议通过专用的“Anaconda Prompt”或终端执行。
- 创建专属分析虚拟环境:打开系统菜单中的“Anaconda Prompt”(macOS 打开系统“终端”),执行以下命令创建一个独立的虚拟环境:
# 创建一个名为 data_env 且 Python 版本为 3.10 的独立环境
conda create -n data_env python=3.10 -y

# 激活该环境
conda activate data_env

# 在该环境中安装 Jupyter Notebook 与分析基础库
conda install pandas numpy matplotlib jupyter -y
执行完成后,控制台将输出依赖解析结果并自动完成所有二进制链接配置。
- 验证与启动:在激活的
data_env终端中输入jupyter notebook,系统将自动在默认浏览器中打开交互式工作台。新建一个 Python 笔记本,输入import pandas as pd; print(pd.__version__),按下 Shift + Enter,若成功输出版本号(如 2.2.x),即代表数据分析环境完全配置成功。
路径 B:官方 Python 搭配 venv 的极简搭建
- 下载安装包:访问 python.org,下载最新的稳定稳定版(例如 Python 3.11 或 3.12 对应安装程序)。
- 安装关键步骤:Windows 用户在安装界面的第一个窗口中,务必勾选底部的“Add python.exe to PATH”,随后点击“Customize installation”或“Install Now”。macOS 用户直接按默认向导完成安装。
- 使用标准库 venv 建立隔离目录:打开系统的 CMD、PowerShell 或终端,依次执行以下命令:
# 创建项目工作目录并进入
mkdir my_data_project
cd my_data_project

# 使用标准库创建名为 .venv 的虚拟环境
python -m venv .venv

# 激活虚拟环境 (Windows PowerShell 命令)
.venv\Scripts\Activate.ps1
# (若为 macOS/Linux 终端,则使用: source .venv/bin/activate)

# 升级 pip 并安装核心数据分析套件
pip install --upgrade pip
pip install pandas numpy matplotlib jupyter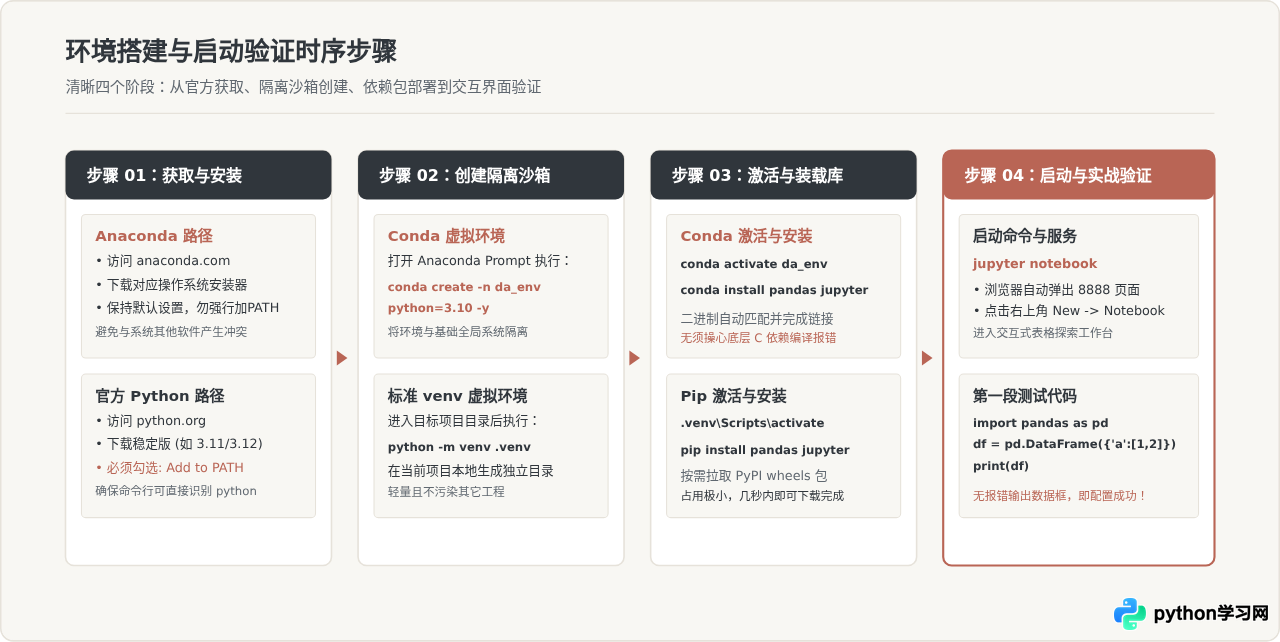
四、初学者常见误区与避坑指南
在实际辅导新手搭建数据分析环境的过程中,有几个高频出现的典型误区,提前了解可以节省大量无效排错时间:
答案是可以,但有顺序讲究。在 Conda 虚拟环境中,最稳妥的策略是:能用 conda install 安装的包,优先用 conda 安装;只有 conda 渠道没有的冷门包,再用 pip 补充安装。尽量避免反复交替混用,以防底层二进制版本产生覆盖冲突。
技术上完全可以共存。但对初学者而言,强烈不建议在没有环境变量管理经验的情况下同时安装两者。很多新手在终端里输入
python 时,调用的是官方 Python,而输入 pip install 时却把包下载到了 Anaconda 目录下,导致“明明安装成功却始终报 ModuleNotFoundError”的混乱现象。如果必须共存,请通过绝对路径或激活具体虚拟环境来调用。
完全不是。Anaconda 是一艘适合新手的“新手防护巡逻船”。随着技术熟练度提升,很多人在掌握了命令行、Git 以及 Docker 之后,会主动转向更轻量的 Miniconda 或纯粹的 官方 Python + Poetry / uv 现代包管理方案。在起步阶段借助 Anaconda 跨过环境配置门槛,绝不影响未来的技术演进。
五、总结:核心维度横向对照表
为了帮助你在几秒内回顾全文并做出最终选择,下表将两者在关键工程与学习指标上的表现进行了横向汇总:
| 对比维度 | 官方 Python (CPython) | Anaconda |
|---|---|---|
| 安装包与磁盘开销 | 约 40MB 安装包,装完约 150MB~300MB(极小) | 约 1GB 安装包,装完约 3GB~5GB(较庞大) |
| 预装分析包与工具 | 仅标准库,无 Pandas、Jupyter,初始需自行下载 | 开箱内置 250+ 科学计算核心库及图形交互工具 |
| 包管理机制 | pip(仅管理 Python 生态包) |
conda(跨平台二进制 + 系统级库依赖管理) |
| 新手上手阻力 | 中等(需熟悉终端、环境变量、虚拟环境概念) | 极低(图形安装向导,开箱即用 Jupyter) |
| 计算性能优化 | 通用标准构建,依赖标准 PyPI 预编译轮子 | 深度集成 Intel MKL 等硬件线性代数加速库 |
| 最契合的应用场景 | 通用软件工程、Web 接口、爬虫脚本、Docker 轻量部署 | 数据分析、统计建模、机器学习实验、学术探索 |
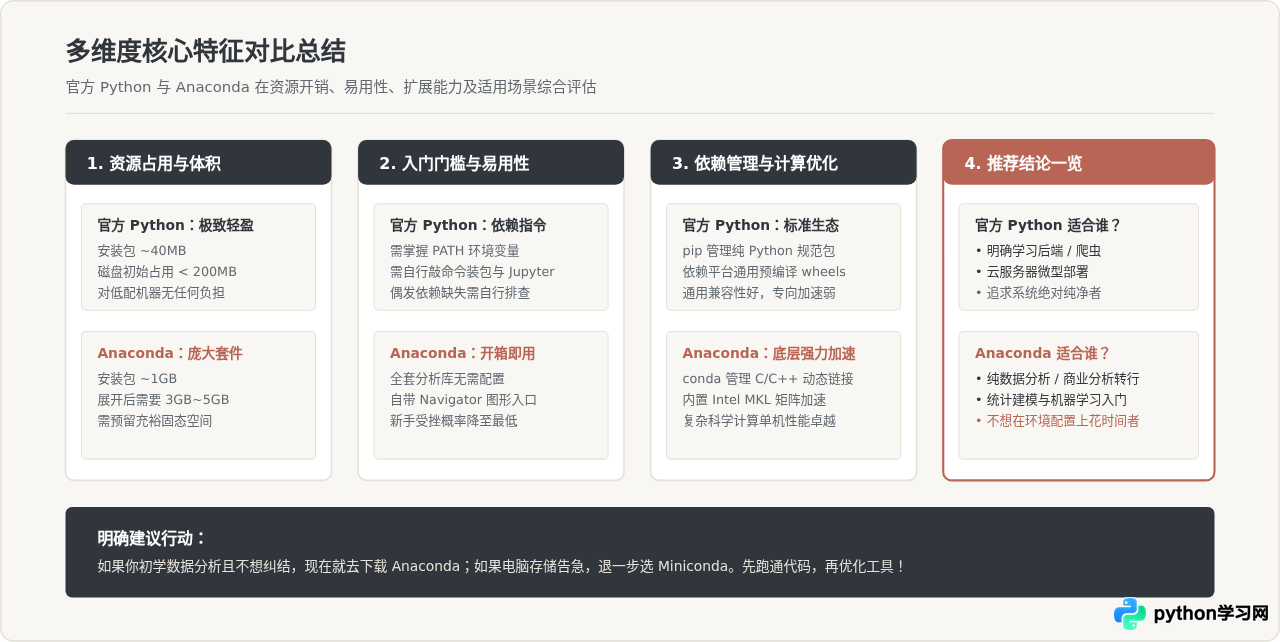
学习数据分析的核心价值在于理解业务问题、构建指标体系以及运用统计模型挖掘数据背后的规律,而非在第一天耗费数小时去解决控制台的依赖报错。明确了这一点,选择 Anaconda 作为起步踏板,便能最大化保留你对数据探索的热情与专注力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















