


Python适合解决哪类实际问题
深入解析Python最适合解决的实际问题类型,涵盖办公自动化、数据处理与分析、接口集成、轻量后端开发等领域,并提供清晰的技术选型依据与辨析指南。
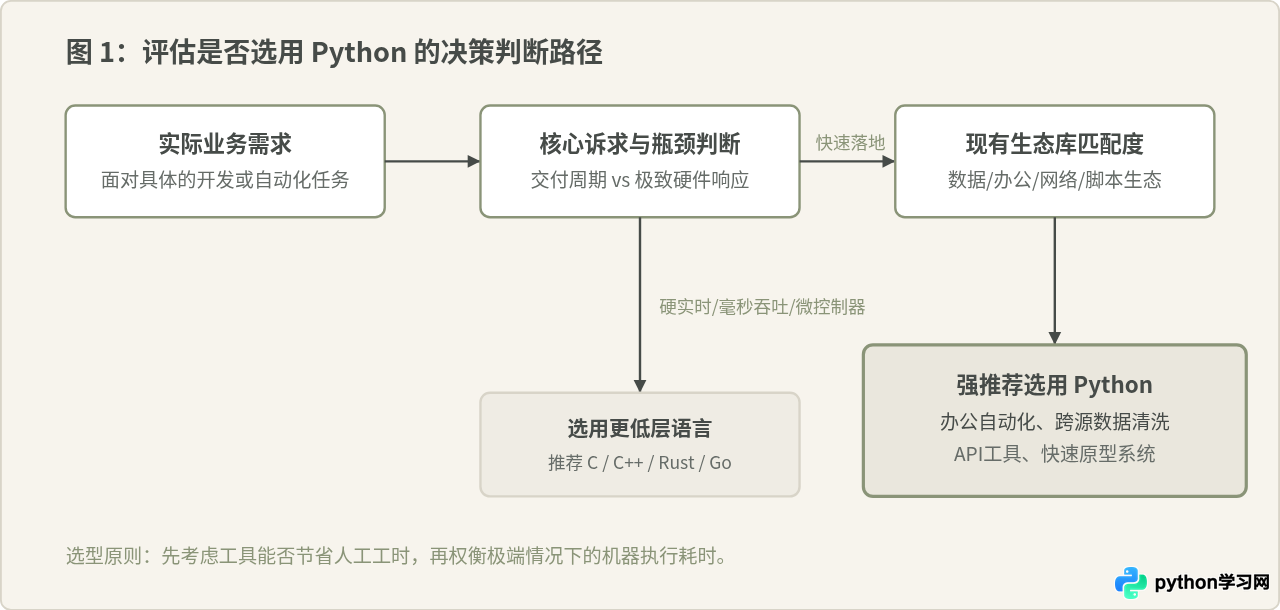
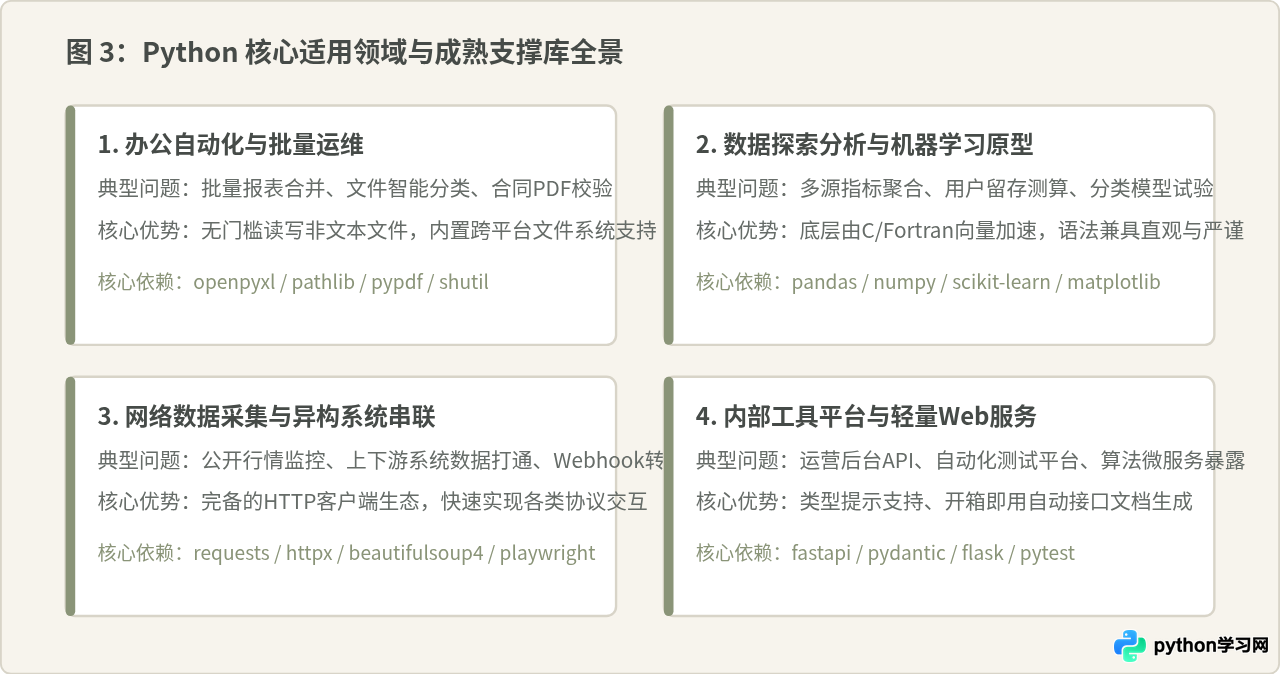
Python最适合解决的核心问题,可以总结为“需要在有限人力和时间成本下,快速搭建稳定、可复用的自动化工具、数据流水线或系统原型”。它的优势不在于追求微秒级的底层执行极限,而在于借助丰富的现成工具库,以极短的代码路径打通文件、数据、网络接口与业务逻辑之间的链路。
一、高频重复的办公事务与本地文件自动化
在企业日常运作中,最消耗人工精力且极易出错的,往往是规则明确但数量庞大的常规操作,例如每月对上百个分公司提交的报表进行核对、把指定目录下的成千上万个文件按规则重命名归档,或是从不同格式的发票与PDF中提取结构化字段。这类问题具有明确的逻辑规则,但手工处理极其繁琐。
Python在此类场景中具备极高的性价比。借助 os、shutil、pathlib 等内置库,可以灵活控制本地文件目录与路径;配合 openpyxl、python-docx 和 pypdf 等第三方组件,可以直接对非纯文本办公格式进行低侵入式读写。通常只需数十行代码,就能将原本需要数天的人工机械劳动缩减为几十秒的脚本执行。
# 示例:批量扫描指定目录并汇总多个Excel表的关键销售数据
from pathlib import Path
import openpyxl

data_folder = Path("./sales_reports")
summary_records = []

# 遍历目录中所有以.xlsx结尾的文件
for file_path in data_folder.glob("*.xlsx"):
    wb = openpyxl.load_workbook(file_path, data_only=True)
    sheet = wb.active
    # 读取B2单元格的分支名称与E10单元格的合计金额
    branch_name = sheet["B2"].value
    total_sales = sheet["E10"].value
    if branch_name and total_sales:
        summary_records.append({"branch": branch_name, "total": float(total_sales)})

# 打印提取结果供后续校验
for item in summary_records:
print(f"分支机构: {item['branch']}, 销售汇总: {item['total']:.2f}")注意:在编写文件批量操作脚本时,务必先在测试目录中运行,或在执行写入、覆盖和删除前增加备份机制,避免由于路径匹配规则偏差导致原有重要文件被意外覆盖。
二、异构数据的清洗、统计与分析探索
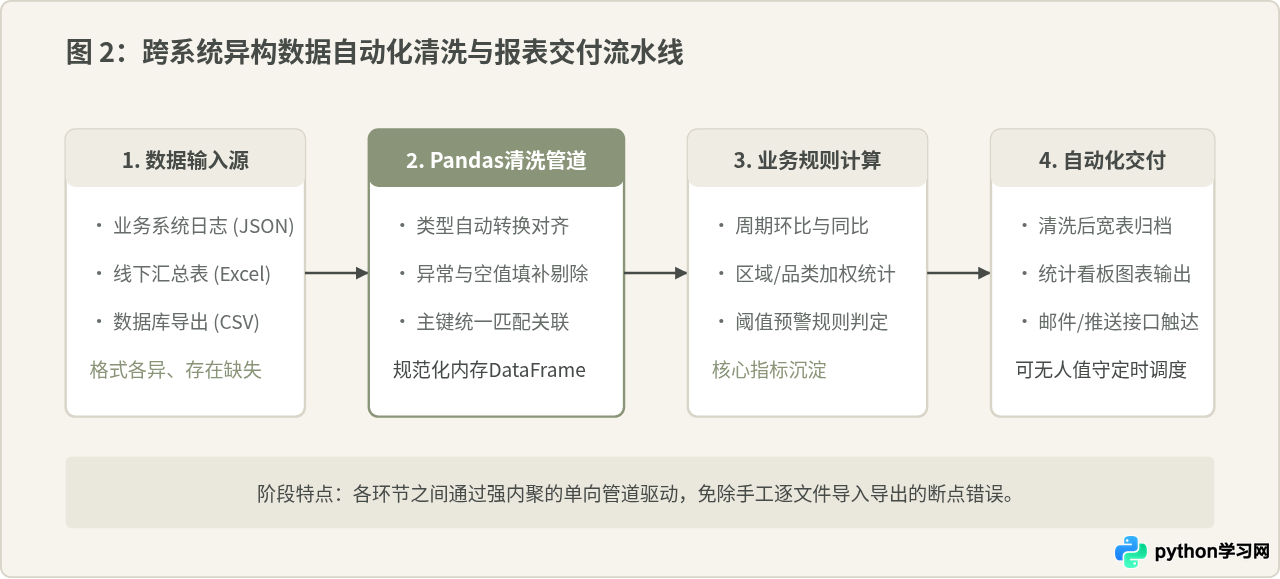
企业在进行业务决策时,数据往往分散在日志文件、数据库导出文件、第三方服务后台和各种表格之中。这些源头数据普遍存在字段命名不一、格式混乱、缺失值多、单位未对齐等问题。如果使用传统数据库或底层静态语言进行清洗,往往需要定义繁琐的表结构与类型转换逻辑;若使用常规表格软件,又难以支撑几十万行以上规模的数据体量。
Python通过 Pandas、NumPy 构建的数据处理栈,专门为矩形表格数据提供了灵活且高性能的内存操作能力。分析人员不仅可以在几秒内完成多表关联(Merge)、分组聚合(GroupBy)与透视计算,还能通过 Matplotlib 或 Seaborn 快速生成业务趋势图表,及时发现异常点与核心分布。
三、网络资源采集、接口串联与胶水整合
在不同系统之间建立连接,也是Python最为擅长的实际问题之一。现代软件系统往往分散在多个独立的SaaS平台、云服务和自建系统之间。例如,客户在营销页面提交表单后,需要将数据实时同步到内部ERP,并同时向企业微信群发送提醒。如果等待两个厂商开发原生互通模块,往往耗时长、成本高。
Python被称为经典的“胶水语言”。它通过 requests 或异步的 httpx 可以极简地调用RESTful API,利用 Playwright 或 BeautifulSoup 获取公开网页上的非接口数据,再通过内置的 json 和网络套接字将不同系统黏合在一起。开发人员只需关注两端数据的映射关系,无需处理冗余的代码样板。
四、中小型Web服务与内部运营工具的敏捷开发
在实际企业业务中,并非所有系统上线第一天就需要承受几十万QPS的并发压力。很多时候,团队的核心诉求是“明天就要上线一个可供内部运营人员使用的查询控制台”或者“两天内为前端团队提供一套符合业务规范的RESTful接口进行功能联调”。
在这类强调快速上线与验证迭代的场景中,现代Python Web框架(如 FastAPI)展现出了极高的工程效率。基于标准的Python类型提示,它可以自动完成入参合法性校验、错误提示返回,并实时生成交互式OpenAPI文档。开发人员可以将全部精力投入到业务规则本身,而不是耗费在重复的样板配置上。
# 示例:使用FastAPI编写一个具备入参自动校验的汇率换算服务
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel, Field

app = FastAPI(title="CurrencyExchangeService")

# 模拟固定汇率映射表
RATES = {"USD": 7.23, "EUR": 7.85, "JPY": 0.047}

class ConvertRequest(BaseModel):
    currency: str = Field(..., description="目标外币代码,如USD、EUR")
    amount: float = Field(..., gt=0, description="换算金额,必须大于0")

@app.post("/api/convert")
def convert_to_cny(req: ConvertRequest):
    code = req.currency.upper()
    if code not in RATES:
        raise HTTPException(status_code=400, detail=f"暂不支持的币种: {code}")
    cny_value = req.amount * RATES[code]
    return {
        "source_currency": code,
        "amount": req.amount,
        "converted_cny": round(cny_value, 2)
    }
五、常见认知辨析:“Python什么都能做”在何时成立与失效
在技术讨论中,常能听到“Python是一门万能语言,什么都能做”的观点。这一说法看似合理,主要是因为Python拥有覆盖极广的第三方包生态,无论是图像处理、声音合成、机器学习、游戏脚本还是网页制作,你总能在社区中找到对应库。在“验证概念可行性”或者“制作最小可用原型(MVP)”的语境下,这句话是成立的。
但在严苛的工业级生产环境中,盲目套用该结论会导致严重的工程缺陷。具体需要修正的认知边界包括:
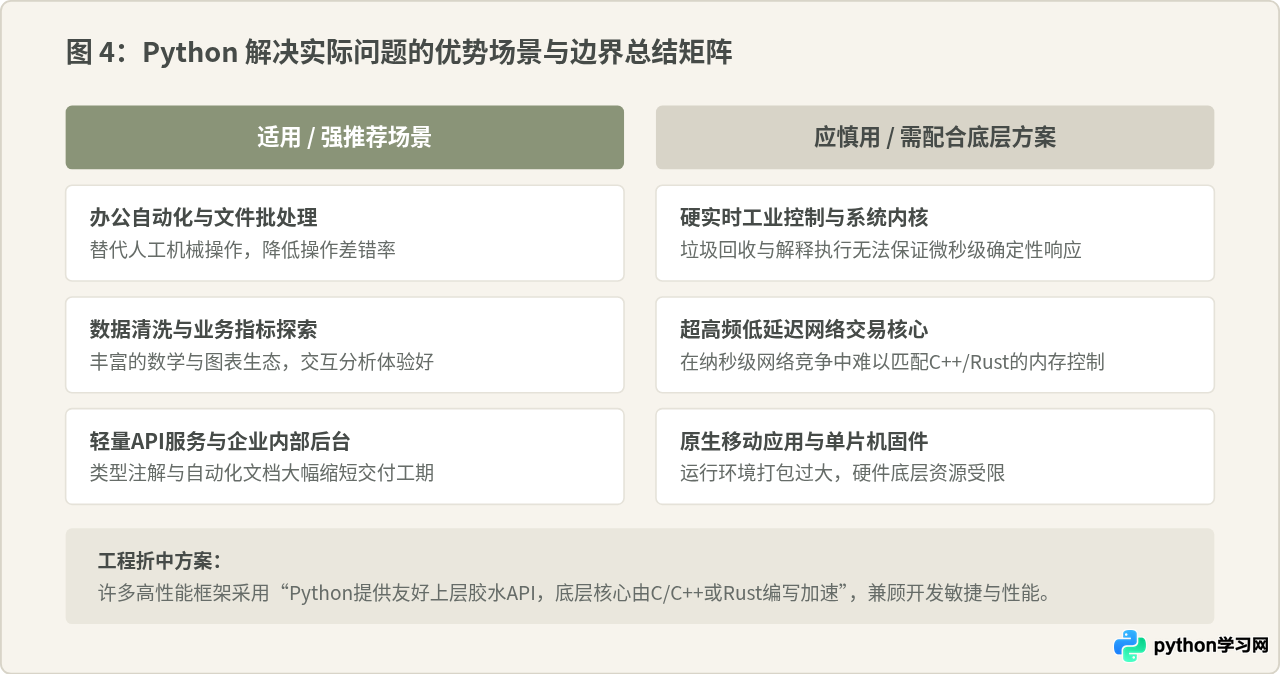
- 高吞吐微秒级计算:Python解释器的全局解释器锁(GIL)和动态类型检查,使其不适合直接编写高频交易引擎核心、3D游戏底层渲染管线等CPU密集型强实时任务。
- 严苛内存受限环境:在仅有几十KB或几MB内存的低功耗单片机或物联网边缘设备上,Python运行时的内存占用通常过重,C语言或专用汇编仍是首选。
- 原生移动客户端开发:尽管有相关框架支持在Android或iOS上打包Python,但在安装包体积、启动耗时、UI响应丝滑度和系统原生API对接上,通常难以匹敌Kotlin或Swift。
六、总结与落地建议
判断一个实际问题是否应当使用Python解决,最核心的标准是衡量“人力编写与试错的时间”与“机器运行的时间”哪个更为昂贵。
如果业务处于探索期,逻辑经常调整,或者面对的是大量异构数据与分散格式的文件,Python几乎总是成本最低、见效最快的工具;而一旦业务模式完全固定,面对海量并发请求或极致计算耗时瓶颈时,则可以考虑将关键性能计算模块剥离,改用静态编译型语言重构,形成“Python主导编排、高性能内核负责底层计算”的高效技术组合。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















