


Python第三方regex库比内置re模块强在哪里?
深入对比Python内置re模块与第三方regex库的核心差异,详解变长后顾断言、完整Unicode属性支持、重叠匹配、模糊匹配等强大功能与迁移策略。
简而言之,Python内置的 re 模块是一个足够应付常规字符串解析但多年演进相对保守的基础引擎;而第三方 regex 库(由 Matthew Barnett 维护)则是功能向 PCRE2 与 Perl 等现代强大正则标准看齐的高级引擎。regex 彻底解除了 re 中“后顾断言必须定长”的顽固限制,原生支持完整的 Unicode 字符属性类别与字形簇匹配,并提供了重叠模式查找、模糊容错匹配以及递归嵌套语法等高阶特性。
一、核心能力全景对比
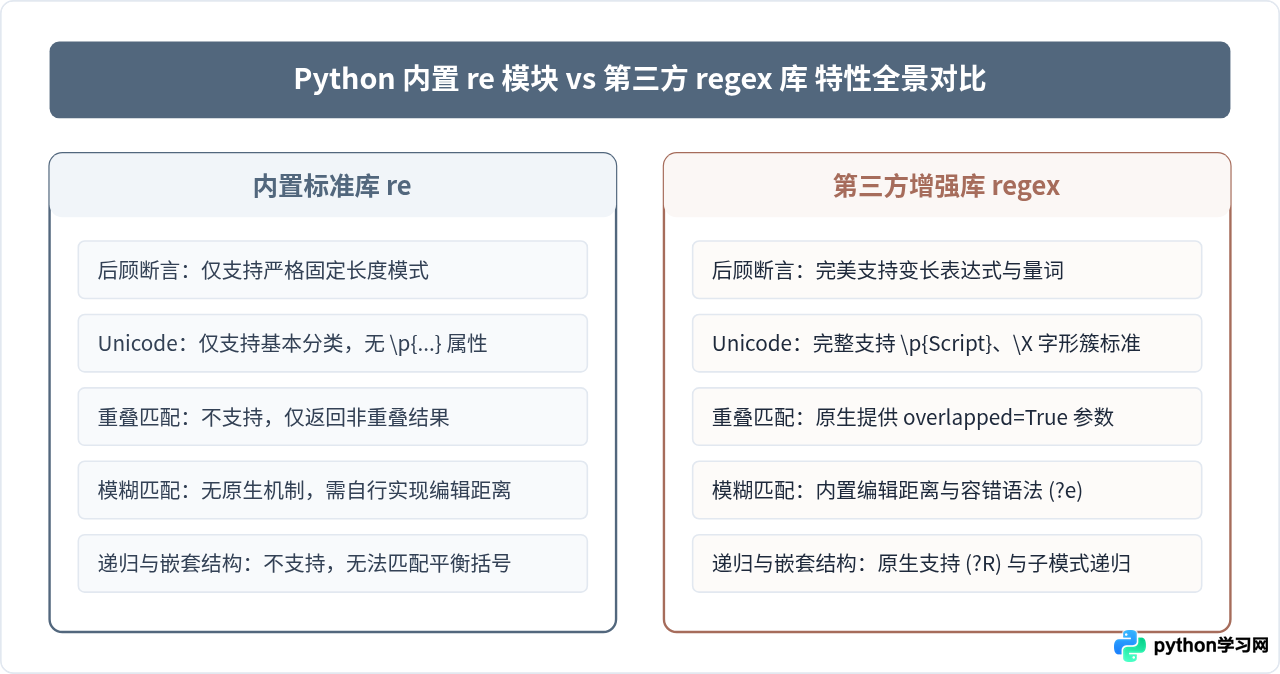
很多 Python 开发者在遇到复杂的文本抽取需求时,都会撞上 re 的功能边界。比如在提取标签属性、清洗包含多国语言或表情符号的文本、或者解析嵌套括号结构时,re 往往需要开发者编写冗长的外部循环或预处理逻辑。下方的架构对比图直观展现了两个模块在能力维度上的差异。
二、核心亮点详述与代码实证
1. 真正好用的可变长后顾断言(Lookbehind)
在内置 re 模块中,如果你写了类似 (?<=https?://) 或者 (?<=\d{2,4}) 的正则,程序会直接抛出语法错误:look-behind requires fixed-width pattern。这是因为 re 引擎的逆向检查器必须预先知道需要倒退多少个字符,无法处理长度不确定的前导模式。
而在 regex 库中,这一痛点被彻底解决,无论是选择分支、重复量词还是可选符号,都可以自由放置在后顾断言中。
import re
import regex

text = "协议类型:http://example.com 以及 https://secure.org"

# 内置 re 尝试变长后顾断言会报错:
try:
    re.findall(r"(?<=https?://)[a-z.]+", text)
except Exception as e:
    print(f"re 报错示例: {e}")
    # 输出: look-behind requires fixed-width pattern

# 使用 regex 库则完全支持:
domains = regex.findall(r"(?<=https?://)[a-z.]+", text)
print(f"regex 结果示例: {domains}")
# 输出: ['example.com', 'secure.org']
2. 全面的 Unicode 属性与字符类支持
内置 re 模块只认识有限的 ASCII/Unicode 简写类(如 \w、\s、\d)。当我们需要精准匹配汉字、平假名、希腊字母或表情符号(Emoji)时,在 re 中通常只能手写粗糙的 Unicode 码点区间(例如 [\u4e00-\u9fa5],这甚至遗漏了大量生僻汉字与扩展区)。
regex 支持现代 Unicode 标准属性 \p{...}、字符脚本 \p{Script=...} 以及用于匹配完整展示字形(防止组合字符与表情符号被切碎)的 \X 元字符。
import regex

sample_text = "Python 编程:α-beta 测试,こんにちは,附带表情 👍🏼 标志。"

# 精准提取所有汉字(使用 Unicode 脚本分类)
chinese_chars = regex.findall(r"\p{Han}+", sample_text)
print("中文字符:", chinese_chars)
# 示例输出: ['编程', '测试', '附带表情', '标志']

# 匹配由基字符与修饰符组成的完整用户感知字形簇(Grapheme Cluster)
# 比如附带肤色修饰符的表情 👍🏼 占多个码点,但在 \X 下作为一个整体捕获
graphemes = regex.findall(r"\X", "👍🏼")
print("字形簇长度:", len(graphemes))  # 示例输出: 1
3. 原生重叠匹配(Overlapped Matching)
文本处理和生物信息学中经常需要寻找滑动窗口内的重叠匹配(例如在 DNA 序列中统计短串频次,或提取滑窗特征)。内置 re.findall 每次成功匹配后,指针会直接移动到匹配结果之后,导致重叠项被直接跳过。
在 regex 库中,只需指定 overlapped=True 参数,即可轻松捕获所有可能重叠的匹配段落。
import re
import regex

sequence = "AAAA"

# 内置 re 只能得到非重叠的 2 个 'AA'
print("re.findall:", re.findall(r"AA", sequence))
# 示例输出: ['AA', 'AA']

# regex 开启 overlapped=True,得到全部 3 个重叠片段 (0-2, 1-3, 2-4)
print("regex.findall:", regex.findall(r"AA", sequence, overlapped=True))
# 示例输出: ['AA', 'AA', 'AA']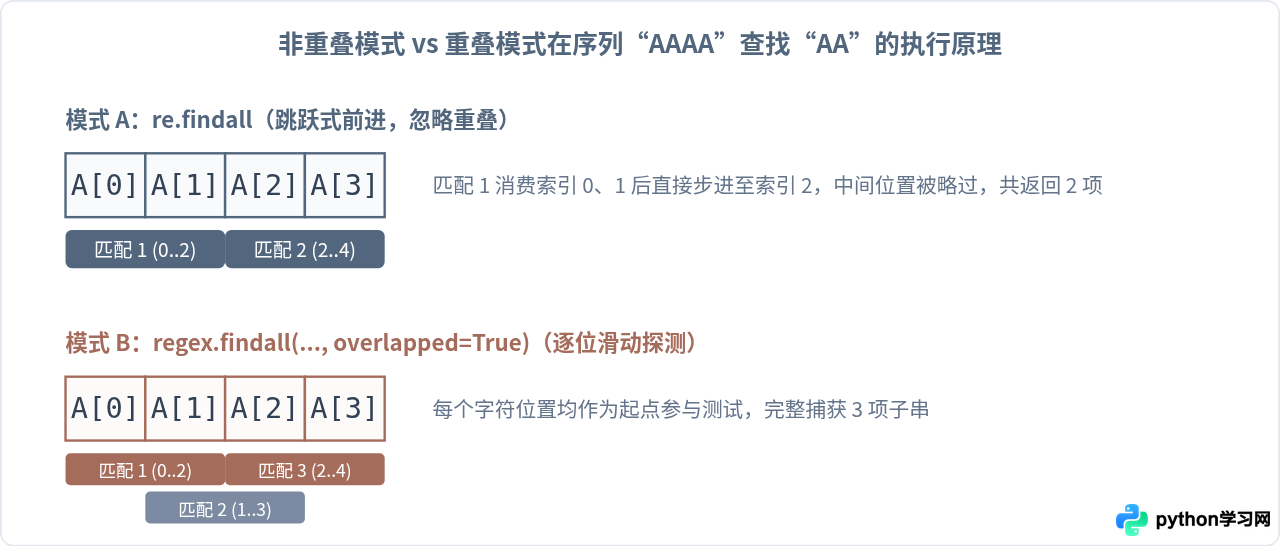
4. 模糊匹配(Fuzzy Matching)
OCR 识别输出、用户手动输入的关键词通常存在漏字、错字或多余字符。如果在 re 中实现模糊容错,我们只能先粗筛再用 Levenshtein 编辑距离算法二次过滤。而 regex 直接在语法层面内置了模糊匹配语法 (?:pattern){e<=k}(即允许至多 k 次插入、删除或替换)。
import regex

# 目标:匹配单词 "algorithm",但允许最多 1 处拼写失误(插入、删除或替换)
pattern = r"(?e)(?:algorithm){e<=1}"
raw_input = "用户可能输入了 algoritm、algorithm 或 algorithmm。"

matches = regex.findall(pattern, raw_input)
print("模糊匹配命中的词汇:", matches)
# 示例输出: ['algoritm', 'algorithm', 'algorithmm']
5. 递归与嵌套语法结构匹配
传统的理论常说“正则表达式不能用来解析 HTML 或嵌套括号”,这对于经典有限状态自动机是成立的。但 regex 支持递归模式 (?R) 或子模式调用 (?1),可以轻松匹配任意深度的平衡嵌套括号。
import regex

# 匹配嵌套的括号结构:形如 (a + (b * (c - 1)))
nested_expr = "公式: 10 + (2 * (5 + 3) / (4 - 1)) + 8"
# 模式拆解:以 ( 开头,中间允许非括号字符或递归自身,以 ) 结尾
pattern = r"\((?:[^()]|(?R))*\)"

matches = regex.findall(pattern, nested_expr)
print("提取的完整括号组:", matches)
# 示例输出: ['(2 * (5 + 3) / (4 - 1))']
三、平滑迁移与使用操作流程
regex 在设计之初就作为 re 的潜在替代品(历史上曾作为 PEP 3114 候选),因此其基础 API(search、match、findall、sub、split、compile)与 re 保持了 100% 的兼容度。通常仅需一条导入语句重命名即可完成平替切换。
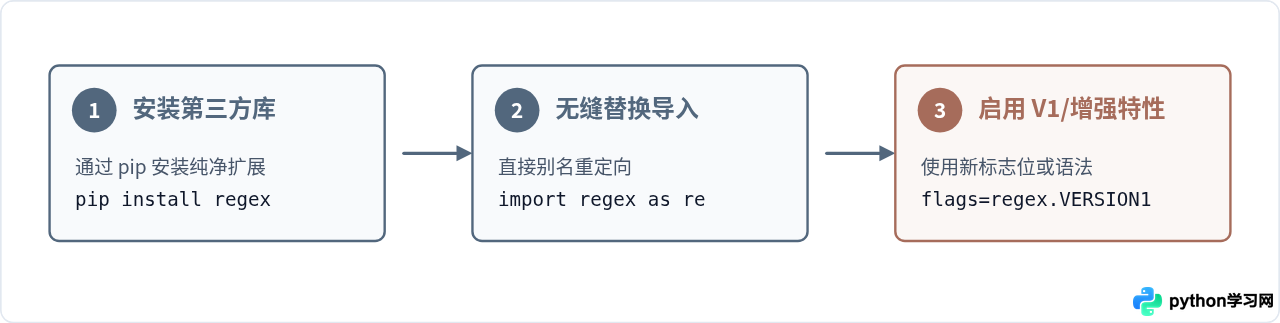
第一步:安装模块
regex 在 PyPI 上提供预编译的 C 扩展 Wheel 包,执行以下命令即可快速完成安装:
pip install regex第二步:在业务代码中平替引用
由于 API 签名保持高度兼容,在大多数已有项目中,你只需要将原有的导入语句修改为:
# 原代码: import re
import regex as re

# 现有所有 re.compile、re.search、re.sub 均无需做任何变更即可正常运行
pattern = re.compile(r"\w+")
第三步:了解并切换匹配行为版本(VERSION0 与 VERSION1)
regex 提供了两个行为标志:
regex.VERSION0(默认):最大程度兼容 Python 标准库re的历史遗留特性。regex.VERSION1:启用全新更严格的标准行为。例如,在字符集并集或差集语法中(如[[a-z]--[aeiou]]表示排除元音),需开启regex.V1模式。
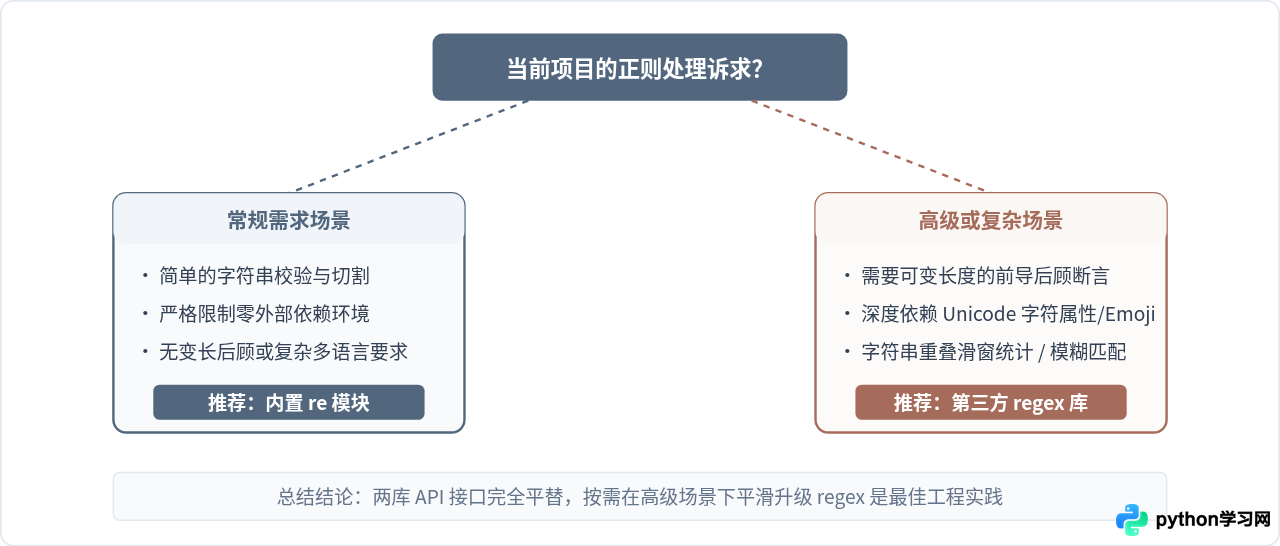
regex 功能强劲,但由于它是用 C 实现的扩展包,如果你的部署环境处于极端严苛的无编译环境或受限轻量容器(如部分裁剪版 Alpine 镜像),需确保对应架构的 Wheel 包能够顺利拉取或预装。对于只处理极度简单格式验证(如纯数字、固定邮箱后缀)的轻量脚本,内置 re 依然是最无需外部依赖的稳妥选择。
四、总结与决策指引
在技术选型上,我们不建议无目的地引入额外依赖,但当遇到特定场景时,继续硬抗使用 re 会显著增加代码复杂度与维护成本。下面的决策矩阵图汇总了日常开发中的选择判断路径:
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















