


Python列表推导式怎么写?高效生成与过滤数据技巧
全面讲解Python列表推导式的基本语法、条件过滤技巧、双重循环与三元表达式应用,对比传统for循环的性能与可读性边界,助你写出高效、优雅的Python代码。
列表推导式(List Comprehension)是 Python 中最实用且最具代表性的语法糖之一。它的核心价值在于用单行声明式语法,替代传统的 for 循环与 list.append() 操作,实现数据的高效生成与灵活过滤。本文直接从基础语法切入,详细拆解推导式的构造逻辑、条件过滤规则、嵌套处理以及性能边界,帮助你在日常开发中写出既紧凑又易读的高质量 Python 代码。
一、基础语法拆解:从传统循环到列表推导式
在 Python 中生成新列表最原始的写法是先初始化一个空列表,通过 for 循环遍历已有序列,再逐个调用 append() 将计算结果存入。例如计算 1 到 5 的平方数:
# 传统循环写法
squares = []
for x in range(1, 6):
    squares.append(x * x)
# 结果: [1, 4, 9, 16, 25]
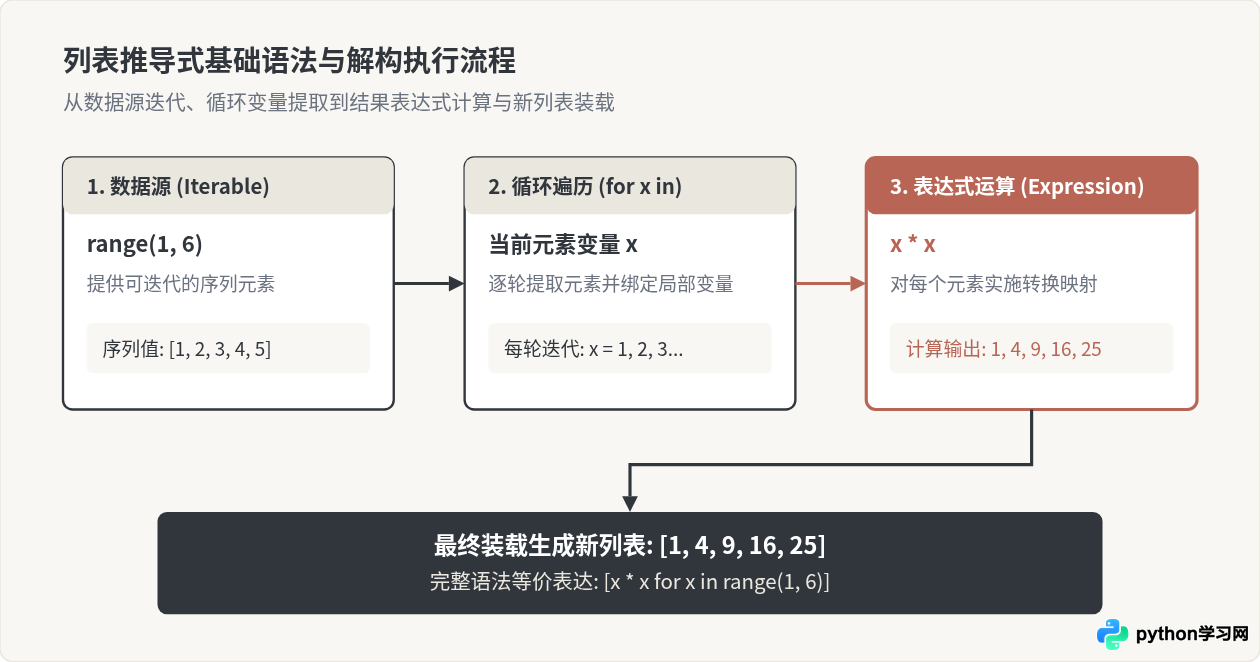
使用列表推导式,这段逻辑可以用一行紧凑代码完整表达:
# 列表推导式写法
squares = [x * x for x in range(1, 6)]
# 结果: [1, 4, 9, 16, 25]
列表推导式的核心结构由三个基本部分构成:最外层的方括号 [] 声明生成结果为列表;最左侧的 x * x 是针对每个元素计算的目标表达式;中间的 for x in ... 负责定义迭代变量与数据源。
二、高效过滤数据:尾部 if 条件的实战技巧
列表推导式不仅能做映射变换,还能在末尾添加 if 子句实现数据过滤。只有满足布尔条件为 True 的元素,才会被传递给最左侧的表达式进行计算和收集。
1. 单条件过滤
例如从包含正负数的混合列表中,仅挑选偶数并计算平方:
numbers = [1, 2, 3, 4, 5, 6, 7, 8]
# 筛选偶数并求平方
even_squares = [x * x for x in numbers if x % 2 == 0]
# 结果: [4, 16, 36, 64]
2. 多条件组合过滤
过滤条件可以使用 Python 的逻辑运算符 and、or,也可以直接链式书写多个独立的 if 子句。链式 if 的执行逻辑等价于 and:
# 找出 1 到 30 之间能同时被 2 和 3 整除的数字
# 方式 A:使用 and 运算符
result_a = [x for x in range(1, 31) if x % 2 == 0 and x % 3 == 0]

# 方式 B:连续使用多个 if(语义等价)
result_b = [x for x in range(1, 31) if x % 2 == 0 if x % 3 == 0]
# 结果均为: [6, 12, 18, 24, 30]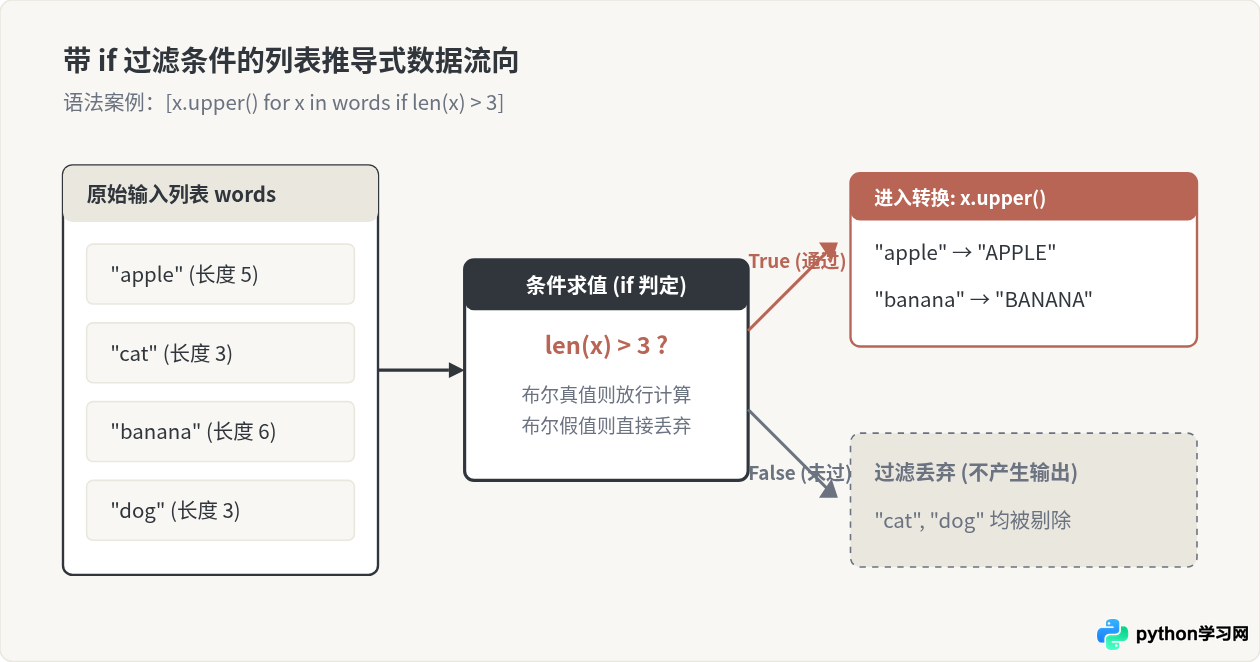
三、分支与多重循环:三元表达式与嵌套推导
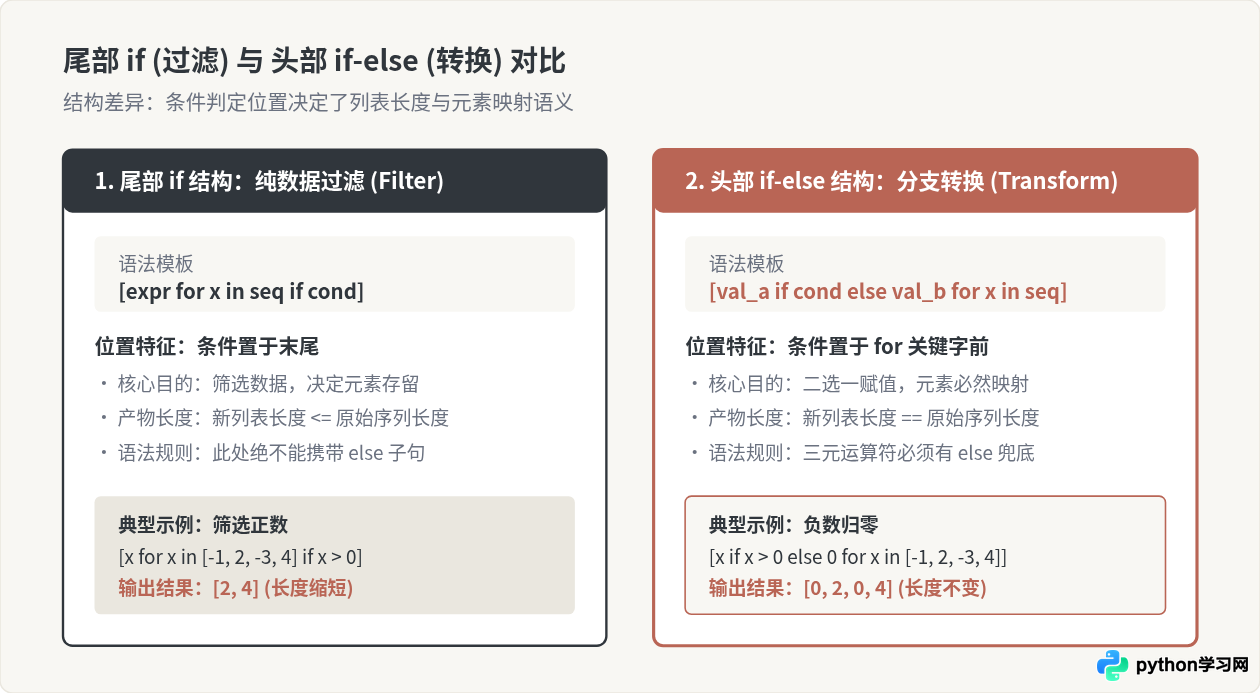
初学者在使用推导式时最容易混淆的场景是:何时使用 if,何时使用 if-else? 关键区别在于条件的作用对象是“过滤元素”还是“转换结果”。
1. 头部三元表达式(if-else)
如果你不想丢弃元素,而是根据条件产出不同的值,必须在 for 关键字之前使用 Python 三元运算符:
raw_data = [12, -4, 0, -8, 25]
# 如果大于 0 则保持原样,否则替换为 0
cleaned = [x if x > 0 else 0 for x in raw_data]
# 结果: [12, 0, 0, 0, 25](长度与原列表完全一致)• 尾部单
if 是过滤器(选拔留存,不带 else,列表可能变短)。• 头部
if-else 是值映射(人人有份,必须带 else,列表长度不变)。
2. 双重循环与二维矩阵展平
推导式还支持多个 for 语句嵌套,执行顺序与普通嵌套循环完全从左到右一一对应:
matrix = [[1, 2, 3], [4, 5, 6], [7, 8, 9]]

# 将二维矩阵展平为一维列表
flat = [num for row in matrix for num in row]
# 结果: [1, 2, 3, 4, 5, 6, 7, 8, 9]

# 对应普通循环逻辑:
# for row in matrix:
#     for num in row:
#         flat.append(num)
四、性能分析:为什么列表推导式比普通循环更快?
在同等计算逻辑下,列表推导式通常比 for + append() 快 20% 到 40%。这一性能差异主要源于底层 CPython 解释器的执行机制:
- 无属性查找开销:普通循环在每次迭代中都需要执行
list.append的属性查找(LOAD_ATTR)和方法绑定调用。 - 专门的字节码优化:列表推导式由解释器直接编译为专门的
LIST_APPEND字节码指令,直接向底层 C 数组末尾注入数据,免去了函数帧入栈与出栈的额外开销。 - 连续内存预估:推导式在底层能够更紧密地复用列表缓冲区,减少反复重分配内存带来的额外耗时。
五、可读性边界与工程最佳实践
虽然列表推导式非常高效,但在工程实践中绝不能无节制滥用。过度追求紧凑代码会导致可读性急剧下降,给后续维护埋下隐患。
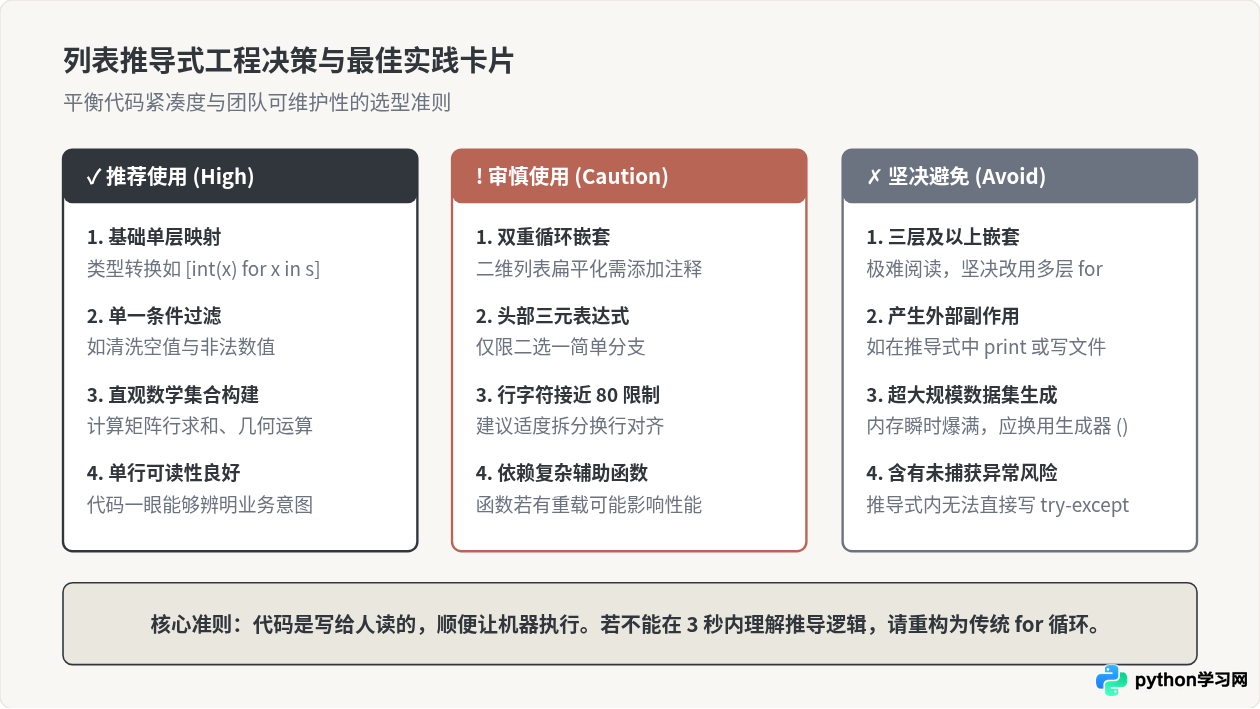
不可忽视的三个注意事项
- 不要用来制造副作用:列表推导式的核心目标是“构造新列表”。切忌写出形如
[print(x) for x in items]的反模式代码。如果不需要最终生成的列表,直接使用标准for循环。 - 海量数据优先使用生成器表达式:列表推导式会在内存中一次性分配全部元素。处理上千万行日志或超大文件流时,只需把外层方括号
[]换成圆括号(),即可转换为惰性计算的生成器表达式(Generator Expression),实现常数级内存占用:# 内存友好型生成器表达式 gen = (x * x for x in range(10_000_000)) # 仅在使用 next(gen) 或迭代时按需计算单个值 - 避免过于复杂的逻辑:如果表达式内部需要多层三元运算、或者包含可能抛出异常且需要
try-except捕获的代码,请果断拆解回具名函数或标准循环。
六、总结与语法速查表
| 业务目标 | 标准语法模板 | 结果列表长度 |
|---|---|---|
| 全量基础映射 | [f(x) for x in seq] |
与原序列相等 |
| 条件过滤筛选 | [f(x) for x in seq if cond] |
小于或等于原序列 |
| 分支二选一映射 | [a if cond else b for x in seq] |
与原序列相等 |
| 二维平铺解包 | [item for row in matrix for item in row] |
子元素总和 |
掌握列表推导式的关键在于把握其声明式语义:把“怎样一步步构建列表”转变为“这个列表由什么构成”。合理运用过滤与映射,能让 Python 代码更加优雅、精悍且高效。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















